ARTICLE · 1227096
每周AI工具|一句话生成3A游戏、300个子Agent开工:Kimi写进App商店的宣传,能信几分?
AI工具 AI科研专家 — 用AI做科研的效率工具
文件级交付 · 模型回读 · 渲染自检 · 许可边界
点击文末「阅读原文」直接使用
关注「AI-For-Precision-Health」 — 每天一篇AI科研实操干货
食品 · 医药 · 器械 · AI工具 · 科研Skill — 让AI真正帮你做科研。
一个 App 商店的功能介绍页,写着「一句话生成 AAA 级多人 3D 游戏」和「300 个子 Agent 同时开工」——而它对应的旗舰模型,连一张正式的模型卡都还没有。
我上周更新手机里的 Kimi,往下翻 App Store 功能列表的时候愣了一下:Agent 集群、Office 全家桶无损转换、Kimi Claw 云端智能体——每一行都写得像产品发布会,不像应用商店。更怪的是,我顺手对照了其他渠道:iOS 官方商店写着「调度多达 100 个分身,并行处理 1500 个步骤」,第三方安卓市场的 3.1.3 版本页面却写着「300 个子 Agent 执行 4000 步」「一句话生成 AAA 级多人 3D 游戏」——同一款 App,两个渠道,两套数字[3][8]。再往模型层查,这些能力对应的旗舰 Kimi K3.1 还压在灰度测试里,开放平台后端只有一个被开发者扒出来的内部标识符「kimi-k3-1」,官方连一张模型卡都没发[5][7]。
这不是月之暗面一家的问题,它是一个越来越常见的模式:宣传先落地,交付在灰度,验证没人做。App 商店的文案是厂商自己写的,基准分数是训练方自己报的,「10 倍效率」是自己测的——整条证据链的起点和终点都是同一家公司。
所以这篇的命题很直接:大厂把未验证的宣传写进官方渠道,读者该信几分?具体拆成两个问题:写进 App 商店的那些宣传,哪些有官方数据撑着,哪些只是文案?以及如果你真的想让这 300 个子 Agent 替你干活,账单会是什么样?
2.8 万亿 Kimi K3 总参数量,每 token 激活 104B,896 个专家选 16 个[1] | 100?300? Agent 集群分身数:iOS 官方商店写 100 分身·1500 步[3],第三方安卓市场写 300 子 Agent·4000 步[8] | $3 / $15 K3 API 官方定价:每百万输入 / 输出 token(美元)[1][6] |
第一个数字来自官方模型卡,可逐字核验;第二个来自厂商商店文案, vendor-stated;第三个是官方定价页——三个数字的可信度等级完全不同,这正是本文要拆的东西。
一、先看能核验的部分:K3 的官方模型卡写了什么
把宣传放一边,K3 本体是能查的。Hugging Face 上 moonshotai 组织的模型卡写得很细:总参数 2.8 万亿,每个 token 激活 104B;896 个路由专家中每个 token 点名 16 个,外加 2 个共享专家;93 层里 69 层用自研的 Kimi Delta Attention(KDA),24 层用门控 MLA;上下文窗口 1,048,576 个 token,原生视觉输入靠 401M 参数的 MoonViT-V2 编码器;权重按 MXFP4 量化、激活 MXFP8,训练阶段就做了量化感知[1]。【事实】以上每一个数字都能在模型卡上逐行对到,包括许可协议——它用的是「Kimi K3 License」,一个自定义许可,不是 Apache 2.0[1]。
有一个数字我特意核了:官方称 K3 是「全球首个开源的 3 万亿级开放权重模型」[1]。这句话的逻辑重音在「3T 级」和「开放权重」上——2.8 万亿确实够到 3T 档位,权重也确实挂在 Hugging Face 上可下载,月下载量过了 100 万,社区有 51 个微调、57 个量化衍生[1]。但「开源」二字要打个折:自定义许可不是 OSI 认证开源,商用条款要单独读。这是我第一次查它的许可时踩的坑——我原本以为 2.8T 开源等于随便部署,读完许可才发现「开放权重」和「开源许可」之间隔着一整页法律文本。
本节结论:▸ K3 的硬数据全部可核验,且经得起逐行对照;但「开源」的表述需要降级为「开放权重 + 自定义许可」,这两个词在商用时是完全不同的两件事。
二、再看宣传的部分:三个渠道,三套口径
把宣传侧的证据摆在一起,你会发现「官方说法」不是一个点,是一条光谱。【事实】iOS 官方 App Store(19 万评分,现役文案)宣传的是 K2.5 实装:「上线即开源」「Agent 集群可现场调度多达 100 个分身,并行处理 1500 个步骤,将原本耗时的工作压缩至分钟级交付,实现 10 倍以上的效率提升」,外加 Kimi Claw(多合一 OpenClaw 全能套件,零配置解锁云端智能体)[3]。【事实】而第三方安卓市场的 Kimi 3.1.3 版本页面(10 月 6 日更新)写的是另一套:K3 已实装、「一句话输入,产出一个 AAA 级多人 3D 游戏」、「动态调度最多 300 个子 Agent 执行 4000 步」、接入 Wind 和标普数据源[8]。
两页文案都姓「官方」,数字却差了一倍以上——iOS 说 100 个分身,安卓渠道说 300 个子 Agent;iOS 主推 K2.5,安卓页面写 K3。【判断】这种渠道间的口径漂移本身就是证据:宣传数字还在流动中,没有一处是定稿。应用商店文案不是科学论文,没人要求它版本一致——但当你引用其中任何一个数字去论证「AI 已经能怎么怎样」时,你引用的是一个还在变的中间态。
我猜这个场景你不陌生:课题组群里有人甩来一张截图——「AI 一句话生成了一个游戏,科研人员要失业了」。我上回在群里见到时顺手查了出处,发现那条消息的源头正是安卓渠道这页文案,而不是任何一份可核验的技术报告。查出处这个动作只要一分钟,却是绝大多数转发永远不会发生的一步——这也是我写这篇的直接动机:把那「一分钟」替你先走了。
本节结论:▸所谓「官方宣传」至少有三个版本(iOS 商店、第三方安卓市场、模型卡),每个版本的数字都不一样——引用之前先问一句:你引的是哪一版?
三、中间那层:K3.1 的灰度证据链,目前只有「指纹」
宣传里那些最猛的能力(长程自主任务、3D 代码增强、操作电脑),对应的下一代旗舰 K3.1 处于什么状态?把目前能查到的证据按时间排一下:【事实】9 月 28 日,开发者在月之暗面开放平台的 API 后端注册表里发现了可调用的「kimi-k3-1」标识符;随后开放平台出现 K3.1 预览,标称 100 万 token 上下文;官网前端出现了「k3d1-agent」标识符和新的 bot 模块,外界猜测是类似 GrokBot 的产品形态[5][7]。
【推断】从这些指纹推测,K3.1 的增量不在参数量(上下文与 K3 持平,参数未确认),而在推理分档和编排层:传闻提供 Low / High / Max 三档推理,外加 Agent 模式、Swarm 多智能体协作、任务模式三个开关[5][7]。推论:如果这个产品结构属实,Kimi 的竞争策略就不是「更大的模型」,而是「同一颗脑子,按任务难度收不同的算力钱」——推理分档改变的首先是大模型的经济学,其次才是能力[5]。
但我要把丑话说在前面:【判断】以上所有关于 K3.1 的具体能力描述,截至发稿没有任何一条来自月之暗面的官方公告——identifier 是开发者扒出来的,功能清单是媒体根据指纹推测的,连「K3.1」这个名字都还没出现在官方 model card 上[5][7]。写这篇文章的时候我给自己定了条规矩:凡是 K3.1 的内容,一律标注「灰度/传闻」,不和 K3 的已核验数据混排。
本节结论:▸ K3.1 的证据链目前只有「平台指纹」这一层,官方一个字没说——所有关于它的能力叙事都应该默认降级为传闻,直到 model card 出现。
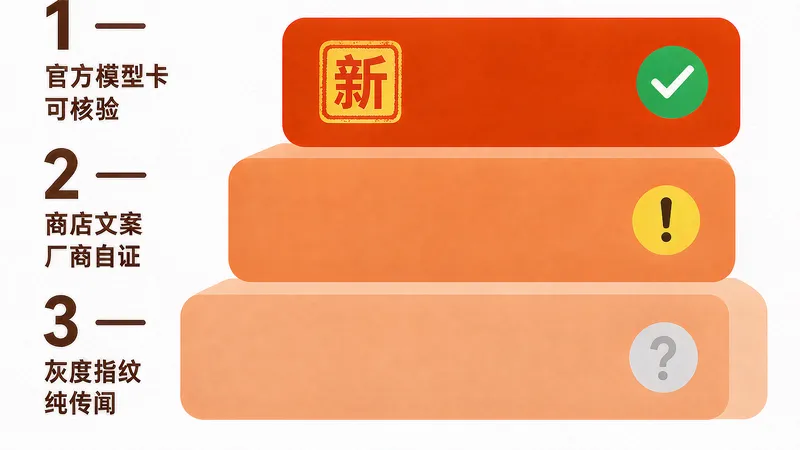
▲ Kimi 宣传的三个证据层:模型卡可核验 → 商店文案厂商自证 → 灰度指纹纯传闻。你转发的那句金句,先看它在第几层。
四、KDA 讲人话:一张便签纸和一份快照
模型卡里最值得讲人话的是 KDA(Kimi Delta Attention)。传统注意力机制下,上下文越长,KV Cache 越大,显存消耗跟着暴涨——这是所有长上下文模型绕不开的成本曲线。KDA 的做法,用新浪报道里的比喻:模型的前几层持续维护一张「运行摘要」便签纸,把最重要的信息压缩在上面,无论上下文多长,便签纸大小基本不变;为了补回细节,每隔四层做一次全上下文的「快照压缩」,需要时临时解压查看,再重新压回去[5]。
【事实】架构参数(69 层 KDA + 24 层门控 MLA、注意力隐藏维度 7168、96 头)在模型卡上可查;官方称这套组合带来约 2.5 倍于 K2 的扩展效率[1][5]。【判断】「2.5 倍扩展效率」是厂商口径的训练效率声明,不等于你的推理账单会降 2.5 倍——训练时的效率优势要传导到 API 价格上,中间隔着推理框架、批处理策略和商业定价三层。
本节结论:▸ KDA 是真实的架构创新,1M 上下文是真实的窗口;但架构效率与你的实际成本之间没有直连通道,别把架构论文的优化倍数当成账单折扣。
五、「一句话生成 3A 游戏」,这个词该信几分?
现在拆最抓眼球的宣传。先说明出处:「一句话生成 AAA 级多人 3D 游戏」这句文案出现在第三方安卓市场的 3.1.3 版本页面[8],iOS 官方商店现役文案里没有这句话。游戏行业里「3A」(AAA)指的是高预算、高体量、高宣传投入的产品级别——一款真正的 3A 游戏需要数百人团队、数年开发、上亿美元。「一句话生成 AAA 级多人 3D 游戏」这句话里的「AAA」,显然不是这个意思——它指的是「画面看起来挺精致」。【判断】这是厂商对行业术语的一次降维借用:借用了 3A 的光环,没继承 3A 的定义。严格说这不构成虚假宣传(没人规定商店文案必须遵守游戏行业术语),但它确实让读者自动补全了不存在的含义。
那实际能生成什么?【事实】该功能的实机演示显示,产出的是浏览器可玩的 3D 小游戏:有完整的世界观、角色、关卡和战斗循环,能试玩能迭代[5][8]。这个水平放在两年前是不可想象的,放在今天也是第一梯队。【推断】但「能玩的 3D 网页游戏」和「AAA 多人 3D 游戏」之间的差距,大概相当于「能跑的卡丁车」和「F1 赛车」——前者是真实交付,后者是营销词汇。推论:这类宣传的真正风险不是它做不到,而是它把用户的预期锚定在「3A」上,然后让真实的交付看起来像失败——明明是第一梯队的成果,被自己家的文案拖累成了「不符预期」。
本节结论:▸ 「一句话生成 3A 游戏」里每个词都该重新称重——「一句话」「3D 游戏」是真的,「3A」「多人」是营销修辞;交付物本身值得肯定,宣传词不值得。
六、300 个子 Agent 的账单:我算了一笔没人愿意算的钱
「300 个子 Agent 执行 4000 步」这句话,我从第一次读到就想算账。按 iOS 官方商店的口径算:一次集群任务调度 100 个分身、并行处理 1500 步,每步是一次模型调用加上工具往返[3]。按 Agent 任务的典型 token 消耗——每步输入带上下文和工具结果,输出是决策和指令——单步 2 万到 5 万 token 是常态。取中间值每步 3.5 万 token,1500 步就是约 5,000 万 token;若按第三方页面的 300 子 Agent·4000 步上限[8],则奔着 1.4 亿 token 去。按 K3 官方 API 定价($3/百万输入、$15/百万输出,混合估算按每百万 token $6 计),官方口径的一次满负荷任务账单在 300 美元上下,第三方口径的上限场景破千美元[1][6]。
【判断】我必须承认这是一笔带假设的估算——步均 token 没有官方数字,我的系数全来自自己做 Agent 项目的经验值。但这笔账的意义不在精确,在于它揭示了「10 倍效率」文案的另一半:效率倍数和成本倍数是同一枚硬币的两面。把小时级工作压到分钟级,代价是把人工成本换成 token 成本——而 4000 步的每一次,都是要付费的[3][6]。
推论:Agent 集群类功能真正的竞争壁垒不是「能调度多少个子 Agent」——工程上这不难——而是「单位任务的 token 经济学」。谁的推理分档做得好(简单步骤用 Low 档、关键决策用 Max 档),谁就能在这场算力军备竞赛里把账单打到对手的三分之一。K3.1 传闻里的三档推理,瞄准的正是这个[5][7]。
落到你自己的项目上,我的用法是把它当「预算敏感型工具」对待:开跑前先估步数(子任务数 × 预期轮次),拿小样本试水一次、记下单任务的真实 token 消耗,再决定放不放集群。文献综述这类可拆任务,先拿十几篇试一轮看消耗,远比一上来放满上千步、跑到一半才发现既烧钱又跑偏要稳——账单和任务漂移,永远是同一批没人盯的步骤里长出来的。
本节结论:▸ 300 个子 Agent 是工程能力,几百美元是一次任务的隐性价格——宣传写了前者,没写后者,而后者决定你用不用得起。
七、竞品不等人:DeepSeek 把基准追平了
K3 发布于 7 月 17 日,到 10 月中旬正好三个月。这三个月里赛道发生了什么?10 月 17 日,DeepSeek 发布 V4.1-Flash-1017,快科技 10 月 18 日的报道直接点名:「V4.1 Flash-1017 目前的性能基准几乎全面超过 K3」——同时 DeepSeek 相关能力也在快速产品化[4]。
【事实】两家都是厂商自报基准,互相之间没有第三方仲裁;「几乎全面超过」是媒体的概括,不是基准报告的原话[4]。【判断】但这不影响一个结构性事实:K3 靠 2.8T 参数建立的领先窗口,只维持了三个月——而且这三个月里,K3 自身的定价、速度、用量问题一直被用户吐槽,快科技的原话是「月之暗面需要在 K3.1 上做出让大家满意的改变」[4]。
这就是为什么「宣传先行」的打法在这条赛道上格外危险:窗口期比产品周期短。App 商店的功能文案可以提前一个季度写好,但基准榜每天在变。等你把宣传铺满、灰度测完、正式发布,竞品的新版本可能已经把你的「领先」变成了「追平」——到时候最先尴尬的是自己写下的那句「AAA 级」。
本节结论:▸ K3 的领先窗口只有三个月且已被追平,这解释了为什么 K3.1 急着灰度——但对用户来说,基准榜的变动速度就是「厂商宣传保质期」的倒计时。
八、自我反驳与三个分歧点
先交底本文论证依赖的三个前提——前提1:Hugging Face 官方模型卡的内容真实反映 K3 模型本身;前提2:iOS 官方 App Store 的功能文案对应已上线功能;第三方安卓市场页面则按传闻材料对待;前提3:厂商自报的性能数据目前无独立第三方复核。以下反驳与分歧均在这三个前提下成立,前提若塌则结论重估。
反驳一:你这是在苛求营销文案,产品宣传从来不承诺科学精度。回应:我不反对营销修辞,我反对的是证据链的单源化。「10 倍效率」的测试者、发布者、受益者是同一家公司,而这条声明会被媒体转述、被用户引用、最终变成「公认事实」——整个传播链里没有一个环节要求它拿出对照实验。营销可以夸张,但夸张的部分应该被标记为夸张。
反驳二:300 个 Agent、4000 步这些数字就算打折,方向也是对的——你是不是在否定整个 Agent 集群路线?回应:恰恰相反,第六节我算账的前提是「这条路能走通」。我批评的从来不是能力,是宣传先于验证的顺序。功能描述写成「动态调度子 Agent 完成多步任务」没有问题;写成「效率提升 10 倍以上」就必须附上基线。方向和修辞是两件事。
分歧点一:厂商自报基准到底算不算证据?我的立场:算「线索」,不算「证据」——它可以被引用,但必须带着「vendor-stated」的标签。有人认为厂商基准也是同行评议的对象,引用时不需要标签;我认为在基准测试普遍缺乏统一仲裁的当下,标签是最低成本的对冲。
分歧点二:推理分档(Low/High/Max)是创新还是割韭菜?我倾向于创新——它把「为任务难度付钱」变成了可选项,简单任务终于不必烧旗舰算力。但也有人认为这是把本该一体的能力拆开重复收费。判定权在你自己的账单上。
分歧点三:2.8T 开放权重对行业是好事还是军备竞赛?乐观方说它拉低了前沿研究的门槛(月下载 100 万、51 个微调、57 个量化是真金白银的生态[1]);悲观方说 3T 级模型的训练成本只有少数机构负担得起,「开放权重」只是把比赛从闭源卷到开源,门槛不降反升。我还没想清楚站哪边。
不确定一:Agent Swarm 的真实成功率。4000 步的长程任务,行业普遍的失败模式不是单步出错而是中途跑偏——「分钟级交付」的宣称里,有多少任务真正走完了 4000 步而没有中途漂移,没有任何公开数据。
不确定二:K3.1 的正式发布时间和最终规格。本文所有 K3.1 内容都可能被官方一纸公告修正——如果 model card 出现后与本文推断冲突,以官方为准,欢迎回来打脸。
九、你可能想问的四个问题
Q1:Kimi K3.1 现在能用吗?严格说:不能正式用。现役可用的是 Kimi K3(App 和 API 都在线,权重在 Hugging Face)[1];K3.1 处于灰度测试,只有开发者扒到的 API 标识符和平台预览,没有官方发布[5][7]。
Q2:K3 免费吗?App 端有免费额度;API 按 token 计费,官方价 $3/百万输入、$15/百万输出[6]。权重下载免费,但部署 2.8T 模型对显存的要求不是个人玩家能轻易满足的——这也是为什么社区衍生以量化版为主[1]。
Q3:「一句话生成 3A 游戏」真的能玩吗?能玩,但请把「3A」两个字从脑子里删掉再试。产出是可玩的 3D 网页游戏,有完整的世界观和战斗循环;当作玩具和原型验证是惊喜,当作 3A 交付是落差[5][8]。
Q4:做文献综述,Kimi 的 Agent 集群和单 Agent 循环该怎么选?我的经验值:任务能否拆成互不依赖的子问题,是唯一的分界线。综述的「按主题分库检索」可拆,适合 Swarm;「通读全文后写批判性综述」不可拆,串行单 Agent 更稳还更便宜。别为了 300 个子 Agent 的排面,把 200 美元能干完的活干成 800 美元。
十、把宣传当假设,把账单当事实
回到开头的问题:写进 App 商店的宣传,能信几分?综合评分:架构数据 9 分(模型卡逐行可查,是我见过写得最细的一档);功能存在性 7 分(商店文案对应的功能真实上线,但验收标准归厂商);性能声明 4 分(10 倍效率、AAA 级,全部缺独立复核);未来承诺 2 分(K3.1 的能力清单来自灰度指纹和媒体推测)[1][3][5][7]。
这不是给 Kimi 打低分——恰恰相反,2.8T 开放权重、KDA 架构、月下载百万的生态,都是硬货。我想留下的只有一个习惯:读到任何「官方宣传」,先问一句「这句话的验收标准在谁手里」。验收标准在厂商手里的,当假设对待;有第三方数据或你自己实测撑着的,才升级为事实。大模型的宣传周期已经卷到了「先写商店文案、再补模型卡」的地步,读者手里的防御工具只剩这一句追问。
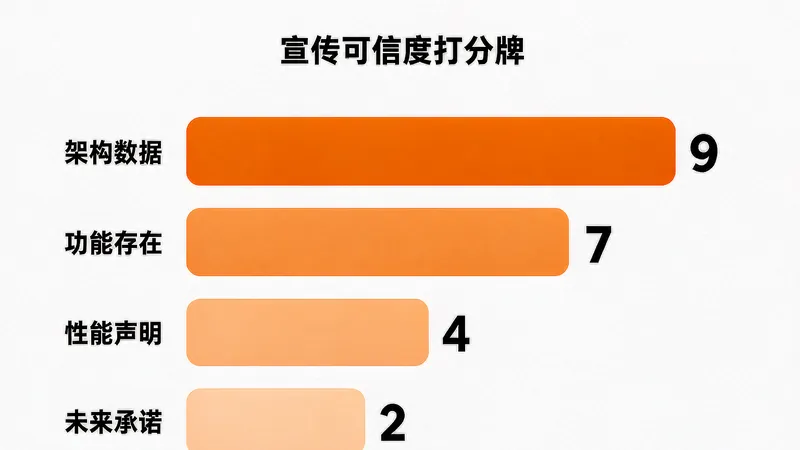
▲ 四层宣传的核验打分:架构数据 9 分,功能存在 7 分,性能声明 4 分,未来承诺 2 分。
▸ 核心结论:K3 的硬数据经得起逐行核验,K3.1 的能力叙事还停在灰度指纹层;「3A」「10 倍效率」是营销词汇不是工程指标,而 300 个子 Agent 的每一次调用都在计费。把宣传当假设,把账单当事实,把模型卡当唯一的锚。
💬 最后一问留给你:如果有一天 App 商店的功能文案必须像药品说明书一样标注「本声明未经第三方验证」,你猜哪些功能会被打上最粗的黑框?评论区聊聊。
创作来源说明:本文由作者与 AI 协作完成——选题核证与框架由作者主导,AI 辅助整理资料与初稿,全部关键数字经作者逐条对照官方模型卡与公开报道核验;文中「我的经验值」「我算了一笔账」均为作者个人判断,可能与你的实测不符。转载请注明出处。
参考文献(可点击原文查看)
[1] Moonshot AI. Kimi K3 Model Card. Hugging Face, 2026. URL: https://huggingface.co/moonshotai/Kimi-K3
[2] Moonshot AI. Kimi K3 Technical Blog. kimi.com, 2026. URL: https://www.kimi.com/blog/kimi-k3
[3] Kimi(K2.5 实装与 Agent 集群功能文案). Apple App Store(CN), 2026. URL: https://apps.apple.com/cn/app/kimi/id6474233312
[4] 快科技. DeepSeek之后又一家国产AI出大招:2.8万亿参数 Kimi K3.1已现身. 新浪财经, 2026-10-18. URL: https://finance.sina.com.cn/tech/roll/2026-10-18/doc-inivrzvi7795482.shtml
[5] 新浪新闻. 大模型不再只聊天,Kimi K3.1 把靶心移到了「会干活」. 2026-10. URL: https://www.sina.cn/news/detail/5347010929494026.html
[6] OrcaRouter. Kimi K3.1: The Search-Box Name for Kimi K3, and What Moonshot Actually Ships. 2026-10. URL: https://www.orcarouter.ai/blog/kimi-k3-1
[7] Asia Daily. Kimi K3.1 Release Signals Emerge as Moonshot Prepares Its Next AI Upgrade. 2026-10. URL: https://asiadaily.org/news/15760
[8] Kimi 版本 3.1.3 功能列表(第三方安卓市场页面). CafeBazaar, 2026-10-06 更新. URL: https://bugbounty.cafebazaar.ir/app/com.moonshot.kimichat?l=en