ARTICLE · 1230168
返修,别怂!这样回复直接接收,模板拿去抄
一、方法细节与超参数设置
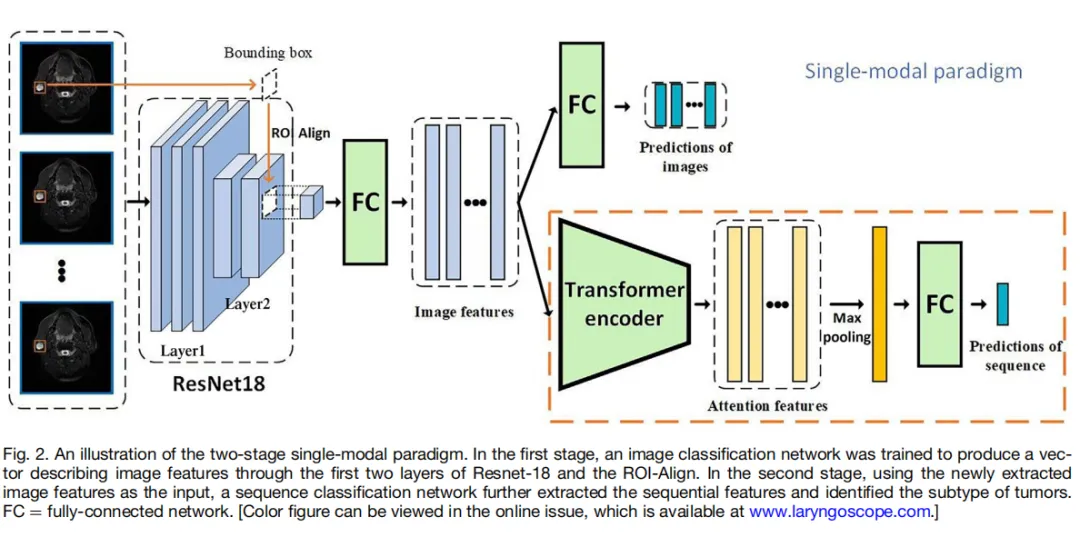
1.审稿人问:请详细说明数据预处理步骤、模型架构、正则化方法以及所有超参数(batch size、learning rate、optimizer、epoch、patience 等)。
回复建议:需如实列出实际使用的参数。包括:图像预处理(重采样方法、归一化方式)、网络架构(如 ResNet 全层微调)、正则化(L2 和 batch normalization 默认使用)、优化器(如 SGD)、学习率、批次大小、最大 epoch 数。早停策略可写为“连续 N 个 epoch 损失未下降则停止”,并给出具体 patience 值。
2.审稿人问:为什么选择特定的深度学习模型?微调了哪些层?是否冻结部分层?
回复建议:说明使用的是主流预训练模型(如 ResNet-18/34/50),所有层均参与微调。若审稿人质疑,可强调这是基于训练集表现最优的选择。
3.审稿人问:请提供目标函数/损失函数的公式。
回复建议:根据模型类型提供对应公式(如 Cox 损失函数)。若原文遗漏,建议补充在回复或正文方法中。
4.审稿人问:模型参数的实际数量(参数量)是多少?
回复建议:可计算并给出具体数值(例如 ResNet-34 约有 2100 万参数),表明模型复杂度。
二、特征提取与选择
5.审稿人问:特征提取使用了什么工具?是否遵循 IBSI 标准?请提供特征列表和配置文件。
回复建议:说明使用开源工具(如 pyradiomics),给出版本号,遵循 IBSI 标准。将特征提取的配置文件和提取到的特征名称列表(表头)提供给审稿人,或承诺接收后开源代码。
6.审稿人问:为什么特征数量与模板/默认值不一致?
回复建议:模板是通用示例,实际特征数需根据自己提取的结果修改,应如实填写原始提取特征数及筛选后保留的数量。
7.审稿人问:特征筛选方法(如 PCA、LASSO)的具体过程?每个步骤保留了多少特征?
回复建议:说明筛选在训练集上进行,给出每一步(如方差阈值、LASSO)后保留的特征数。若审稿人要详细数值,可指向开源代码或配置文件。
8.审稿人问:插值方法(如重采样)是什么?对纹理/形状特征有何影响?
回复建议:默认使用最近邻插值。定性回复可说明插值方法不会对纹理特征产生显著影响;定量需做不同插值对比实验,一般可不提供。
三、模型融合与对比实验
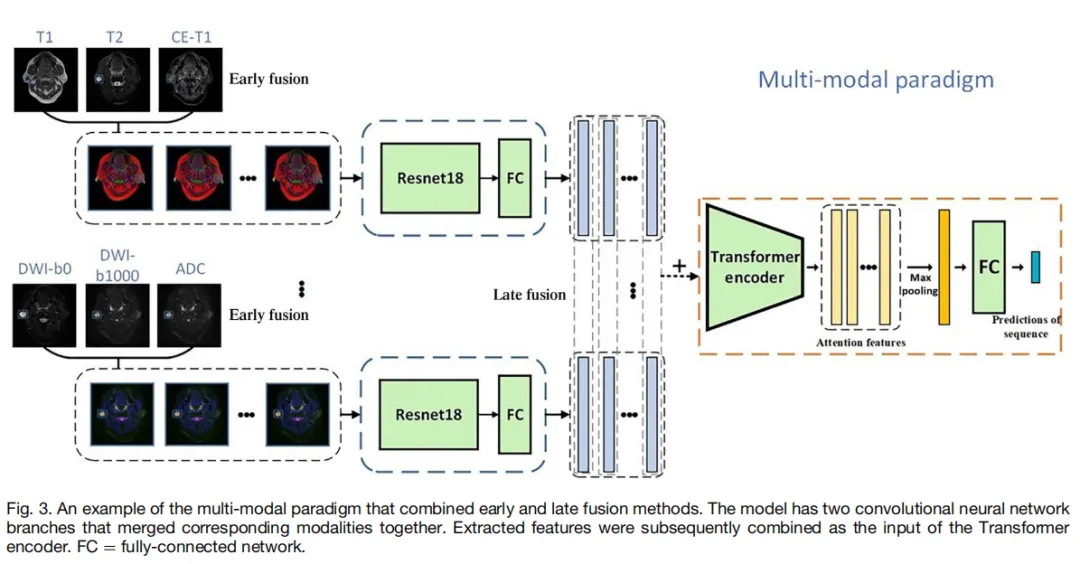
9.审稿人问:为什么没有做多序列/多方法的融合?融合策略是什么?
回复建议:若实际未做融合,可回复做的是不同方法学的对比,而非结合。若做了后融合,需说明:使用每个子模型预测的风险分值作为新特征,再用 Cox/逻辑回归进行二次拟合。
10.审稿人问:为什么没有与临床模型、病理组学等结合?要求补充临床特征或做融合模型。
回复建议:可如实说明临床模型信息增益不大,或单独补充一个临床模型结果放入补充材料,证明其效果差以凸显影像模型价值。若不想补充,可拒绝并说明理由(研究重点不在临床,或临床数据收集不全),并引用类似文献。
11.审稿人问:如何体现深度学习模型的增量贡献?要求做消融实验(如逐一移除模块)。
回复建议:可拒绝,说明研究目的是整体融合模型的性能,而非比较单一方法优劣;几乎所有文献都证明融合优于单一,无需额外消融。若同意补,则补充两两组合的结果表格。
12.审稿人问:为什么某些对比结果没有显著性检验(如 DeLong 检验)?要求提供配对差异和置信区间。
回复建议:DeLong 检验本身不提供置信区间,基于固定样本量未做 bootstrap 重采样,故没有置信区间概念。可甩出多篇文献证明该做法常见,或补充百分比提升说明。
四、评价指标与统计检验
13.审稿人问:为什么没有置信区间?要求给 AUC、NRI、IDI 等指标提供置信区间。
回复建议:固定样本量下,DeLong 检验等无法给出置信区间,需通过 bootstrap 或交叉验证重采样才能计算。可回复未做重采样故无,并引用文献支持;或找几篇无置信区间的论文作为例证。
14.审稿人问:NRI/IDI 是基于连续风险值还是阈值?如何选定阈值?
回复建议:基于最佳阈值(如 Youden 指数)计算重新分类指标,不同阈值下结果会有差异。阈值应基于训练集确定,在测试集上固定使用。
15.审稿人问:校准曲线(Calibration curve)的截距和斜率是多少?总体校准如何?
回复建议:校准曲线通常是多段折线,无统一截距和斜率。可目测或简单线性拟合给出近似值,或说明使用的接口无直接输出功能。
16.审稿人问:决策曲线(DCA)的阈值范围如何确定?
回复建议:目测给出一个大概范围(精确到小数点后一位即可),说明在该范围内模型有临床净收益,无需过于精细。
17.审稿人问:混淆矩阵为什么不提供?
回复建议:混淆矩阵基于 0.5 阈值,而最佳阈值往往不是 0.5,故不常用。敏感度特异度可推导混淆矩阵,可不提供。
五、临床意义与补充实验
18.审稿人问:为什么没有做人机对比?或要求提供模型推理时间、包含预处理时间等。
回复建议:模型推理本身是毫秒级,不包含人工勾画/预处理时间。可说明是初步探索,或承认局限性。人机对比涉及主观因素,可给出合理时间分布,审稿人无法复现。
19.审稿人问:为什么不做其他终点(如 PFS)?为什么不做基因/病理组学?
回复建议:可拒绝,称当前数据不允许或正在随访收集中,画饼说“在下一份工作中正在开展”。这是典型的“why not”问题,无需真做。
20.审稿人问:多变量回归中是否考虑了某些临床因素的影响?要求补充基线表或亚组分析。
回复建议:若数据缺失多,可回复已收集但缺失严重故删除;或做组间差异性检验,若无显著差异,可说明无需额外调整。