ARTICLE · 1230446
英文PDF翻译成中文,先看能不能选中字,选不中的得先识字
英文 PDF 要翻成中文,头一步不是挑翻译工具。是打开它,Ctrl+A 全选,看字能不能被选中。
能选中,说明这份文件里有文字层,往后哪个翻译工具都吃得进去。
选不中,它其实是一叠照片。工具再能干,也得先从图上把字认出来。
这个判断我拿两份文件试了一遍。
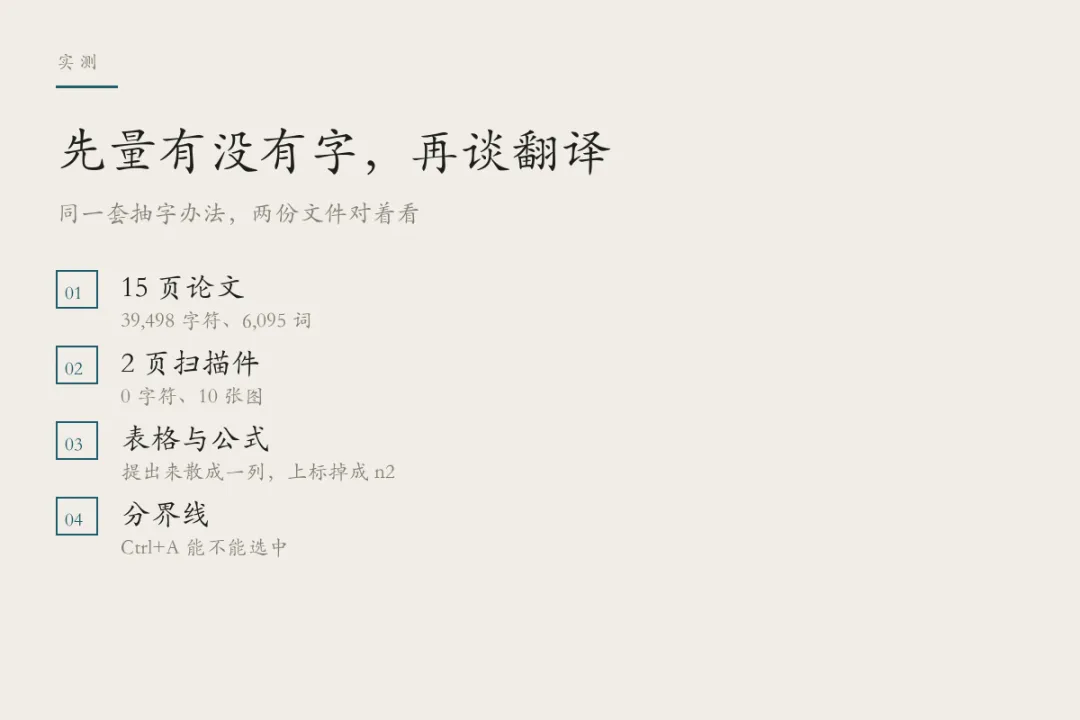
一份是 15 页的英文论文,arXiv 上那篇讲 Transformer 的原文,2.11 兆,用脚本把文字抽出来,39,498 个字符,6,095 个词,跑了两秒就出来了。
另一份躺在桌面上,2 页,0.68 兆。
抽出来的字数是 0。两页都是 0。
翻到页面上看,全是图片,一页六张,一页四张,多半是拿手机扫出来的,或者截图存下来的,看着就不像排出来的字了。
同一套抽字的办法,一份 39,498,一份 0。
有文字层,也不等于翻完就能读了。
那篇论文里的 Table 1 是三列对照表,提成纯文字以后变成一格一行,表头、单位和数值全断了联系,公式里的上标也掉下来,O(n²·d) 变成了 O(n2 · d),看着像 n 乘了个 2。
翻译工具只负责把英文换成中文。
散掉的表格,它拼不回去。
再说钱,这一步白折腾的人不少。
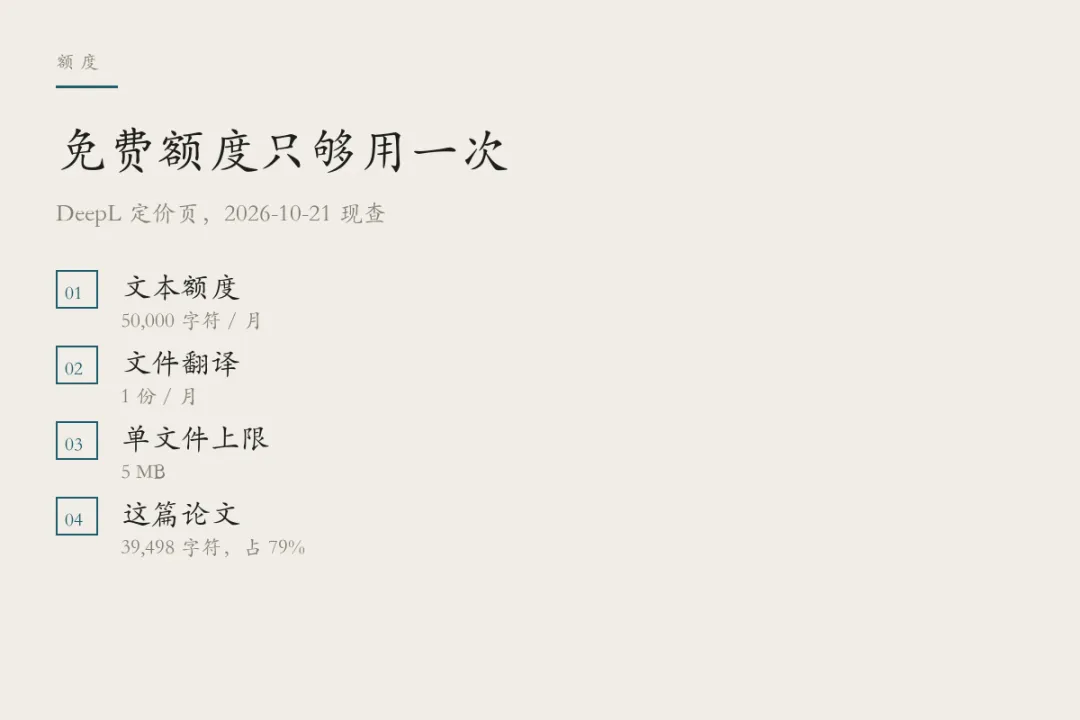
DeepL 官网的定价页我今天现查了一遍:免费版一个月 50,000 个字符,文件翻译 1 份,单个文件不超过 5 MB。那篇论文 39,498 个字符,差不多是整个免费额度一个月的 79%,整篇走文件翻译,这个月就只剩这一份了。
所以常见的翻车不是翻得差,是一上来把整篇传上去,把一个月只发一份的文件额度,花在一份你其实只想看摘要的东西上。
只想看懂两段的话,额度根本不用动。
微软 Edge 那个 PDF 阅读器的官方说明写得很直接:选中要翻的文字,点工具栏的翻译图标,或者右键点一下翻译所选内容,支持 70 多种语言。它只翻你选中的那一块,结果贴在侧边栏放着。
不是整篇给你一个译文文件。也别指望它保住原来的排版。
选不中的那种,卡点根本不在翻译上。
桌面上那份 0 字符的 PDF,丢进任何文档翻译,头一步都是先认字。
认错一个字,译出来就错一个字。
字小、带表格、有手写的扫描件,认错的概率就更高了。
具体高多少,我给不出数。
手上没有标好答案的样本可以对照,这句只能说到这了。
还有人推过 pdf2zh,说翻完排版基本不动。那篇是两天前发的,思路是先把 PDF 拆成能认的结构,再一段段翻回去。它要装 Python 环境、要配模型密钥,我没装,所以这条路上到底能保住多少排版,我说不了。
回到省事的那条判断线,三步就够。
一步,Ctrl+A;选不中,先去做文字识别,别在翻译工具里绕圈了。
两步,把选中的文字粘到记事本,看一眼。一行里左右两栏接在一起,或者每页都重复着页码,就说明排版是散的,靠复制粘贴翻不出能看的东西。
三步,能选中、只想看几段,用 Edge 选中就翻;真要整篇译文呢,再动那个每月一份的额度,留给真需要的那份文件吧。
翻不翻得动,跟工具贵不贵关系不大。先看这份文件里有没有字,比先挑哪个软件,早了整整一步。