ARTICLE · 1235997
DeepSeek-OCR开源,一整页文档,压缩成几百个token
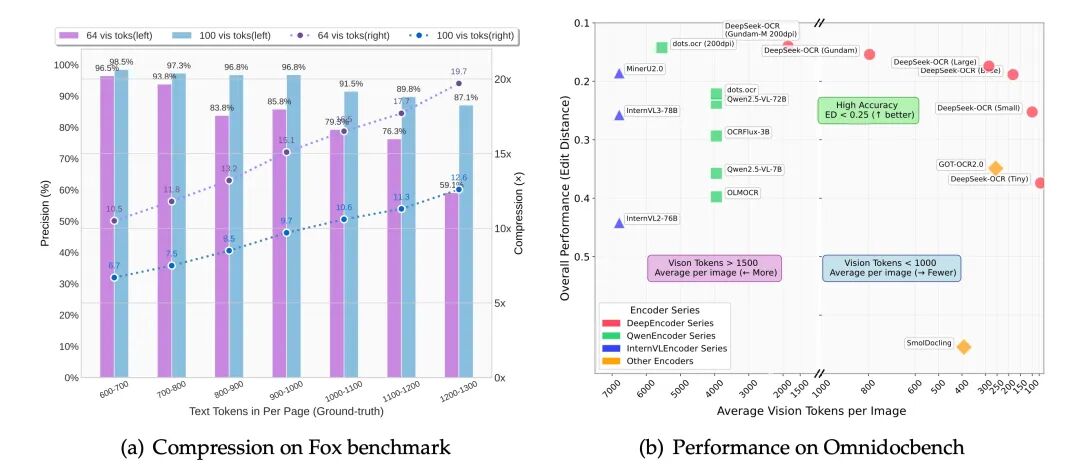
DeepSeek 开源了一个名为 DeepSeek-OCR 的 OCR 模型,核心创新是“上下文光学压缩”——把整页文档或图像压缩成极少量的视觉 token(模型可理解的“图像片段”),再交给大语言模型处理,在探索视觉文本压缩极限的同时大幅降低 token 开销。
要点
发布节奏:2025 年 10 月 20 日发布 DeepSeek-OCR;10 月 23 日获上游 vLLM 官方集成支持;2026 年 1 月 27 日推出全新升级版 DeepSeek-OCR2。
核心理念:从大模型中心视角研究视觉编码器的作用,用尽可能少的视觉 token 承载尽可能多的文本信息,相当于把一整页书“速记”成几行浓缩信息再还原。
压缩能力:原生分辨率分四档:Tiny(512×512)仅消耗 64 个视觉 token,Small(640×640)消耗 100 个,Base(1024×1024)消耗 256 个,Large(1280×1280)消耗 400 个;另配有动态分辨率 Gundam 模式(n×640×640 + 1×1024×1024),可无缝拼接处理超大页面。
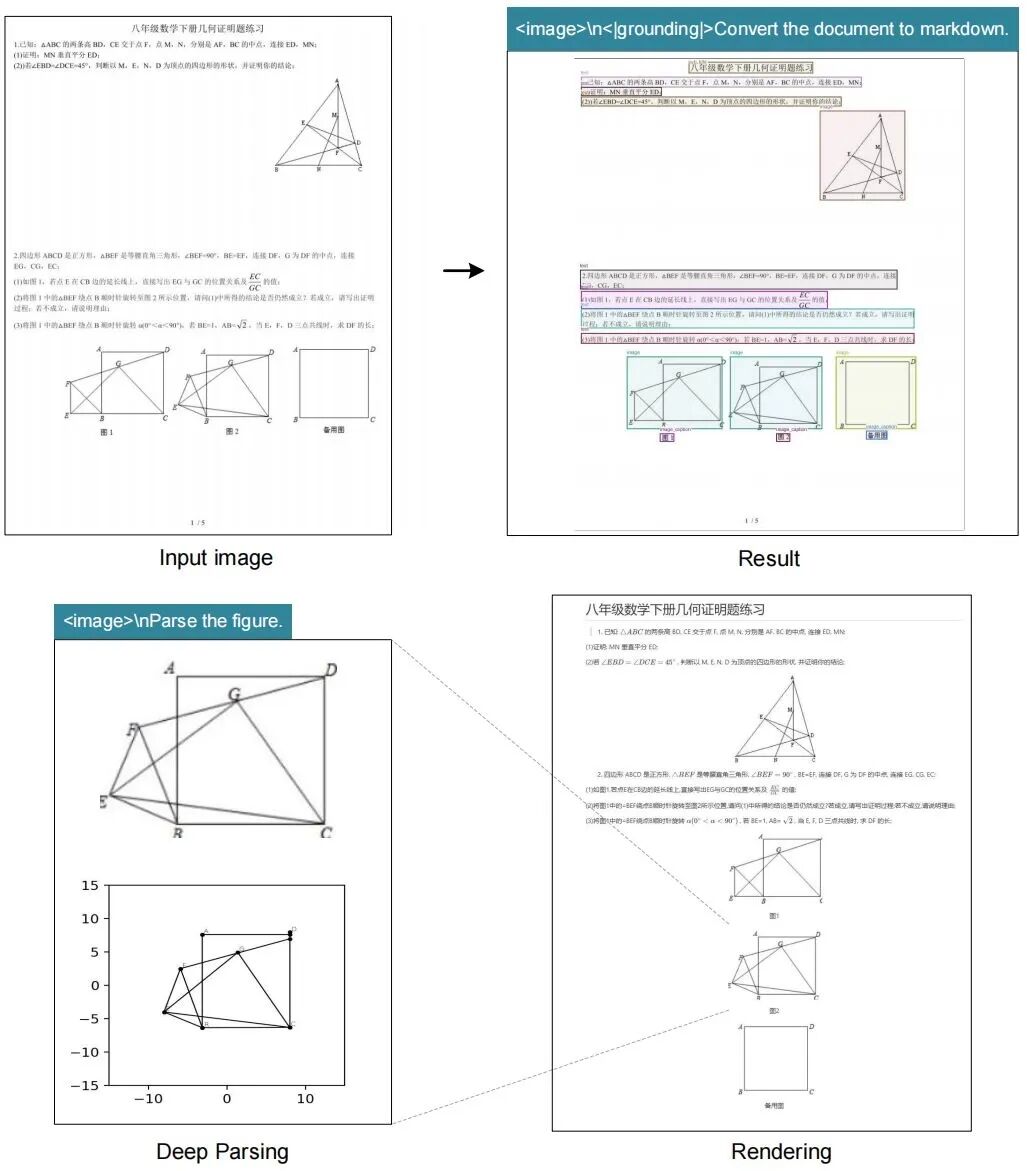
任务覆盖:通过输入不同提示词,可直接执行文档转 Markdown(保留完整版面结构)、自由通用 OCR、图表解析、图像细节描述、按引文坐标定位文字等多项复杂任务。
性能参考:在单张 NVIDIA A100-40G 显卡实测中,PDF 并发处理速度约为 2500 tokens/s。
推理方案:官方同步提供 vLLM(适合批量、高吞吐工业场景)与 Transformers(适合快速验证与上手调试)两套推理实现。
学术生态:技术论文同步公开于 arXiv(编号 2510.18234),模型权重托管于 Hugging Face;并在项目实现中公开致谢了 Vary、GOT-OCR2.0、MinerU、PaddleOCR 等前作贡献。
上手
硬件门槛:官方基准环境为 CUDA 11.8 + PyTorch 2.6.0,必须配备 NVIDIA 独立显卡(性能指标基于 A100-40G);无 N 卡或显存较小的普通家用设备基本无法完成本地部署。
环境依赖:需使用 Conda 创建 Python 3.12.9 环境,并手动下载安装指定的 vllm-0.8.5 whl 离线包;flash-attn 必须锁定 2.7.3 版本且安装时需附加
--no-build-isolation参数,环境依赖错配是新手最常见的报错卡点。报错忽略:在安装依赖环节,若终端出现
vllm 0.8.5+cu118 requires transformers>=4.51.1的警告提示,官方明确说明可直接忽略,并不影响 vLLM 与 Transformers 框架共用同一环境。获取形态:无一键安装包或便携版,纯开源代码仓库形态:需通过 GitHub 克隆工程代码并前往 Hugging Face 下载模型权重;若选择上游 vLLM 官方路线,在 v0.11.1 正式发布前需拉取 nightly 版本安装。
项目由 DeepSeek AI 开发,当前 24.1k Stars。
❝项目地址:github.com/deepseek-ai/DeepSeek-OCR