ARTICLE · 1242354
5 个 AI 提示词模板,专治“写得出但不好用”
「正文」
晚上清理手机发现备忘录里一直躺着一类废稿,也不是完全不能用,大多文字通顺结构完整,发给同事也能看懂,但真拿去干活的时候,总觉得哪里差一口气,AI 返回的东西像那么回事,却总要再花半小时改,改完回头一看,跟重写也没差多少。
问题不是出在“会不会写提示词”,出在写出来的提示词「能读,但不能执行」。
最近拿 Seedance 2.5 做视频的时候,这个感受特别明显,它的指令遵循能力比上一代好了一大截,镜头时长写几秒基本执行几秒,人物停顿和动作也比以前稳,变得更听话了,却还没有真正做到更懂人,你写“商业感”“高级一点”,它理解不了;你写“一个穿米色风衣的女人慢慢转身”,它就真的只做一个转身,多一个细节都不给。
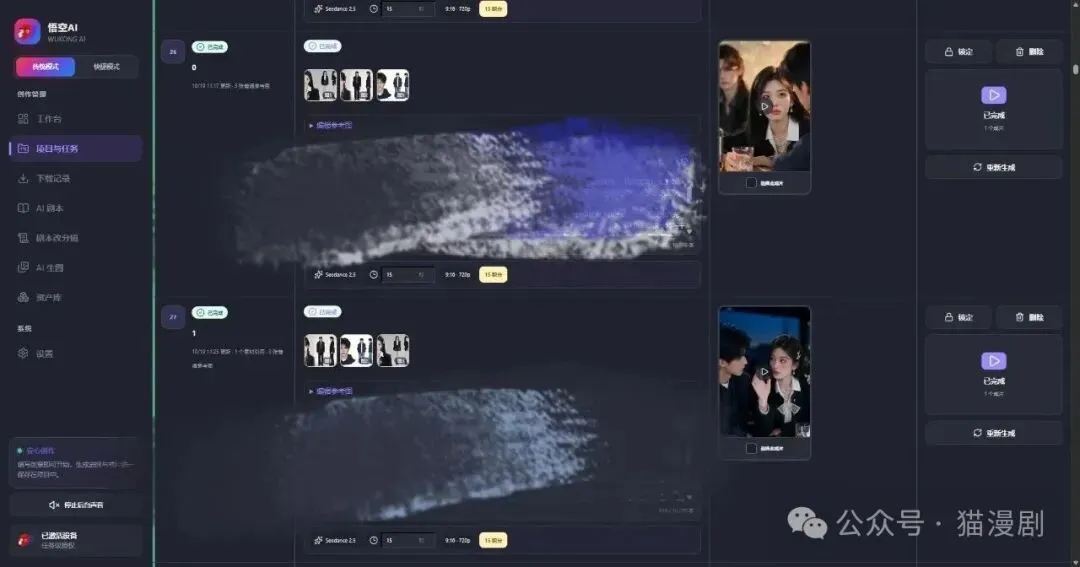
这恰恰暴露了一个被很多人忽略的事实:「AI 不补全你的意图,它只执行你的句子」 你没写的,它就用默认值填,默认值通常平庸,或者跑偏。
下面这 5 个模板,不是“提示词写作大全”,而是我自己反复踩坑之后留下来的「执行层修补工具」每一个都针对一种“写得出但不好用”的具体症状。
模板一:不变项锁定——专治「出来是对的,但长得不像了」
最让人泄气的翻车,不是生成失败,是生成了一条“对但不对”的东西。产品形状还在,logo 歪了;人脸还在,气质变了;衣服还是那件衣服,颜色跑了两档。
Seedance 2.5 的故障排查文档里把这个叫 subject changes shape:标签弯折、面部漂移、服装突变。原因通常不是你描述得不够多,而是你「把太多东西交给了模型去“自由发挥”」。
「模板结构:」
❝❞
保持不变:______(脸/产品形状/颜色/构图/光线方向) 只允许发生变化:______(一个动作或一个视觉变量)
图生视频尤其需要这个,官方指南里有一句话:最忌把照片重新描述一遍,先锁定不能变的部分,你不需要告诉它“这个人长什么样”,参考图已经说了。你需要告诉它的是——「哪些东西不许动」。
一个可以顺手改的句式:「“保持参考图中的脸型、发型、服装和光线方向不变,只让头部做一个缓慢的转向”」 就这一句,比堆三个形容词管用。
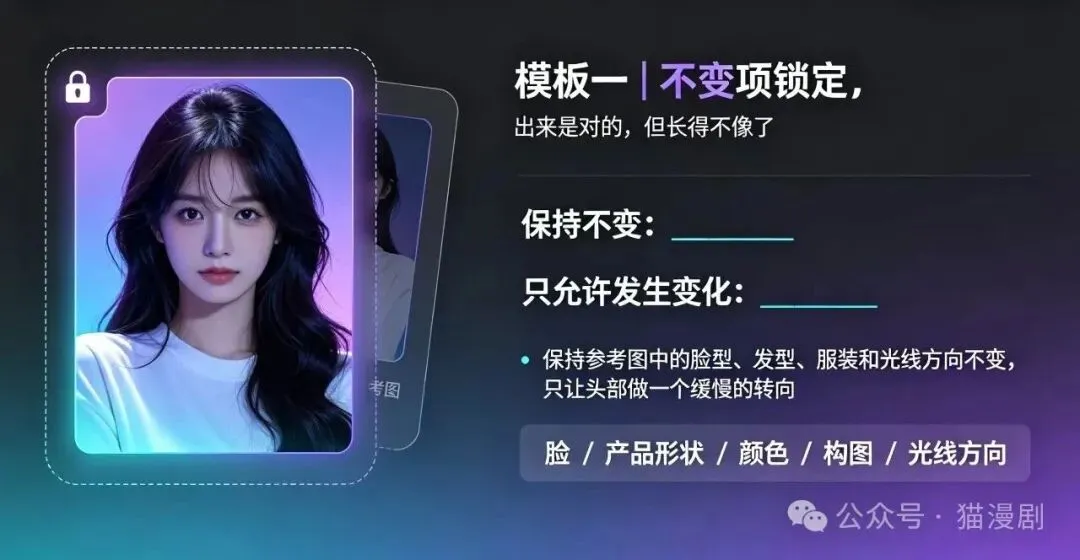
这个模板的底层逻辑很简单:把“生成”变成“在约束下生成”,你锁得越具体,它乱猜的空间越小。
模板二:单动作节拍——专治「动作像被快进了三倍」
我有一段时间特别爱在一条提示词里塞动作:走过来、拿起杯子、喝一口、放下、笑一下,写的时候觉得很完整,生成出来一看,每个动作都像有人在后面催它,走路带风,喝水像赶场。
Seedance 2.5 处理单条连续动作弧的能力,远远好过处理一堆互不相干的动作堆叠,你给三个动作,它不会平均分配时间,而是会自己“压缩”出一条看起来完成度最高的路径,结果就是所有东西都快了半拍。
「模板结构:」
❝❞
开始:______(起点画面) 变化:______(一个动作,只写一个) 结束:______(停在哪个画面)
故障排查文档给出的修复逻辑就是这个三段式:开始、变化、结束,然后最多配一个支持这个节拍的镜头运动,10 秒左右的片段,60 到 120 个词的提示词就够承载一到两个节拍,不是写得越长越“专业”,写得越长,模型越可能只抓前半段,把结尾丢掉。
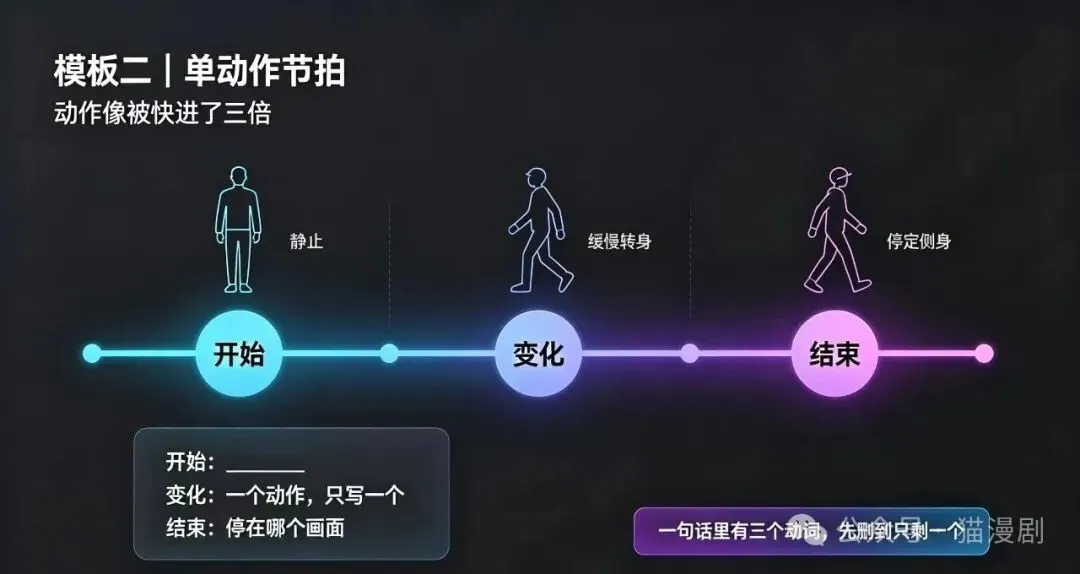
我现在写动作提示词的习惯是:「如果一句话里有三个动词,先删到只剩一个,再生成」 删掉的那个,往往是你本来就不需要它做的事。
模板三:单运镜指令——专治「镜头不知道在急什么」
镜头是最容易写“爽”的部分。推、拉、摇、移、环绕,全写上,感觉像在写分镜,Seedance 2.5 确实吃镜头指令,但它的吃法是:「如果你同时给多个运镜动词,它们会竞争,最后赢的那个不一定是你想要的那个」。
一个具体症状:你写“环绕产品,同时缓慢推近,最后定格在 logo”,结果它又转又推又切,节奏乱成一团,排查文档的建议很干脆:先保留一个运动,并且写明起点和终点。
「模板结构:」
❝❞
景别:______(中景/近景/特写) 运动:______(推/拉/摇/环绕,只选一个) 端点:从______开始,到______结束。速度:______
这个模板不负责“好看”,负责「可预期」,Seedance 2.5 对镜头语言的服从度已经相当高了,你给得越干净,它执行得越准。
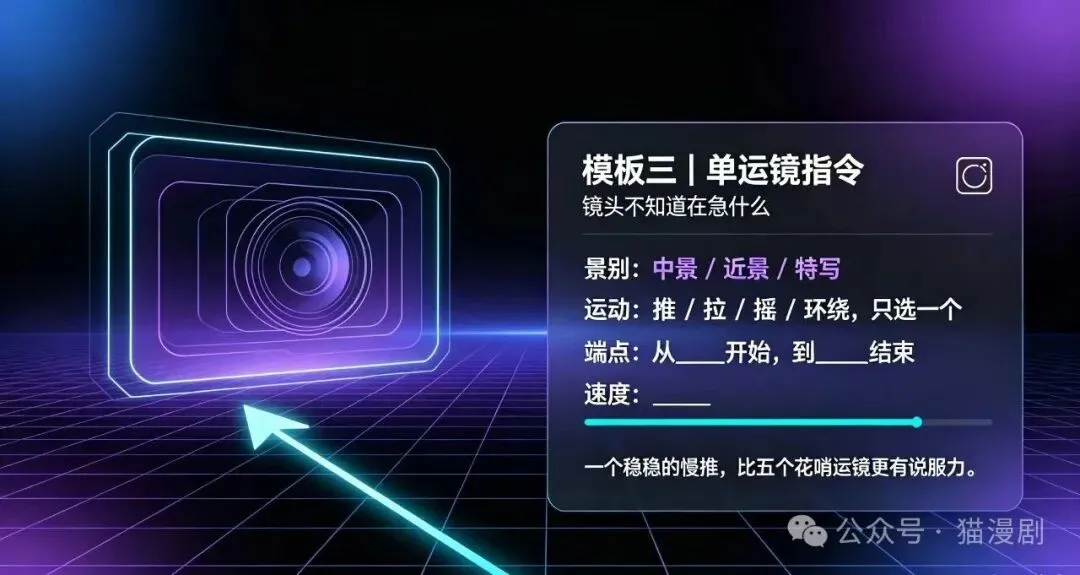
真正拍过东西的人都知道,一个稳稳的慢推,比五个花哨运镜剪在一起更有说服力,提示词也一样。
模板四:参考素材分工——专治「素材越多,画面越乱」
Seedance 2.5 把参考素材上限拉到了 50 个,图片、视频、音频、文字可以混着来,这听起来是好事,但用不好会加速翻车:每份素材都在向模型“喊话”,身份、风格、场景互相污染,最后出来一个四不像。
一份实测报告里,一位漫剧导演的做法值得直接抄:把女王、唐僧、孙悟空、宫殿和城门分别作为参考,「每份素材承担一个清晰的职责」,写提示词时指定谁负责身份、谁负责场景、谁负责动作。
「模板结构:」
❝❞
@素材1 只负责:______(身份/产品外观) @素材2 只负责:______(场景/环境) @素材3 只负责:______(动作参考/风格参考) 所有素材共同遵守:______(不变项)
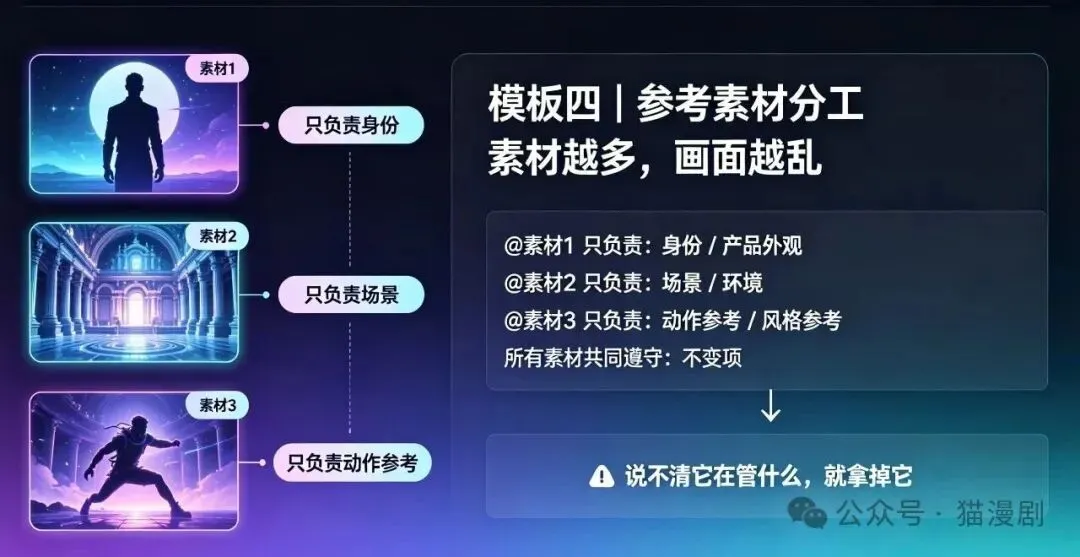
这条模板的本质不是“多给素材”,而是「给每份素材划边界」,素材越多,边界越要清楚,如果一份素材你自己都说不清它到底在管什么,拿掉它,画面会干净很多。
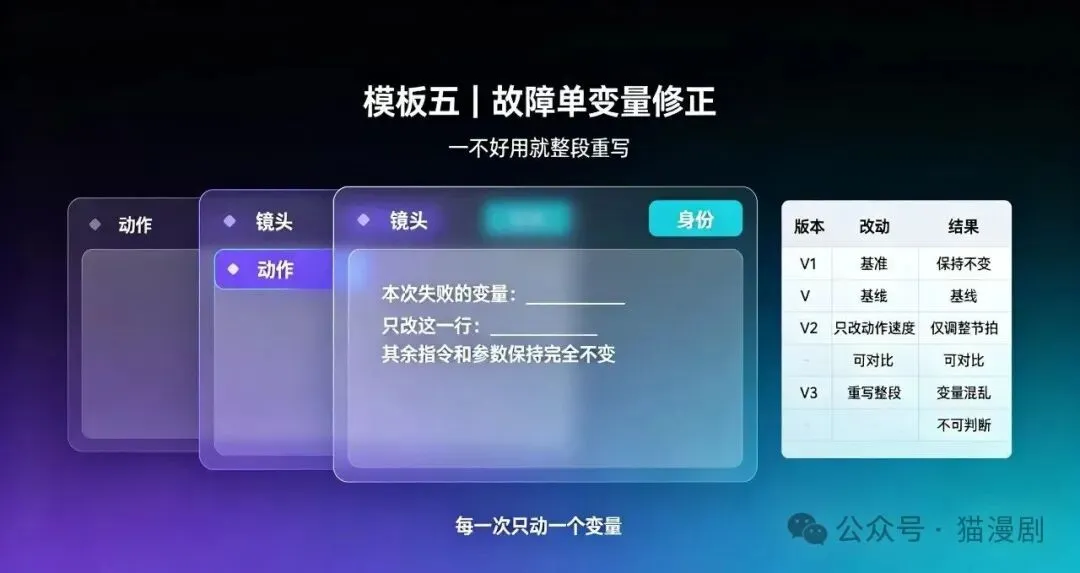
模板五:故障单变量修正——专治「一不好用就整段重写」
这是五个模板里最“反直觉”的一个,也是我觉得最值钱的一个。
以前的习惯是:生成结果不对,回去把提示词从头到尾改一遍。改完再生成,还是不对,但已经不知道是哪个改动起了作用,还是哪个改动把原来的对也改没了。
Seedance 2.5 的排查逻辑恰恰相反:「不要立刻重写整个提示词。先识别失败的是哪一个变量——动作、镜头、身份、光线、音频还是连续性——下一次只改那一个变量,其他全部不动」。
「模板结构:」
❝❞
本次失败的变量:______(从上面六个里选一个) 只改这一行:______ 其余指令和参数保持完全不变
这条模板不生成内容,它「生成信息」,你每一次只动一个变量,才能知道到底是哪句话在起正作用,哪句话在帮倒忙,三次单变量对比之后,你手里留下来的那版提示词,才是真正“能用”的版本,而不是碰巧这次对了的版本。
我甚至觉得,前面四个模板都是“怎么写”,只有这个模板是“怎么不再写废”。
写到这里,我越来越觉得提示词这件事被过度复杂化了,市面上有太多“万能公式”“高级结构”,但真正让一条提示词从“写得出”变成“用得上”的,往往不是加了什么,而是「删掉了什么、锁住了什么、一次只动了一个什么」。
Seedance 2.5 已经足够听话了,它的问题不是不执行,是执行得太老实——你给的句子是什么样,它就还你什么样,所以下一次打开对话框之前,可以先问自己一句不那么像“提示词课”的问题:我写的这句话,是在描述一个愿望,还是在交代一个操作?
如果是愿望,它大概率会还你一个看起来差不多、改起来很累的答案,如果是操作,它才有机会一次就把事情做对。
上面五个模板,不需要背,收藏起来,下次哪一条生成结果让你皱眉头了,翻出来对着改一行就行,真正好用的提示词,从来不是写出来的,是「修」出来的。