ARTICLE · 1246640
看到好功能却没源码?4.4万 Star 的 REA 让 AI 替你把应用拆解到底
日常开发中,我们几乎每天都会遇到这样的时刻:看到某个桌面客户端或 Web 应用里的某个交互细节极其丝滑,或者某套离线检索、本地存储机制做得非常精妙,很想在自己的项目里做一套类似的,但翻遍开源社区也找不到它的源码。
过去面对这种场景,面前通常只有两条路。
第一条路是全凭直觉黑盒猜测。对着界面录屏或抓包,自己从零猜状态机和底层调用,往往耗费数周时间写出来的逻辑,依然在边界情况频频踩坑。
第二条路是搬出传统的逆向工程全家桶。下载安装 Ghidra、Hopper 或 IDA,面对密密麻麻的十六进制汇编、符号表和反编译伪代码,没有数年逆向背景的开发者往往看两眼就直接放弃。
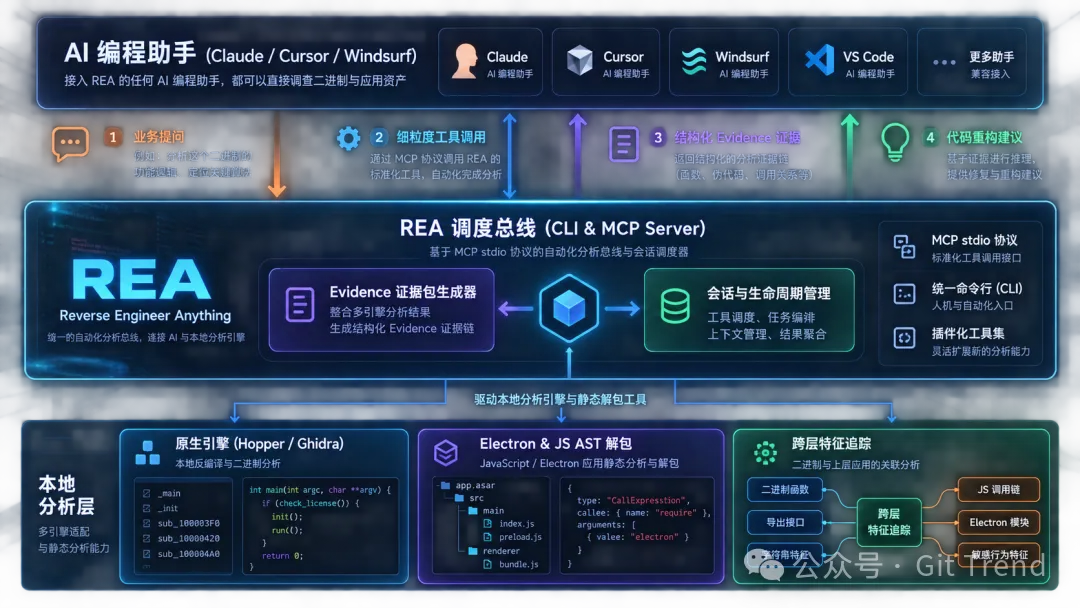
而近期在 GitHub 斩获 4.4万 Star 的开源项目 REA(Reverse Engineer Anything),正是为了打破这种困境。它把逆向分析的核心能力包装成了标准 MCP 工具集与统一命令行,让任何接入它的 AI 编程助手都能直接替你调查二进制与应用资产。
项目卡片
项目:REA[1] 状态:v4.1.0 / 4.4万 Stars / 125+ MCP 调查工具 一句话判断:首个真正让 AI 智能体掌握工业级反编译与动静态取证能力的逆向中间件,让没有逆向背景的普通开发者也能直接向 AI 提问应用深层原理,并无缝重构出可用代码。
很多开发者一听到逆向工程,第一反应依然是安全攻防、破解或恶意软件分析,觉得离自己的业务开发太远。
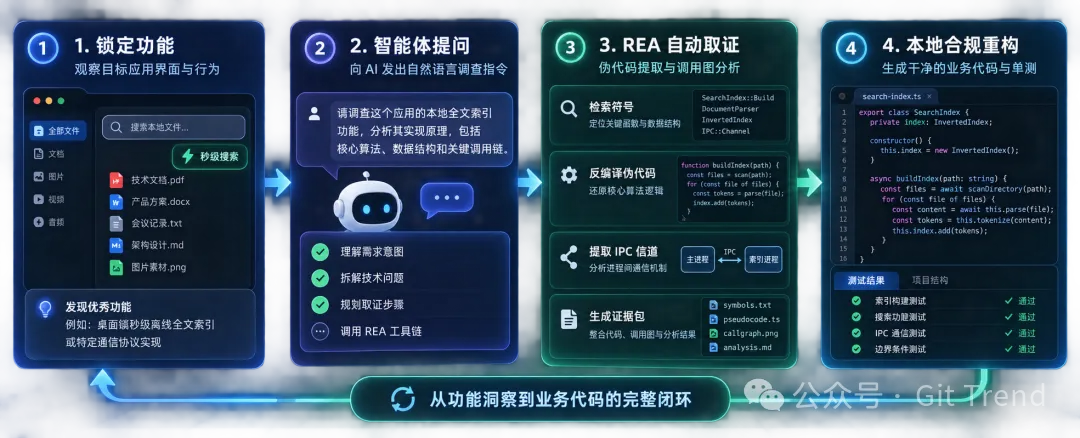
但 REA 切入的完全不是破坏性场景,而是产品功能理解与工程重构。它的逻辑极其简单:你不需要成为汇编高手,只需要向 AI 提出一个具体的业务问题。
例如面对一个现成的待办或笔记应用,你不再需要去学复杂的逆向指令,而是直接向接入 REA 的智能体发问:“调查这款应用的离线全文检索机制,找到它是如何处理分词与本地 SQLite 索引的,展示取证链条,并在我的项目中用 TypeScript 重写一份”。
智能体接到指令后,并不会凭空幻觉猜测,而是通过 REA 的底层协议调动分析工具:从定位二进制入口、提取内嵌字符串与符号表,到追踪交叉引用与调用图,最后锁定对应的关键函数逻辑。
更重要的是,REA 强调证据链条与语义还原。它在返回反编译结果的同时,会把伪代码、调用关系与置信度作为证据(Evidence)打包交代清楚。开发者拿到的是经过 AI 消化后的架构推演和可运行代码,而不是一堆冰冷的寄存器指令。
在此之前,让大语言模型参与逆向分析几乎是个伪命题。
一方面,把动辄几十兆的二进制文件直接塞进上下文窗口既昂贵又不现实;另一方面,传统的分析工具各自为战,GUI 交互极其复杂,AI 根本无从下手。
REA 解决的核心问题,是构建了一套统一的自动化分析总线。
在本地运行时,REA 既是一个独立的命令行工具,也是一个兼容标准模型上下文协议(MCP)的本地服务。它将庞大的反编译动作解构为细粒度的工具原子,涵盖原生二进制检查、调查工作流追踪、Electron 与 JavaScript 产物图解包、以及运行时观察等。
对于最常见的 JavaScript、Electron 桌面客户端或 ASAR 包,REA 甚至无需任何原生反编译引擎。你只需要在终端敲下一行静态分析命令:
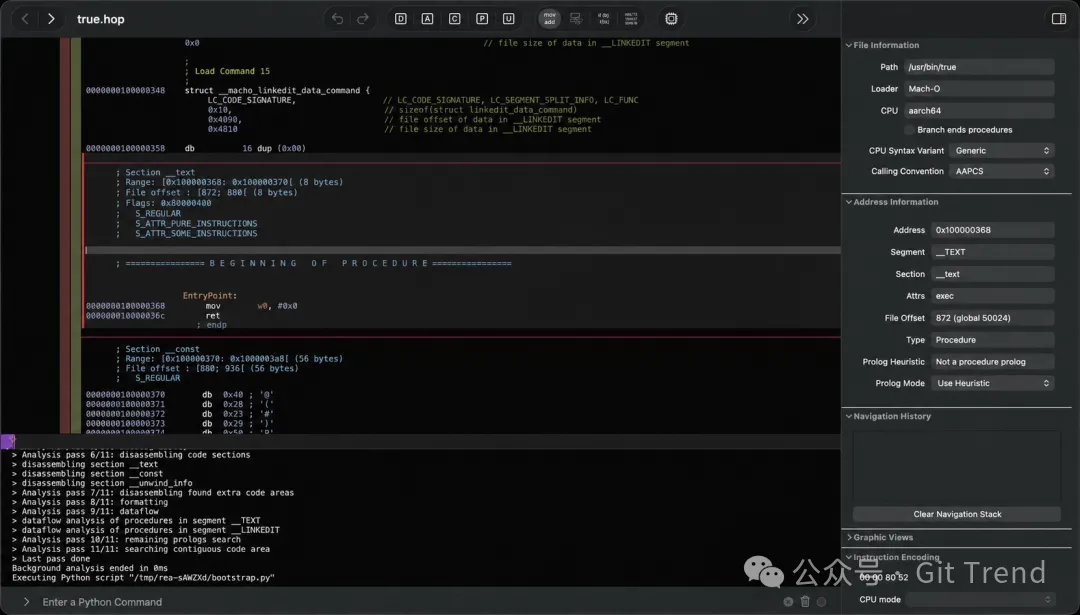
npx -y rea-agents@latest analyze-javascript-application /path/to/app --jsonREA 就会在本地毫秒级提取出整个应用的路由结构、IPC 通信信道、原生导出以及模块依赖图谱,直接吐出结构化的取证记录。而在需要深入原生代码时,它又能无缝桥接本地的 Hopper 或 Ghidra,按需拉取特定函数的伪代码。
这种分层设计让整个分析过程完全在本地机器上运行,既保护了开发者的本地资产隐私,又避免了频繁启停厚重分析软件的上下文丢失。
想要把 REA 用起来,体验门槛被压到了令人惊讶的程度。
对于日常已经在使用 Claude Code、Cursor、Windsurf、VS Code 或 Antigravity 的开发者,甚至不需要手动修改繁琐的 JSON 配置文件。直接在终端执行官方提供的引导式向导:
npx rea-agents setup交互式终端会自动探测你当前机器上已安装的 AI 客户端,展示明确的配置变更方案。获得批准后,它会一键完成 MCP 服务的注册与工作流 skill 的挂载。如果日后想清理,也可以随时通过对应命令彻底移除。
但在兴奋地尝试分析各种应用之前,有三个客观的技术边界需要保持清醒认知。
首先是原生反编译引擎的前置依赖。虽然静态分析 JavaScript/Electron 完全免依赖,但如果你想分析 macOS 上的原生 Mach-O 或 Linux 上的原生 ELF 二进制,本地仍需配置 Hopper 或 Ghidra。REA 自身是桥梁与驱动器,并不捆绑任何商业软件的破解许可。
其次是逆向的法律与版权边界。REA 的核心定位是学习架构设计、协议互操作性与自研功能参考。它不提供原始源码的绝对复原,也不支持一键克隆整个应用。所有分析结论应严格用于自研代码的逻辑推导,规避直接复制受版权保护的专有资产。
最后是本地运行时的权限隔离。REA 的设计理念是将一切分析收敛在本地环境,不上传任何文件到云端托管逆向平台。但它本身不是沙箱,运行不可信分析时依然依赖宿主当前用户的系统权限,因此对待未知来源的可执行文件仍需保持审慎。
如果你想继续看这类 AI 工具拆解,我会把上手路径、关键限制和可复用配置整理成清单,方便你直接判断值不值得试。
[1]REA: https://github.com/morluto/rea