ARTICLE · 1251053
AI调用成本竟然能省90%?看懂这个“小抄机制”,你的API账单会瘦一大圈!
同样是调用AI,有人月底账单肉疼到想哭,有人却淡定喝咖啡。
差别在哪?先问你一个问题:
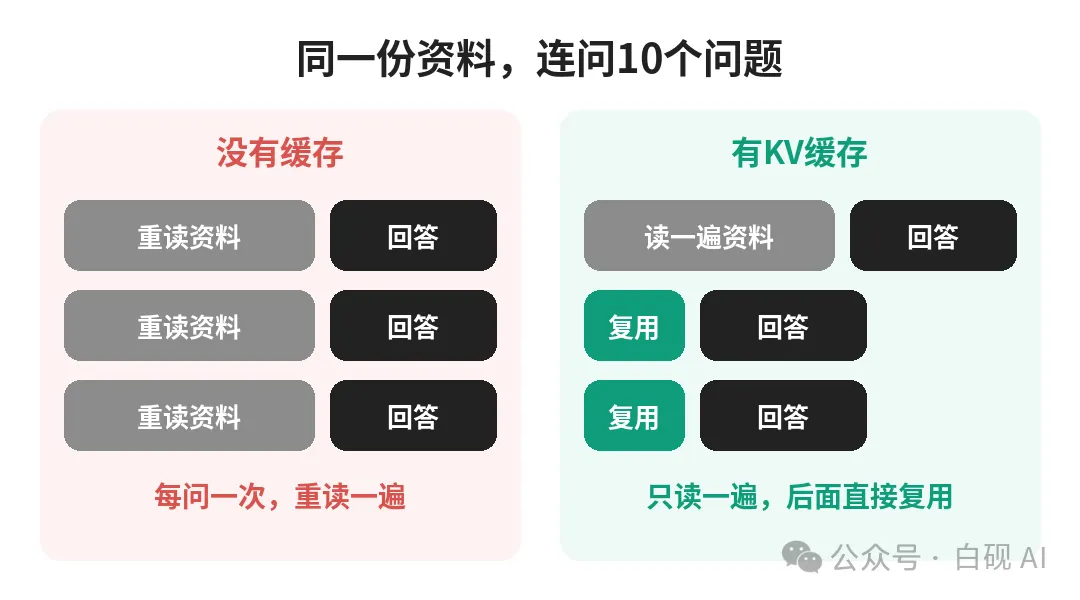
你让AI读一份几万字的资料,然后连着问它10个问题。它是不是每答一题,就把整份资料重新“啃”一遍?
如果是,那就好比你请了个翻译,每说一句话,他都要把整本书从第一页重新翻到最后一页。累不累?累。贵不贵?贵得离谱。
对普通用户来说,这只是个技术细节。但对每天调用成千上万次大模型的开发者、正在搭建AI Agent的团队来说,这可能就是一张烧钱的账单。
破解这个难题的主角,就是今天要聊的:
🔑 KV Cache(KV缓存)
名字听着很硬核,原理却简单得像“考试带小抄”。别走开,三分钟讲明白。
01|KV缓存是什么?一个“做题大法”就懂了
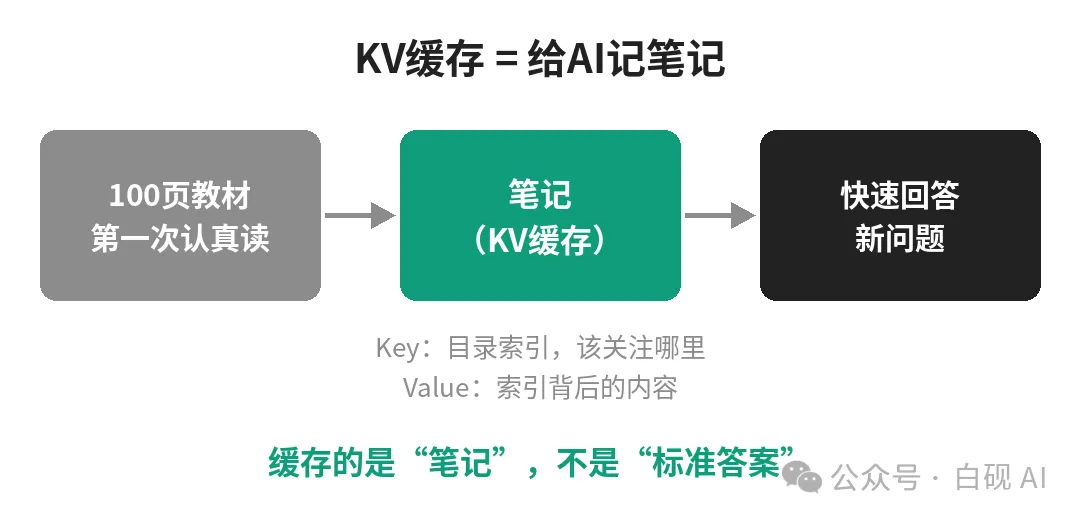
想象你是个学生。老师甩给你一本100页的教材,说:“接下来我要问你5道题。”
第一题:你老老实实翻开教材,划重点、做笔记、理思路,终于答出来了。累得够呛。
第二题:老师又抛来新问题。这时候,你会把100页教材重读一遍吗?当然不会!你脑子里已经有了知识框架,顺着笔记找到相关内容,几秒钟就能作答。
KV缓存,干的就是这个“记笔记”的活。
大模型读文字时,在“注意力机制”里会产生两种重要的中间成果:
🗝️ Key(键):像书的目录索引,帮模型判断“该关注哪里”
📦 Value(值):像索引背后的内容,提供“关注到的信息是什么”
这些中间成果可以存进缓存。下次遇到相同的开头内容,模型就能直接“翻笔记”,不用重新算。一句话总结:第一次认真算,后面能复用的,绝不重复算。
⚠️ 常见误会,必须澄清
KV缓存存的不是AI写好的答案,而是它思考过程中的中间状态。缓存命中,不等于AI“复制粘贴”以前的回答,它依然会理解你的新问题,生成全新的回复。打个比方:缓存存的是“笔记”,不是“标准答案”。
02|“缓存命中”是啥?为什么有人能省90%?
再认识一个关键词:缓存命中(Cache Hit)。假设你在做一个AI客服,每次请求包含三块内容:
📌 第一块:固定的系统提示词
📚 第二块:5万字的公司产品手册
💬 第三块:用户当下的问题
第一次调用:用户问:“你们产品有哪些功能?”AI老老实实把三块内容全部处理一遍。
第二次调用:另一个用户问:“产品怎么收费?”这时前两块内容一字不差,只有最后的问题变了。AI心想:“这5万字我刚读过,笔记还在呢!”于是直接复用,只处理新问题。
🎯 这,就是缓存命中。
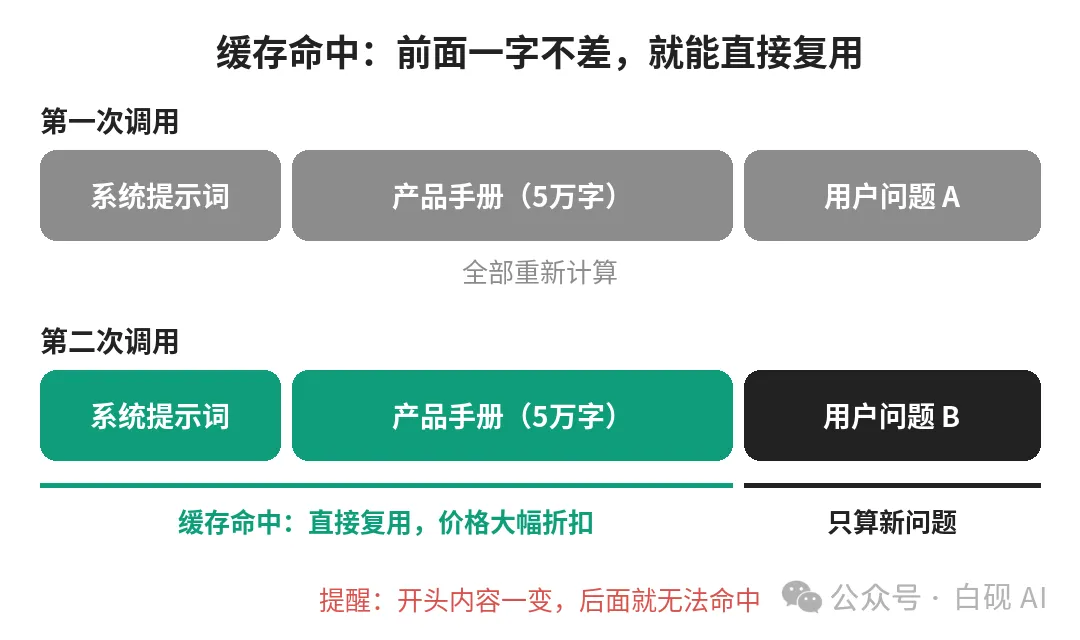
反过来,如果你每次都改提示词、换资料顺序,或在开头塞一个不断变化的内容……就像每次都把笔记本撕掉重写,缓存直接“未命中”,白白浪费。
那到底能省多少钱?
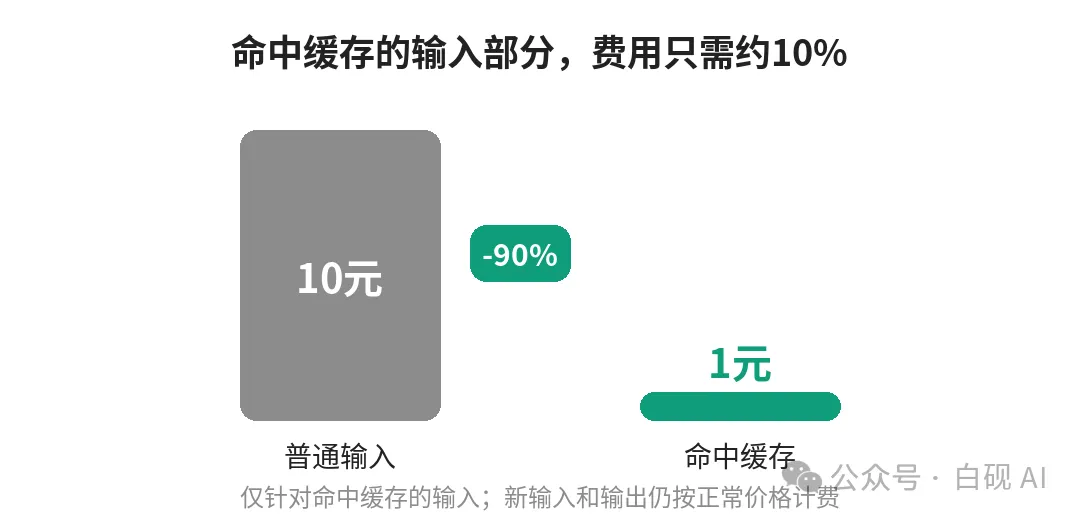
部分大模型API对命中缓存的输入给出了大幅折扣。以“缓存读取价是普通输入价的10%”为例:
但先别急着开香槟,冷静看三个前提:
1. 优惠针对的是符合条件的缓存输入,不是整次调用的全部费用
2. 新增输入和AI生成的输出Token,依然正常计费
3. 首次建立缓存可能有写入费用,各家平台规则不一样
所以准确的说法是:不是所有调用都能省90%,但重复内容越多,省得越狠。具体能省多少,取决于命中比例、输入输出结构和平台的计费政策。
03|为什么AI Agent团队,尤其要盯紧缓存?
如果你只是偶尔和AI聊聊天,缓存的存在感可能不强。但AI Agent,是缓存的“头号受益者”,也是“头号烧钱户”。
什么是Agent?简单说,它不只是回答问题,而是能自己拆任务、连续干活的AI助理。比如你说:“帮我研究新能源汽车行业,分析竞争格局,写份报告。”它会这样干活:
1. 🔍 搜索行业资料
2. 📖 阅读多份研究报告
3. ✂️ 提取关键数据
4. ⚖️ 对比不同企业
5. 📈 分析市场趋势
6. ✍️ 生成完整报告
看起来是一个任务,后台却是一连串的模型调用。更要命的是:每走一步,Agent都要把对话历史、工具说明、已收集的资料一股脑再带上。这就像你每问助理一个新问题,都得把之前所有材料重新念一遍给他听。
如果一个Agent连跑20步,每步都背着同一大坨背景资料,这部分重复成本就会像滚雪球一样越滚越大。可一旦缓存持续命中,这些重复内容就能被“一键复用”。
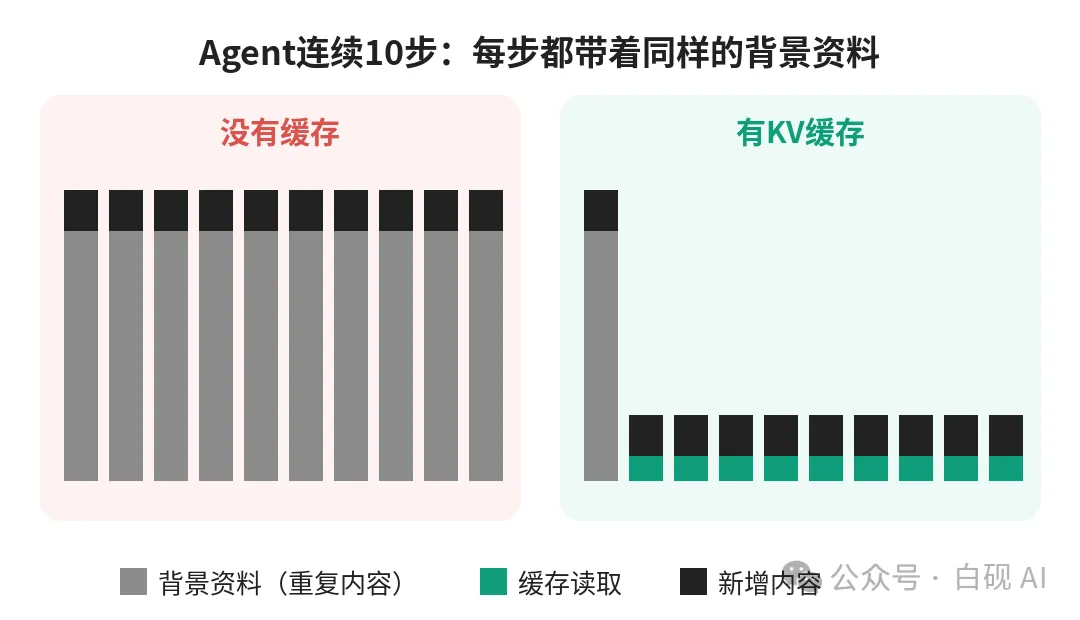
✅ 任务越长
✅ 固定上下文越多
✅ 调用越频繁
缓存的价值就越惊人。而且它省的不只是钱,还有时间:重复处理少了,响应自然更快。所以未来优秀的Agent,不仅要“能干”,还要“会省”。
04|会玩AI的人,都在悄悄做这4件事
知道缓存有用还不够,关键是:怎么让它真正命中?送你4个实战心法。
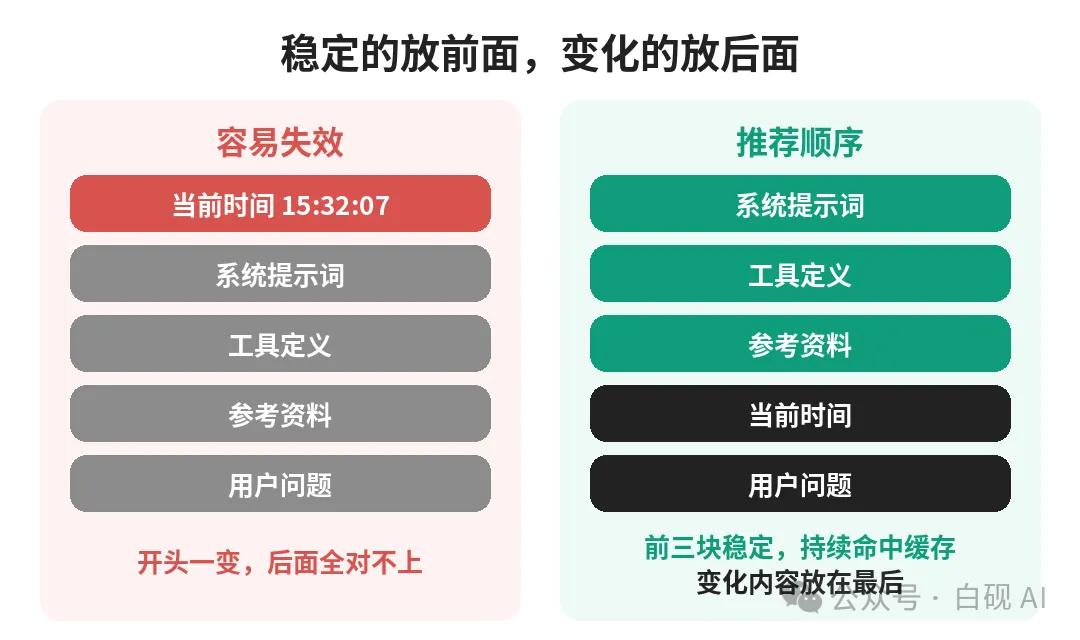
🥇 心法一:固定内容放前面
系统提示词、角色设定、工具定义、长期参考资料……这些“老面孔”很少变化,就让它们稳稳站在最前排。后续请求才更容易共享相同的开头,缓存才有机会“认出来”。
🥈 心法二:变化内容放后面
用户的新问题、最新搜索结果、当前时间、实时状态……这些“善变分子”每次都不一样,请把它们安排在队伍末尾。最典型的翻车现场:
稳定的在前,变化的在后。
🥉 心法三:别乱动提示词和工具顺序
有些开发者喜欢今天改改措辞,明天调调顺序。哪怕意思一模一样,也可能让缓存“认不出你”。因为缓存匹配看的是具体的输入内容和结构,而不是“意思差不多”。在Agent系统里,工具定义及其顺序保持稳定,尤其重要。
🏅 心法四:看数据,别靠感觉
别凭“我觉得命中了”做判断。用API的话,一定要盯这些数据:
📊 总输入Token数
✅ 命中的缓存Token数
💵 缓存读取与写入成本
🧾 不同任务的实际花费
还要留意:有些模型要求输入达到一定长度才有缓存资格,各平台的缓存有效期也不同。不是把内容往前放,就一定能命中。真正的高手,是用数据发现问题,再调整结构。
05|别高兴太早:缓存不是“永久保险箱”
听到这里,你可能会想:“那我缓存一次,以后是不是就能一直白嫖了?”很遗憾,不是。
缓存有“保质期”。不同平台、模型、配置的有效期各不相同:有的适合短时间内连续调用,有的支持更长时间保留。一旦缓存过期、被清理,或新请求不满足复用条件,就得重新计算。所以缓存最适合这些场景:
✅ 长文档连续问答
✅ 持续运行的AI Agent
✅ 基于固定资料的智能客服
而那种每次输入都完全不同的“一次性任务”,缓存的作用就比较有限了。
另外,KV缓存也不是“免费午餐”。保存中间结果要占用存储资源,实际系统里还涉及缓存管理、淘汰、调度等一堆工程问题。说白了,这是一笔资源交换:
花一点存储空间,换更少的重复计算。
06|AI时代的竞争力,藏在这些“小细节”里
过去我们用AI,最关心的是:这个模型够不够聪明?回答准不准?复杂任务能不能搞定?
但当AI真正走进企业流程,成为每天24小时运转的生产力工具,新问题就来了:同样的活,谁能干得更便宜、更快?这时你会发现,缓存、Token管理、上下文设计、模型选择……这些看似不起眼的细节,突然变得价值千金。
KV缓存背后,其实是一个朴素又深刻的思路:别让AI为同样的信息,反复付费。
• 普通用户:懂了原理,就明白AI为什么能越用越高效
• 开发者:掌握缓存优化,可能直接换来更低的API账单
• Agent创业团队:它甚至可能决定你的成本结构和商业化能力
未来AI应用的比拼,不只是谁的模型更强,更是谁能把模型用得更聪明。
会用AI,是第一步。让AI高效干活,才是真本事。
写在最后:三句话划重点
1. KV缓存能复用已算好的中间结果,减少重复计算。
2. 缓存命中能降低符合条件的输入成本,但不等于整次调用都省90%。
3. 固定内容放前面,动态内容放后面,是提高缓存命中的黄金法则。
当你真正理解这些,再去搭建AI工作流或Agent,会发现:那些看似不起眼的工程细节,恰恰决定了AI是一个“好玩的玩具”,还是一台可持续赚钱的生产力机器。
💬 最后留个问题
你用AI的时候,更在意回答质量,还是调用成本?欢迎在评论区聊聊,说不定你的“省钱小妙招”,就是别人正在找的答案!
觉得有用的话,点赞、在看、转发三连走起 👍
关注我,用大白话看懂AI技术,一起抓住普通人的AI时代新机会。