ARTICLE · 1251306
重写110个App,就为练一个手机Agent
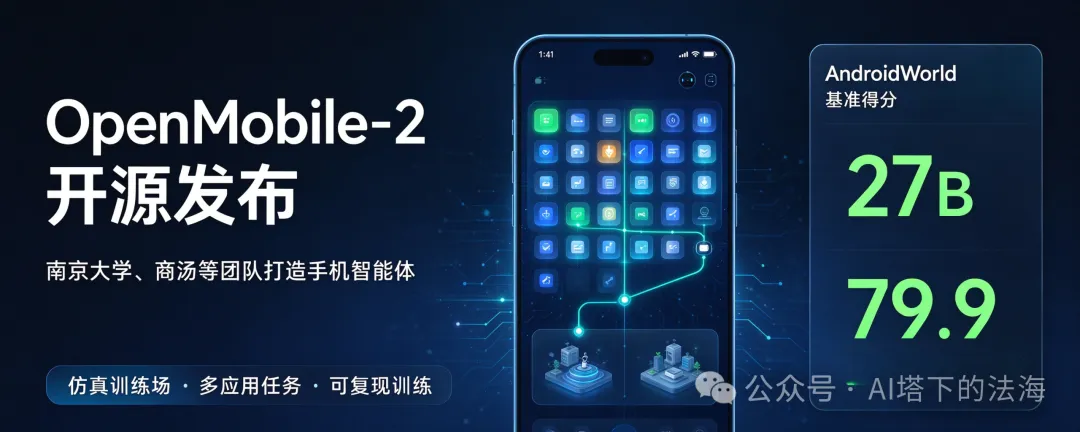
南京大学、商汤以及多所高校团队拿出了一套新方案:他们复刻了淘宝、京东、美团、滴滴这类国内高频 App,再加上 Slack、谷歌云盘等海外工具,搭起合计 110 多个应用的仿真环境,目标很明确 —— 训练一个能直接在手机上操作应用的 AI 智能体。
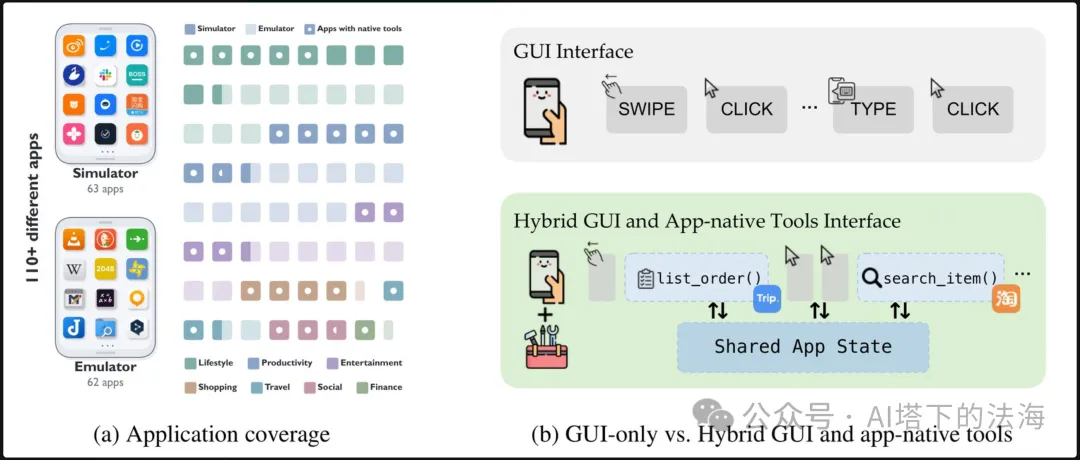
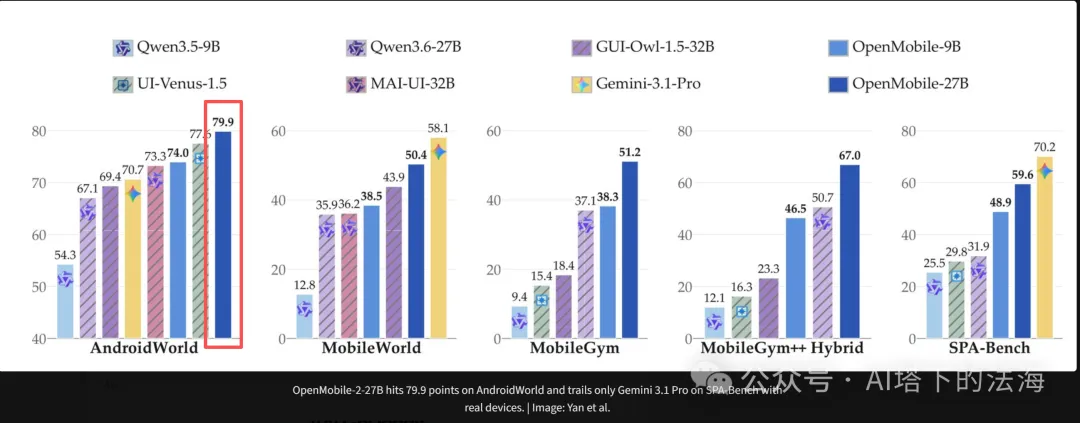
10 月 25 日,这套名为 OpenMobile-2 的手机 Agent 正式开源。模型基于 Qwen3.5 的 9B、27B 两个版本,其中 27B 版本在 AndroidWorld 基准测试拿到 79.9 分,配套的训练环境、数据集、复现文档全部对外公开。比起榜单分数,这项研究更值得细看的,是它戳中了当前开源手机智能体普遍遇到的痛点。
瓶颈不在模型,而在缺少可用的训练场地
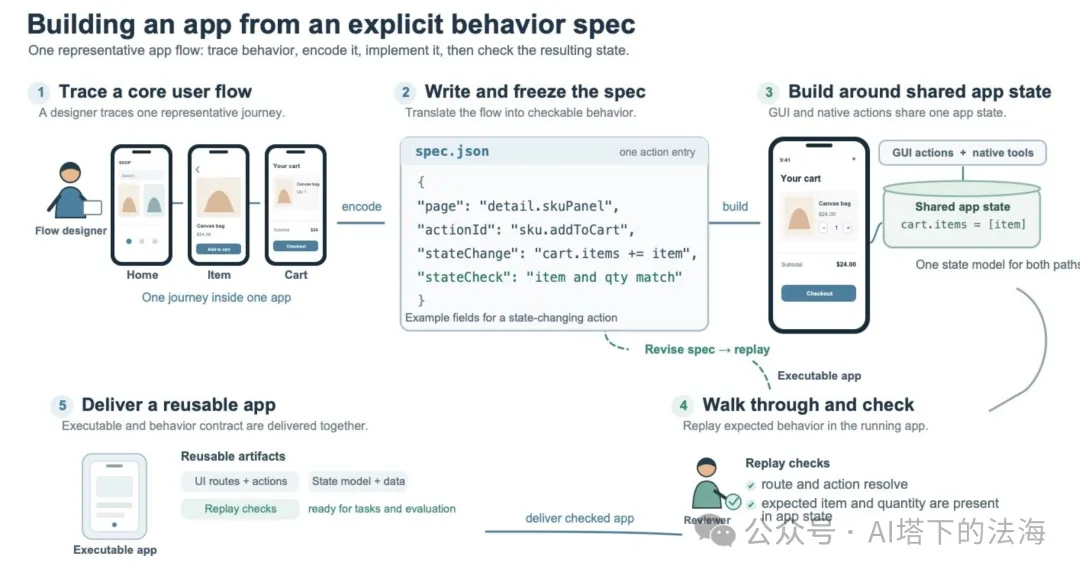
很多人默认手机 Agent 拼的是模型能力,但团队的结论刚好反过来:最大的卡点,是训练环境,不是模型权重。想教会 AI 操控手机 App,需要大量实操样本。可真实 App 的操作日志都掌握在大厂手里,不会对外放出,开源模型天然缺训练素材。这支团队没有想办法去拿真实用户数据,而是自建一套仿真训练环境,把整套 “训练场” 连同模型一起开源出来。
自研 35 款复刻 App,解决真机训练的各种麻烦
为了这套环境,团队独立重建了 35 款主流应用,国内和海外工具都覆盖在内。直接拿真实 App 训练的麻烦很多:需要登录账号、一不小心会生成真实订单、任务状态没法一键重置,成本高、结果还没法复现。重建版本会人工对照原版界面、交互流程反复校准;订单、行程、余额这类状态可以跨任务保存,还支持剪贴板在不同 App 之间传递信息;每次任务跑完自动重置回初始状态。AI 只能和普通人一样看截图做判断,拿不到程序底层数据,和真人使用逻辑一致。依托这套仿真环境,研究团队产出了约 1.16 万条任务流程样本、两千多道可以自动判分的测试题,样本标注依靠 Gemini 3.1 Pro 生成,相当于让开源模型向闭源能力看齐。
同样的数据预算,App 多样性比堆样本更划算
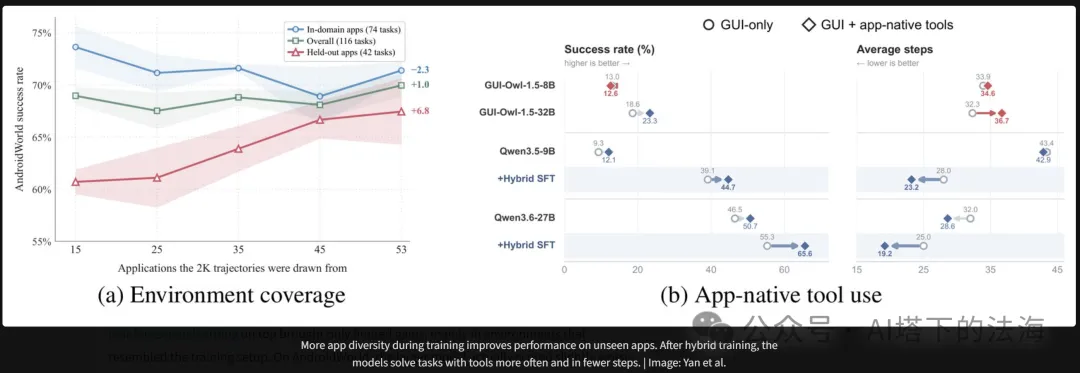
实验里有一个很有参考价值的发现:在总训练数据量固定不变的前提下,只增加 App 的种类,模型在陌生应用上的成功率,就能从 60.7% 提升到 67.5%。同样的训练预算,丰富应用场景的多样性,远比盯着少数几个 App 反复刷样本收益更高。另外团队也观察到,后期强化学习带来的提升空间有限,效果大多局限在和训练环境相近的任务里,甚至出现反向波动:27B 版本强化学习后 AndroidWorld 得分从 80.8 回落至 79.9。
模拟器跑分有水分,真机测试才是硬标尺
各类评测基准的参考价值差别很大。AndroidWorld 榜单上,27B 版本相比基础模型从 67.1 涨到 79.9,上一代 OpenMobile-1 只有 64.7;难度更高、侧重多 App 串联长任务的 MobileWorld,得分从 35.9 提升至 50.4。而 SPA-Bench 真机测试才是最硬核的检验标准:27B 版本冲到 59.6,相比基座 31.9 近乎翻倍,是目前开源模型里的最好成绩,仅次于 Gemini 3.1 Pro。模拟器跑分容易,真机环境下的提升,才更有说服力。团队还自建了包含 215 项任务的评测集,接近一半任务需要跨 App 联动,评测不靠大模型主观打分,依靠程序比对操作前后 App 内存储的数据来判定结果,更客观。
GUI 点击 + 直连 API,走出一条混合路线
这项工作里还有一个有意思的设计:50 多款仿真应用支持直接调用 “加入购物车” 这类原生指令,AI 不用一步步点击菜单。直接用这个捷径,模型不会主动使用;经过针对性训练之后,任务完成率最高可以提升 10.3 个百分点,操作步骤平均减少 5 步,而且这套能力还能迁移到没见过的工具上。这刚好对应行业里已经形成的判断:API 调用型智能体稳定性更强,GUI 点击型更灵活。手机端很难拿到大量官方接口,OpenMobile-2 走的是 GUI + 直连指令的混合路线,兼顾两种优势。OPPO 的 X-OmniClaw 是靠 deeplink 在真机复现操作路径,谷歌则直接把手机控制能力集成进 Gemini 3.5 Flash,几条路线可以对照来看。
行业风向转变:训练场才是稀缺资产
这件事背后,行业的竞争逻辑正在变化。开源模型权重只是一部分,仿真训练环境、自动化评测体系,价值可能更高。Qwen 底座很多团队都能拿来微调,但一套覆盖上百款 App、可以稳定复现的仿真环境,搭建门槛很高,很难快速复刻。借用闭源模型做样本蒸馏,是现阶段很务实的过渡方案:先让开源模型学会成熟闭源智能体的操作思路,再依靠多样化仿真环境拓展泛化能力。往后拉开差距的关键点,未必是更大参数的模型,而是谁的训练环境更贴近真实手机使用场景。
手机智能体的瓶颈,如果慢慢从模型本身转移到训练环境,你觉得哪一方会最先补齐这块短板?欢迎评论区聊一聊....