ARTICLE · 1271186
【ai-memory】给20多个AI编程工具装共享长期记忆,Claude Code的活Codex接着干
上周 Hacker News 上一个开源项目拿了 990 分、647 条讨论;GitHub 上 5 个月怒攒 14,000+ stars,本周还在以每周 2,200+ 星的速度蹿升。它干的事说出来很简单:让 Claude Code 干到一半的活,换成 Codex 打开同一个目录接着干——而且 Codex 知道你刚才卡在哪、哪些方案试过不行、还有哪些坑没填。
它叫 ai-memory,本周 GitHub Trending 周榜第 11 名(数据采集于 2026-10-28)。
一、为什么它突然爆了:每个 AI 编程工具都在"失忆"
先看数据(采集于 2026-10-28):
• GitHub 总 stars:14,193,周新增 2,239(新增/总量比 16%,快速蹿升期) • 主语言:Rust,MIT 协议,最新版本 v3.2.9(2026-10-28 发布) • 项目创建于 2026-05-21——也就是说,5 个多月冲到 1.4 万星
官方描述翻成大白话:给 AI 编程命令行工具(agent coding CLI)做长期记忆,并让不同厂商的 agent 之间顺利"交接棒"(handoff)。
你多半经历过这种崩溃:
下午用 Claude Code 调一个 bug,试了三种方案都失败,终于锁定方向,token 用完下班了。第二天换 Cursor 或者 Codex 接着干——新 agent 一脸懵:这是什么项目?架构是什么?你之前干了啥?于是你花 20 分钟把昨天的事重新讲一遍,讲到一半发现有些细节自己也忘了。
这不是你的错。Claude Code 的记忆只属于 Claude Code,存在你这台机器上;Cursor 的记忆只属于 Cursor。每个 AI 工具都在认真记笔记,但每本笔记都锁在自己的抽屉里。 换工具、换电脑、换同事接手,笔记全部作废。
ai-memory 的解法粗暴直接:给所有 agent 配一本公共笔记本。
它支持 20 多个主流编程 agent:Claude Code、Codex、Cursor、Gemini CLI、OpenCode、Grok、Devin、Kimi、Kiro、GitHub Copilot CLI、Qwen Code……全部接入同一个记忆库。任何一个 agent 学到的东西,其他 agent 都能查到。
二、它切中的空档:agent 越多,记忆越值钱
为什么是这个时间点爆?三个背景叠在一起。
第一,多 agent 工作流成了常态。 现在的开发者手里不止一个 AI 编程工具:写代码用 Claude Code,快速改动用 Cursor,查资料用 Gemini CLI。工具越换越勤,"重新解释项目背景"这件事就越痛。有人算过账:每天给新会话重述一遍项目上下文烧掉的 token,一年下来是一笔不小的开销——更贵的是你的时间。
第二,长上下文不等于长期记忆。 模型上下文窗口再长,也是"一次性"的:会话结束就清零。而且上下文越长越贵,把三个月的项目历史每次都塞进上下文,既不现实也不划算。把记忆外置成可检索的知识库,用多少取多少,才是经济账。
第三,市面上的记忆方案各有各的锁。 Mem0、Zep 这类记忆服务走托管 API 路线,按量收费,数据在别人家;各家 agent 的内置记忆又互相不通。ai-memory 站在了两者的空档:MIT 开源、免费自托管、数据是本地纯文本——谁也不锁定。
作者的背景也值得一说。Fabio Akita,GitHub ID akitaonrails,巴西技术圈的传奇博主:做了 18 年技术 YouTuber,2008 年就创立了巴西 Ruby on Rails 社区。有意思的是,他大方承认这个项目"与 Claude Code 协作构建"——代码、连 README 都是和 Claude 一起写的。一个 20 年 Web 开发老兵 + AI 结对编程,5 个月做出 1.4 万星项目,这件事本身就是 AI 时代个人开发者的一个样本。
三、技术拆解:一本 git 管理的 markdown 笔记本,居然不需要调 API
ai-memory 的架构可以用一句话概括:markdown 是真相,数据库只是目录。
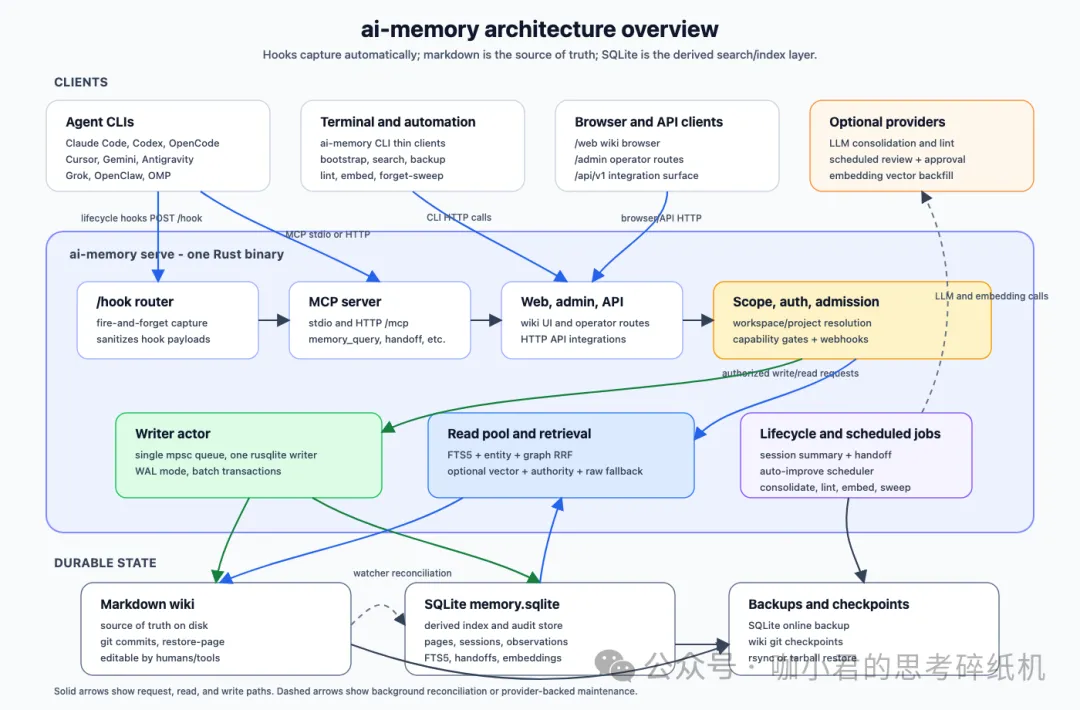
整条流水线是四步:
capture(静默捕获)→ consolidate(整理成页)→ recall(检索注入)→ handoff(交接棒)机制一:生命周期钩子静默捕获。 通过各 agent 的生命周期钩子(hook——agent 在"会话开始、收到提问、工具调用结束"等时点主动通知外部程序的机制),把你的每条指令、每次工具调用、会话边界自动记录下来。你不需要说"帮我记住",它在后台默默记。
机制二:一切沉淀为 git 管理的 markdown。 记忆的真源是一棵 git 版本化的 markdown 文件树:可以 grep、可以用 Obsidian 打开、可以手改、可以 rsync 备份。SQLite 数据库只是派生索引,随时可以从文件重建。没有向量库要维护,没有内容锁在二进制大 blob 里——这是它和 Mem0 类"事实抽取"方案最大的不同:记忆是你可以直接读懂、直接编辑的页面,不是一行行不透明的事实记录。
机制三:默认零 LLM 调用。 这是最反直觉的设计:捕获、搜索、交接,默认路径一次大模型 API 都不调,零 API key 也能跑。搜索靠 SQLite FTS5(SQLite 内置的全文搜索引擎)加实体匹配和链接邻居,融合成一个排序。你要是想升级,可以配本地嵌入模型(embedding——把文本变成向量,让语义相近的内容在数学上离得近)或任意 OpenAI 兼容接口,语义搜索、LLM 摘要都能开,但那是选项,不是前提。
机制四:记忆会"变老",而且用得越多老得越慢。 记忆按层级设定衰减节奏;你打开过、搜索过、通过链接到达过的页面,衰减更慢。冷的零散笔记可以压缩成只剩硬事实(文件路径、错误码、决策),近似重复会合并,疑似矛盾会打标——这些同样零 API 调用。重要的是从不硬删除:原文永远留在 git 版本链里,一条 restore-page 命令就能找回。
性能数字是实测的,不是拍脑袋:单机写入天花板约 700 次/秒(32 并发写入时延迟 1.43 毫秒);在标准长记忆基准 LongMemEval-S 的 470 个问题上,零 LLM 的纯全文检索路线 hit@5 达到 0.951(hit@5——前 5 条检索结果命中正确答案的比例),本地嵌入路线 0.943。作为对照,同类项目 mcp-memory-service 公开的 R@5 是 0.804。
彩蛋级的工程细节:整个系统是一个 Rust 单二进制文件(编译成一个可执行文件,拷到哪都能跑,没有依赖地狱);每次写操作有审计日志;"删除"命令会明确告诉你删掉的到底是什么。
四、怎么用:两条命令装完,第一天就能干三件事
Linux/macOS 安装只要两条命令(不用 root):
curl -fsSL https://github.com/akitaonrails/ai-memory/releases/latest/download/install.sh | shai-memory setupsetup 会自动创建数据目录、起一个用户级后台服务,并把本机找到的所有 agent 一次性接好。Windows 有对应的 PowerShell 两条命令,Arch/Fedora 有原生包,还能 Docker 一把梭。
装完第一天你可以干三件事:
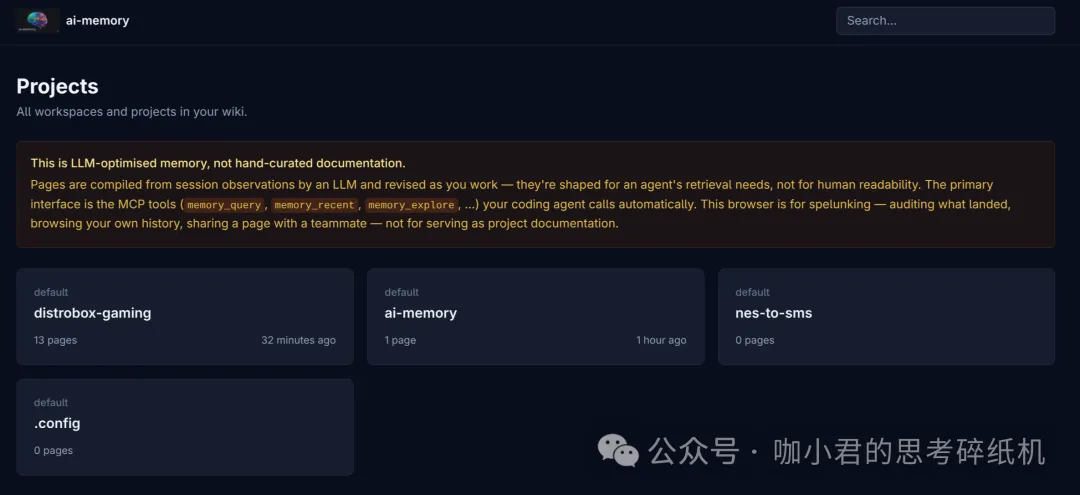
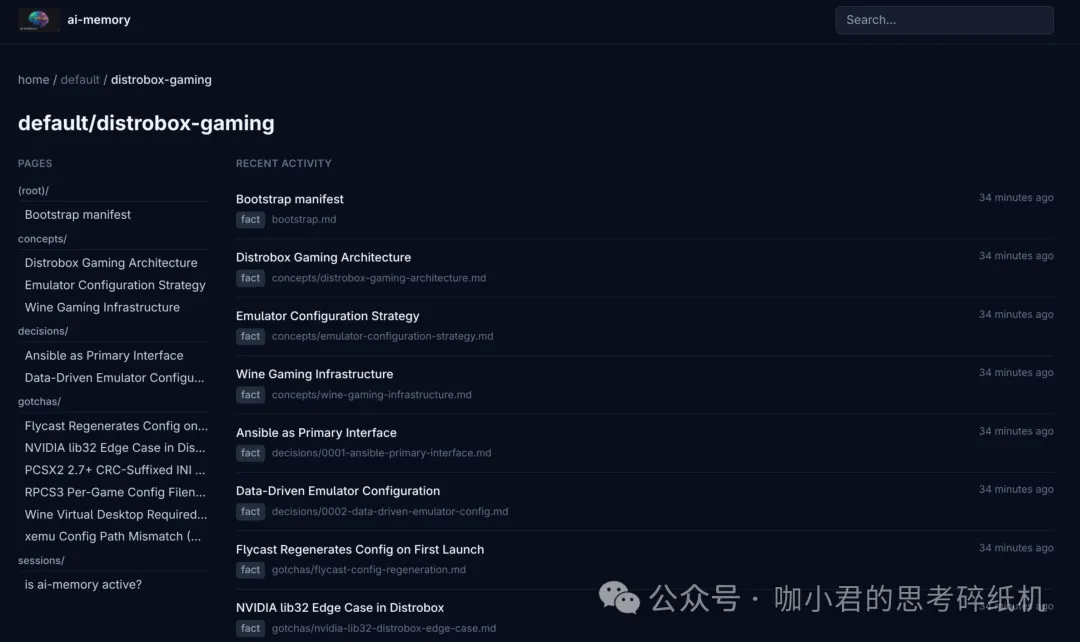
1. 正常写代码。 用 ai-memory run claude(或 codex)启动 agent,它自动挂上捕获钩子。下班时不用做任何事,session 自动整理成一页 wiki。2. 第二天问一句"我们昨天做到哪了?" 新会话(任何 agent)会收到一份交接简报:做到哪、什么失败了、还开着哪些问题。 3. 搜记忆。 直接问"我们讨论过 XX 吗",或者打开 Web 界面浏览整个项目的记忆库(见下图)。
适合谁:多工具切换的重度 AI 编程用户;小团队共享项目知识(自带多用户认证和审计);想在多台机器之间同步项目记忆的人。
不适合谁:只用一个 agent 且从不换机器的轻度用户(内置记忆够用);对"任何工具记录我操作"高度敏感的人——虽然它有类型化的隐私边界和路径排除规则,但静默捕获这件事本身你需要接受。
三个注意事项:一是默认服务只绑定本机回环地址,暴露到局域网前先读它的安全文档、开认证;二是记忆库就是 git 仓库,按 git 的思路定期备份;三是中文用户有个惊喜——它的零 LLM 搜索原生支持中日韩无空格文本的子串匹配,中文项目名、中文注释都能直接搜。
最后。AI 编程工具的下半场,比的可能不是谁更会写代码,而是谁更会"记得"。工具会换,模型会换,你踩过的坑不该跟着一起消失。
GitHub:https://github.com/akitaonrails/ai-memory
官网:https://aimemory.sh
架构文档:https://github.com/akitaonrails/ai-memory/blob/main/docs/ARCHITECTURE.md
安装指南:https://github.com/akitaonrails/ai-memory/blob/main/docs/install.md