ARTICLE · 1280448
AI Agent 观测评估与质量保障
随着大语言模型在推理、长上下文处理与任务规划等方面的能力不断提升,借助 Coding Agent 构建 Agent 原型已不再困难。然而,编码效率的提升并不意味着交付效率与软件质量同步提升,代码产出加速使人工评审与测试验证逐渐成为新的瓶颈。因此,Agent 工程化的关键问题已从提高代码产出效率,转向如何在快速迭代中持续保障质量。
问题核心在于如何建立「信任」。
测试结果是否可靠,评判标准是否一致,我们手中的尺子究竟能否准确衡量软件质量?
传统软件开发生命周期中,测试的基本思路是尽最大可能根除测试环境中的不确定性。例如,通过虚拟系统时钟模拟时刻和时间流逝;Mock 模拟外部服务响应;夹具、事务回滚和资源回收,保证测试间相互隔离;固定随机种子等等。这些措施的共同目标是让相同代码在相同条件下产生可复现的测试结果。对于仍然间歇性失败测试(Flaky Tests),则先将其 移出主测试流水线,隔离运行,持续跟踪,避免其误报干扰正常的回归测试和发版判断。
然而,即使依赖与运行环境固定,Agent 仍可能产生不同的执行轨迹与任务结果。这源于模型输出的随机性,也与提示词、技能和上下文以及多轮交互中工具调用和环境状态的动态演化有关。质量退化难以通过传统服务指标及时发现,需引入数据驱动的统计评估,从「消除不确定性」转向「度量不确定性」,系统地评估 Agent 的任务能力、执行过程与运行稳定性。
围绕这一目标,本文讨论三个问题:
表 1.1 评测成熟度自查表
表格可左右滑动
对于传统的分布式服务,Logs、Metrics 与 Traces 三大支柱通常足以定位运行故障。然而,Agent 失败往往不伴随服务指标异常:模型调用、工具执行均成功,任务质量仍可能不达标。因此,可观测体系不仅要记录请求是否成功,还须记录全链路执行过程,为异常检测、过程追踪与根因分析提供依据。
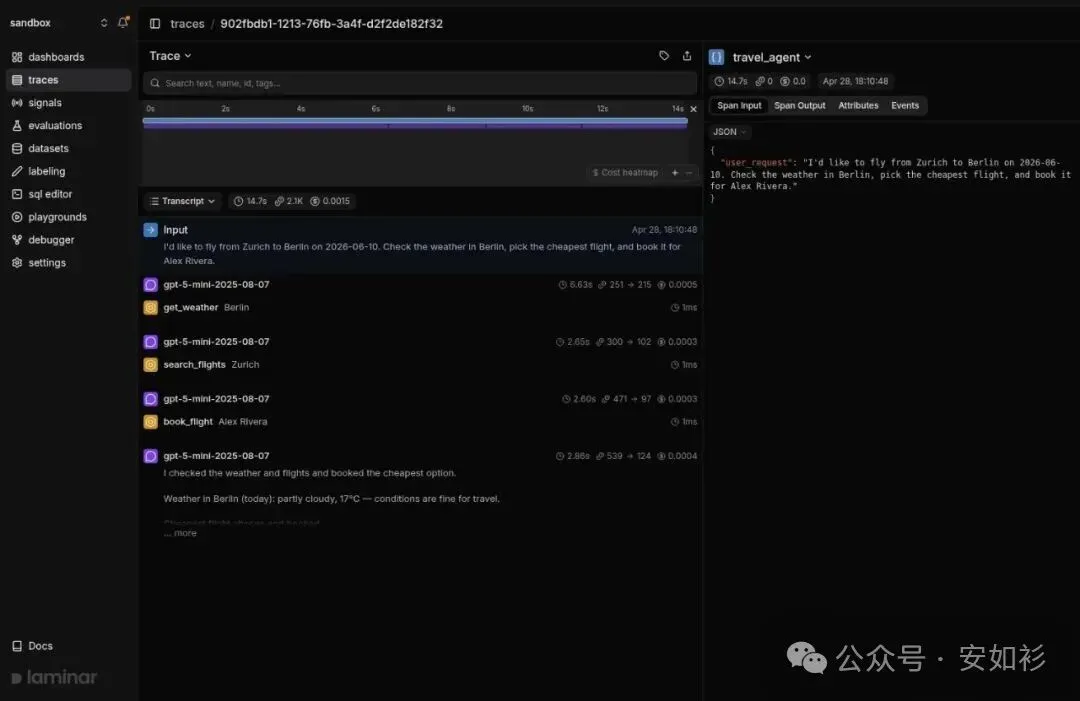
下表横向对比 Claude Code、Codex 与 DeepSeek Harness(DSH)在各维度上的工程实践。
表 2.1 三款 AI Coding Agent 的可观测实践对比
完整轨迹提供诊断依据,聚合指标则用于发现异常趋势。
表 2.2 Agent 的四类指标视图
那么如何在不修改 Agent 代码的前提下获取完整执行轨迹?
可观测性属于横切关注点,贯穿模型调用、工具执行与状态变更等环节。面向切面编程(AOP)通过钩子、装饰器和拦截器等机制织入执行流程,实现非侵入式观测。
flush(),等待尚未发送的事件完成上报,避免进程退出导致记录丢失。traceparent 等机制,将不同组件的记录关联到同一条 trace,便于还原调用顺序、分析耗时与定位故障。Agent 的质量不能仅凭最终回答判断。一次任务可能涉及多轮模型调用、工具执行与环境状态变更,因此评测必须同时考察任务结果、执行过程及其稳定性。构建离线评测体系,首先需要明确测试对象、执行条件与评价标准,再通过重复试验和多维评分形成可靠的质量判断。
3.1 评测的基本概念
为讨论方便,先明确几个基本概念。
• 用例(task)定义一次测试的输入(包含相应上下文)、执行条件(如测试环境需要拉起的依赖)与成功标准(答案、断言等)。
• 由于模型输出具有随机性,同一用例通常需要重复运行,以评估结果的稳定性;对同一用例的一次实际运行称为一次试验(trial)。
• 评估器(grader)根据预先定义的标准判断 Agent 的表现。一条用例可以配置多个评估器,分别检查任务结果、执行过程或其他属性;每个评估器也可以包含多项断言(assertion)。
• 轨迹(trajectory/transcript)记录一次试验的执行过程,包括模型输出、工具调用及其结果等信息;结果状态(outcome)则描述试验结束时环境所处的状态。
• 评测执行框架(evaluation harness)负责组织和运行整个评测流程,包括准备测试环境、执行用例、记录过程、调用评估器并汇总结果。评测集(eval suite)是围绕特定能力或行为组织的一组测试用例,用于系统性地衡量 Agent 的表现。
这里须强调结果输出与结果状态之别:以订票 Agent 为例,轨迹末尾声称「已订票」并不代表订票成功,只有确认环境数据库中确实存在对应订单,才能认定任务完成。若仅依据模型的自述评分,容易将虚假完成误判为成功。
此外还须区分防护栏(guardrail)与评估器(evaluator):前者在毫秒级同步执行,职在阻断;后者在秒级异步执行,职在打分。
评分规则则可根据评测目标灵活组合:加权评分按不同指标的权重计算总分,并要求总分达到阈值;全项通过要求所有必要检查均通过,任一失败即判定不合格;也可以将两者结合,以总分衡量整体表现,同时对关键指标设置硬性门槛。
3.2 评测集与仿真环境
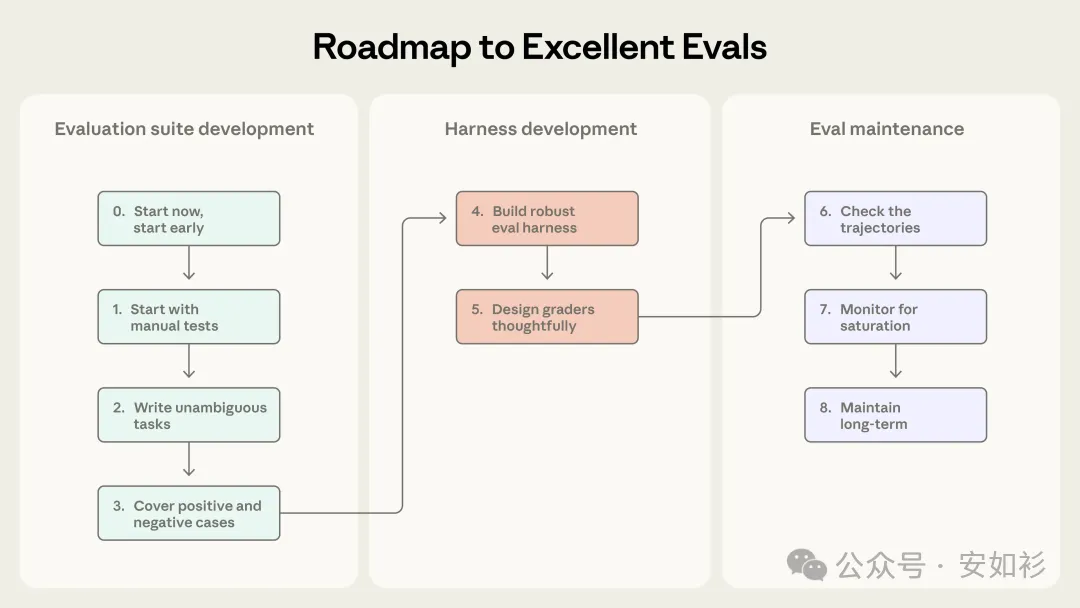
高质量评测集应满足三个条件:场景覆盖充分、执行环境可复现、用例能够持续更新。初期不必追求全面覆盖,可以人工构造少量典型用例;随着系统上线,再将真实业务中的好例与坏例持续回流,逐步扩充评测集。简单问答任务可以使用表格维护输入与预期输出;复杂任务则更适合通过 Git 仓库管理,将每个用例组织为独立目录,保存任务说明、环境配置、依赖、解决方案与验证脚本。
Harbor 即采用这种方式:instruction.md 为任务指令,即输入;task.toml 为元数据与配置;environment/ 为环境定义,如 Dockerfile 与依赖;solution/ 用于校验用例本身可解;tests/ 为验证脚本,执行后须写出 reward.txt 或 reward.json 作为奖励。用例由此可版本化、可评审、可复现。
工程上,DeepSeek Harness 采用回放用例:snapshot.yml 声明场景;session[.vN].jsonl 是录制的历史会话,作为回放输入;workspace.expected/ 是期望的工作区文件树。执行时,框架以录制会话为输入回放整个 Agent 循环,再将持久化结果与期望输出比对。
就形态而言,评测集可分为端到端与过程两类,其取舍见表 3.1。
表 3.1 端到端评测集与过程评测集
工程上通常采用「搭积木」的做法:先构造大量单步即可判对错的小块用例,再按业务路径把它们串联成完整任务。同一任务集应支持两种执行方式——按步骤逐段校验,或整体跑完后只看终态。前者用于定位,后者用于验收;同一批用例两种跑法,方能兼顾归因与保真。
评测资产亦应按用途分账,而非混在一个集合里:
• 黄金集(gold set):人工精挑的高质量用例,数量不必多,是对外汇报与对内对齐的门面;
• 错题集(regression set):线上回流与人工排查确认的坏例,逐条转为用例,只增不删;
• 挑战集(challenge set):刻意拔高的难题,用于探测能力上限,允许长期不通过;
• 必过集(must-pass set):触碰即炸的底线场景(越权、隐私泄露、脏数据写入),以失败即阻断的形式承担一票否决。
四类集合的判据都应落到可人工校验的确定事实上;含混判据只应出现在黄金集之外的探索性用例中。
对 Agent 评测而言,仿真环境让 Agent 与外界环境的每一次交互都能得到相对确定的结果。若每次环境都不同,评测便失去意义。Agent 在评测环境中与外界的交互,大致分为三类。
(1)静态只读接口。如文档查询、历史数据查询,直接访问即可,无需特殊处理。
(2)服务模拟。针对有状态、有时效性的 API,使其在评测时按线上的预期返回。例如在汽车智能座舱的 Agent 中,Agent 难免要在车辆运行过程中与传感器数据打交道;评测时不可能真的让数十辆车达到对应状态,因而多借助仿真与数字孪生技术,在 Agent 调用传感器接口时按预期返回数据。
(3)沙箱环境。沙箱在信息技术领域十分常见,本地有 Docker、Podman、Apple Container;远程有 Modal、Daytona、GKE 等。对于文件修改类任务,若没有沙箱,每次文件修改与依赖库安装都发生在宿主机上,多个用例执行时彼此干扰;置入沙箱之后,这些操作被隔离,任务并行化程度亦可大幅提升。网络是评测中最常见的非确定性来源之一,因此一般要求约束 Agent 与验证器在试验期间网络访问。为降低复现成本,还可部署一套典型的云原生微服务环境,借助混沌工程(chaos engineering)工具如 ChaosBlade 注入故障,把偶发的线上故障固定为可重复的场景。
还有一类易被忽视的场景:多轮对话中的用户本身也需要仿真。客服、助手类 Agent 允许用户多轮表达意图、补充要求、甚至中途变卦。Harbor 的仿真用户机制允许另一个 LLM 接收任务指令与人设(persona),通过 ACP 桥与目标 Agent 对话,驱动后者逐步完成任务。
3.3 评估器与轨迹分析
评估器主要分为三类,其特性对比如表 3.2 所示。
能够明确验证的结果,应尽量采用代码评估;涉及语义理解、回答质量与执行合理性的部分,则可借助模型评估,必要时由人工复核。
例如,编程 Agent 修复认证漏洞时,可以同时检查单元测试是否通过、静态分析是否存在问题、数据库中是否产生预期安全日志,以及是否调用了必要工具。对客服 Agent,则可以检查工单是否解决、退款是否完成、工具调用是否合规,以及回答是否体现适当的沟通质量。
表 3.2 三类评估器的特性对比
示例一:编程 Agent 的评测声明
任务是修复一个「密码字段为空时可绕过认证」的漏洞。其评测声明如下:
task: id: "fix-auth-bypass_1" desc: "Fix authentication bypass when password field is empty and ..." graders: - type: deterministic_tests required: [test_empty_pw_rejected.py, test_null_pw_rejected.py] - type: llm_rubric rubric: prompts/code_quality.md - type: static_analysis commands: [ruff, mypy, bandit] - type: state_check expect: security_logs: {event_type: "auth_blocked"} - type: tool_calls required: - {tool: read_file, params: {path: "src/auth/*"}} - {tool: edit_file} - {tool: run_tests} tracked_metrics: - type: transcript metrics: - n_turns - n_toolcalls - n_total_tokens - type: latency metrics: - time_to_first_token - output_tokens_per_sec - time_to_last_token示例二:对话 Agent 的评测声明
对话类 Agent(如客服)的成功是多维的:工单是否解决(状态校验)、是否在限定轮次内完成(轨迹约束)、语气是否得当(量表评审)。其评测声明如下:
graders: - type: llm_rubric rubric: prompts/support_quality.md assertions: - "Agent showed empathy for customer's frustration" - "Resolution was clearly explained" - "Agent's response grounded in fetch_policy tool results" - type: state_check expect: tickets: {status: resolved} refunds: {status: processed} - type: tool_calls required: - {tool: verify_identity} - {tool: process_refund, params: {amount: "<=100"}} - {tool: send_confirmation} - type: transcript max_turns: 10tracked_metrics: - type: transcript metrics: - n_turns - n_toolcalls - n_total_tokens - type: latency metrics: - time_to_first_token - output_tokens_per_sec - time_to_last_token轨迹是评估 Agent 执行质量的重要依据,但原始轨迹通常包含大量重复上下文,直接交给模型容易造成信息冗余。因此,评估前应先提取关键路径,再从三个维度分析:
• 结果正确性:最终输出是否符合预期。
• 证据链完整性:最终结论是否得到工具调用及其返回结果的支持,而非仅依赖模型已有知识。
• 执行效率:是否存在不必要的工具调用、重复操作与执行绕路。
最好选择统一轨迹格式,支持轨迹回放与重新评分。前者允许将历史执行记录加载到目标 Agent 中,复现失败现场或继续执行;后者则可以在不重新调用模型的情况下,使用更新后的评估器重新计算历史试验的分数。
3.4 能力评测、回归评测与性能基准
按目的,评测可分为两类。能力评测(capability evaluation)衡量 Agent 当前能够完成哪些任务、表现如何,宜从较低通过率起步,重点覆盖薄弱任务;回归评测(regression evaluation)则验证既有能力是否退化,通过率应接近 100%,用于发版门禁。随着能力提升,部分能力评测用例可以进入回归集,持续监测能力漂移:前者衡量「能否做到」,后者衡量「能否稳定做到」。
门禁本身亦须分层,否则要么形同虚设,要么寸步难行。其一为一票否决型,针对脏数据写入、越权操作、隐私泄露、间接提示注入、必过集失败等触碰即炸的场景,任一条命中即阻断发布,不接受平均分的抵消;其二为阈值型,针对一次通过率、耗时、token 成本、判官一致率等可量化指标,以历史基线与噪声底设定容忍余量,超出即告警或降级。如果把安全项做成百分比,必被大量通过样本稀释;如果把所有指标都做成一票否决,则无法发布任何版本。
门禁之外,发版过程本身也是一次实验。候选版本先在影子流量下与线上基线跑同题对比,以 A/B 判断是否退化;通过后再进入灰度(canary),观察真实流量下的表现,异常即回滚。这一步的意义在于把「离线通过」与「线上可用」之间的缺口交给真实流量来填,而不是寄望于离线用例覆盖全部长尾。
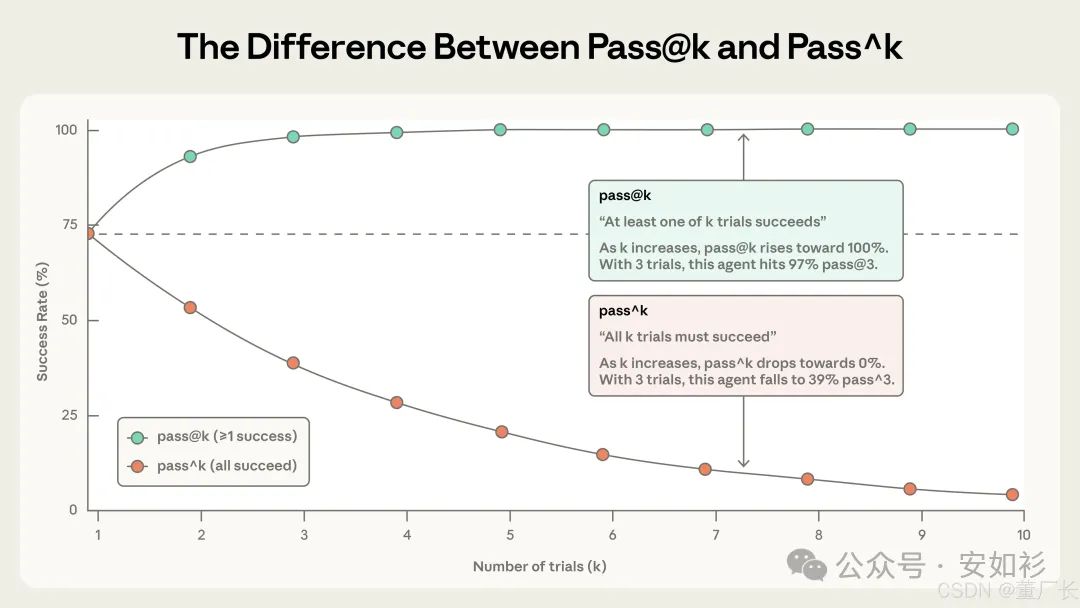
评测还应从单次结果转向执行分布。同一用例需要重复运行,才能区分偶发失败与系统性缺陷。常用指标包括:
• pass@k:k 次执行中至少一次通过,衡量能力上限。
• pass^k:k 次执行全部通过,衡量执行可靠性。
两者的差距反映了 Agent 能力与稳定性之间的距离。
除功能正确性外,回归评测还应覆盖性能。
DSH 的 benchmarks/ 包括会话首次打开、升级后重开、长会话浏览和 Agent 续跑等场景。测试使用固定的合成输入,在隔离 Node 进程中运行,同时约束耗时与堆内存。超出预算即阻止合并,作为强制门禁。此外,Harness 本身应具备单元测试、逐文件 100% 覆盖率门禁、fixture、快照回放、性能基准及真实 API 端到端测试,主要验证的是执行框架本身,保证工程正确性。通过将模型响应固定为 fixture,可以在不依赖模型调用的情况下,确定性地验证会话恢复、权限交互、界面渲染与性能开销。
3.5 评测结果的可信性
评测成为发布门禁之后,首先需要回答一个问题:我们凭什么相信评测结果?
基准本身也可能存在验证漏洞。对 SWE-Bench Pro 的后续审计发现,731 个公开任务中,有 480 个需要修复或移除,其中涉及验证器或运行环境缺陷的任务达 228 个。更严重的是,部分 Agent 能够通过修改沙箱中的解释器或伪造依赖,使验证器误判任务通过;也有模型直接从 GitHub 获取参考修复方案,而非独立解决问题。
上述缺陷可归为三类,分别落在评测的不同环节,须以不同手段应对:
• 用例缺陷:引入保留集(holdout),即只在发布前执行、永不向优化者公开的用例;并定期轮换题目,抑制过拟合。
• 验证器缺陷:将验证器(verifier)本身纳入评审,与评测结果一并留存版本,使其可回溯、可复验。
• 可作弊性:收紧环境的网络与资源访问(参见 3.2 节的网络约束),并对轨迹作证据链检查。
一个经验是,若某次评测分数突然大幅上升,应先排查评测脚手架是否已发生变化。
3.6 评测的实验有效性与统计稳定性
Agent 评测的结果不仅取决于模型本身,还受到执行环境、Harness 和模型随机性的影响。因此,比较不同版本的评测成绩,首先需要保证实验条件一致。
首先,执行环境会影响评测结果。与直接对模型输出打分的静态基准不同,Agent 需要在完整环境中编写程序、安装依赖、调用工具并反复执行。同一模型、同一执行框架和同一题集,仅改变任务的 CPU、内存配额,Terminal-Bench 2.0 上的通过率就可能相差 6 个百分点(p<0.01)[7]。
基础设施报错率也随资源配额放宽而下降:严格按规格执行时为 5.8%,三倍资源余量时为 2.1%,完全不设限时为 0.5%(p<0.001)[7]。这说明部分失败并非源于 Agent 能力不足,而是执行环境引入了额外干扰。但资源并非越多越好。从一倍增加到三倍时,通过率的变化尚不显著(p=0.40),主要改善的是基础设施稳定性;超过这一范围后,额外资源开始影响任务完成能力,进而改变评测所衡量的对象[7]。因此,评测平台应同时设置最低资源配额与硬性资源上限,并在报告中记录环境配置及其对结果的影响。
其次,Agent Harness 也会影响评测结果。
最后,模型输出具有随机性,单次通过率不足以描述其稳定性。即使同一配置重复运行后总通过率仅相差两三个百分点,具体用例仍可能在通过与失败之间反复切换,工具调用次数也可能出现明显波动。
因此,除总体通过率外,还应报告重复试验中的逐题判定一致率,并结合通过率观察哪些任务稳定通过、稳定失败,哪些任务存在偶发性失败。否则,总体指标的波动可能掩盖单个用例的不稳定性。
3.7 判官的三类偏差
规模化评测离不开 LLM-as-a-Judge。
表 3.3 LLM 判官的三类系统性偏差
表格可左右滑动
JudgeBench 显示,直接打分的 GPT-4o 准确率仅 50.86%,与随机猜测相当;具备推理能力的模型(o3-mini)可升至 80.86%[25]。
3.8 判官的纠偏与验收
MT-Bench 报告 LLM-as-a-Judge 与人工的一致率超过 80%,与人与人之间的一致率相当[19]。但近似不等于等价,仍须以四类手段纠偏,见表 3.4。
表 3.4 判官纠偏的四类手段
表 3.5 判官可用性的三条验收线
模型判官可以分担规模,却不能替代人的最终判断。在高风险的越狱与安全场景中,单个判官的准确率仅 0.51 至 0.59,逐条误判率(Acc@0)低至 0.17 至 0.30,越是不能出错之处,越不应交由单一模型裁决[26]。若判官本身不如被测对象准确,则无论怎样纠偏与组合,人工标注需求最多只能再降一半[27]。
还须防止古德哈特定律(Goodhart's law)式的退化:一旦金标集变成关键绩效指标,被评者便会去优化指标本身,而非指标背后的业务目标;评估者与被评估者逐渐习得彼此的偏好,一同偏离真实目标。这就是评估者与被评估者的协同适应。
另外,评测标准的制定不能交给各自为政的多方。产品、运营、研发与测试各有立场,若无单一标准所有者,各方各自成文,判据必然歧异。一位「独裁者」胜过十位「民主者」,须指定一名标准所有者,对评分细则与判分争议拥有最终裁决权,各方先就同一批样本背靠背标注,再由所有者裁定分歧、修订细则,如此反复,直到人人一致率达标[31]。这是标准化而非集权:裁决权集中的目的是让规则唯一,而非让意见唯一。但同一机制亦有其反面,即独裁者偏差。消除之道不在更换所有者,而在让判据持续接受外部校准:其一,评测样本取自真实线上流量而非个人构想,业务扩量后用户画像改变,评测集须随之更新;其二,把线上坏例经归因回流为用例,并在归因结论为「标准判错了」时修订 Rubric 本身;其三,以 A/B 测试的真实业务指标作为最终裁决。
3.9 评测的三条独立路径
以上做法本质上都是行为评测(behavioral evaluation):依据可观察的输入与输出判断其准确性。其盲区在于从不打开模型内部,因而防不住「会表演」的模型。另有两类路径值得重视。
其一,白盒审计(white-box audit),属机制可解释性(mechanistic interpretability)谱系。其代表工作是电路追踪(circuit tracing):以跨层转码器(cross-layer transcoder)把模型的 MLP 替换为可读的特征字典,再将一次前向计算还原为归因图(attribution graph,由特征节点与因果边构成的计算图),据此定位某个中间步骤,并以替换该特征的方式作干预验证[32]。同一谱系中三种工具的强度并不同:单义特征(monosemantic features)只回答「模型里有哪些特征」[33];logit lens 与 tuned lens 只回答「中间层表示可否解码为预测分布」[34];线性探针(linear probe)只回答「某类信息可否被线性读出」,而读出并不等于使用[35]。三者给出的都是「读得出」的证据,唯有归因图配合干预,才触及「经哪些边算出来」。
其二,忠实性审计(faithfulness audit):不判断答案对错,只检验说出的理由是否真是得出答案的原因。通行做法是对思维链施加干预,提前截断作答(early answering)、注入错误(adding mistakes)、插入无关段落(filler tokens)、改写措辞(paraphrasing),观察最终答案是否随之改变,并以干预前后答案一致率曲线的下方面积(area over the curve,AOC)度量忠实度[36]。另有输入侧的反事实检验:在提示中埋入偏见线索,再看思维链是否隐去该影响、只报出「合理」的理由[37]。
在线评测与在线监控常被混为一谈,但两者不可互相替代。
监控看的是确定性指标:报错率、耗时、token 消耗、工具调用失败率
评测看的是质量判据:是否切题、是否完成任务、是否越权违规,须由判分器裁决。
表 4.1 多种评测方式的定位与局限
表格可左右滑动
4.1 静态基准的局限与在线评测流程
真实上线之后,会遇到许多真实问题。
其一,依赖漂移。第三方 API 出现限流或变更,使 Agent 在执行任务时产生预期之外的偏离。
其二,长尾输入。用户提问的方式千奇百怪,存在大量模糊表达,Agent 随之走偏。
其三,会话状态累积。多轮会话中上下文不断累积并压缩,可能引起模型能力下降,同时抬高成本与延迟。
其四,用例覆盖有限。测试用例不断迭代,也难以百分之百覆盖线上情形,边界与异常场景仍需被发现。
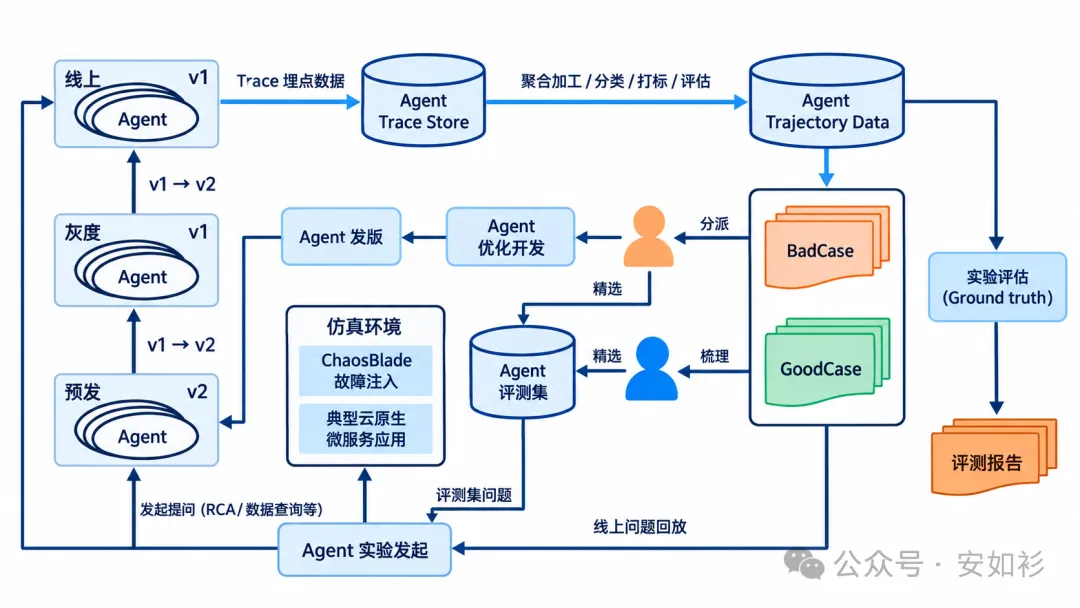
因此需要引入在线评测,实时监测线上失效案例(bad case),并做告警与监测。在线评测的整体流程如下:
表 4.2 线上坏例的四类来源
表格可左右滑动
4.2 早期异常检测与故障归因
在线评测还有一项重要职责,即在任务尚未结束时发现异常。长任务可能持续数小时甚至数天,早期错误一旦没有被及时发现,后续执行就会不断消耗 Token 与计算资源。
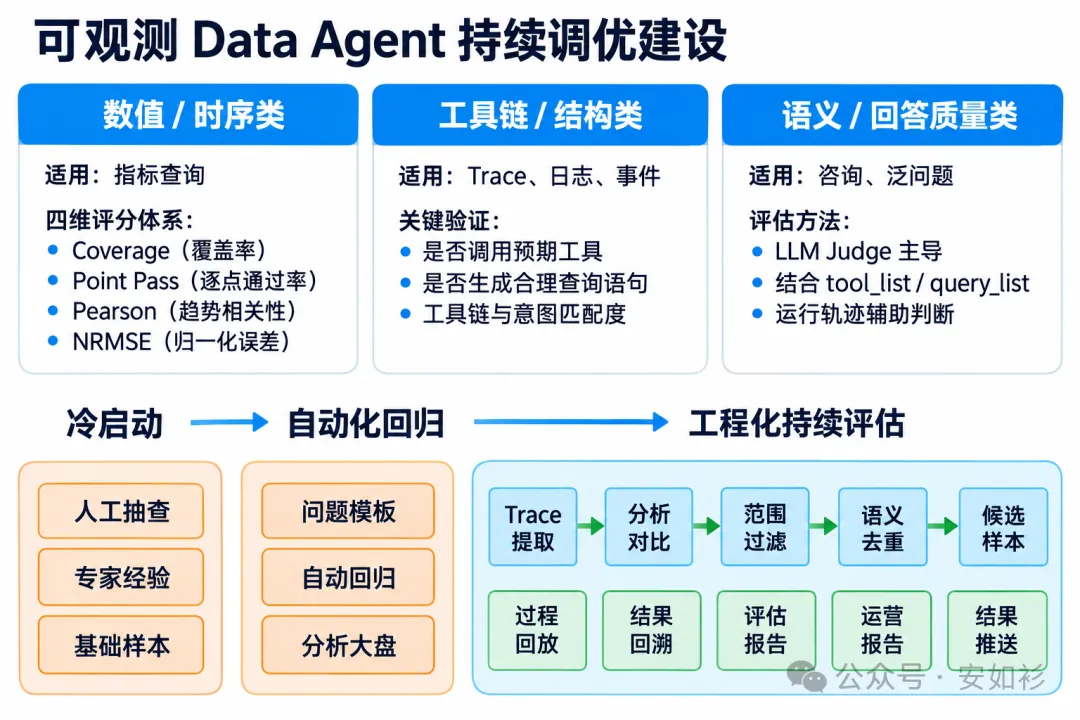
因此,需要两项能力。
其一是故障归因,既要知道哪个子 Agent 出错,也要定位其出错的具体步骤。归因的价值不止于解释,更在于把失败转化为回归用例,使同类错误不再重现。
归因方法包括逐步分析、重复执行失败频次统计、多模型集成,以及基于历史故障库的检索。实践中,可以先通过异常检测(Anomaly Detection)缩小候选步骤,再交由模型分析,而不是直接将整条轨迹交给判官。这既能减少上下文冗余,也能降低诊断成本与延迟。
表 4.3 故障归因的分类、层级与责任方
若属 Agent 问题,则修复(提示词、模型、工具),然后回归验证上线并持续观测;若属评测问题,则补充或纠正用例,调整 Rubric,重跑评测以验证新判据。此外,归因须有组织制度承载。例如设置质量例会对上一周期的高分与低分案例做人工复核,逐条给出归因层级与责任方,再分派修复。
4.3 分层评测:让误差彼此独立
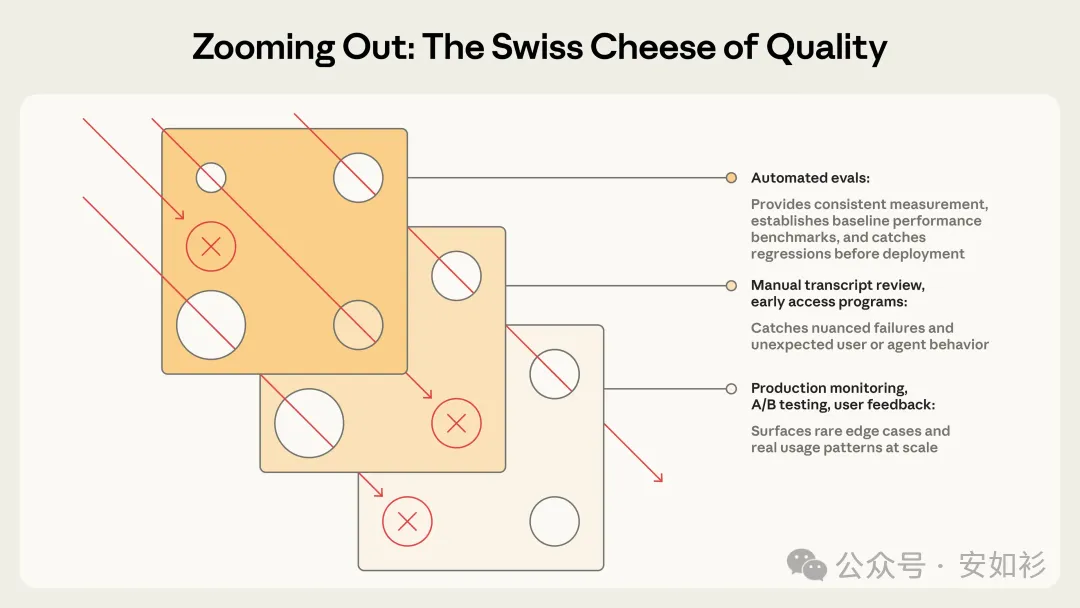
自动化评测覆盖不到长尾,生产监控解释不了原因,用户反馈稀疏且有偏,人工复核无法规模化。一次需要分层评测。
这一结构可用安全工程中的瑞士奶酪模型加以说明:每一层防线都如一片带孔的奶酪,各自都有覆盖不到之处;风险能否穿透,取决于各层的孔洞是否恰好排成一线。单一防线无论多严密,都不足以独自拦截全部失败。
4.4 安全与权限
安全也应作为独立的质量维度纳入体系。尤其是间接提示注入(indirect prompt injection),攻击者可以通过网页、文档、emoji 等外部内容诱导 Agent 泄露信息或执行越权操作。
安全评测不能只看输出,还必须检查执行过程中的权限使用与数据流向,通常设置为一票否决项;模型能力提升并不意味着安全性自然提高,二者必须分别评估。
4.5 数据飞轮
前述各环节各居其位,合起来构成一个闭环:全链路可观测记录执行轨迹,在线评测从中发现坏例,归因与修复确定优化方向,发版前的回归评测则以不超过基线的得分作为放行条件;坏例又回流为用例,成为下一轮的基准。
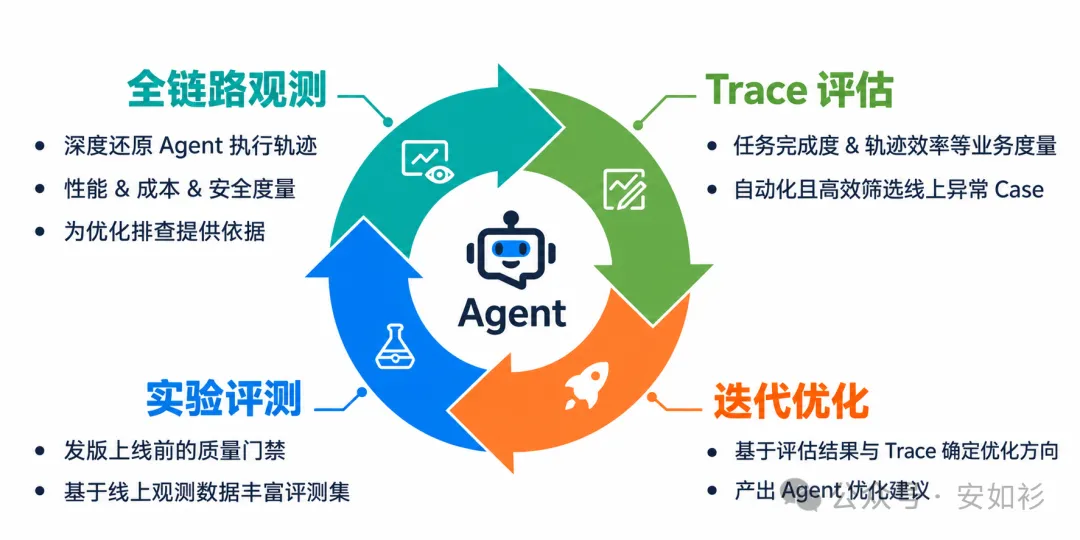
飞轮能否持续转动,取决于「驱动开发迭代优化」这一环能否把个人经验沉淀为团队资产,这本质上是知识工程问题。
软件研发的核心从来不是写代码,而是获取、学习并传递知识。
有效编码的前提是,所需知识已经被有效地获取了。如果所有的知识都已经被掌握,那么编码也不会花费太多的气力;否则,开发过程就会迅速地转化为如何寻找并掌握正确的知识。AI 时代,软件工程师的关注点从如何构造软件,变成了如何提取、组织知识,并让知识变成 LLM Agent 能理解的形式。提示词工程、上下文工程、Harnesss,关键一直都在如何组织知识。
徐昊,前 Thoughtworks 中国区技术主管
质量工程关键在于将不可言说知识转化为明确的约束、可验证的标准和可重复的评测,并通过持续反馈发现知识缺口、修正错误认知,最终形成从知识获取、实现到验证和改进的闭环。
此处常缺两类沉淀物。
其一是操作规程。资深工程师经验,多以口头传授或人脑记忆存在,团队一换人便丢失;可行的做法是把它写成 Agent 可读、版本化的 Skills。
其二是决策留痕。架构决策记录(ADR)按三态归档:提案(proposed)、已实施(implemented)、已否决(rejected)。二者共同让「依据评估结果确定优化方向」可交接、可审计。
全链路可观测提供证据,离线评测建立质量基准,在线评测发现真实问题,持续回归则将改进固化为工程约束。只有让每次失败都能被追踪、解释,并最终转化为可复用的测试用例,Agent 才能从「能够运行」走向「值得信赖」。
参考文献
[1] Yao S., Zhao J., Yu D., et al. ReAct: Synergizing Reasoning and Acting in Language Models. International Conference on Learning Representations (ICLR), 2023.
[2] OpenTelemetry. OpenTelemetry Documentation.
[3] LangChain. State of AI Agents.
[4] Anthropic. Demystifying Evals for AI Agents. 2026-01-09.
[5] Claxton L. The AI-Native SDLC Playbook. Claude Resources, 2026-08-21.
[6] Shazal A., Koen M. The Anatomy of Effective Commerce Agents. Claude Resources, 2026-09-02.
[7] Anthropic. Quantifying Infrastructure Noise in Agentic Coding Evals. 2026-02-05.
[8] Domagała M., Dragan Ł., Rdzany M., Wigg D. Harness-Aware Evaluation of Plugins. OpenAI Cookbook, 2026-09-23.
[9] Zhuge M., et al. Agent-as-a-Judge: Evaluate Agents with Agents. arXiv:2410.10934.
[10] Zou A., et al. Universal and Transferable Adversarial Attacks on Aligned Language Models. arXiv:2307.15043.
[11] Zou A., et al. Improving Alignment and Robustness with Circuit Breakers. arXiv:2406.04313.
[12] Fowler M. Eradicating Non-Determinism in Tests. martinfowler.com, 2011-04-14.
[13] Bricken T., Wang R., Bowman S., et al. Building and Evaluating Alignment Auditing Agents. Anthropic Alignment, 2025-07-24.
[14] Langfuse. Open Source LLM Observability & Evaluation Platform. github.com/langfuse/langfuse.
[15] Laminar (lmnr-ai). Open-Source Observability for AI Agents. github.com/lmnr-ai/lmnr.
[16] Alibaba. LoongSuite Pilot: Local Telemetry Collector for AI Coding Agents. github.com/alibaba/loongsuite-pilot.
[17] Laude Institute. Harbor Framework Documentation: Core Concepts, Task Format, ATIF (RFC 0001). docs.harborframework.com.
[18] Liu Y., Iter D., Xu Y., et al. G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment. Conference on Empirical Methods in Natural Language Processing (EMNLP), 2023. arXiv:2303.16634.
[19] Zheng L., Chiang W.-L., Sheng Y., et al. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems (NeurIPS), Datasets and Benchmarks Track, 2023. arXiv:2306.05685.
[20] Verga P., Hofstätter S., Althammer J., et al. Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models. arXiv:2404.18796, 2024.
[21] Zhao Y., et al. One Token to Fool LLM-as-a-Judge. arXiv:2507.08794, 2025.
[22] Panickssery A., Bowman S. R., Feng S. LLM Evaluators Recognize and Favor Their Own Generations. Advances in Neural Information Processing Systems (NeurIPS), 2024. arXiv:2404.13076.
[23] Fanous A., et al. SycEval: Evaluating LLM Sycophancy. AAAI/ACM Conference on AI, Ethics, and Society (AIES), 2025. arXiv:2502.08177.
[24] Koo R., Lee M., Raheja S., et al. Benchmarking Cognitive Biases in Large Language Models as Evaluators. Findings of the Association for Computational Linguistics (ACL), 2024. arXiv:2309.17012.
[25] Tan S., Zhuang S., Montgomery K., et al. JudgeBench: A Benchmark for Evaluating LLM-based Judges. International Conference on Learning Representations (ICLR), 2025. arXiv:2410.12784.
[26] Schwinn L., et al. A Coin Flip for Safety: LLM Judges Fail to Reliably Measure Adversarial Robustness. arXiv:2603.06594, 2026.
[27] Dorner F. E., et al. Limits to Scalable Evaluation at the Frontier: LLM as Judge Won't Beat Twice the Data. International Conference on Learning Representations (ICLR), Oral, 2025. arXiv:2410.13341.
[28] Landis J. R., Koch G. G. The Measurement of Observer Agreement for Categorical Data. Biometrics, 33(1): 159–174, 1977.
[29] Li T., Angelopoulos A., Chiang W.-L. Does Style Matter? The Impact of Style Control on Chatbot Arena Rankings. LMSYS Org, 2024-08-28.
[30] 图灵 Agent 评测团队. 《Agent 评测白皮书》系列 01:Agent 评测全览. 美团技术团队博客, 2026-09-10. tech.meituan.com.
[31] 图灵 Agent 评测团队. Agent 评测漫谈——由浅入深讲解 Agent 评测. 美团技术团队博客, 2026-08-07. tech.meituan.com.
[32] Ameisen E., Batson J., Lindsey J., et al. Circuit Tracing: Revealing Computational Graphs in Language Models. Transformer Circuits Thread, 2025. transformer-circuits.pub/2025/attribution-graphs/methods.html.
[33] Bricken T., Templeton A., Batson J., et al. Towards Monosemanticity: Decomposing Language Models With Dictionary Learning (2023);Templeton A., et al. Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet (2024). Transformer Circuits Thread.
[34] Belrose N., Furman D., Smith L., et al. Eliciting Latent Predictions from Transformers with the Tuned Lens. arXiv:2303.08112, 2023;logit lens 原始提法见 nostalgebraist. interpreting GPT: the logit lens. LessWrong, 2020.
[35] Belinkov Y. Probing Classifiers: Promises, Shortcomings, and Advances. Computational Linguistics, 48(1): 63–82, 2022. arXiv:2102.12452.
[36] Lanham T., Chen A., Radhakrishnan A., et al. Measuring Faithfulness in Chain-of-Thought Reasoning. arXiv:2307.13702, 2023.
[37] Turpin M., Michael J., Perez E., Bowman S. R. Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting. Advances in Neural Information Processing Systems (NeurIPS), 2023. arXiv:2305.04388.