ARTICLE · 1283548
公司买了新AI工具,我却切换不动——两年的 AI 积累全锁在另一个 App 里
一、公司给俺们买了 Qoder,俺却切不动
先说个俺自己这两天碰上的事儿。
公司给俺们买了企业版的 Qoder。按说这是好事,工具升级,还能省自己的订阅钱。
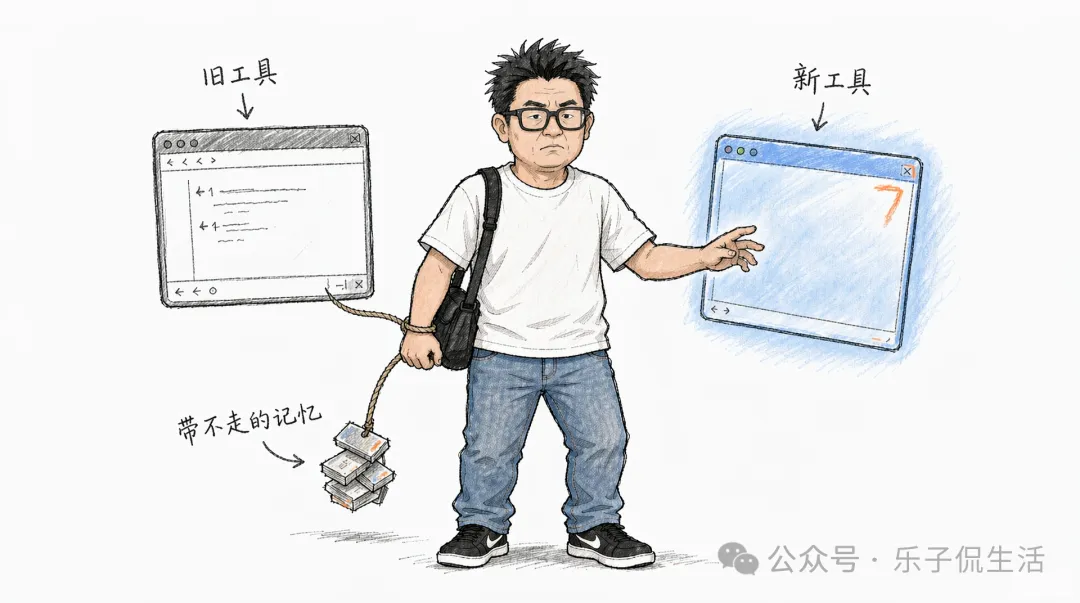
但俺这两天一直在纠结一件事:俺平时基本被 WorkBuddy 垄断了。想切过去用 Qoder,试了一下发现——自己在 WorkBuddy 上攒的那些东西,没法快速搬走。
不是文件搬不走,文件谁都会导。是那些只有它知道的上下文搬不走:俺们一起定的规则、一起踩过的坑、一起形成的判断标准、它对我这个人的了解。
切过去,等于从零开始重新磨合一遍。
二、最近在做 Harness,有个想法一直在脑子里转
巧的是,俺最近正好在做 Harness 的开发,有个想法一直在脑子里转,越想越觉得有意思,而且刚好能对上上面这个困境。
Harness 这套东西给俺最大的启发是:模型、软件、硬件,其实都是可以替换的。但一个系统长期积累下来的记忆、规则和判断,应该一直留着。
换句话说:执行层随便换,资产层自己拿着。
这话说出来好像挺朴素,但俺们把它套回到自己身上看一看,问题就出来了。
三、真正锁住你的,不是那个工具
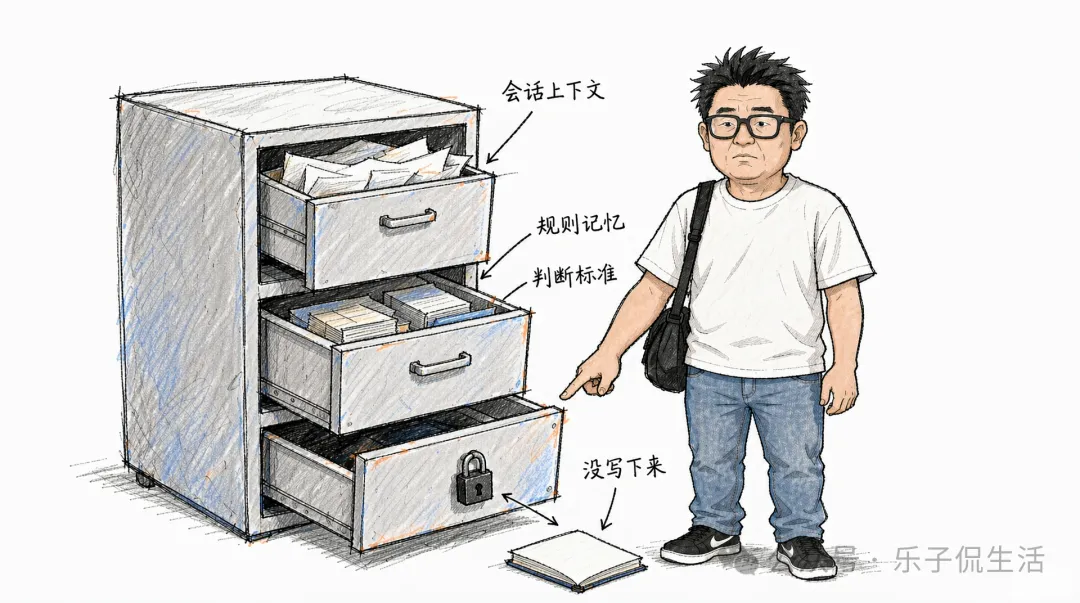
回头拆一下“切不动”这件事,你会发现它被锁在三个地方:
第一层:会话上下文。在平台上,跟着账号走,导出出来是一堆没有结论的流水账。
第二层:规则和记忆。各家都有自己的一套规则文件,名字和格式五花八门,互相不通。
第三层:判断标准。这一层最要命——它从来就没被写下来过,一直只在你自己脑子里。
前两层看着难,其实都是技术问题,能搬。真正搬不动的是第三层:你都没把它写出来过,当然没法导。
所以俺现在的做法是:规则文件的内容是通用的,只有格式不通用。
把判断标准、踩坑记录、决策理由,全部写成你自己控制的 Markdown,放在本地。至于各家那个规则文件(CLAUDE.md、AGENTS.md、.cursorrules、.workbuddy/ 这类),只当它是“适配层”——从你的主库里生成一份扔进去就行,换工具的时候重新生成一遍,五分钟的事。
四、我们平时用 AI,其实是没有积累的
想想俺们平时是怎么用这些东西的。
场景一:今天和 DeepSeek 讨论一个技术问题,聊明白了,解决了,聊天记录就放在那儿。
场景二:明天用 Trae 开发一个项目,调试了几十轮,最后终于跑通了,那些经验又留在 Trae 的会话里面。
场景三:过几天换个模型、换个工具、换台电脑,甚至只是开一个新会话——之前大量的上下文,就很难再完整利用起来了。
最难受的不是“忘了”,是你明明已经在某个问题上踩过一次坑,但下一次遇到相似的问题,还是有可能从头再踩一遍。
而且你还隐约记得自己踩过。就是想不起来当时是怎么爬出来的。。。这种感觉最折磨人。
五、俺自己做 AI 项目,越来越能感觉到这个问题
不是空谈,是俺自己在项目里真真切切碰到的:
GEO 知识库到底该怎么组织?
RAG 检索到底哪里容易出错?
数字人 API 调用有哪些限制?
字幕和视频包装,到底卡在哪个环节?
这些东西,如果只存在于聊天记录里,它们其实很难真正变成可以复用的能力。下次再碰到,还是得从头问一遍,从头试一遍。
所以俺最近一直在想一件事:Obsidian 这种本地知识库,不能只是拿来存笔记。它应该成为自己长期积累技术经验、项目决策和工作记录的地方。
六、但光把聊天记录导出来,也不算有了第二大脑
这里有个更深一层的问题,也是俺觉得很多人(包括俺自己一开始)容易搞错的地方。
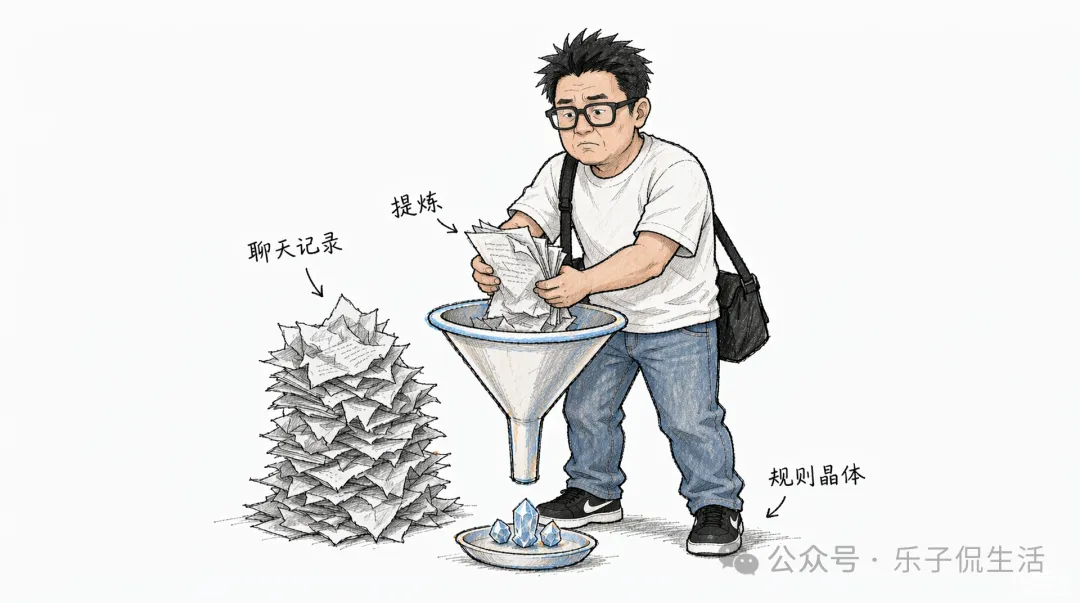
把所有聊天记录导出成 Markdown,看起来很勤奋,其实不等于你拥有了第二大脑。
为什么?因为聊天记录里有错误、有猜测、有废话,也有大量最终被推翻的方案。你全量导出来,本质上只是把垃圾从一个地方搬到了另一个地方。
真正值得保存的,是这几样东西:
这个问题为什么会发生
最后是怎么定位到根因的
什么方案被验证有效,什么方案被否掉了
当时做这个技术选择的原因是什么
下一次遇到类似问题,应该怎么处理
如果这些东西能被整理成规则、测试用例、Skill 和可检索的知识,那么以后无论换成什么模型,都可以继续用。
七、三个容易踩的坑,俺自己先记下来
想清楚“要存什么”之后,还有三件事很容易翻车,俺一并写在这儿:
第一,提炼这一步有保质期。
导出 Markdown 是最容易的一步,也是价值最低的一步。真正贵的是“复盘”,而且必须在你还记得“为什么”的时候做。拖上两周,聊天记录就变成考古现场,你自己都看不懂当时为什么否掉那个方案。
第二,规则不写失效条件,半年后就是一根错误的指挥棒。
RAG 检索的最佳实践、数字人 API 的限制,这类东西半年一变。一条规则如果没有“适用范围 + 验证日期 + 什么信号出现就该怀疑它”,那它不是资产,是负债。
第三,“换模型也能用”这话得打个折。
真正能跨模型迁移的只有两层:事实性的经验(踩过的坑、API 限制、参数)和你的判断标准(优先级、什么时候宁可慢也要稳)。中间那一层——prompt 怎么写、上下文怎么组织——其实是跟模型强相关的适配层,换了大概率要重写。
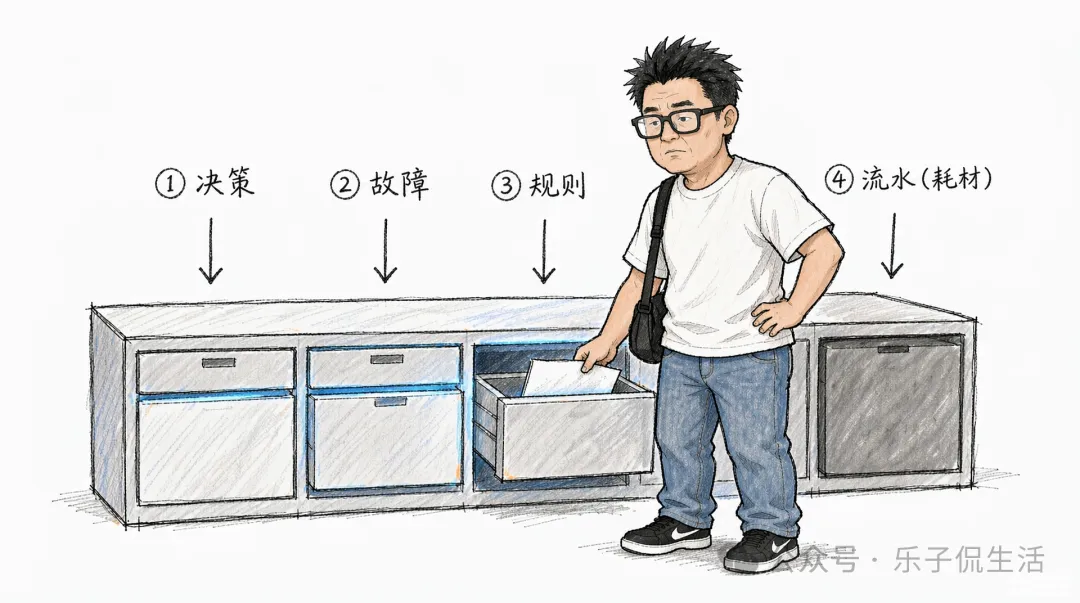
八、落到 Obsidian 里,别按项目分,按复用方式分
这是俺现在在用的分法,供参考:
前三类是资产,第四类是耗材。大部分人把精力花在第四类上,所以才总觉得“存了很多,但用不上”。
现在大家都在追模型能力,今天这个模型第一,明天那个模型又刷新榜单。这些热闹,看看就好。
但如果你的全部生产力,都依赖某一个平台的聊天记录,那工具一换,过去积累的经验就可能很难迁移——就像俺这两天切 Qoder 一样。
所以 Qoder 俺肯定还是会切过去用用看。但在切之前,俺得先把这两年在 WorkBuddy 里攒的东西,一样一样捞出来,写成自己的。
一个人真正应该拥有的,不只是几个 AI 会员和 API Key,而是一套属于自己的知识、判断标准和工作方法。
模型可以不断升级,但俺希望自己的经验是连续的——而且越用越有价值。
喜欢的点个赞,下一次咱们聊聊怎么写个技能,把“知识”落到 Obsidian。