ARTICLE · 1292100
AI助手也要学会“闭嘴”?Meta让Agent判断什么时候该提醒、什么时候该沉默
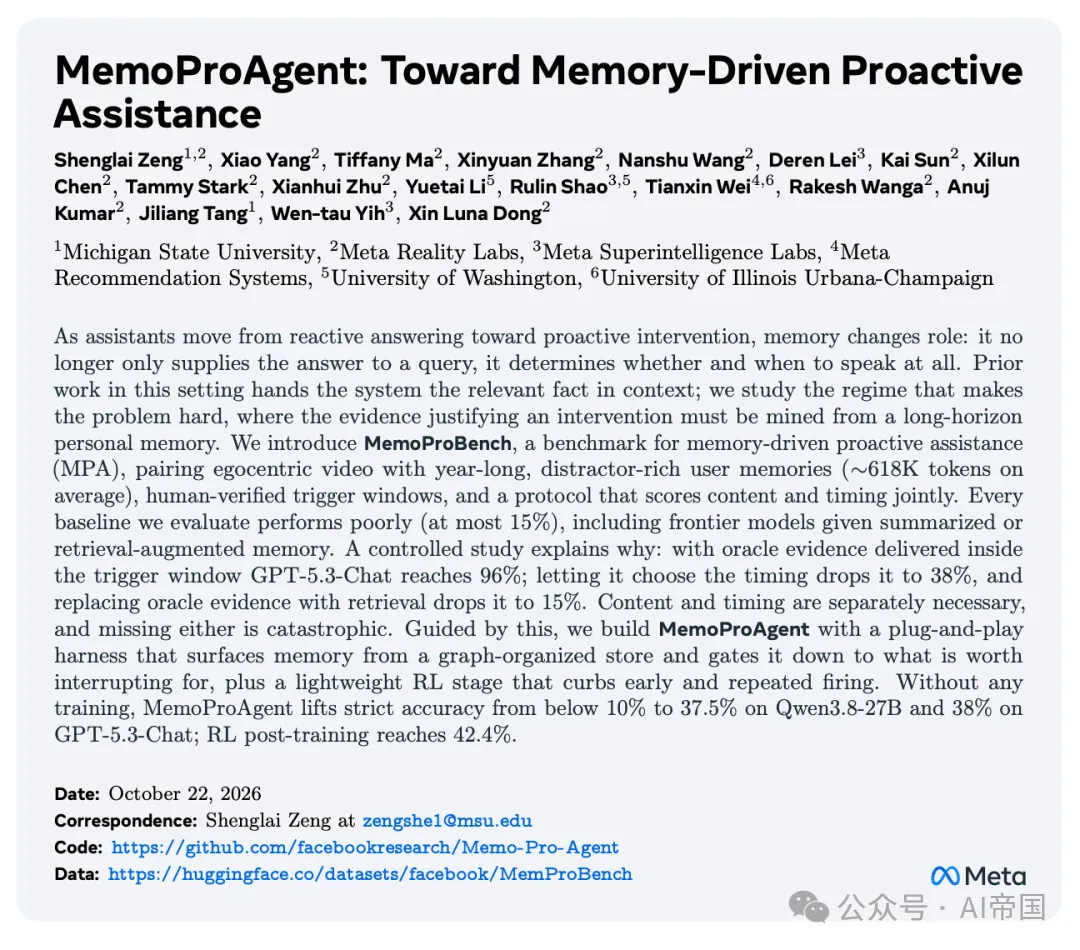
看到商店里的气泡水,助手记得家中已喝完,才有理由主动提醒补货;同一条记忆在上课时出现,就可能变成打扰。Meta 参与的 MemoProAgent(原名 ProPerAgent)研究这类“不等人提问”的助手。基准 MemoProBench(原名 ProPerMem)把第一人称视频与约一年的合成个人历史 memory 配对,主指标 Perfect 要求内容正确、时机合适、整段只提醒一次。
正确证据在窗口内出现,才有96%的理想结果
150段视频的受控实验把“证据是否正确”和“是否给定时机”分开:GPT-5.3-Chat 直接拿到正确证据,且证据只在标注触发窗口内出现时,Perfect 为96%;同样的证据一直可见、让模型自主选时机,降为38%。改用标准检索增强生成(RAG)的结果,即使仍在窗口内提供,也只有15.3%。给对内容和给对时机,各自都影响结果。
[表4:Qwen3.8-27B 与 GPT-5.3-Chat 上的内容×时机] 指标为 Perfect,单位%,样本为150段视频。oracle 是直接提供标注中的正确记忆证据;“给定时机”只在触发窗口内填入证据,其他时刻为空,模型仍自行决定是否开口。96%属于 GPT 的理想条件,Qwen 在同条件下为77.3%。
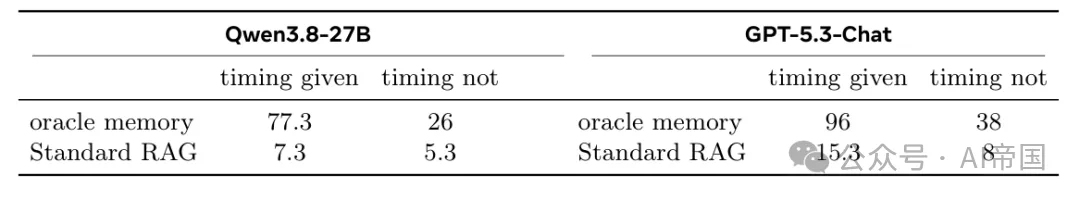
表4
这项基准的目标证据平均只占约61.8万 token 历史的0.19%,难点包括从干扰中找出依据,以及判断现在是否值得打断。Hit 只要求至少一次在允许时段说对,额外说错或重复也不抹掉命中;Perfect 则不允许这些多余提醒。两项指标都检查内容与时间,Perfect 额外约束“只说一次”。默认允许触发窗口结束后2秒的时间容差。
图记忆找依据,门控判断是否值得提醒
MemoProAgent 把过去事件组织成情景 memory,把偏好与约束组织成语义 memory,并用图连接相关对象。每次先从画面识别当前关注的物体,再检索相关记录。门控模型进一步筛选:一条记录即使有关,也可能已经处理完,或不构成现在提醒的理由;只有仍值得提醒的依据才被整理成一条证据交给生成器。
[图5:MemoProAgent 概览] 上方生成流程先观察、取得证据,再决定说话或沉默;下方检索侧从情景与语义 memory 图中找候选,经过门控筛选和整理,返回证据或空值。空值不是硬性禁止发言,生成器仍结合当前画面做最终决定。
图5
系统也把已经说过的提醒保留给模型,减少重复。150个测试样本的消融中,不含强化学习的系统 Perfect 为37.3%;去掉门控降到24.0%,把图记忆换回标准 RAG 降到20.7%,隐藏已说内容则降到8.0%。这些是小样本上的组件对照,不能与完整测试集的37.5%混作同一次测量。
同一 Qwen 模型下,完整提醒成功率从7%到37.5%
主实验使用800个测试样本。Qwen3.8-27B 在四帧滑动窗口下,每2秒做一次决定,标准 RAG 最佳检索条数对应的 Perfect 为7.0%;加上 MemoProAgent 的记忆与门控流程、不改权重,达到37.5%。换成每秒接收一帧、分块保留上下文的流式设置,则从1.0%提高到33.3%。这是完整流程的改进,不能当作基座模型单独增加了同样幅度的能力。
[表5:MemoProBench 在窗口与流式范式下的性能比较] 上半部分为窗口模式,下半部分为流式模式;Perfect 是主指标,Hit 允许额外提醒,over-trig 表示重复开口,early/late 表示提前/迟到,fires/clip 为每段平均开口次数。除次数外均为百分比。RAG 按测试过的检索条数取最好结果,不能把它理解为未调参的弱基线。
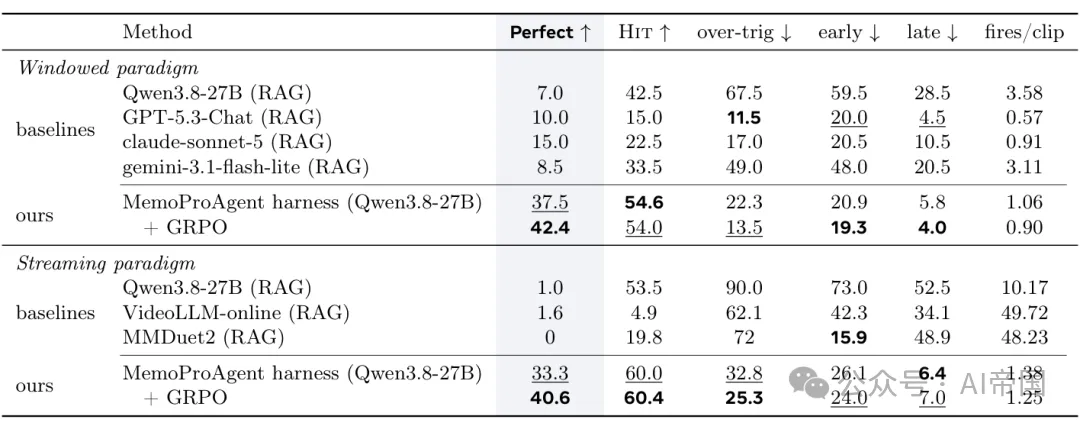
表5
只对生成器做组相对策略优化(GRPO)强化学习后,窗口 Perfect 进一步达到42.4%,重复提醒比例从22.3%降到13.5%;Hit 则从54.6%变为54.0%。增益主要体现在少重复、少提前开口,而非命中更多。训练奖励与评测使用同一个内容评判器,这组行为分解支持上述解释,但仅凭 Hit 基本不变,还不足以排除所有评判器适配偏差。
主动助手要同时验证有用提醒与正确沉默
这组实验支持先判断“这条记忆是否构成当前打断的理由”,再决定说什么,并把重复提醒算作失败。负样本检验了这种选择性:150段移除相关记忆、全程应沉默的视频中,窗口模式的标准 RAG 仍在77.3%的片段开口;MemoProAgent 降到15.3%,强化学习后为14.0%。错误打断减少了,但还没有消失。
[图7:对 MemoProAgent 的进一步探查] 三个面板分别展示 Epic-Kitchens 上的迁移表现、应全程沉默片段的错误触发率,以及150样本上的消融;蓝色为窗口模式,红色为流式模式。负样本的错误触发率越低越好,另两项 Perfect 越高越好;三个面板的样本范围不同,不能合并为一个总体成功率。
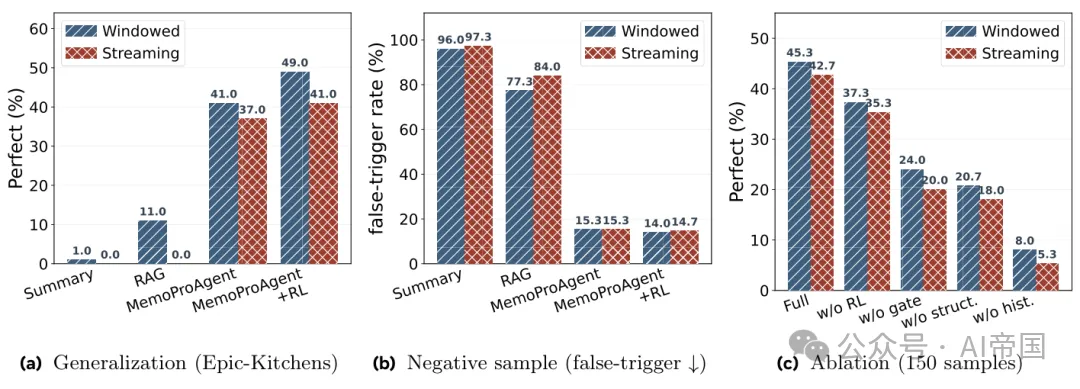
图7
这里的长期 memory 是合成文字历史,经人工复核后与真实第一人称视频配对,并非对真实用户持续记录了一年。每段只有一个触发窗口,论文也未测生产环境的端到端延迟。把这套方法用于持续、多事项的提醒,还需验证这些条件;GPT 在150例理想证据实验中的96%,也不能直接当成 Qwen 完整系统的统一上限。
截至2026年10月25日,官方已公开推理代码仓库。仓库说明,800条评测历史需要获授权的 Hugging Face 访问,视频需按 Ego4D 的访问条款另行取得;公开代码不包含后训练检查点,也不等于已经能直接复现论文全部结果。
📄 原文标题
MemoProAgent: Toward Memory-Driven Proactive Assistance
🔗 原文链接
https://arxiv.org/abs/2610.22671v2