ARTICLE · 1297684
AI代码的DFX,都隐藏在每次线上事故里
大家好,我是小❤。先说个前阵子的事。
那天凌晨两点,电话把我叫醒了。出事的不是我写的代码,是我组里一个刚转岗的同事——他靠着 AI 补代码,五分钟写完一个消息发送模块,八百多行,编译过、单测绿、接口文档齐全。提交时他还挺得意:这活儿以前得干两天。
功能测试全过,演示时一切丝滑,领导点头,产品说"就是要这个效果"。
然后上线第三天,凌晨两点,链路挂了。
不是功能坏了——功能一步都没错。是某个外部接口那会儿抖了一下,返回了个超时。这个模块老老实实在那儿干等,线程一个接一个被占住,队列越堆越长,最后整条发送链路卡死。业务方打电话过来时,消息已经积了两个小时。
我裹着毯子翻日志,翻了四十分钟,里面只有一句:
error: send failed发哪条失败了?哪个客户?哪个渠道?重试过吗?进死信吗?不知道。他不知道,我们的监控也不知道。
第二天复盘,我本来准备说他两句,说着说着自己先沉默了——这份代码是我 review 过的,他问我的时候,我说的是"主流程没问题,可以上"。我们都看了主流程,没人看一眼失败路径。
那天我想明白一件事:AI 能把"系统能做什么"写得又快又好,但它不会替你问一句"这地方坏了怎么办"。
一、功能需求管"能不能",DFX 管"坏了算谁的"
我们平时写需求,写的基本都是功能需求:点这个按钮发消息、那条数据要能查出来、导出成 Excel。功能需求回答的是"系统能做什么"。
但线上真正把你叫醒的,几乎从来不是功能需求没实现——功能没实现,测试就过不了,根本发不出去。叫醒你的是另一批问题:
依赖的外部服务挂了,我们怎么办?
消息发了一半,重启了,算发过还是没发过?
报警能不能让我拿到就知道去哪儿查,而不是先去翻日志?
这个接口被重复调用了三十次,会不会给客户发三十条消息?
新增一个配置项,旧版本的服务读不认,会不会直接起不来?
这些问题有一个共同的称呼:非功能需求。落到软件工程里,它有个专门的名字——DFX,Design for X,面向 X 的设计。
说人话就是:在写代码之前,就把"将来怎么运维、怎么排查、怎么扛住流量、怎么演进"想清楚,别等出事再补。 功能需求回答"系统能做什么",DFX 回答"它扛不扛得住真实世界"。
它不是一个缩写游戏。业内常说有七个小兄弟:
| 缩写 | 全称 | 中文 | 一句话 |
|---|---|---|---|
| DFR | Reliability | 可靠性 | 坏了能不能不崩、崩了能不能恢复 |
| DFP | Performance | 性能 | 流量翻十倍扛不扛得住 |
| DFT | Testability | 可测试性 | 能不能在测试环境里把它测明白 |
| DFS | Serviceability | 可观测/可运维 | 出事能不能看见、能不能查 |
| DFSec | Security | 安全 | 会不会被越权、被拖库、被打穿 |
| DFM | Maintainability | 可维护性 | 半年后的人还改得动吗 |
| DFE | Evolvability | 可演进性 | 加字段、加租户、换版本会不会炸 |
这表看着就想划走吧?别急,后面每章只说一件事:你其实天天在做 DFX,只是做得很随机。
比如你写的每个 if err != nil,是 DFR;顺手加的那条索引,是 DFP;日志里多打的那个 tenant_id,是 DFS;把那个 180 行的函数拆成三个,是 DFM。
问题是,随机做和系统地做,中间隔着一次事故。
带团队这些年我越来越觉得,最难的不是让新人把功能写出来,而是让他写出"我敢让它在凌晨挡在前面"的代码。
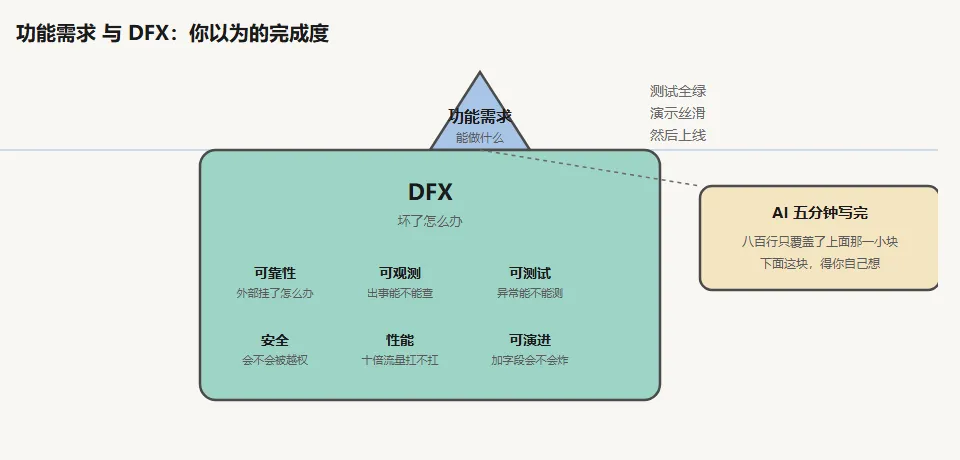
AI 时代这件事更尖锐。以前写两天做个模块,中间会卡壳、会犹豫、会反复问"这儿失败了咋整"——那些卡壳,其实就是在做 DFX。现在 AI 五分钟给八百行,整个卡壳过程被压成零。代价是:那些本来会被想起来的问题,连想的机会都没有。
下面七章,就当是我给团队的一份复盘。
二、DFR 可靠性:外部系统一定会失败,你要为它的失败负责
这章是上一晚事故的复盘。
先说一个反直觉的定义:故障(fault)不等于失效(failure)。
故障:系统的一部分状态偏离了正常。
失效:整个系统向用户停止服务。
你要做的事只有一件——用一堆不可靠的零件,搭出一个可靠的系统。零件坏是必然的,让它坏不到整体上,才是本事。
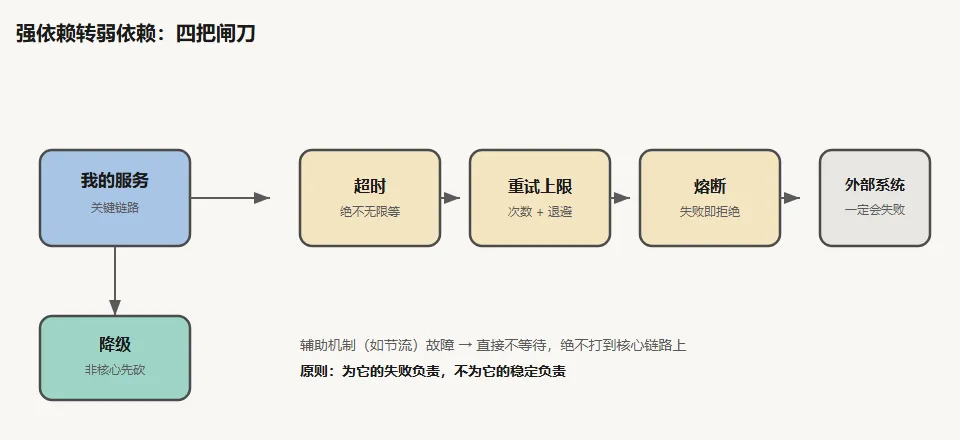
可靠性工程的第一课,是把强依赖转成弱依赖。所谓强依赖,就是"它不在了我就不活了"。四个标准动作:
| 动作 | 干什么 | 你天天在写的 |
|---|---|---|
| 超时 | 给每次调用设上限,绝不能无限等 | context.WithTimeout |
| 重试 + 退避 | 失败重来,但要设次数上限和退避间隔 | 忘了写上限的 for i := 0; i < 3 |
| 熔断 | 连续失败到阈值就直接拒绝,别再打它 | 一个一直没上过的熔断器 |
| 降级 | 关键路径保命,非关键功能先砍掉 | "这功能挂了不影响下单" |
我那次事故,第一个动作就没做——没超时。第二个做了半截——重试了,但没上限也没退避,于是对方越抖我们打得越凶,活脱脱一个放大器。
后来我给这个同事做复盘,发现不是他不懂这些道理,是他根本没往那儿想。AI 补的代码里 if err != nil 一个不少,但每个后面都只接 return err——错误"处理"了,链路还是那个裸奔的链路。
这里有个我特别喜欢的原则:外部系统一定会失败,我们要为它的失败负责,而不是为它的稳定负责。
第三方稳不稳,你管不了。但"把它直接挂在关键链路上、失败还看不见、也不想办法兜住",这是你自己选的。
后来我在另一个需求里落地了个发送节流组件,正好用上这条原则。节流本质是"让消息发得慢一点、更自然一点",属于辅助逻辑。设计时我就定死一条:节流自身的任何异常,一律降级成"不等待"。
配置读错了?不控频,照发。等的时候超时了?立刻返回,绝不硬睡满。
select {
case<-time.After(waited):
case<-ctx.Done():   // 超时预算更重要,不硬睡
return0
}
你品品,如果这里写的是 time.Sleep(waited),那就变成:一个可有可无的辅助功能,能把核心的发送链路拖死。
这就是可靠性设计里最值钱的一句话:辅助机制的死活,不许传导到核心业务上。
三、状态机只画成功路径,是所有事故的亲妈
再讲一个更常见的坑。
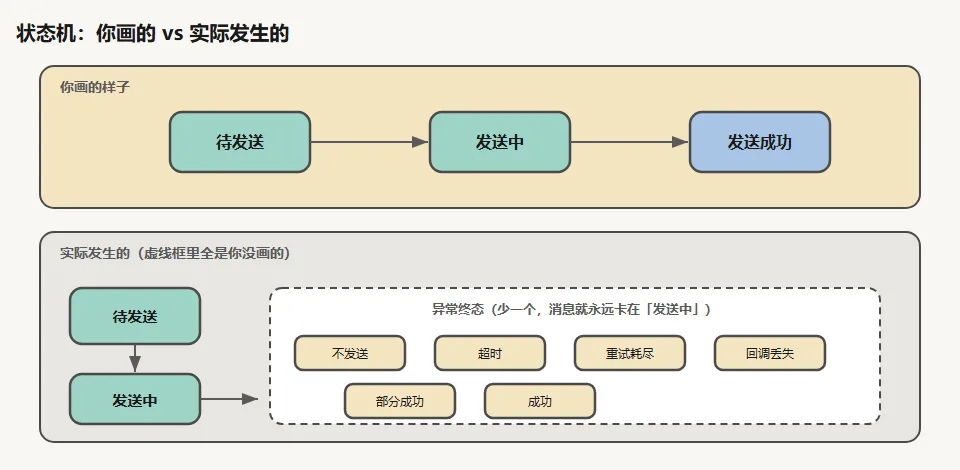
我们设计一个"发消息"的流程,脑子里浮现的往往是:
待发送 → 发送中 → 发送成功漂亮,清爽,能跑通。然后你按这个图写代码,上线,出事。
因为真实世界里,这条链路上藏着至少五六条你压根没画的分支:
发送失败了,是重试还是放弃?
重试三次全失败,消息去哪儿?进死信?还是烂在内存里?
回调一直没回来,等到什么时候算超时?
文本发出去了,图片没发出去,这条算成功还是失败?
两个入口碰巧同时触发了发送,会不会发两遍?
这些分支在你那张图上一个字都没有,代码里也就没有——没有"重试耗尽"这个终态,消息就只能永远卡在"发送中"。
我见过最典型的场景(就是这次):发送失败了,系统"聪明"地选择了不发送,然后……就没有然后了。状态机里根本没有"不发送",也没有"超时"。它就那么静静地停在中间,像一台停在半路的电梯,没人知道它该去哪儿。
要补的其实很朴素:
| 补什么 | 为什么 |
|---|---|
| 异常终态 | 不发送 / 超时 / 重试耗尽 / 回调丢失 / 部分成功,每个都得有明确终点 |
| 幂等键 | 重复调用必须得到同一个结果,否则就是给客户发两遍 |
| 对账 Job | 定期核对"平台认为的终态"和"外部真实的结果",它们一定会不一致 |
补完你会发现一个很扎心的事实:这些坑,在设计图上画两条线就能避开,在线上排查要烧掉一整个值班。
还有个更隐蔽的坑:自愈机制。 很多系统会做"自动修正",发现计数对不上就悄悄改对。听起来很美好,对吧?
问题是,它悄悄改对了,然后什么也没说。 等你发现数据一直在漂移,已经漂了三个月,还不知道是哪个路径在破坏一致性。自愈把问题修好了,同时也把证据销毁了。
所以正确的姿势是:既修,也报。
四、DFS 可观测:告警不是通知,是带着答案的通知
回到凌晨两点那个场景。真正缺的不是脑子,是信息。
可观测性这个词被说得太玄了。我判断标准特别土:
出事了,值夜班的人能不能不问人、三分钟内知道去哪儿看?
做不到,那就是可观测性欠账。这里有两件事特别值得做。
第一件:给一条业务链路一个 ID。
不是框架自动生成的那种请求 ID——那个一入库、一过 MQ、一进定时任务就断了,跨机器根本串不起来。要的是一个业务链路 ID:一条消息从生成、审核、发送、回执到状态落库,全程带着同一个 biz_id,能反查出"哪个租户、哪个账号、哪个客户、哪个任务"。
请求 ID 管一次调用,业务链路 ID 管一件事的一辈子。
有了它,排查从"在十几个服务的日志里拼图",变成"搜一个 ID,链路全出来"。这不是优化,是救命。
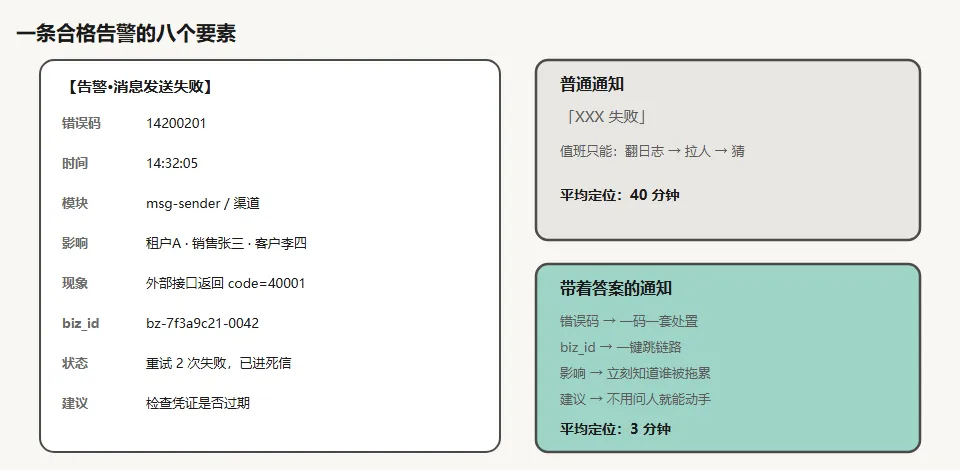
第二件:告警要长成一张能直接干活的脸。 我们当时的告警呢?群里一句"XXX 失败",值班只能翻日志、拉人、猜。
我现在要求告警必须带八个要素,缺一个都不算合格:
【告警·消息发送失败】
错误码   14200201
时间     2026-10-12 14:32:05
模块     msg-sender / 外部渠道
影响     tenant_A · 销售张三 · 客户李四
现象     调用外部发送接口返回失败,code=40001(凭证已过期)
biz_id   bz-7f3a9c21-0042
状态     已自动重试 2 次未成功,任务置 FAILED(已进死信)
建议     1) 检查该渠道凭证是否过期 2) 过期则执行续期流程
看出区别了吗?上面这条告警,值班拿到就能动手;"XXX 失败"那条,值班拿到只能找人。
一句话总结这一章:告警不是通知,是带着答案的通知。 日志同理——必须带上下文(租户、请求 ID、业务链路 ID、耗时),不是打一句 error 就完事。日志不是装饰,是给凌晨三点的你自己看的证据。
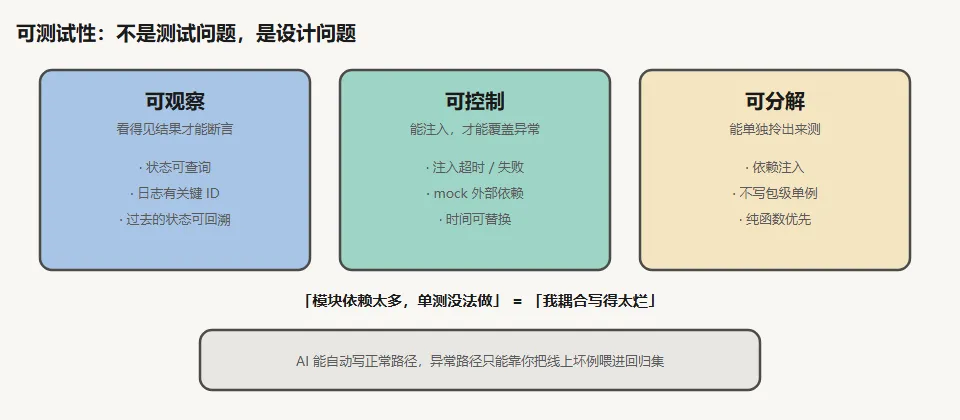
五、DFT 可测试:可测试性是设计问题,不是测试问题
这句话我第一次看到时愣了很久:可测试性表面看是测试问题,实际上是设计问题,是设计好坏的晴雨表。
这些年我 review 过的烂代码,一多半都卡在这上面:想写单测,先得 mock 七八个依赖,mock 到一半就放弃,还自我安慰"这模块不好测"。翻译过来就一句:是耦合写得太烂。
可测试性好的东西长什么样?三个词:
可观察:结果能看见、能断言。看不见就不可测。
可控制:能用输入把每个分支走一遍,包括磁盘满、内存分配失败那种分支。
可分解:一个函数能单独拎出来测,不用拖一整个进程。
这三条里,只有"可控制"是测试的同学能帮你的,另外两条全在你写代码那一刻就决定了。
顺带说个 AI 时代的新坑。以前测的都是"正常路径",因为正常路径就是需求。现在 AI 写代码,正常路径它能自动写全,但异常路径它基本靠猜——它不知道你们系统的超时预算,不知道哪个依赖最不稳定,不知道哪个错误码在业务上叫"失败"。
所以有件事必须坚持:线上真实发生的坏例子,要沉淀进版本化的回归集。 线上的坑,只有进过一次回归,才算真的填了。
再补一句:如果链路里挂着模型调用,"兜底"和"失败降级"必须分得清,而且都要打点。 拿一句兜底话术把"知识缺失""画像不全"盖过去,测试集上一片祥和,线上其实是系统性失效。
六、安全、性能、可维护、可演进:四个不配大章节、但不能没有的维度
这四个我快速过,但每条都是真实事故里长出来的。
DFSec 安全:最常见也最丢人的是多租户隔离——查询漏了 tenant_id,就是跨租户数据泄露,SaaS 里属于一级事故。另外两条:日志里绝不能出现手机号、token、完整提示词;越权请求被拒之后要留审计——拒绝了不留痕,等于没拒绝。
DFP 性能:两个高频雷。一是 N+1,列表页逐条查关联、循环里发 RPC、循环里打日志。二是超时预算:假设一次处理总共 180 秒,中间加个最长 6 秒的等待,留给等回调的就只剩 174 秒。加任何一步都要问:这一步挤占了谁的预算?
DFM 可维护:函数超 50 行、文件超 300 行、嵌套超 3 层、魔法数字、函数名叫 process 或 handle——这不是洁癖,是"半年后改这段代码的人(很可能就是 AI)能不能改对"的问题。
DFE 可演进:三条铁律。接口加字段用新字段号,别改语义;配置项必须有默认值,否则老版本读不到起不来;数据库变更走"先加后删",别一步到位。
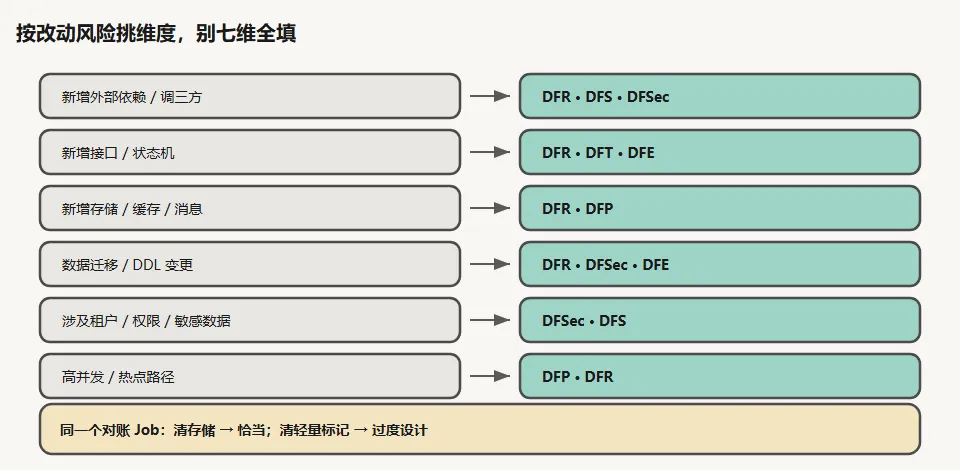
最后是全文我最想强调的一句:DFX 要对准本次需求的风险,不是把模板抄一遍。
同一个"对账 Job",放在清存储这种真金白银的场景叫恰当;放在清一个轻量标记的场景叫过度设计。七维全填、全是模板话的设计,分数很漂亮,实际既没防住风险,还拖慢交付。
用风险挑维度,别用模板填满格子。
七、规则写了一堆,事故照样来,问题出在入口和出口
讲到这儿,你可能会说:这些规则我们都有啊,超时、幂等、熔断、退避,文档里全写着。
对,规则一点都不缺。 缺的是两件事。
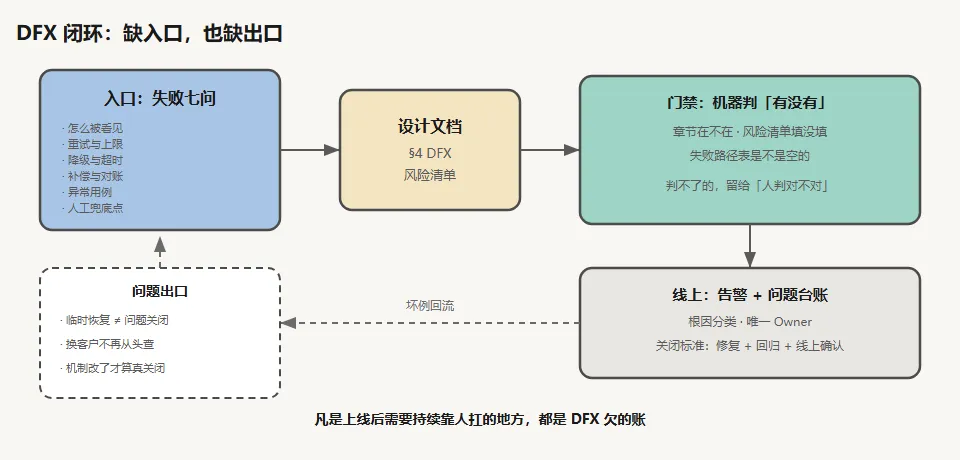
第一件:入口。
那些规则全落在编码规范和交付检查上——"重试要退避"是编码规范,"熔断要用公共库"是复用规范,都在开始写代码之后才出现。
而事故是在设计那一刻埋下的。设计的时候没人问:"这条链路失败了会怎样?"——就像这次 review,我盯着主流程看了二十分钟,愣是没问一句。
所以现在团队里定了个规矩,动设计之前先过一遍"失败七问":
失败怎么被看见,我能不能比客户先知道?
要不要重试?退避和上限是多少?超限了会不会进告警?
有没有降级、熔断、超时?整条链路的超时预算通了吗?
有没有补偿或者对账?靠什么数据证明业务是对的?
测试用例能不能覆盖所有异常链路?
上线之后需要操作手册吗?错误提示能不能支撑排障?
上线之后还有哪些地方需要人工兜着?
七问答完,设计文档就自动长出了 DFX 章节;答不上来的,就是没想清楚的风险。它不替代评审,只是保证评审的时候有人会问。
第二件:出口。
线上问题查完了,然后呢?重启一下、重新上传一下、手工改一条数据——这个客户救回来了,这件事就"关闭"了。
这才是最要命的:把临时恢复当成了问题关闭。 没有归类、没有唯一责任人、没有关闭标准,下次换个客户,同样的坑从头再查一遍。作为 TL,我最怕的不是出事故,是同样的坑在别人身上再出一次。
要补的很简单,一条问题台账,每条记四样:根因分类、唯一 Owner、关闭标准、线上验证结果。 关闭标准就一条——根因修复 + 回归通过 + 线上观测确认。
落地时还有个特别清醒的分工:机器管"有没有",人管"对不对"。
"文档里有没有可靠性章节""风险清单填了没有""失败路径表是不是空的"——这些结构性问题,机器扫一遍就能判,判得准还便宜。
"这个降级方案合不合理""这个对账 Job 是不是过度设计"——这是语义判断,机器判不了,硬判只会催生形式主义。
所以正确的姿势是:把检查卡在状态流转上(比如转测那一刻),机器拦"缺章漏项",人只负责最后那一层"搭不搭"。
结语:DFX 后端类比总表
写了这么多,最后落到一张表上。这些缩写你要是记不住,记右边那一列就行:
| DFX 维度 | 你以为的官话 | 你其实在写的代码 |
|---|---|---|
| DFR 可靠性 | 故障隔离、强依赖转弱 | context.WithTimeout、重试上限、select { case <-ctx.Done() } |
| DFP 性能 | 容量评估、过载保护 | 索引、批量查询、别在循环里发 RPC |
| DFS 可观测 | 全链路监控、告警体系 | 带一个业务链路 ID、日志带上下文、告警带处置建议 |
| DFT 可测试 | 可控制性、可观察性 | 依赖注入、别写包级单例、异常路径有断言 |
| DFSec 安全 | 身份认证、访问控制 | 每个查询带 tenant_id、日志别打手机号 |
| DFM 可维护 | 模块化、低耦合 | 函数 50 行、名字能把意思说清楚 |
| DFE 可演进 | 向前兼容、灰度升级 | proto 用新字段号、配置有默认值、DDL 先加后删 |
你会发现,最右边那一列,你每天都在写。
所以 DFX 从来不是要额外学的新东西。它是把已经在做的那些动作,提前到设计那一刻,系统地做一遍。
AI 让写代码变得空前便宜,也让"没想到"变得空前昂贵——它写得太快,快到连"这儿要是失败了"都来不及想。
所以我现在做代码review,不看代码写得漂不漂亮,只看两件事:失败了会怎样,出事了能不能查。 这两条过了,剩下的都好说。
功能需求决定系统能不能上线,DFX 决定它能不能活过第一个月。
最后留一句话,是这段时间遇到线上问题最大的收获:
凡是上线后需要持续靠人扛的地方,都是 DFX 欠的账。
我是小❤,我们下期再见!
 你最好看