ARTICLE · 1310444
AI画图终于不用抽卡了
凌晨一点半,我在跟一个模型较劲。不是不会写提示词——写得很清楚了:标题在左上角,人物在右侧,右下角留白放二维码。
它给我第八张,依然是居中的、对称的、四平八稳的。
我盯着屏幕想:我这哪是在画画,我是在许愿。
这个僵局,最近几天松动了。
一、这两天圈里在传的一个模型
一个叫 MOSS-Image 的开源文生图模型,模思智能和 OpenMOSS 团队做的,主干只有 5B。开源四天,海内外下载量破百万,直接登顶 Hugging Face 文生图趋势榜。11 月 3 日,硅基流动也上线了它。
最初我以为又是一次"榜单刷屏"。但这轮讨论里有句话让我停下来多看了两眼——大家争的不是"画得多好看",而是"终于不像 AI 画的了"。
这两件事,差得挺远。前者是审美,后者是病根。
二、它主要动了三个地方
1. 先把"AI 味"从训练数据里剔掉
圈子里的一个说法:现在越来越多模型拿 AI 生成的图去训练,练出来的东西就慢慢带上同一种"味"——过分精致的皮肤、糊成一片的发丝、塑料质感的衣褶。数据在循环喂养自己。
MOSS-Image 在数据环节做了件反着来的事:训练集里把 AI 生成图剔出去,只留真实图像,还顺手标注了水印、模糊这类属性。
所以它给人的第一印象不是"更漂亮",是"更不塑料"。皮肤保留细纹和毛孔,头发边缘不整齐,布料褶皱不是熨过的。
2. 构图可以用坐标"框死"
这是我觉着最实用的部分。它支持结构化 JSON 布局加边界框,你可以直接告诉它每个元素的位置和范围:
{
"summary": "极简白茶产品主图,浅米色背景",
"items": [
{ "type": "object", "desc": "白色陶瓷茶罐,哑光质感",
"bbox": [400, 180, 420, 460] },
{ "type": "text", "desc": "主标题:白露",
"bbox": [120, 80, 700, 140] },
{ "type": "text", "desc": "底部信息:净含量 50g",
"bbox": [120, 900, 700, 50] }
]
}
官方数据:7Bench 布局评测里,目标定位 mIoU 0.88(坐标基于 1200×672 画布)。
以前你要说"标题在左上、人物在右侧、右下角留 200 像素放二维码",全靠自然语言磨,磨十遍它还是给你居中。现在它是真的按坐标摆。
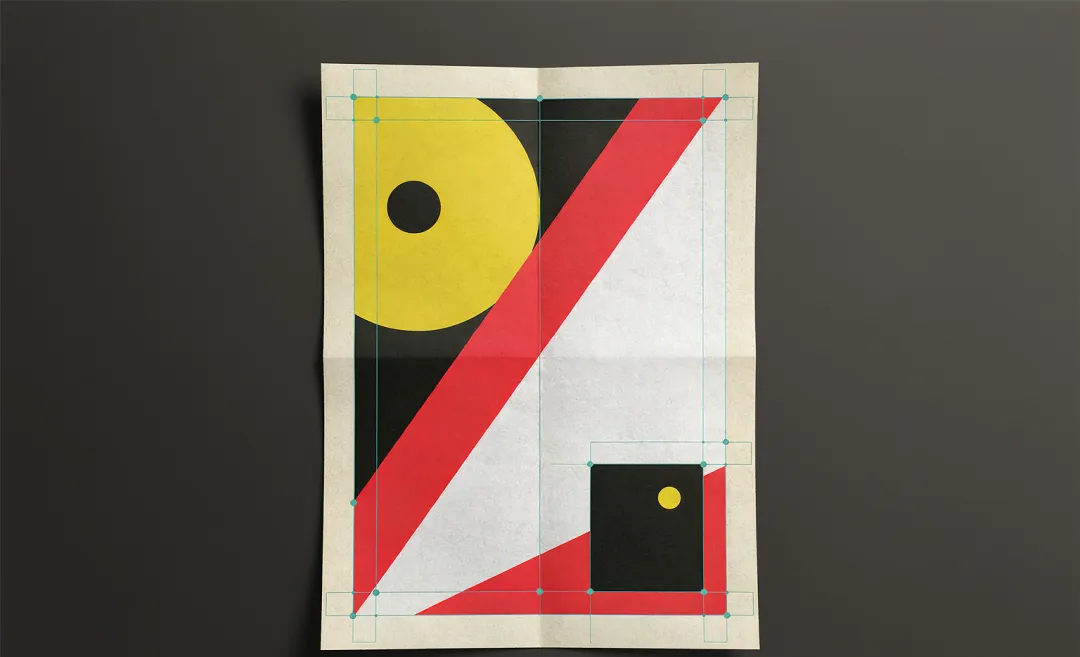
把"感觉"变成"坐标",设计才谈得上被交付
3. 长提示词吃得下
支持最长 4096 tokens 的文本条件。这意味着你不用再把一个想法压缩成五个关键词,可以把主体、空间关系、文字内容、镜头语言、质感一次写完。下面这段可以直接抄去改:
一位穿深蓝长衫的旅人站在巨大月洞门前,门内是
发光的山水,门外是雪地。
构图:人物占画面右下三分之一,月洞门圆心落在
左上方黄金分割点,顶部留白。
色调:墨蓝、靛青,一点点朱砂红。
质感:宣纸水墨 + 极细金色描边。
镜头:35mm,平视。
不要:赛博朋克、霓虹、过度锐化。
一个不太显眼但很重要的变化:社区有人反馈,这代模型对长描述遵循更好,堆一长串 lowres, bad anatomy, worst quality 的负面词反而会干扰它。你不需要再背提示词公式了,你需要把话说清楚。
三、但先别急着换工具
泼点冷水,四条:
- 慢。
官方默认 50 步,社区在做 8 步、4 步的加速版,但还在测试,不是开箱即用。 - 画风会飘。
有开发者明确指出某些风格下稳定性还不够。要做高度统一的系列图,LoRA 该压还是得压。 - 文字渲染别全信。
"中文长文本覆盖率 96.3%"衡量的是"该出现的字有没有出现",不等于逐字正确。海报、包装这种要交付的活,出图后一个字一个字核。 - 榜单数字多是自测。
RLA 真实设计盲评里它 Elo 1698.70,排第二,仅次于 GPT Image 2——成绩漂亮,但当参考,别当定论。
所以现在的选型很清楚:做商业海报、电商主图、带字的封面,它顺手;做高度风格化的系列创作,SD 那套 LoRA 生态还是更成熟。工具之间不是替代关系,是分工。
四、真正值得注意的,不是这一个模型
把最近一个月的事排在一起看,会发现一件更有意思的事:
10 月 6 日,Google 的 Nano Banana 2.1 上了 "Thinking" 模式——落笔之前先推理,先拆主标题、副标、图表、版权说明的视觉权重层级。Krea 2 学会了 boxed layouts。11 月 2 日,商汤的 SenseNova 6.8 Flash 把设计生成铺到了 SVG、Three.js、Blender,还能接 Figma 工作流。
四家,做法不同,方向一致:从"生成"走向"控制"。
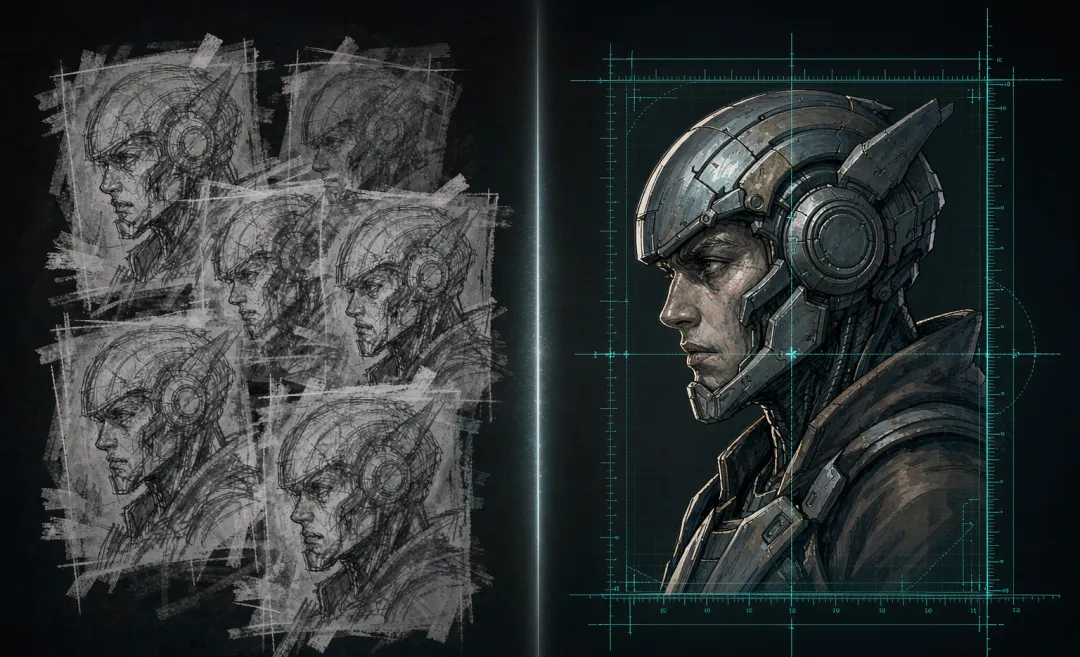
左边是反复抽卡的废稿,右边是能被描述、被复现的那一张
过去两年,AI 绘画的进步主要在"像不像"。接下来这两年的竞争,在"听不听话"。对做创作的人来说,这是好事——因为"像"是模型的能力,而"听话"才把决定权还给你。
· · ·
我常被问:AI 会不会取代画师。
这两年我的答案越来越简单:它取代不了审美,只取代"手"。
工具换代,换的其实是"手"这部分的成本——从把参数调到凌晨三点,到把想法说清楚。真正稀缺的从来不是会不会调 CFG、会不会挂 ControlNet,是你知道那张图该长什么样,以及为什么该长那样。
那些熬到深夜的班,希望以后能少一点
所以这次更新真正让人高兴的地方,不是"又能出好看的图了"。
是你终于可以把力气,花在想上,而不是花在猜上。
你画图最常崩在哪一步?手指、文字、光影,还是怎么摆都不对?
评论区说说,我按呼声最高的那个,出下一篇具体的修法。
说明:本文事实来自公开报道及 OpenMOSS 团队公开技术资料(截至 2026 年 11 月 4 日),模型能力与评测数据以官方发布为准;对比结论与选型建议属个人观点。