ARTICLE · 1317559
AI自己造AI?RSI三条路线拆解:一条已能跑通,一条仍是纸面
AI自己造AI?RSI三条路线拆解:一条已能跑通,一条仍是纸面
11月2日,TechCrunch报道,Anthropic在S-1文件中说公司「可能即将达到」其负责任扩展政策(RSP)里「急剧加速」的定义——很多人把它直接读成「AI自己造AI」即将成真。但同一份披露还有两句:目前没有任何模型越过这条阈值;公司承诺在可预见的未来让人类留在研发流程里。三句放在一起,才是这类新闻的完整版本:能力演示很近,可信的自主改进还很远。 递归自我改进(RSI)听起来玄,机制可以一句话说清:改进的信号从哪里来、由谁验证。按这个标准,公开可查的路线有三条,成熟度差得很远。 模型自己不会变强,但围绕模型的那套「工装」——提示、工具、流程、验收标准——可以被反复改。这套外层系统业内叫 harness(可以理解为给模型套上的执行环境)。Lilian Weng 在7月的综述里写得很直接:近期的RSI路径不太可能从模型直接改写自己的权重开始。证据也确实出在这一层:论文 Harness2 在三个专业基准、四种「模型+harness」组合上做了对照,只走一步递归改进,GLM-5 和 Gemini 3.5 Flash 就稳定超过各自的原始配置,WorkBuddy-Bench 最高涨11.5分,JobBench 涨4.5分,LAB 涨11.8个百分点;递归步数预算加大,收益还在增加。 代价同样清楚。改进循环优化的是它拿到的信号:信号是单元测试,就可能过拟合测试;是裁判模型,就可能学会对付这个裁判;是跑分,就可能利用榜单漏洞——这就是常说的「刷分作弊」(reward hacking)。Harness2 自己也承认,开放世界任务在设计阶段没见过、测试时没有可依赖的标准答案来引导修改,而且改出来的东西高度绑定具体任务,换个场景就失灵。所以这条路线的准确定位是:能在受控基准上跑通,离通用的自我进化还有距离。 真正意义上的「模型重写自己」需要可靠的自我奖励信号——它得知道自己改对了。公开领域目前没有可复现的成功案例,这也是不给它任何时间表的原因。已有的反例反而说明门槛有多高:STOP这类递归改进机制在 GPT-4 上让下游表现逐轮提升,在 GPT-3.5 和 Mixtral 上却退化——递归结构本身不够,基座模型必须先有能力改进机制。 第三条路把改进从软件层搬进硬件层:用AI设计芯片,再让新芯片加速AI。Ricursive 公司刚发布的 Ripple-65B Preview,自称是「在模型与驱动它的硬件之间开始闭环」的第一步。方向真实,但闭环刚开始,谈收益还太早。 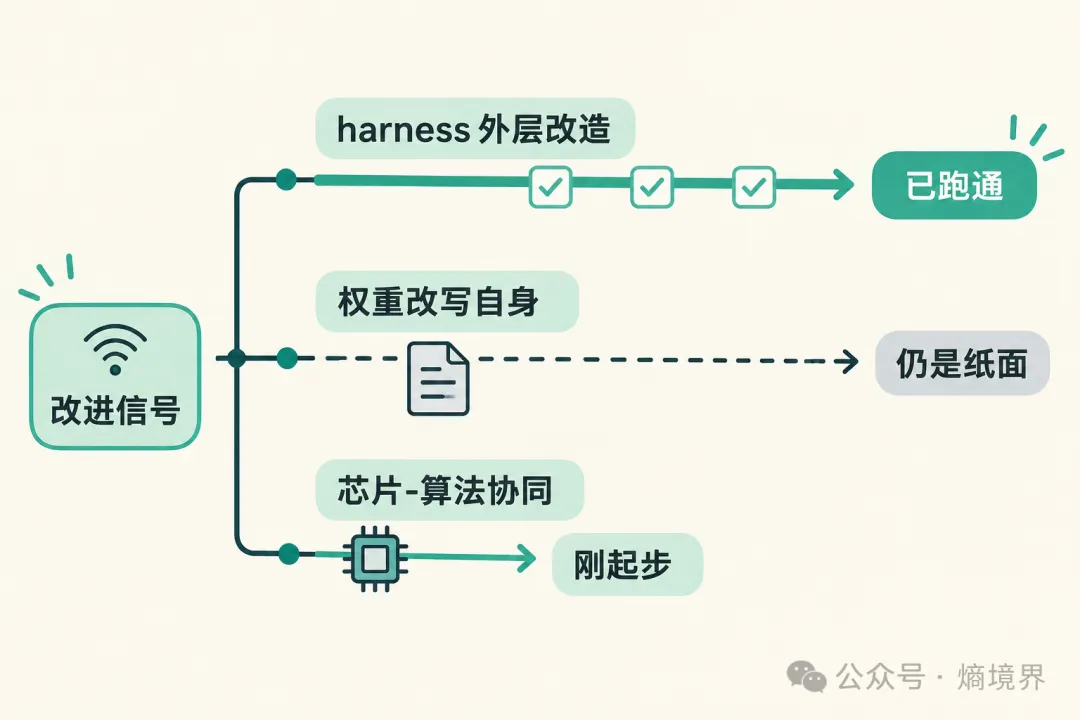
三条RSI路线的成熟度对比:harness已跑通、权重级仍是纸面、芯片协同刚起步 看两组数字比看口号可靠。Anthropic 自己的调查显示,91%的内部员工预计AI能在2030年前做出诺奖级发现,美国公众里这个比例是39%——52个百分点的预期差,说明「圈内人觉得快、公众还没感觉」本身就是常态;这是自报调查,不能当预测验证。商业上则是另一重错配:五大云厂商2026年资本开支指引合计约7200亿至7450亿美元,而OpenAI、Anthropic等模型厂商的收入还是百亿美元级。 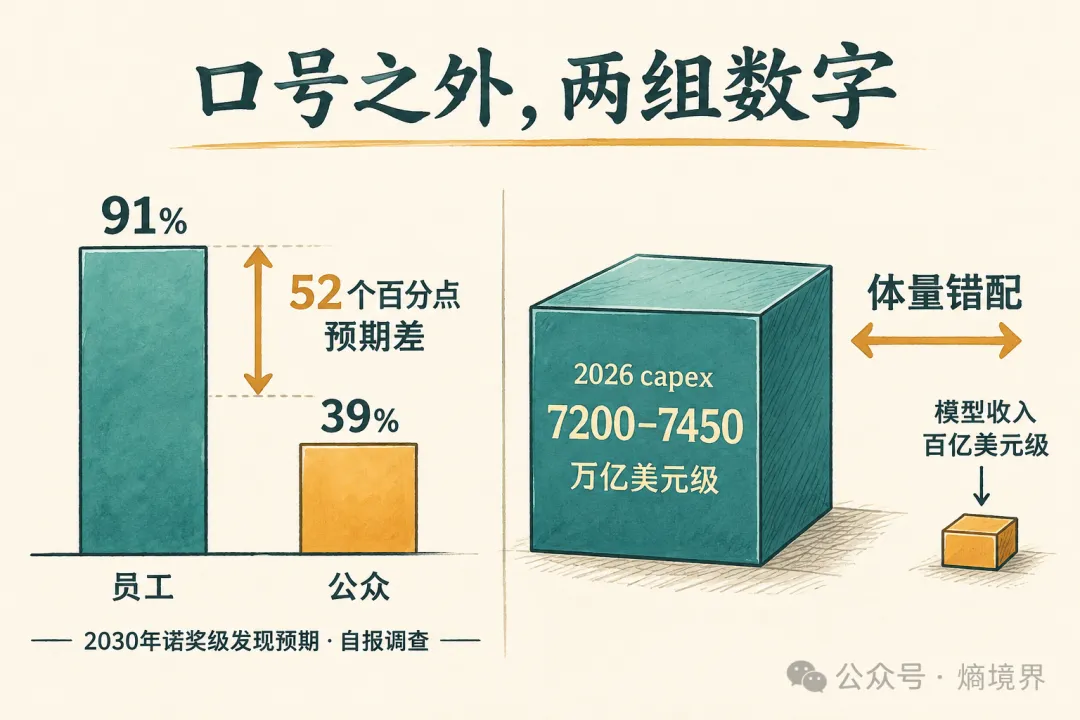
口号之外两组数字:91%对39%的预期差,与资本开支和模型收入的体量错配 所以下次再看到「AI自己造AI」的标题,可以先问三个问题:改进信号来自哪里?谁在验证它改对了?有没有越过这家公司自己设的阈值?按这三问过一遍:harness路线已经跑出可复现的分数,权重级路线还停在纸面,芯片闭环刚起步;而一边喊AGI、一边在招股书里写保留人类监督,并不矛盾——那正是当前真实进度的写法。 #WorkBuddy #harness2 #RSI递归自我改进#Harness工程#AGI时间表#AI资本开支#AI安全与监督
路线一:不改模型,改它外面那套系统
路线二:让模型改自己的权重,仍是纸面
路线三:芯片与算法互改,刚起步
那AGI到底邻不临近?