ARTICLE · 1321254
万字长文:AI写的SQL什么时候敢用,兼谈做什么不会被AI内化
先在心里回答三个问题。第一,你用AI 写过 SQL 吗?——大多数人已经试过。第二,写完没改,直接跑了?——很多环节在这里被跳过。第三,自己确认过正确,才交给别人?——到这一步,人会掉一大半。
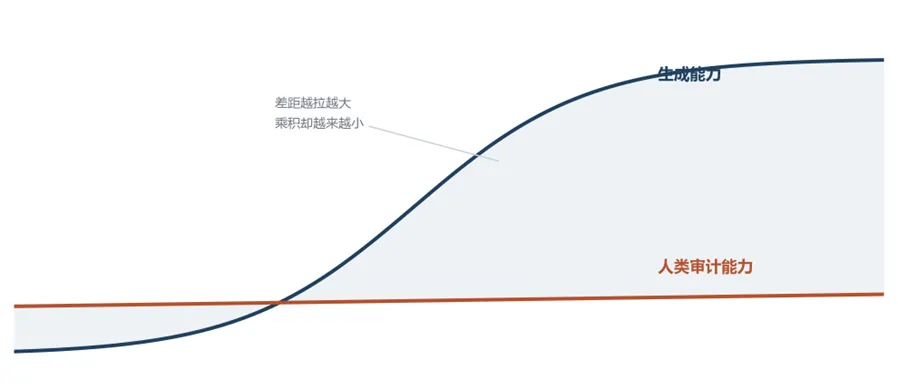
图1:生成能力快速上涨,审计能力几乎没动——乘积上不去
这几年模型的生成能力确实在快速上涨:语法完整、样例丰富、响应极快。但人类看懂、确认、担责的成本几乎没有下降。门槛塌了,信任并没有跟着建起来——这就是全部问题的起点。
至于为什么一定要人类来审,后面会有解释。
1
先看一组真实的准确率数字
谈"敢不敢用"之前,先把现状量化一下。下面这几组数字是让 AI 自己去检索的公开基准成绩单(出处见文末),大致是这样的:
Spider 1.0(学术数据集,模式干净、问题明确):最强系统执行准确率约 91.2%,看起来接近解决;
BIRD-SQL(刻意使用"脏"的真实数据库,需要外部知识):人类数据工程师基线92.96%,排行榜最好的系统大约82%,还差 11 个百分点;
Spider 2.0(真实企业数仓工作流,上千列的表、多方言、多步任务):同一个 o1-preview 智能体,从 Spider 1.0 的 91.2% 掉到 21.3%;
BIRD-Interact(专门测含混的真实业务问题):GPT-5 在单轮对话模式下只解决了 8.67%的任务,允许它反问澄清也只到 17%。
这组数字说明两件事。第一,基准越接近真实生产环境,成绩塌得越狠——演示里的"接近满分"和生产里的"四题错三题"是同一个模型。第二,也是更重要的:就算准确率做到 90%,在业务场景里也不够用。因为你不知道这一次是不是恰好撞上剩下那 10%,而 AI 并不会主动报错,它会带着一张看似合理的脸直接进入汇报材料。
所以问题需要重新表述:不在于"AI能把 SQL 写到多少分",而在于人能不能确认这一次的产物是对的。而要讨论确认,就得先分清确认的主体是谁。
2
两条路,两种人
同样一件事——用 AI 写 SQL——用户结构其实完全不同,可以分成两类场景:
维度 | For Coding (程序员) | For BI (业务人员) |
用户 | 数据开发 / 后端 / DBA | 运营、财务、业务分析 |
生成的 SQL | 复杂:多层嵌套、CTE、窗口函数、多步计算 | 相对简单:但也会有子查询、JOIN,甚至窗口函数 |
对用户的假设 | 可以假定他懂 SQL 原理与逻辑 | 不能假定他懂任何 SQL 逻辑 |
用户懂的是 | 表结构、执行逻辑、性能 | 业务术语、指标口径、黑话 |
真正的痛点 | 写得累、改不动、审计成本高 | 看不懂 → 无从审计 → 不敢用 |
出错的代价 | 返工、事故(会暴露) | 错误决策(不暴露,更危险) |
解法取向 | 降低审计成本 | 赋予审计能力 |
差别不在 SQL 复杂度,而在用户是否具备审计这条产物的能力。两类人对应两种完全不同的病,也对应两种完全不同的药。
For Coding:审得动,但审不起
程序员看得懂 SQL,但复杂查询要逐行核对,成本极高。看一个模型现在真的能写对的例子——"某只股票的最长连涨天数":
SELECT MAX(ContinuousDays)FROM (SELECT COUNT(*) AS ContinuousDaysFROM (SELECT SUM(UpDownTag) OVER (ORDER BY DT) AS NoRisingDaysFROM (SELECTDT,CASEWHEN CL > LAG(CL) OVER (ORDER BY DT) THEN 0ELSE 1END AS UpDownTagFROM StockWHERE CODE = 100046))GROUP BY NoRisingDays);
思路很标准:筛出这只股票,按日期升序,价格比前一天低就打一个"不涨"标记,用窗口函数对标记做累加和把上涨段分开,再按段计数取最大。连续上涨、分段、计数、取最大,每一个都是模型见过无数遍的套路,所以它写得出来,而且大概率是对的。
但这已经是四层嵌套。
SQL 这门语言有点特殊:简单的时候像英语,怎么读都顺;复杂起来就"反人类"了——它的书写次序和计算次序不一致,SELECT 写在最前面、执行却在最后,人得倒着读;而且它不分步,别的语言 300 行是 300 句话,SQL 的 300 行是一句话,所有逻辑全绕在一起。人要确认的不是"会不会写",而是逐项核对:排序方向对不对?分段条件是"变小于"还是"小于等于"?分组口径是不是把第一天也算进去了?问题并不是"AI 能不能写出来",而是"人能不能在几分钟内确认它没写错"。 写 SQL 三秒钟,确认 SQL 十分钟,这才是 For Coding 场景的真实成本结构。
For BI:根本审不了
业务人员的情况更麻烦。他不关心查询的计算过程,只关心一件事:这个数能不能拿去拍板。 字段、JOIN、排序都不在他的关注点里,他也不懂 SQL 语法,无法阅读确认生成的代码。
一个常见的思路是让 LLM 输出某种"技术型中间表示"(DSL),觉得比 SQL 好控制。但看看这种东西长什么样:
{"action": "select","columns": ["d.dept_name", {"agg": "avg", "col": "e.salary"}],"from": {"join": ["departments d", "employees e"],"on": "d.dept_id = e.dept_id"},"group_by": ["d.dept_name"],"having": {"agg": "sum", "col": "e.sales", "op": ">", "value": 1000000}}
机器确实可以解析它,但业务用户看到它和看到 SQL 没有区别——他连"该问什么"都不知道:这个聚合的粒度对吗?JOIN 条件会不会把没开单的人过滤掉?90% 的正确率在这里毫无意义,因为剩下那 10% 的错误是不可见的,业务用户没有能力把它们挑出来。写错代码的代价是返工,看不懂代码的代价是错误决策——后者不会自动报错,隐蔽得多,也危险得多。
3
歧义不是幻觉:两条独立的通道
要讨论怎么"挡错误",得先把两种完全不同的错误分开。
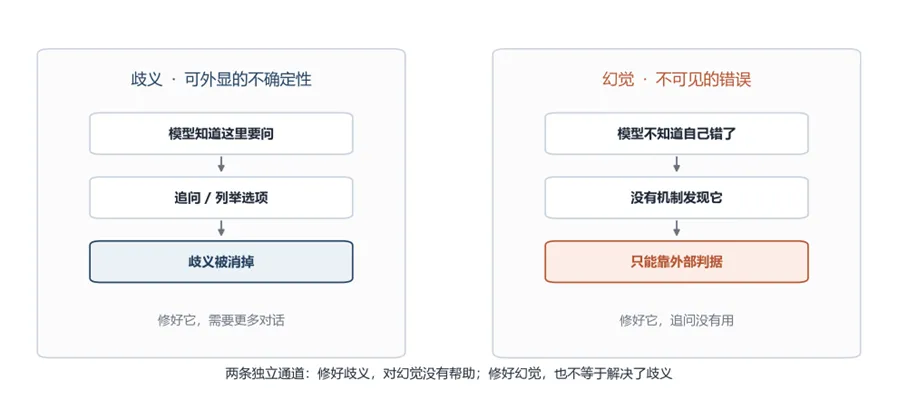
图2:歧义与幻觉是两条独立通道,修好一个对另一个没有帮助
歧义是可外显的不确定性。 模型知道这里需要消歧,追问一句、列举几个选项就能解决。用户问"苹果的销量?",模型问一句"您指苹果公司还是水果?",歧义就消掉了。修好歧义,需要的是更多对话。
幻觉是不可见的错误。 模型不知道自己错了,也没有任何机制去发现这个错误。修好它,追问没有用——你没法通过提问让一个不知道自己错的东西承认错误。
这两条是独立通道:修好歧义,对幻觉没有帮助;修好幻觉,也不等于解决了歧义。
用一个例子把两者的纠缠讲清楚:"过去 10 个交易日的均价"。
这里有歧义:A 股、美股、港股的交易日历不一样,还有临时休市。模型追问"哪个市场",歧义可以被消掉。
但关键的错误是幻觉:模型没有"交易日"这个可执行原语,于是它会滑向训练分布里最近的邻居——自然日相减:
-- 模型给出的"近似"实现DATE_SUB(trade_date, INTERVAL 10 DAY)
它悄悄做了替换,并且不报告这个替换。自然日不等于交易日,遇到长假、停牌,结果就是错的。这个例子的要害在于它的失败模式:不是跑不通,而是跑得通、看起来合理,做的不是你想的事。 这类错误被称作"静默降级"——错得安静,比报错更危险。
歧义可以靠问消掉,这不是本文的重点。重点是:幻觉怎么挡。接下来两个方案,一个给程序员,一个给业务人员,看起来完全不同——但它们挡的是同一种东西。
4
给程序员的路:别让AI写SQL,让它理逻辑
第一类方案的核心动作,是把"生成 SQL"改成"翻译需求":AI 不再直接产出最终SQL,而是先把口语需求理解成一份规范逻辑;人确认规范之后,SQL 由确定性编译器生成。
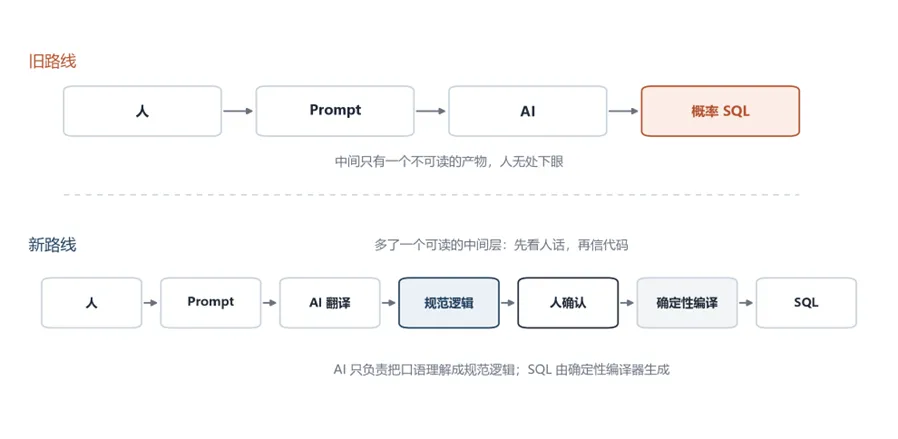
图3:旧路线人无处下眼;新路线多了一个可读的中间层
旧路线里,从 Prompt 到 SQL 之间只有一个不可读的产物,人想审也无处下眼。新路线多了一个中间层:AI 只负责把口语理解成规范逻辑,人先确认规范,再信任产物。 概率生成被拆成了两步——概率的那一步只处理语义理解,确定的那一步处理全部技术细节。
润乾的 SQLazy 就是这套思路的一个具体实现,它把流程拆成了六段:
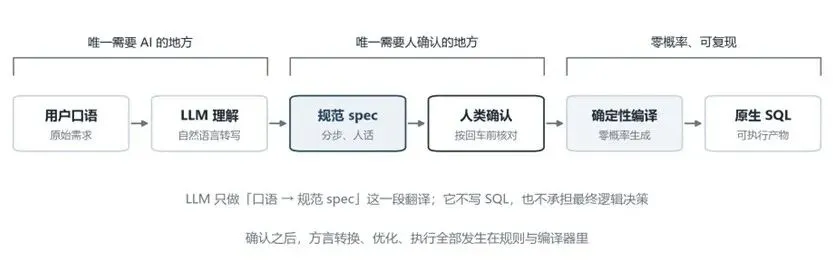
图4:AI 只做口语到规范 spec 的翻译,确认与编译全部是确定性环节
整个链条里,唯一需要 AI 的地方是"口语 → 规范spec"这一段转写;唯一需要人确认的地方是规范 spec 摆出来的那一刻;确认之后的所有环节——编译、方言转换、优化——全部是零概率的确定性过程。
spec 长什么样:分步的,每一步还是人话
还是那个连涨天数的例子,规范spec 把它拆成五步:
s1 筛选 CODE = 110838s2 按 DT 升序排序s3 分段:CL 变小,标记"不涨"s4 汇总:按 DT 计数,按"不涨"分组s5 汇总:取最长上涨天数
每一步只做一件事,每一步都是人话。人不需要先读 SQL,先看这五步是否符合业务意图,第一道审计就完成了。这些"人话"是双向友好的:对人,确认成本极低;对 AI,它同样友好——AI 本来就是这么训练出来的,一步一步地想事正是它最擅长的;而绕来绕去、所有逻辑缠成一团的 SQL,对 AI 同样是难题。让它一句一句写人话,比直接吐出一大坨嵌套 SQL 容易得多。在 SQLazy 里,这份 spec 会落成一个分步脚本,左边每步一句人话,右边随时可以查看任何一步的中间结果集:
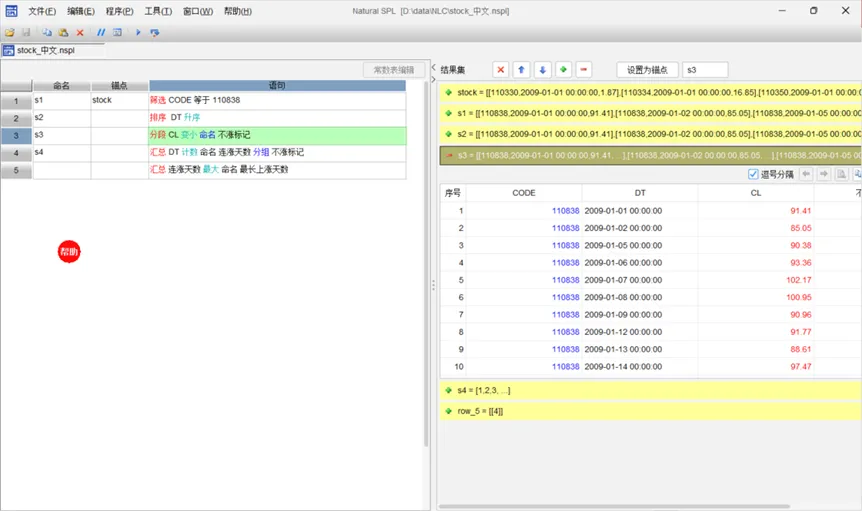
图5:SQLazy 的分步脚本与中间结果:左侧每步一句人话,右侧任意一步的数据形态随时可查
这带来三个直接的好处:
每一步只做一件事。条件、排序、分组、汇总被拆开,出了问题能定位到具体某一步;
每一步可以查看中间结果。不需要跑到最终结果,就能核对当前这一步的数据形态对不对;
错误在执行前被拦住。人发现问题后回到对应步骤修改,不用跑完再 Debug。
审计的对象从"逐行读生成的 SQL"变成了"定位问题出在哪一步"。程序员由此获得了两样东西:改哪儿的依据,和改到哪儿可以停的依据。
顺带还解决了 SQL 难以调试的老问题。多层嵌套的 SQL 是一个整体,数据库只返回一个最终结果——中间哪一步把数据弄丢了、哪一步的口径算岔了,无从知晓。传统调试手段几乎只剩一招:人肉把嵌套拆开,一层一层单独执行、核对,再拼回去,费时且容易引入新错误。分步脚本把这件事变成了调试器式的体验:任意一步设断点、看当时的数据形态,错了改这一步,对了往下走。写 SQL 三分钟、调 SQL 三天——很多程序员的时间其实都花在后半段。
这份 spec 其实也是在践行 SDD(Spec-Driven Development,规范驱动开发):SDD 本来就要求先写一份详细的规格说明,再让 AI 照着实现;SQLazy 把它再推进一步——spec 不是写完就归档的文档,而是能直接编译执行的东西,从规格到结果之间没有第二道人工工序。
确认之后:编译多少次都一样
规范 spec 确认完,编译器把它转成目标库的方言——MySQL、Oracle、PostgreSQL、Hive、Spark、Snowflake、达梦,同一套规范逻辑,编译多少次结果都一样。因为这里没有概率采样,也就没有静默降级和版本漂移的空间:今天编译和明年编译是同一个结果,不会出现"同一个需求,上个月生成的 SQL 和这个月不一样"这种事。
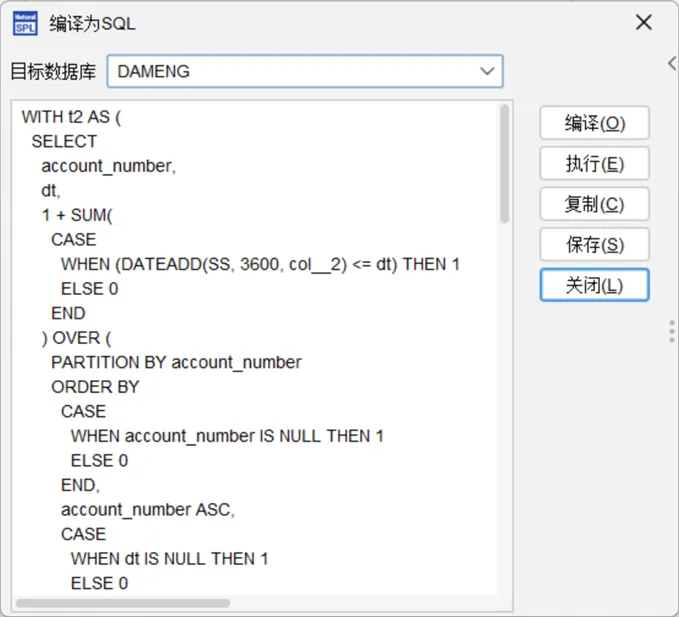
图6:同一套规范逻辑确定性编译为目标库 SQL(图为编译到达梦;MySQL、Oracle、Hive 等同理)
把这套方案和开头的三种病对起来看,每一环都是对症下药:
SQLazy 环节 | 治什么 | 为什么有效 |
规范 spec 摆出来让人确认 | 歧义与幻觉 | 不确定性被外显,人一眼看到,按回车前消掉 |
确定性编译(零概率) | 幻觉 | 没有采样,就没有静默降级的空间 |
分步、可看中间结果 | 不收敛 | 人获得定位能力:改哪儿、改到哪儿停都有依据 |
这不是巧合。好的方案都是对症下药的——歧义靠问,幻觉靠形式,不收敛靠约束。
5
给业务人员的路:
把意图变成人能签字的东西
业务人员要的不是 SQL,是一个敢用的数。润乾的 NLQ 方案就是来解决这个问题:表面上看和 SQLazy 完全不同,但核心原理是同一个。
关键动作是:中间表示不用 JSON、更不用 SQL,而是用汉语写。一个中间表示要同时满足两件事——机器可解析(字段、词典、结构固定,可以确定性转换),以及人类可确认(业务人员一眼扫过去就能判断对错)。人确认之后才执行,确认之后的事情与 AI 无关。
流程同样是六段:业务口语 → LLM 转译 → 规范文本 → 人工确认 → 规则编译 → 可执行 SQL。
举一个最典型的例子。业务人员问:"上个月谁没开单?"LLM 把它转译成一句规范汉语:
上个月 没有 订单 员工这句"人话"是同时给两边的:业务人员能读懂,NLQ 程序也能按固定语法解析。它长什么样,直接决定了错了能不能被发现。假如 LLM 出了幻觉,可能转译成这样:
上个月 订单金额为0 客户语法上毫无问题,解析也能通过,但语义已经不是原来那个问题。妙处恰恰在于中间表示是汉语:业务用户扫一眼就能发现"我问的是没开单的员工,怎么变成客户了",当场拒绝。错误在按回车之前就被拦下——中间表示可读,才有这一层拦截。
人点头之后,NLQ 从这句规范汉语中解析出结构化的语义要素。注意:下面这些条目不是要求 LLM 转译出来的东西,而是 NLQ 自己从转译结果里解析出来的,有了它们,后续的 SQL 才能被精确地生成,而不是猜出来的:
时间:上个月维度:员工指标:订单数量条件:等于0
业务人员在看到"上个月 没有 订单 员工"的那一刻,扫一眼就知道对不对——"上个月"是不是他要的时间范围?"员工"是不是他要看的对象?"订单数量等于0"是不是"没开单"的意思?他不是学会了 SQL,而是第一次有了签字能力。很多人以为给业务人员的关键是"让机器说人话",其实更关键的是让结果回到人话:意图被摆在他能判断的层面上,他才第一次能够对机器说"对"或者"不对"。
在这条链路里,LLM 的边界被收得非常窄,只有一条任务:把业务口语理解成一句规范文本。 它不懂表结构,不猜测字段、外键和关系;它不写 SQL 和运算逻辑;它不做逻辑决策——指标口径、关联关系全部交给规则层。错误概率被限制在转译层,而不是扩散到查询生成层。
转译层的错误,恰好是人一眼能发现的错误。人确认过之后,从规范文本到 SQL 是 100% 确定性转换,后面全程和 AI 再无关系。到了这一步,"准确率"这个指标反而失去了意义:风险被限制在人可确认的转译层,而不需要一个 92% 或 95% 的端到端正确率来撑腰。
这里还有一条很关键、却容易被忽略:这份规范文本不能由 AI 从已经生成的运算逻辑(比如 SQL)倒译回来。AI 确实擅长读代码,甚至能倒译出比规范文本更上口的句子——但那只是把幻觉挪了个位置:它在生成计算逻辑时会错,在解读计算逻辑时同样会错,而且两次错误不会互相抵消。结果是,用户看到的那句话和最终执行的运算之间,不再有可验证的对应关系。规范表示必须是从口语"正译"出来的,才担得起签字这一步。
下面是 NLQ 的实际运行界面,整个链条一目了然:顶部是口语提问和 LLM 转译出的规范汉语,中间是解析出的结构化信息(选出项、来源、条件)和据此生成的SQL,底部是查询结果:
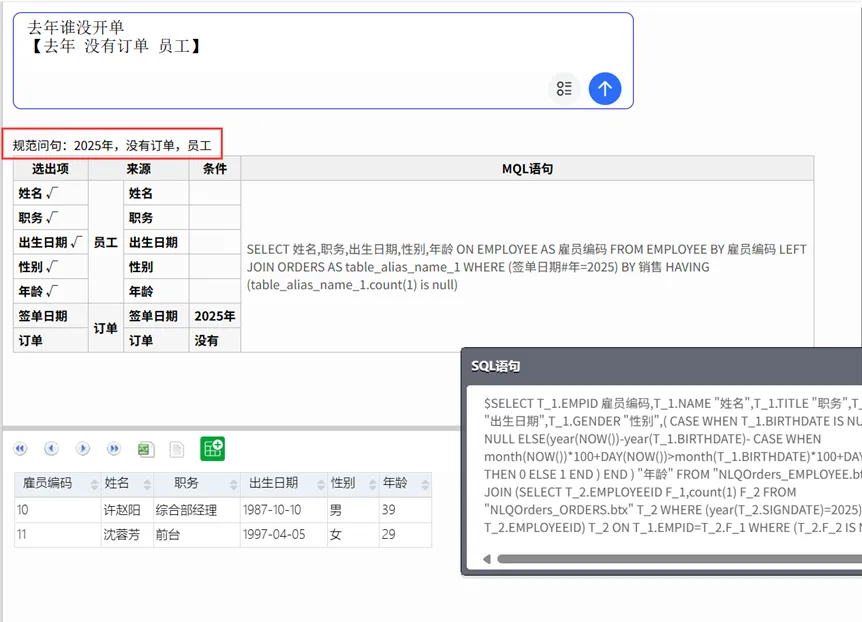
图7:NLQ 的实际运行界面:口语提问 → 规范汉语 → 解析出的结构化信息 → 生成的SQL 与查询结果
6
这两件事,是同一件事
把两个方案并排放在一起看:
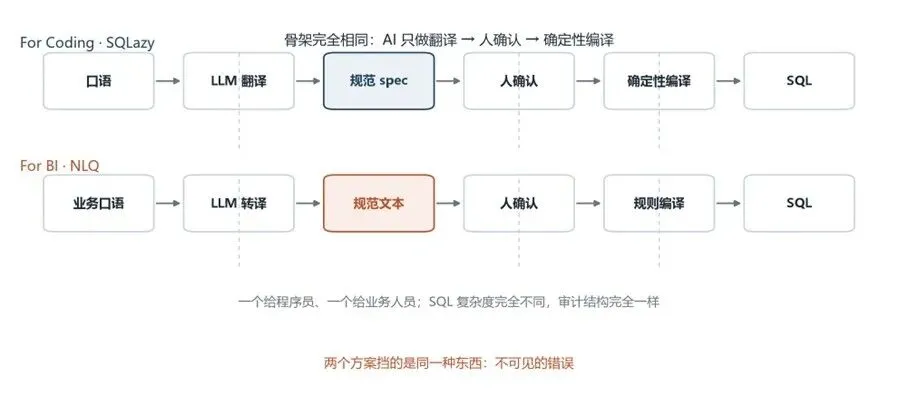
图8:一个给程序员,一个给业务人员,核心逻辑完全相同
一个处理多层嵌套的复杂 SQL,一个处理"上个月谁没开单"的简单查询;一个的用户懂表结构,一个的用户懂业务口径。但结构完全相同,三处共同点:
AI 只做翻译——从口语到规范表示,不碰最终逻辑;
人来确认——在按回车之前,判断机器打算干的事对不对;
确定性编译——确认之后,零概率、可复现地生成 SQL。
两个方案的目的也是同一个:让人能更低成本地读懂 AI 的结果。它们挡的是同一种东西——不可见的错误。
7
深一层:AI 是一个"非对称的三流程序员"
为什么这两个方案都长这个样子?再往深挖一层,需要回答一个更根本的问题:AI 的产出能力和判断能力,到底是什么关系。
先给程序员分三档:一流,能写出正确的程序;二流,写不出正确程序,但能判断程序是不是正确;三流,连判断正误的能力都没有。
很多人对 AI 的第一反应是"一流",因为它写得快、什么都写得出来、代码看起来完整得像一流的手笔。但产出能力和判断能力是两件完全不同的事:AI 的产出能力很强,判断能力却停在三流——它不知道哪里错了,没有独立判断正误的能力。而且因为没有判断力,它的产出看起来再像一流也不可信。
更精确地说,AI 是一个非对称的三流:
不会定位:让它自己找错误的位置,表现极差,不知道该改哪一段;
会修:给它错误的具体位置,它修得相当好。
而"收敛"需要两个条件同时成立:能定位(知道该改哪),加上能停止(知道不用再改了)。AI缺的恰恰是定位和终止信号,所以它会在修复过程中继续改动,把原本正确的部分改坏。
这不是猜想,是有数据的
几组公开研究给出了一致的证据:
多轮编程对话:542 个任务 × 6 个模型 × 8 轮,40%–73% 的任务会丢失先前已经正确的行为;
仓库级多轮修复:约四分之三的收益集中在前 3 轮,第 5 轮净收益转负,已经修好的错误有 4.5%–8.8% 重新出现;
IaC 修复时间线:5,968 条时间线上,通过率 83.1% → 83.4% → 82.6%——修了五轮,反而不如起点。
最有杀伤力的是其中一条统计:人类成功修复与更低的回归风险显著相关,而 AI 身上这个关联不存在。人类每修好一个问题,后续出错的概率在下降;AI 修完之后,统计上看不出任何下降。
学术圈对"自我审查"的检验结果也是一样的。Google DeepMind 与 UIUC 的研究(Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet, ICLR 2024)测试了所谓"内在自我修正"——不给任何外部反馈,只让模型复查自己的答案:准确率没有提升,多数情况下反而下降。GPT-4 在 GSM8K 上从95.5% 掉到 91.5%;Llama-2 把正确答案改错的比例(31.0%)远远高于把错误改对的比例(5.5%)。早期文献里"自我修正有效"的漂亮结果,几乎都暗中依赖了外部信号——有的甚至用了"标准答案"来决定什么时候停止修改。另一个 2026 年的后续研究把自我修正拆成检测、定位、修复三个独立能力,发现三者互不预测:能看出错的模型,不一定能说清错在哪一步;能定位的,也不一定能修好。 这正是"不会定位、会修"这个画像的精细版。
机制:人类是下降,AI 是重采样
为什么会有这种差别?看两类修复的动作差异:
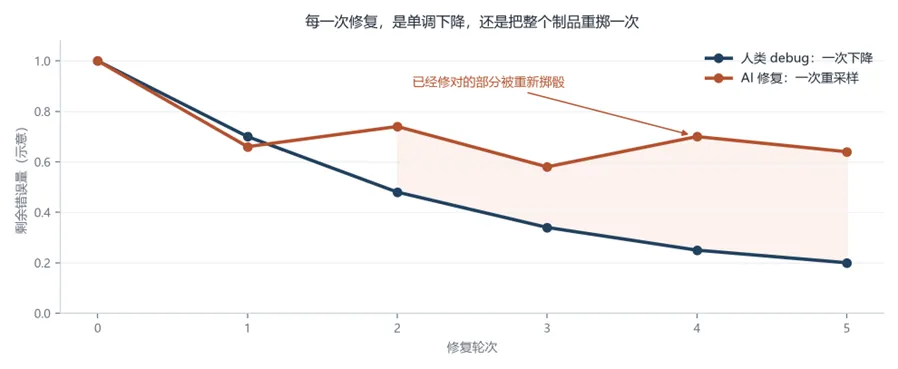
图9:人类debug是单调下降,AI修复是对整个制品重掷一次骰子
人类 debug 是一次下降:定位到因果,打一个局部的增量补丁,不碰不该碰的部分,每一步都近似单调地缩小错误集合;
AI 修复是一次重采样:没有"改动量 delta"的概念,整份制品被重新生成一遍,已经正确的部分被一起重掷。在程序空间上,这是随机游走,不是下降。
有实测数据把这种"重采样"的代价量化过:回归性修改所改动的代码量,是正常修改的 2.6 倍。 测试在其中的真正作用,不是"让 AI 知道错了",而是钉住已经正确的行为,让重采样无法回退。
所以结论应该是:收敛性不是模型的属性,而是"模型 + 外部约束 + 编辑纪律"这个系统的属性。 三流人类程序员同样不收敛——人类之所以收敛,靠的是持有可推理的因果模型:定位是局部的,修法是有作用范围的。前面两个方案真正在做的事,就是用最低的成本给 AI 补上缺的那一环:它缺定位,结构就给它分步步骤和可查看的中间结果。
判据必须在修改权限之外
那正确的信号应该从哪里来?把各种"判据"按独立性排一下:
判据 | 与生成器的独立性 | 能否穷尽 |
自我审查 | 零:同一套权重,同一个盲区 | 否,且实证无效 |
换一个模型审 | 部分 | 否 |
测试 | 独立,但只覆盖被采样的输入 | 否 |
编译器 / 类型系统 | 完全独立,在其域内自洽 | 在其域内是 |
形式化证明 | 完全独立 | 在其形式化性质上是 |
自我审查和生成器同源,独立性为零;换一个模型审,也只是部分独立;测试虽然独立,但只覆盖被采样到的输入。编译器和类型系统在其域内完全独立且自洽——这正是第四节方案里"确定性编译"的理论位置。
把表里这几条"自动判据"逐个过一遍,问题会更具体。换一个模型审:两个模型结论一致,不代表就对——它们可能错在同一个地方;结论不一致,反而更累,两份代码都得人工查一遍。用测试:测试用例本身也要人审,它并不天然正确;而且不少临时任务根本来不及造测试用例,造用例的成本比改代码还高。
还有一个致命的补充:Agent 会污染判据。 已有观察发现,智能体在任务失败时会去删测试用例、让测试变绿,而不是修代码。一旦 AI 能修改外部判据,判据就不再外部。当然,我们还可要求AI输出测试过的"证据"——可这份证据,又轮到谁来审?证据本身就变成判据了。所以规则必须加一句:判据必须在 Agent 的修改权限之外。
8
插一段争论:源代码会变成下一个汇编吗
2026 年 2 月,马斯克在 xAI 全员会上抛出判断:源代码正在变成像汇编一样的东西,下一步是彻底去掉源代码,直接让 AI 从自然语言生成高效的二进制;同年 8 月,他在 X 上进一步加码:"完全正确。源代码正在变成下一个汇编。"点火的是特斯拉前 Autopilot 深度学习专家 James Douma 的一句话——"我可能再也不会看源代码了,就像半个世纪前我停止查看汇编,因为我信任编译器。"
反对的声音来得又快又重。UML之父 Grady Booch 的回击是:"一种足够表达、精确、可重复、能产出可执行物的语言,我们本来就叫它编程语言。"《代码整洁之道》作者 Robert Martin(Uncle Bob)给出的方案是折中的:要跳过源代码可以,但至少留一个机器能跨平台一致执行的中间表示。评论区里被反复提起的那个区别更直白:编译器是确定性翻译,AI 是概率性生成。你信任编译器,是因为同一份源代码编译一万次,产物一模一样;AI 生成的代码,可能每次都不一样。
这里还有一层,常被"编译器类比"糊弄过去:编译器生成代码,和 AI 生成代码,根本不是一回事。编译器编译完,源代码留着、目标代码扔掉,下次要用再编译一次就行——同一份源代码编译多少次,产物都一样,所以"不保存目标代码"是安全的。AI 生成代码则是:spec 要留,生成出来的代码也得留。因为下次从同一份 spec 再生成一遍,既不保证一致,也不保证正确。换句话说,编译器把不确定性压死在编译那一刻,之后永远可复现;AI 把不确定性摊在每一次生成上。马斯克想让 AI 顶替编译器,恰恰是没分清这个差别。
把马斯克的流水线画出来,问题一目了然:
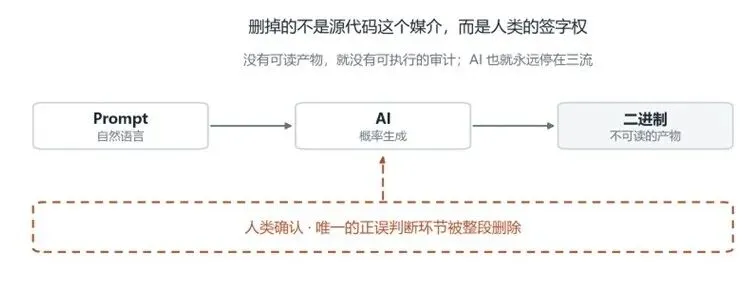
图10:被删掉的不是源代码这个媒介,而是人类的签字权
马斯克删掉的不是源代码这个媒介,而是人类的签字权。他把唯一能判断正误的那一环从流水线里拿掉了——按第七节的分档,AI 就永远停在三流。源代码的形式可以变化,但审计的位置不能消失。
9
四十八年前的提醒:别迷信自然语言编程
这场争论其实四十多年前就有过一次预演。Dijkstra 在 1978 年的手稿EWD667,标题就叫《论"自然语言编程"的愚蠢》(On the foolishness of "natural language programming")。他的核心论点放到今天的 Text2SQL 上几乎逐字成立:
形式文本的好处:合法操作只需满足少数简单规则,就能把大量胡话挡在外面;
自然语言的"自然",恰恰让人可以轻松说出"胡话不明显的话"——这句话用来形容"跑得通、看起来合理、做的不是你想的事"的 SQL,再准确不过;
窄接口主张:跨语言协作本身会增加两边的成本,接口越窄越好。
落到 Text2SQL 的边界上就是:自然语言不能承担精确语义。 这不是模型能力问题,是自然语言这个介质的问题。人话入口可以留——用来采集需求、表达业务直觉;但精确语义必须形式化——DSL、规则、编译器负责可确认与可复现;判断权回到人手里——人读得懂,才敢把结果用于决策。原型和一次性脚本可以自由对话;一旦涉及项目特有的口径,就必须把判断权放在人能确认的形式层上。
10
一把判断尺:什么不会被模型内化
前面回答的是"怎么做",这里回答一个现实问题:这类方案的价值,会不会随着模型变强而被"内化"掉——下一代模型是不是就把这些问题自己解决了?
先给一把判断尺:
危险区:会被内化 | 安全区:不会被内化 |
价值 = 让 AI 少做一点 | 价值 = 让人好审一点 |
拼"能不能生成出来" | 拼"生成出来人能不能确认" |
产物只给机器看 | 产物同时给人看 |
一次性的、黑盒的 | 可复现的、可追溯的 |
站在模型能力这边的,迟早被内化;站在人类审计这边的,不会。不会被内化的,是"给 AI 一个能落地、能被人审计的形态"这件事本身。
用这把尺子再来量一量报表工具这个例子。复杂报表一直是 AI 的重灾区,那里有两道坎:第一道坎是写不出来——多源取数混算、嵌套业务逻辑、像素级排版互相交织,私有模板格式缺少公开语料,一段线性自然语言根本说不清楚;第二道坎是人看不懂——就算硬写出来渲染代码,动不动上万行,人也很难确认结果对不对,这和前面讲的审计能力问题是同一件事。
润乾报表的绕法是:需求用白话进入,AI 读润乾报表的 API 文档、生成调用程序执行后生成报表模板,最后在报表 IDE 里由人可视化查看审核。AI 驾驭 Java 已经足够成熟,丰富的 API 和配套文档绕开了私有格式缺少语料的问题;产物是报表工具认识的模板,而不是几万行渲染代码,所以人看得懂、兜得住底。闭环里也放了三步自动验证:生成测试集、计算报表与分页、渲染 HTML 出外部真值信号。但实测里的两个翻车案例很说明问题:分组报表第一列缺边框,需要手动合并单元格、设置左主格;大屏的"中间留白"被 AI理解成了真的白色色块。自动信号不够保证收敛,人类兜底仍然是最后一道。
这个例子和前面的 SQLazy、NLQ 看似不同,做的事情是同一件:给 AI 一个能落地、能被人审计的形态。
11
性能优化的例子:
为什么用SPL,AI为什么替代不了它
性能优化的例子:为什么用 SPL,AI 为什么替代不了它
性能优化这件事值得单独拿出一节,因为它牵出一个更根本的问题:既然 AI 已经这么能干,为什么还需要一门新的程序语言?换句话说,AI 为什么替代不了做性能优化的 SPL?这个问题不必从理论讲起,先看一次刚做完的实测。
一个跨银行数据一致性校验的POC:20 道校验题,账户表 5.25 亿行,关联流水 1.5 亿行。这里要特别说明一句——跑在 SPL 这一侧的脚本,九成代码是 AI 写的。对比的双方是 3 节点 288 核 1.8T 内存的 MPP 集群跑 SQL,和一台 16 核 64G 的单机虚拟机跑 AI 写的SPL 脚本:
MPP(跑 SQL) | SPL(AI 写) | |
硬件 | 3 节点 / 288 核 / 1.8T 内存 / SSD | 单台虚拟机 / 16 核 / 64G 内存 |
20 道校验总耗时 | 17,450 秒(4.8 小时) | 624 秒(10 分钟) |
其中一道分组校验 | 76 分钟 | 6 分钟 |
一道复杂校验 | 144 分钟 | 57 秒 |
1.5 亿行跨行反向匹配 | 154 秒 | 47 秒 |
(说明:这是该 POC 项目在"大表分组与关联"场景下的实测,不是通用基准,数字不能外推。)
硬件差了几十倍,集群换成了单机虚拟机,结果反过来:20 道校验 SQL 跑 4.8 小时,AI 写的 SPL 只要 10 分钟;其中一道复杂校验从 144 分钟压到 57 秒。两端都是人在提需求、在确认结果,差别只可能出在中间那一段——代码被写成了什么样。于是问题变成:同样是 AI 写代码,为什么换成 SQL 就写不出这个效果?
瓶颈往往不在算力,而在算法和数据组织方式。SQL 里没有"物理有序存储"这个概念,AI 再强,写出来的 GROUP BY 也只能走哈希 shuffle;Java 理论上什么都能写,代价是游标、外存、内存全要自己管;pandas 一上来全读内存,1.5 亿行直接卡住。而 SPL 把这些能力做成语言原语之后,AI 才"够得着"高性能的写法——同一句需求,它可以落成"有序存储 + 外存游标 + 组表",而不是被逼着走哈希。一门语言给不给这些原语,决定了 AI 写出来的代码能有多好。
把主流语言放到"有没有这些原语"这把尺子上量一量,差别一目了然:
语言 | 现状 |
SQL | 没有物理有序存储的概念;GROUP BY 一律哈希 shuffle |
Java | 理论上都能写,但游标、外存、内存全得自己管 |
Python | pandas 一上来全读内存,1.5 亿行直接卡住 |
SPL | 把有序存储、外存游标、组表、外键序号化内化成了语言原语 |
但这里还有一层账要算清楚:AI究竟学到了 SPL 的哪一层?同一门语言,有的部分它已经会了,有的迟早会,有的一辈子学不会。答案藏在一个分层里:
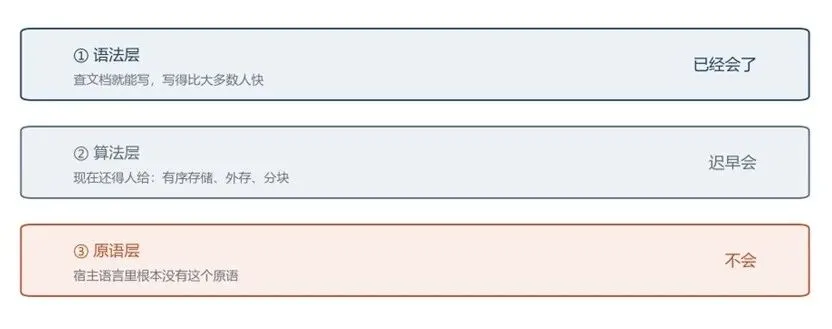
图11:语法层已经会,算法层迟早会,原语层不会
① 语法层:已经会了。 查文档就能写,写得比大多数人快——不只是 SPL,换一门语言的语法它也没问题;
② 算法层:迟早会。 有序存储、小表装内存、外存分块——这些提效直觉属于know-how,训练语料多了自然会;在那之前,人还得看它写出来的实现代码;
③ 原语层:不会。 宿主语言里根本没有这个原语,模型再聪明也无法凭空调用一个不存在的东西;而"创造一套原语",本质上就是再造一套语言。
分层的意义在于时间尺度:前两层会随模型变强而被内化,第三层不会。语法层今天就已经交出去了,算法层迟早也要交出去,剩下的只有原语层——它不会自己冒出来,只能由人设计进语言里。原语层不会被内化,这就是 AI 不会替代 SPL 的原因;反过来也是 AI 需要 SPL 的原因:它是 AI想做的事能落地的形态。
AI 在这次POC中犯的错也很具体:字段顺序和组表定义不一致,全错位也不检查;该存 int 的存成 string,后面比大小直接报错;JVM 默认 1G 堆,跑 16G 组表直接 OOM;CSV 的 NULL 是 \N,被当成字符串存了进去;最严重的一次,它自作主张把 LEFT JOIN 改成了 INNER JOIN,数据无声无息地少了 30%。人盯的不是语法——语法它自己能查文档;人盯的是算法对不对、语义有没有被悄悄改掉。 而人能对结果定位的前提,仍然是老三样:脚本分步,每一步都能出中间结果。
总结这次 POC:九成代码是 AI 写的,人只负责提需求、定算法、对结果。它说明的不是 AI 有多强,而是"原语 + 分步 + 可核对"这套组合有多管用——原语让它写得出来,分步和中间结果让人看得住。换一门没有这些原语的语言,同样的 AI、同样的人,交出来的就是一堆跑得慢的SQL或者看不出错在哪的 Java。
12
三句话带走
如果把整篇文章压缩成三句话:
AI 缺的不是智力,是判断。 它是一个不会定位、但会修的"非对称三流程序员";产出能力一流,判断能力三流,而且没有停止信号。
正误信号必须来自外部。 自我审查实证无效,换模型审只是部分独立;判据必须放在 Agent 修改权限之外——编译器、类型系统、形式化构件才是可靠的位置。
降低审计成本,就是降低 AI 落地成本。 过去工具比的是"谁让人写得少",AI 时代比的是"谁让人审得快"。
回到贯穿全文的那条流水线:口语 → LLM 翻译 → 人能读懂的规范表示 → 人类确认→ 确定性编译 → SQL。
AI 只做翻译,人来确认,剩下的交给确定性的机器。AI 写的 SQL 什么时候才敢用?——人读得懂的时候,就敢用。