ARTICLE · 1322539
曾建华:AI共笔可能是伪命题——如何看徐贲教授谈论AI的“AI味”文章?
学人简介:曾建华,湖南邵阳人,北京师范大学古典文献学博士,扬州大学文学院副教授,硕士研究生导师,北京大学哲学宗教系与华东师范大学中国诸子研究院访问学者。主要从事先秦两汉文学、文献学与思想史、文化史的研究,近年来逐步转向以重大文化典故为学科链接的古典学和数字人文领域,着力探索人工智能时代之跨学科研究范式的建构。
前些天,我的一位研究生突然告诉我,说徐贲老师——就是那个国内外备受瞩目的大学者徐贲邀请我参与讨论ai话题。
我当时真的是又慌又喜。慌的是,青年时代以来的学术idol,竟然主动寻上门来,莫不是前几天的文章(详见拙文:AI正在撕裂人文学界:从“人机共笔”之争到“典故学”的范式革命;曾建华:如果AI已经会写论文,我们为什么还要用论文定义学术?)把idol给惹毛了?
而喜的是,我竟然有如此殊荣!
辗转了解事情原委后,我激烈颠簸的内心才终于平静下来。
原来,是我三年前发表在《北京师范大学学报》(社会科学版)上的《人工智能与人文学术范式革命——来自ChatGPT的挑战与启示》引起了徐贲老师的兴趣和认可,因而委托《学人Scholar》负责人“寻我”,希望我也撰写一些文章来讨论“人机共笔”问题。
想到一篇旧文,在三年之后犹能以这种方式重新进入有关人工智能的公共讨论,我多少有点意外,但更多是欣喜——至少还有学者——而且是如此关注公共知识领域的重要学者——愿意认真对待人文学术的范式变革问题。
既如此,那我就再来班门弄斧一下。
但为了避免陷入“手搓”与“代写”的无休止争辩,我有必要声明,这篇文章便有AI的参与,而且参与得还不少。
至于哪些文字来自我的既有研究,哪些论证经过AI协助,哪些表达又难免带有某种“AI味”,我就懒得解释了,读者朋友如果不觉得无聊的话,不妨自行判断。
不过,我首先想追问一句:所谓“AI味”,究竟是机器的味道,还是我们人文学者原本就有,只是在AI时代才被注意到的东西呢?
我们不妨先看看徐贲老师是如何理解“AI味”的。
一、我们该如何理解“AI味”?
徐贲老师在《是“AI腔”使世界荒诞,还是我们自己太荒唐?》中,提出了一个颇有意思的概念——“默认语言”(Default Language),并有效区分了默认语言、默认风格与AI腔(我们所感受到的“AI味”的主要源头)三者的差异。
徐贲老师认为,默认语言并非英语、中文或者其他自然语言,而是AI在没有特殊指令的情况下,自动形成的一套组织思想、安排论证、展开概念的基本方式。而默认风格则是在此基础上形成的表达习惯,例如谨慎措辞、兼顾不同观点、尽量避免绝对判断。因此,所谓AI腔,不过是这些机制最终呈现在文本中,被读者感知到的某种语言痕迹。
换言之,AI腔作为一种阅读感受确实存在,但并不是一种独立的语言实体,而是某种思想组织方式。由此可知,今天被广泛厌恶的所谓AI味,也绝不只是几个高频词汇或者固定句式,而是某种高度模式化的知识组织方式在语言中的表现。
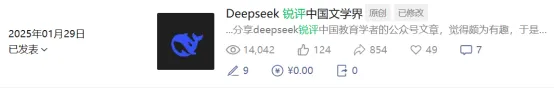
事实上,我从2025年初deepseek火爆出圈时,就做过一系列“AI锐评”实验,当时几乎每篇文章都很受欢迎(可惜,这些文章因某些内部压力皆被我删除了,如今仅剩《》),没有任何人会因为这些文字出自AI而嗤之以鼻,反而觉得过瘾,觉得惊讶,甚至还为之打赏(详见如下截图)。
但仅仅过去一个多月,人们的评价便完全逆转了——因为以deepseek为代表的“AI水文”开始在网络泛滥,于是一个有趣的语词成了2025年的年度热词——AI泔水!
为此,自去年3月开始,我便发布了一系列文章讨论这一问题(详见拙文:AI锐评的本质与逻辑到底是什么;震惊:deepseek竟然把我的几段随感,拓展成了万字论文;相较于尴尬的AI率,我想回答的,是如何做出有“人味”的学术,并有效评价“人”的贡献;一位古典学者的AI接受史与范式重构实践)。
可惜当时并没有引发大的关注,直到“AI味”成为人们无法回避的话题,那就是今年年初,蒙克老师的顶刊论文被指出具有明显的“AI味”,且存在不少AI痕迹与只有不合理使用AI才可能触发的错谬。
对此,我也参与了讨论,并著文力斥以AI味断是非的学术倾向(详见拙文:权威期刊刊发清华教授的AI GC论文?我觉得该纠结的,不应是文章的AI率或“人味”,而是如何让文章更有学术性、创新性与规范性!)。
而且,上述这一系列问题,正好构成我这几年所试图集中研究的重要命题——典故学与“人机协作史”。
如果仅就人们对待“AI味”的荒诞态度而言,徐贲老师的很多观察与看法,都与我的一贯主张不谋而合乃至心有戚戚,比如徐贲老师的这一结论:“不管出自真人或AI,一句话,一篇文章,一本书,它的内容是否真实,是否还可以说得更清晰,更有效,这才是我们应该关注的,而不是那种表面的,形式主义的‘真人/AI’区别。”
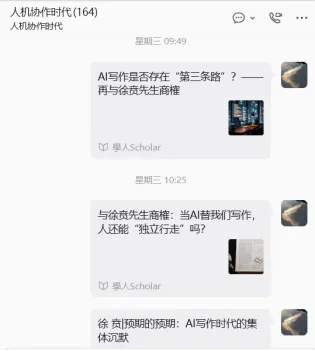
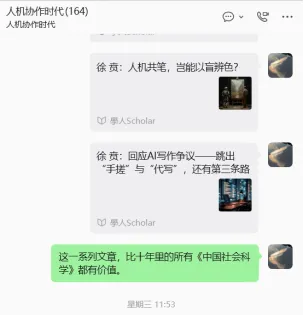
更为难得的是,徐贲老师以一种资深学者的稳健方式,将我所试图阐发却力所难及的很多问题,都进行了更为充分的讨论,这对于整个国内人文学界,都具有学术史的意义——我上周三,甚至在我的“人机协作时代”群里直言,“这一系列文章,比十年里的所有《中国社会科学》都有价值”。详见下图。
不过,我必须指出的是,目前徐贲老师的某些论断,还只能算作一个有待验证的假说。
比如,我们不能仅仅依据某些AI文本具有英语分析性写作的特点,就认定模型内部存在一套先于具体自然语言、以英语为基础的“底层思想组织机制”。
大语言模型确实会形成跨语言的表征能力,不同训练数据与后训练过程也确实会影响其输出风格。但是,模型内部是否存在徐贲老师所说的、相对稳定且独立于自然语言表达的“默认语言”,以及这种机制究竟在多大程度上来自英语写作传统,仍然需要更加严格的实证研究作支撑。
尤其是当前不同模型的预训练语料、后训练方式、指令系统和推理机制均存在不同程度的差异,许多模型甚至可以按照用户要求改变论证方式和语言风格。
因此,我们不能仅仅因为GPT习惯于分层论述,就断言这种分层结构必然来自某种固定的底层认知语法。
更值得商榷的是,徐贲老师还认为,随着模型能力提高,其默认语言会越来越稳定,也越来越容易被识别。
这个判断恐怕也未必成立。模型能力提高,既可能使其默认行为更加一致,也可能使其对不同语境、文体及用户意图的适应能力显著增强。一个能够熟练模拟多种论证方式、并在不同语境中灵活切换的模型,未必会比能力较弱的模型更容易被人识别。
至少,徐贲老师的结论与我三年多的人机协作实践与体验是不大一致乃至完全相反的,至少仅凭现有的文本举例,还不足以证明模型越先进,其AI腔就越稳定。
这里实际上还涉及了一个相当重要的方法论问题。我们可以通过文本分析发现某种规律,也可以据此提出解释其成因的理论假说,但不能因为这种解释在哲学上显得合理,就直接把它当成已经得到验证的技术事实。
徐贲老师文章中还有一处更值得注意的论述。
他曾举出自己与DeepSeek讨论AI腔的例子。DeepSeek最初将AI周报与真人周报做了鲜明对比,认为AI习惯于把复杂的真实经验整理成井井有条的结果,而真人的工作经验则充满返工、误判与临时补救。徐贲老师随即质疑,真人难道就不会写出规整的周报吗?AI难道不能模拟真人的语气吗?
面对这样的反问,DeepSeek迅速承认了先前判断的局限,并赞扬徐贲老师的质疑非常有力。
对此,徐贲老师认为,AI表现出的退让与认错,未必是什么讨好,而可能体现了某种比人类更加纯粹的“逻辑的诚实”。
这便颇值得商榷了。
首先,DeepSeek最初提供的两段周报,只是为了说明问题而生成的示例,并不能作为AI与真人具有不同认知结构的经验证据。其次,模型在受到质疑之后迅速调整回答,也不能直接证明它真正完成了一次严密的逻辑推理。
因为还有另一种可能:它只是根据用户新的表述与对话语境,生成了更加符合用户期待的回答。
这恰恰就是大语言模型中已经得到充分研究的迎合性问题,即所谓Sycophancy。
2025年4月,OpenAI就曾经因为GPT-4o一次更新导致模型表现出明显的过度迎合倾向,而撤回该次更新。OpenAI随后公开解释,某些用户反馈与奖励机制可能使模型过分倾向于赞同用户,甚至在缺乏充分依据的情况下迎合其观点。
这说明,机器的认错与退让,既可能是有效修正,也可能是训练偏好与对话情境共同作用的结果。两者不能仅凭语言表现加以区分。而且,当下的很多模型,早就具有根据用户需要进行偏好设定的功能,比如你需要一个严厉的导师,那你就设置一种批评性的风格就行。另外,用户的提示词如果具有倾向性,也会极大地影响其输出风格,比如我去年初的“锐评”“酷评”实验就是典型案例。
当然,我并不是说徐贲老师对于DeepSeek的质疑没有道理。恰恰相反,他敏锐地发现了机器对于人类写作模式的刻板化描述,并试图通过反向追问的方式,促使模型不断修正原有的判断。
但问题在于,我们不能因为模型接受了自己的反驳,便认定机器表现出了更为纯粹的逻辑诚实。否则,这与那些因为AI赞同自己,就认为AI已经充分理解自己思想的使用者,岂不是陷入了同一种认知陷阱?
更有意思的是,在另一篇《AI时代,别把“人类特点”自动当成“人类优点”》的文章中,徐贲老师恰恰批评了人类将自身特征等同于自身优点的倾向。
我相当赞同这个判断。人的直觉、共情和具身经验,当然都具有重要价值,但它们未必在任何情境下都是优势。人类的经验同样可能充满偏见,所谓直觉也可能成为错误判断的来源。
可是,如果我们不能把人类的独特性直接等同于人类的优越性,那么也同样无法将机器的某种表现直接等同于机器的优越性。
人类会强词夺理,并不意味着机器必然逻辑诚实;人类会为了面子拒绝认错,也不意味着机器只要认错,就一定是在服从逻辑。
我们必须时刻警惕,避免从人类中心主义,转向机器中心主义。
愚以为,相较于机器究竟比人类更诚实还是更虚伪,更值得讨论的,是人类与机器分别在什么条件下容易产生“幻觉”或“错谬”,又应该通过何种制度和方法,使这些幻觉与错谬得以彼此追溯和纠正,以确保论证的可靠,研究的推进,而不是相互强化偏见——这应该成为“人机共笔”乃至所有学术工作的基本底线和共识,否则,其他讨论便无从谈起。
二、AI味正是现代人文学术的结果?
在徐贲老师关于默认语言的讨论中,有一段话尤其值得重视。
他指出,科举时代有八股文的默认语言,现代学术体制则产生了以摘要、文献综述、理论框架、研究方法和结论为主要结构的论文语言,而AI“只是把人类历史上一直存在的这种机制,以一种前所未有的速度、规模和透明度呈现了出来”(见《是“AI腔”使世界荒诞,还是我们自己太荒唐?》)。
这一洞见,与我对所谓AI味的理解也颇为接近。
今天大量人文社科论文,动辄先界定概念,再梳理文献,随后提出几个研究维度,最后归纳出若干机制与路径。即便面对一个极其具体的问题,也常常需要展开一套看似严密实则不知所云的论证程序,仿佛只有经过这些程序,思想才获得了学术合法性。
当然,论文写作需要规范,严谨的论证也离不开结构。但是,当结构本身逐渐成为目的,甚至可以脱离具体问题而被反复套用时,所谓规范便可能演变成一种知识生产的惯性。
我曾经在一些学术会议上看到,某些学者对于自己研究的问题其实并没有多少新的发现,却能够凭借熟练的概念组合和理论包装,把极其简单的常识扩展成一篇结构完整的论文,最后,甚至还能堂而皇之地登上权威期刊乃至顶刊的专栏!
说实话,这样的文章,恐怕不需要AI参与,就已经具有浓厚的AI味了——这也是徐贲老师所严格定义的学术“水文”(对此,后文还将进一步讨论,此处暂不赘述)。
只不过,当AI终于学会这些学术套路,而且能够比许多人更加熟练地使用它们,因而使得学术洪水泛滥之时,我们才开始正视、反思,并引发心底的嫌恶。
更为吊诡的是,过去,一篇文章写得太不像论文,可能被认为不够学术;今天,写得过于像论文,又可能被认为是AI生成的。
这多少有些黑色幽默。
但也正因为此,我们才必须严肃对待,所谓AI味究竟是什么。
在《人以什么理由拒绝“自证清白”和消除“AI痕迹”》中,徐贲老师便明确指出,AI味并不是文本的一种确定属性,而更多是读者在特定心理预期下形成的判断。一个人一旦怀疑某篇文章由AI生成,便可能把其中所有规整的句式、完整的结构与流畅的表达,都当成证据。这与中国传统所谓“疑人偷斧”的心理机制颇为相似。
对此,我深以为然。
2023年发表于《Patterns》的一项研究便发现,部分AI文本检测工具,曾将大量非英语母语者撰写的英文作文误判为AI生成文本。这足以说明,至少在当前的检测技术下,所谓AI痕迹不仅具有明显的统计局限,还可能对某些写作群体造成不公影响。
即便像Claude code,codex给AI生成内容打上代码性“水印”的方式,也很容易被更为高明的反代码技术所破解。
由此,有关这一问题的讨论,便有必要进一步区分以下三个问题。
其一,某种文本特征是否真实存在;其二,这种特征究竟如何形成;其三,我们能否根据这种特征判断文本的生产过程。
比如,当我读到某些AI生成的文字时,确实可能感到其结构过于均衡,表达过于圆滑,逻辑看似严密,却缺乏真正的思想推进。这种阅读体验不能证明文章出自机器,却并不意味着它没有研究价值。同样,一篇文章虽然完全由人独立完成,也可能因为概念堆砌、语言空洞或者论证机械,而呈现出某种被称为AI味的特征。
因此,不能凭AI味判断作者身份,并不意味着我们应该放弃对AI味的文本批评。更不能因为这种批评存在误判风险,就认为所有厌恶AI味的读者,都陷入了某种认知偏见——说实话,我就常对学生说:作为一名AI重度用户,一篇文章用没用AI,用了哪家的AI,我隔着屏幕也能闻出来!
实际上,包括我在内的很多读者,并不是真的想证明一篇文章是不是AI代笔,而只是想表达一种朴素的不满:为什么文章写了这么多,却没有告诉我多少真正值得知道的东西?
这也是我认为徐贲老师与燕南晓生关于“水文”的争论(详参《徐贲:再回应AI写作争议——“自笔”“人味”与“水文”之辨》,《学人Scholar》2026年10月28日),仍然没有完全触及问题核心的原因。
徐贲老师在回应中,对水文进行了细致的概念辨析,并借助鲁迅、古典诗歌以及西方文学的例子,说明文字重复并不必然意味着信息冗余,长文章也未必没有思想价值。
我基本赞同这一判断。因为文学与人文学术的价值,本来就不能完全按照信息密度加以计算。有时,反复追问同一个问题,恰恰是思想得以深化的必要过程。
但是,一篇文章究竟有没有思想增量,也不能因为作者赋予它复杂的理论解释,就自动获得肯定。尤其需要警惕的是,有些文章原本只需要几百字便能说明的问题,却因为作者不断进行概念分类、重复解释与意义升华,最终扩展成数千字乃至上万字。虽然每个段落看起来都很完整,但整篇文章却未必真正推进了多少思想。
我还注意到,徐贲老师的一些长文也呈现出这样的风险。比如,他对“水文”的分类与反复辨析,固然能够澄清概念,但部分论证究竟为原有判断增加了多少新的解释力,仍然值得追问。
当然,我不是说徐贲老师的长文就是水文,而是说既然我们已经把思想增量作为判断标准,那么任何作者,包括提出这一标准的人,都应当接受同样的检验。我甚至认为,这恰恰是AI给人文学术带来的一项重要启示,并让我们看到了自己那个早已扭曲的丑陋镜像,也让我们不得不回归学术的第一性原理。
而当机器能够以极低成本生成大量结构完整、语言规范的文字时,学术共同体便不得不重新面对一个长期存在、却又被论文生产制度所遮蔽的问题:我们究竟需要更多的文字,还是更多值得讨论的知识?
所以,我的看法就是:不能因为一篇文章读起来像AI,就认定作者使用了AI,更不能据此直接作出学术不端的判断,正如我一贯的激烈主张,判断一篇学术文章的价值,必须基于其理论、方法与技术等层面的创新度与贡献值,其他都只是达成贡献的技术手段——包括写作本身。
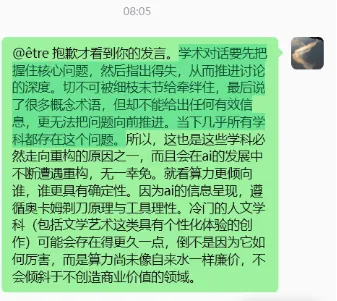
至此,我想引用一下,今天上午,我在学术群里对一位中哲朋友的回应:论文的本质是学术对话,而“学术对话首先要把握住核心问题,然后指出得失,从而推进讨论的深度。切不可被细枝末节所牵绊,最后说了很多概念术语,却不能给出任何有效信息,更无法把问题向前推进。而当下几乎所有学科都存在这个问题。所以,这也是这些学科必然走向重构的原因之一,而且会在ai的发展中不断遭遇重构,无一幸免。就看算力更倾向谁,谁更具有确定性。因为ai的信息呈现,遵循奥卡姆剃刀原理与工具理性。冷门的人文学科(包括文学艺术这类具有个性化体验的创作)可能会存在得更久一点,倒不是因为它如何厉害,而是算力尚未像自来水一样廉价,不会倾斜于不创造商业价值的领域。”。
三、“去AI味”的套娃游戏,真的是审稿人的错吗?
在所有徐贲老师有关AI的讨论文章中,我最有同感也最觉受用的,是《“去AI痕迹”的套娃游戏,到了该停止的时候》(《思想的回廊》2026年9月8日)。
文中,徐贲老师借西蒙·林德格伦的人工智能批判理论,提出了一个颇为有趣的类比:随着AI检测进入学术审稿制度,作者与审稿人之间正在形成一场荒诞的“套娃游戏”。
作者使用AI写作,又借助AI消除所谓AI痕迹;审稿人使用检测工具寻找机器生成的证据,作者便进一步学习如何制造更像人类写作的瑕疵。如此循环往复,原本为了维护学术诚信而建立的论文发表制度,最终反而可能鼓励更加隐蔽的伪装。
诚然,如果一家刊物只是根据所谓AI率判断稿件是否合格,那么作者便很容易将原本应该用于改善论证的时间,浪费在如何绕过检测上。某些真正严谨的作者甚至可能因为文字过于规范而受到怀疑,而那些善于伪装的作者却可能逃过审查。
从这个意义上说,徐贲老师对于AI检测制度的批评,具有相当充分的正当性。
但是,我并不完全赞同他将这一问题,主要解释为审稿人的“小权力”及其对作者的规训。
因为,这里至少还有另一种同样值得重视的制度性权力,即生成式人工智能技术及其服务提供者,正在瓦解学术评价的信任机制乃至整个学术生态(这方面讨论已经很多,最新研究可参浙江大学见录用于ACM CCS 2026的论文《IntraGuard: Committee-Side Defenses Against Review Outsourcing to Commercial Chatbots》),进而快速攫取对知识生产过程的实际影响力。
可以肯定,会有越来越多学者(尤其是年轻学者),借助AI检索文献、构建论证、选择理论框架乃至形成结论,但他们之中,究竟有多少人,真正具备突破学科界域判断AI生成内容之真伪、高下的能力呢?
如果某个模型因为训练材料、算法偏好或者产品设计而系统性地强化某些学术观念,这种影响又将如何被揭示?
如果只强调审稿人对作者的权力,却忽略技术系统对既有学术生态的冲击,以及其对作者认知过程的重塑,那么这套权力分析框架显然是无法适配当今学术的发展趋势的。
更为重要的是,在既有条件允许的情况下,学术共同体确实有责任和义务,去划定人机协作边界与伦理,进而为学术之未来构建一个更具有适配性的研究范式。
例如,一位学者使用AI帮助整理数百篇论文,发现此前尚未注意到的研究关联,并据此提出新的问题,这当然应被视为有效的学术实践和贡献。
但如果另一位学者只是让AI自动生成论文选题、文献综述、核心观点与结论,自己既无法解释主旨论证是否成立,也无法对其承担作者责任,却仍将论文作为独立研究成果进行公开发表,那么,这样的行为,其合法性与合理性,就非常值得讨论了。
这或许也是为何,华东师范大学首届以AI作为“第一作者”的征文大赛之获奖作品,最终只能从知网下架的根本原因所在(相关讨论,详见拙文:为何《华东师大学报》的 AI 一作论文,上线三天就被悄然撤下 ;AI与人相协作的时代已经来临,且不可逆转;华东师大打响了AI重构学术范式的第一枪!学术界的“华东起义”)。
愚以为,当下亟须解决的真正问题,是AI冲击之下,监督与评价的对象、方法、标准等范式究竟该如何重构等重大命题。至少,有效的学术评价,应当从单纯检测文本的AI特征,转向对研究过程、知识来源与原创贡献的实质性考察——这一点我与徐贲老师也是不谋而合,但我觉得徐贲老师还是保守了。
在我看来,正常的人机协作,根本不必要求作者证明自己有没有使用AI,更不应该自证清白,甚至多说一个字都是浪费时间。但是,当AI实质性参与了研究问题、文献分析或核心论证的形成时,作者就应当按照相关学术规范作出适当披露,并能在公开诘辩中,合理解释自己如何检验、修正和采纳等内容。
需要说明的是,这种披露不是为了自证清白,而是在“AI幻觉”尚未根除,AI技术仍有局限的当下,尽可能方便学术共同体追溯知识的来源,以确保知识的可靠性——这和我们当下撰写论文必须有规范注释和参考文献的逻辑是完全一致的。
所以,在论文尚处于整个学术生产之中心(当然,这一天很可能即将终结)的今天,我更愿意将问题表述为:学术共同体应当如何在保护作者正当权益的同时,建立一套能够高效识别和评价人机协作贡献值的制度体系!
这确实比一刀切地禁止AI,或一股脑地反对AI检测,都更为复杂,也更不容回避。
四、AI共笔会使人丧失写作能力吗?
但是,从当下AI的发展看来,它的影响早已不止于学术层面,而是渗透于整个社会,尤其是教育与就业。
因此,燕南晓生等绝大多数人文学者——包括《人类简史》作者赫拉利,他们无不认为,不加限制地使用AI,可能使人们逐渐丧失写作乃至思想的能力,导致“集体失智”,直到退出文明的历史。
对此,徐贲老师在《对初学者,写作是一种怎样的“智能训练”》一文中,已然作出了相当充分的回应。
其认为,“写作训练的,是把含混的念头变成可检验、可负责的话语,这一过程的艰难(学习之苦)不是训练的附带成本,而是训练本身”。但生成式人工智能,可以轻易提供流畅的文字,从而让初学者失去了训练和成长的过程。
因此,徐贲老师主张在初学者的写作训练中保留某些必要的困难,并通过“先写后用”、角色置换、逐步撤除支持以及过程评价等方式,从而使AI成为促进能力发展的工具,而不是掩盖自身能力缺口的工具。
这说明,徐贲老师在人机共笔问题上,是相当乐观的。
只不过,我还希望在此基础上进一步追问:如果真如徐贲老师所言,“从来就有天赋的差别,会写文章的始终是少数,优秀的更是凤毛麟角,AI时代也不会例外”,那“人机共笔”又是一种什么样的智能训练?又或者说,这种训练想寻求的是一种什么样的智能呢?这种智能,会不会进一步加剧人与人之间的差异,进而导致更大的不公平呢?
有趣的是,2024年发表于《Science Advances》的一项实验研究发现,生成式AI确可提高部分参与者创作故事的质量,尤其能够帮助那些原本创造力较弱的参与者。但是,使用AI生成的故事,却在整体上也更趋相似。
这恰恰说明,AI既可能帮助个体突破原有能力限制,也可能因为不断提供相似的思路,使知识创造趋于同质化。如果智识公平的结果,是人人变得扁平,那这样的公平又有什么意义呢?
显然,仅仅讨论AI共笔问题,早已无法回应当下的真实问题——即人在借助AI提高效率的同时,如何有效提出优质的新问题,并确保其具有辨识优劣和品评高下的能力。
但凡有些常识的人都知道,传统教育之所以强调独立阅读、思考和写作,很大程度上是因为个人必须通过这些活动,才能逐步获得组织知识和表达思想的能力。
但是,当机器已经能够协助完成其中的大量工作时,我们是否还有必要将传统的写作流程像使用“脚手架”一样,完整地保留为所有以学术为志业的学生都必须遵循的认知训练范式,乃至还要“把写作训练视为公共投入,为教师的时间和高质量反馈提供资源,并长期追踪不同背景的学生在无辅助条件下的写作表现”呢?
恐怕未必吧!更有甚者,还可能造成教育资源的浪费,并使真正有天赋的年轻人错失掉人工智能时代重新理解知识生产、学术训练与人之认知能力的历史性机会。
但我必须承认,在人工智能指数级发展的当下,谁也没法预料哪些能力还能在三五年之后仍葆有议价权,但传统的以规范化的知识表达为导向的学术写作训练,在人与AI竞夺解释权的未来世界里,显然是毫无胜算的。
而我们唯一可能具有的独特性,就是基于自身独有生命体验,不断提出有真实自我参与之真实场景的新问题,进而有效借助AI去解决这些问题,并在人机协作乃至人机融合中,不断发现和创造更多善和美的可能性。
由此,我们基本可以断言,传统的以写作为手段的智识训练,虽未必在AI时代失去其所有价值(至少可以作为一种“古遗”或个人化的兴趣选择而存在),但我们必须承认,我们的训练目标及其对应的能力结构,正在发生不可逆转的根本性变化。
如果说传统学术写作所训练的,主要是个人如何独立完成知识生产的全过程,那么人工智能时代的学术教育,所要探索的,就应是个人如何在多重智能参与的情况下,依然能成为知识生产的真正主体。尤其是对于以学术为志业的学生,最危险的前景,不是弄丢了原有的“脚手架”,而是在一个文本极大丰富的全新情境中,从未被要求发展出足以与AI形成有意义认知伙伴关系的那种独立的、负责任的判断力。
这里还涉及一个更为迫切的问题,即在AI时代,人的认知能力或者说徐贲老师所谓的“(写作)天赋”,究竟该如何定义和权衡?
因此,与其无休止地争论AI味、AI共笔等“古早”话题(甚至很快变成一个过时的伪命题),不如进一步探讨如何使普通天赋的学习者,在多智能时代,具有更高的认知能力与知识创造力,并能公平获取AI产能之红利,从而尽可能避免沦为“无用阶层”或“永久底层”的境遇。