ARTICLE · 1324954
最新课程!AI类器官+AI蛋白质设计与AI多肽抗菌肽设计与AI合成生物学!


01 AI蛋白质设计线上直播课
02 AI类器官线上直播课
03 AI多肽设计抗菌肽设计线上直播课
04 AI抗体设计线上直播课
05 AI合成生物学线上直播课
06 AIDD人工智能药物设计进阶
优惠1:报二送一(同时报名两个班赠送一个学习班,赠送班任选)
优惠2:提前报名缴费可享受300元优惠(仅限前15名)
优惠3:报名直播课程可赠送往期课程回放
(报名一个直播课可以赠送两个回放)
(报名三个直播课赠送下面全部课程回放)


一、熟悉超算环境与蛋白质从头设计实践


上下滑动查看更多


Day1:类器官技术基础、构建与 AI 技术融合
一、类器官技术发展与多场景应用全景
1.1 类器官定义与核心特征:三维培养、自组织、器官特异性结构与功能
1.2 从干细胞到类器官的发展脉络:多能干细胞、成体干细胞、肿瘤类器官
1.3 类器官在四大场景中的定位
1.4 新药研发:靶点发现、药物筛选、药效评价、毒性预测
1.5 精准医疗:患者来源类器官 (PDO) 指导个体化用药
1.6 再生医学:可移植功能单元、组织修复
1.7 疾病机制研究:遗传病、感染、肿瘤发生发展
1.8 类器官与传统模型的关系:细胞系、动物模型、器官芯片的边界与互补
1.9 关键数据库与资源:类器官样本库、HCA、公共类器官数据集
二、类器官构建核心技术与质控
2.1 干细胞诱导分化:多能干细胞定向分化、成体干细胞扩增
2.2 支架材料:Matrigel、水凝胶 (天然 / 合成)、微流控芯片
2.3 培养基优化:生长因子组合、小分子抑制剂、条件培养基
2.4 常见类器官类型构建要点:肝、肾、肠、肿瘤、脑、胰岛
2.5 患者来源类器官 (PDO) 的建立流程与样本处理
2.6 类器官质量控制与表征:形态学判读、标志物表达验证 (免疫荧光 /qPCR/ 流式)、功能验证 (CYP450/ TEER/MEA)、批次一致性与可重复性、成熟度评分卡
三、AI 与类器官的技术融合路径
3.1 类器官数据的采集与标准化
3.1.1 数据采集工具:高内涵成像 (HCI)、单细胞测序、微流控传感器
3.1.2 数据标准化挑战:批次效应、跨平台兼容性
3.1.3 数据完整性、可追溯性与合规要求 (为注册申报打基础)
3.2 AI 算法在类器官研究中的应用
3.2.1 计算机视觉:类器官形态学自动识别 (分割、计数、异常检测)
3.2.2 机器学习:药效 / 毒性分类模型 (随机森林、XGBoost)、回归模型 (剂量‑反应关系)
3.2.3 深度学习:卷积神经网络 (CNN) 处理类器官影像、图神经网络 (GNN) 整合多组学数据
3.2.4 基于 AI 的类器官药物敏感性预测
3.3 虚拟类器官与数字孪生技术
3.3.2 数字孪生:整合类器官实验数据与 AI 模型,构建动态预测系统
3.3.3 应用场景:药物筛选优先级排序、毒性预警
四、类器官数据合规与注册申报要点 (认知级)
4.1 类器官数据在 IND/NDA 申报中的使用现状
4.2 监管态度:FDA 现代化法案、NMPA 相关动态、动物替代趋势
4.3 数据完整性、可追溯性、标准化要求
4.4 合规风险点:批次效应、跨平台兼容性、数据可解释性
4.5 类器官数据支撑申报的典型场景与边界
Day 2:类器官在新药研发全链路中的实战应用
五、靶点发现、药物筛选与药效评价
5.1 类器官用于靶点验证:基因编辑 (CRISPR) 与类器官结合
5.2 高通量药物筛选的类器官模型选择:剂量‑反应设计、对照设置、Z 因子
5.3 药效评价实战:肿瘤类器官药敏测试 (PDX 替代,IC50/AUC/ 协同指数)、中药复方多成分协同作用分析、药效终点选择
5.4 肿瘤类器官高通量药敏筛选与化疗 / 靶向药响应评估
六、毒性预测与机制研究实战
6.1 毒性预测实战:肝类器官代谢毒性 (CYP450、DLI 预测)、肾类器官损伤标志物 (KIM‑1、NGAL)、心脏 / 肠类器官毒性评估要点
6.2 机制研究:AI 关联类器官基因表达与药物表型 (耐药相关通路挖掘、生物标志物发现) 毒性终点选择与数据解读
6.3 肝类器官 DILI 预测与药物肝毒性分级
七、类器官的高级构建与 AI 模型开发
7.1 类器官构建与表征的高级技术
7.1.1 复杂类器官构建:3D 生物打印 (定制化支架、肝小叶结构、多细胞共打印)、微流控芯片集成 (器官芯片联用、"肠‑肝轴" 共培养)、长期培养维持 (Wnt/Notch 信号通路优化、营养梯度设计)
7.1.2 高精度表征:空间多组学 (Visium 定位异质性)、功能动态监测 (MEA、Seahorse XF)、自动化质控 (AI 驱动成熟度评分卡)
7.2 AI 模型开发与优化关键技术
7.2.1 类器官数据 AI 预处理:影像数据增强 (旋转 / 裁剪 / 噪声注入、三维重建)、多组学数据对齐、缺失值填补 (GAN)
7.2.2 模型架构选择与优化:小样本场景 (迁移学习 esNet‑50 微调、元学习 MAML)、多任务学习 (联合预测药效 + 毒性)、可解释性 (Grad‑CAM、SHAP)
7.2.3 从 0 到 1 构建类器官药敏预测模型
八、类器官多模态数据整合与自动化
8.1 多模态数据整合与智能分析
8.1.1 多源数据融合策略:影像、组学、电生理、临床数据;GNN 构建 "类器官‑药物‑基因" 关联图谱、Transformer 跨模态注意力
8.1.2 智能分析场景:耐药机制挖掘 (动态影像 + 耐药基因时序)、复方药物协同效应 (浓度‑响应曲面建模)
8.2 自动化与高通量技术应用
8.2.1 硬件自动化:液体处理机器人 (96/384 孔板铺板、梯度稀释误差 < 2%)、自动化成像系统 (0pera Phenix 全孔扫描 + 实时分析)
8.2.2 AI 驱动流程优化:贝叶斯优化调整浓度 / 时间点、异常检测 (污染 / 死亡预警并触发干预)
8.3 基于公开数据集 (如 L1000) 构建简单药效预测模型,结果解读 (AUC / 准确率、模型边界)
Day3:类器官在精准医疗、再生医学与疾病机制研究中的应用
九、类器官在精准医疗中的应用
9.1 患者来源类器官 (PDO) 用于个体化用药指导
9.2 肿瘤类器官药敏与临床决策:临床验证路径、一致性评估
9.3 类器官生物样本库建设:样本采集、伦理、知情同意、存储
9.4 PDO 指导肿瘤患者用药的临床研究
十、类器官在再生医学中的应用
10.1 类器官作为可移植功能单元:肠、肝、胰岛类器官移植
10.2 组织修复与再生:类器官 + 支架材料 (水凝胶、脱细胞基质)
10.3 脱细胞羊膜 / 丝素水凝胶等生物材料与类器官结合
10.4 移植免疫与安全性考量:免疫原性、致瘤性、批次一致性
10.5 类器官移植修复动物模型
十一、类器官在疾病机制研究中的应用
11.1 遗传性疾病、感染性疾病、肿瘤发生发展机制
11.2 类器官与 CRISPR 基因编辑结合:疾病模型构建
11.3 表型分析与多组学整合:转录组、蛋白组、代谢组
11.4 生物标志物发现与靶点验证
11.5 类器官疾病模型解析致病机制
十二、类器官与器官芯片、多器官互作
12.1 器官芯片 (Organ‑on‑a‑Chip) 与类器官联用
12.2 多器官互作模型:"肠‑肝轴"" 肝‑肾轴 " 共培养
12.3 微流控与传感器集成:实时监测、灌流培养
12.4 在药物吸收、代谢、毒性中的联合应用
Day 4:高级技术、数据合规与转化路径
十三、复杂类器官构建与高级表征
13.1 3D 生物打印:定制化支架、多细胞共打印 (肝实质 + 胆管细胞)
13.2 空间多组学:空间转录组定位类器官功能区与异质性
13.3 功能动态监测:MEA 电生理、Seahorse 代谢流分析
13.4 自动化质控:AI 驱动的形态学 + 功能批量评估 (成熟度评分卡)
十四、类器官数据合规与注册申报实战
14.1 类器官数据用于 IND/NDA 申报的案例解析
14.2 数据标准化与批次效应处理:统计方法、对照设置
14.3 监管沟通要点:Pre‑IND 会议、数据包准备
14.4 FDA/NMPA 相关动态与趋势
14.5 类器官数据申报的合规边界与风险控制
十五、类器官技术转化与产业化路径
15.1 从实验室到产业化的关键节点:标准化、规模化、质控体系
15.2 类器官产品化形态:试剂盒、服务、平台、样本库
15.3 知识产权与商业模式
15.4 产学研医协作:药企 + 医院 + 高校 + 材料企业
15.5 类器官技术转化路径解析;企业平台搭建与团队协作的实际考量 (原模块 9 内容融入)
十六、前沿趋势与未来展望
16.1 生成式 AI 在类器官图像增强与数据合成中的应用 (科普级)
16.2 基础模型 (Foundation Model) 在类器官多组学中的探索
16.3 类器官与器官芯片的标准化趋势
16.4 多场景应用的融合前景:研发 — 临床 — 再生 — 机制


上下滑动查看更多


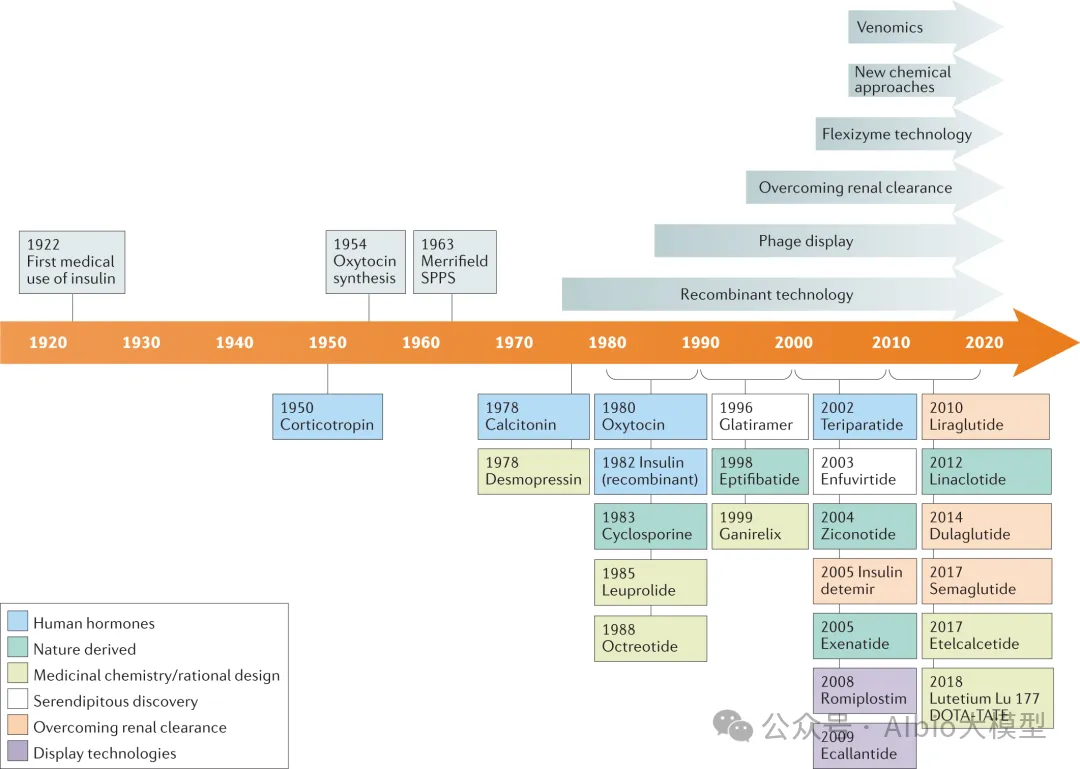


上下滑动查看更多


*涉及使用代码/计算工具的操作
第一天:代码基础,抗体基础,介绍各大药企在AI辅助抗体药物开发上的布局,复现GSK在抗体亲和力成熟上的工作
 1.代码基础知识讲解,环境搭建:Linux,VS code*
a)超算的登录
b)Linux系统的常用shell命令:vim, ls, cd, less, rm等;
c)一些package安装的常用命令:pip, conda, source等。
d)VS code的基本配置:连接服务器;选择不同python版本的Interpreter;debug模式的使用等。
2.抗体基础知识讲解:
a)VDJ重排,germline,CDR区域,表位(epitope/paratope),抗体亲和力成熟,抗体的可开发性等概念介绍
b)不同抗体编号方案(Kabat,Chothia,IMGT)讲解,使用python自动化对抗体序列编号,并识别CDR区域*
c)抗体药物开发的基本流程
3.各大药企在AI辅助抗体药物开发上的布局:讲解各大药企公司发表的文献及报告:
a)Genetech的lab-in-the-loop,结合了实验和计算方法的迭代优化策略的工作b)Genmab手动建立了多样性的抗体可开发性数据集,以进行可开发性数据的训练和预测.
c)GSK、阿斯利康、诺和诺德等在抗体亲和力成熟上做的工作等。
4.抗体结构预测
1)通用蛋白结构预测模型:AlphaFold3。
u运行网页server上的AlphaFold3预测结构,https://alphafoldserver.com*
uAlphaFold3输出结果分析,各项置信度指标的含义,以及如何判断预测的准确度,如pLDDT,ipTM,PTM,PAE。
uAlphaFold3的安装过程讲解。
a)抗体专用结构预测模型:ImmuneBuilder,IgFold。实操如何在服务器安装和使用。
5.复现GSK在抗体亲和力成熟上的工作*
第二天:基于大语言模型的抗体亲和力成熟。
1.基础知识讲解
1)介绍蛋白质的语言模型(26字母语言模型->20氨基酸字母表,上下文依赖->氨基酸的共进化)
2)为什么要开发蛋白质大语言模型?
1. 相比于结构或功能信息,序列信息更加海量;
2. 蛋白质序列通过进化而来,可以学习蛋白质基本规律,折叠,共进化等
3)模型架构和基础理论:transformer,多头注意力机制,Bert,GPT,T5等
2.基于Bert架构的蛋白质语言模型
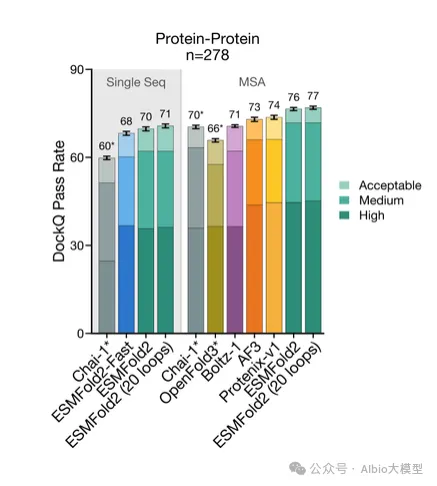
1)ESM系列(ESM-1b、ESM-1v、ESM2、ESM C)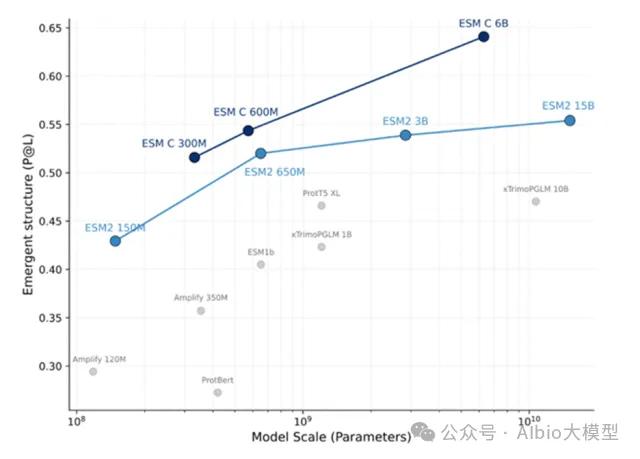 2)ESMFold:无需MSA信息的结构预测
3)多模态的蛋白质语言模型ESM3
4)使用抗体序列库训练的语言模型:Ablang,AntiBERTy
3.Adaptyv EGFR Binder比赛——设计靶向EGFR的更高亲和力binder。1)比赛结果展示
2)比赛排名靠前的抗体/蛋白是如何设计的
a)第一轮比赛,排名第一的方法:BindCraft
b)第二轮比赛,排名第一的方法:Cradle,在Cetuximab的基础上,用的LLM,突变了10个FR的氨基酸
c)第二轮比赛,排名第二的方法:对一个纳米抗体进行人源化改造
d)第二轮比赛,排名第三的方法:保留与结合重要的氨基酸,生成其它氨基酸RFdiffusion+inverse folding
4.零样本的抗体亲和力成熟*
1)Efficient evolution,基于序列的语言模型推荐突变点(Nat. Biotechnol.文章)
i.了解语言模型推荐突变点的原理;
ii.安装package和模型参数。https://github.com/brianhie/efficient-evolution
iii.运行以推荐突变点:python bin/recommend.py [sequence]
2)Structure evolution,基于结构的语言模型推荐突变点(Science文章)
i.了解inverse folding推荐突变点原理
ii.安装package和模型参数
1.git clonehttps://github.com/varun-shanker/structural-evolution.git
2.conda env create -f environment.yml
3.conda activate struct-evo
4.wget -P ~/.cache/torch/hub/checkpoints https://zenodo.org/records/12631662/files/esm_if1_20220410.zip
5.unzip ~/.cache/torch/hub/checkpoints/esm_if1_20220410.zip
iii.运行以推荐突变点:python bin/recommend.py examples/7mmo_abc_fvar.pdb \
--chain A --seqpath examples/7mmo_chainA_lib.fasta \
--outpath examples/7mmo_chainA_scores.csv \
--upperbound 109 --offset 1
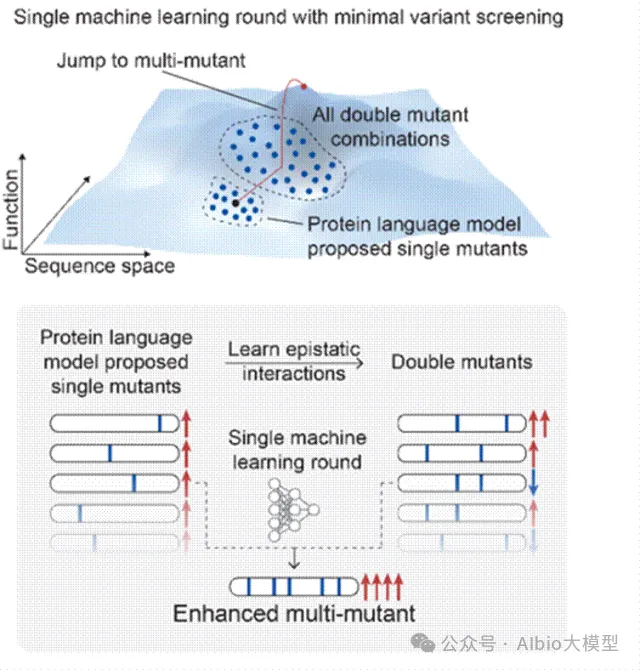
5.小样本的抗体亲和力成熟*,在已有少量样本的亲和力数据下训练模型。使用MULTI-evolve的方法预测多点的组合突变。
第三天:抗体可开发性预测和优化1
1.抗体可开发性优化在药物开发过程中的意义,
2.衡量抗体可开发性要考虑的因素,如免疫原性、自聚集性、结合特异性、稳定性等等3.以一篇专利文件为例讲解AI辅助抗体改造的案例。Patent No.: US12110324B2。Generate:Biomedicines公司通过AI方法在tezepelumab上改成的一种靶向(TSLP)的长效单克隆抗体GB-0895。
4.抗体结构简单物理性质的计算:溶剂可及表面积(SASA)的讲解及计算;等电点的计算;蛋白质表面电荷分布的计算。*
5.讲解Ginkgo举办的抗体可开发性预测比赛的结果。6.公开的抗体可开发性数据的收集。
7.抗体性质预测的模型实践,展示在小样本的情景下训练机器学习模型*1)数据处理,划分数据集
2)模型构建,基于特征工程的机器学习模型(随机森林,XGboost,ElasticNet等);学习根据蛋白质序列和结构信息构建常见特征。seq_features = feature_utils.get_all_seq_features(heavy_seq, light_seq, is_fv=True, isotype='igg1', lc_type='lambda')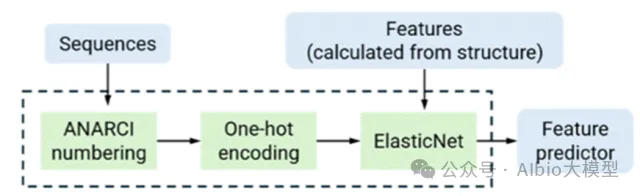 3)模型训练和评价,GridSearchCV交叉验证调参等
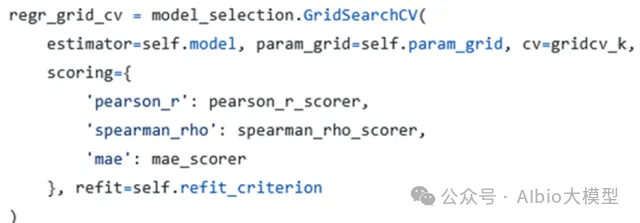 4)模型的可解释性,特征重要性分析
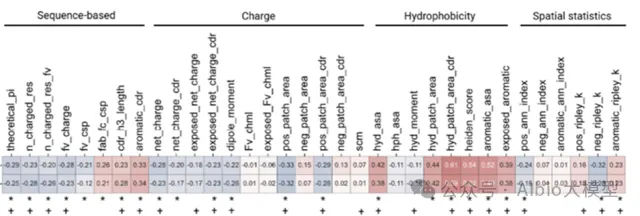
第四天:抗体可开发性预测和优化2和抗体人源化
1.基于蛋白质语言模型的可开发性预测*
1)零样本的可开发性预测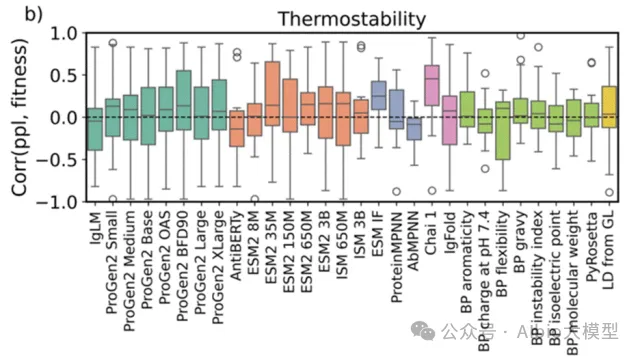 2)少样本的可开发性预测。给定抗体序列和相应的性质,构建下游模型预测。
a)数据处理,划分数据集
b)获得序列embedding以构建下游模型,实现蛋白质序列的不同方式encoding,包括"onehot", "georgiev", “esm”系列模型。
c)深度学习模型的构建。上游的大语言模型+下游简单线性层。
d)模型训练和评价:绘制训练曲线,训练集和测试集的评价指标随epoch的变化,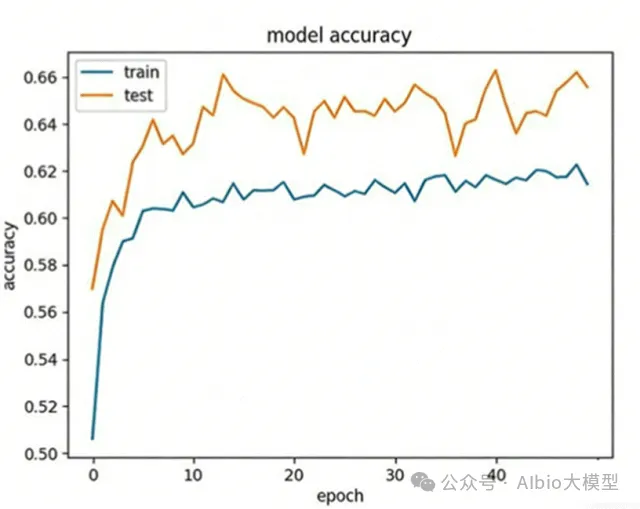 2.免疫原性预测
1)免疫系统介绍,MHC-I和MHC-II,Anti-drug Antibody等基础概念
2)免疫原性预测是MHC结合肽段的预测
3)预测免疫原性。netMHCpan的原理讲解,安装和使用
3.抗体人源化
1)人源化的基础知识和流程。目标:保留亲和力+减小免疫原性+好的稳定性和可开发性。CDR移植到人源框架,回复突变,Vernier Zone,
2)Germline的搜索,IMGT/V-QUEST数据库搜索得到V 基因和J基因相似的人类germline序列。
3)人源化的经典方法biophi的原理讲解、安装和使用。
4)基于AI和基于物理能量(Rosetta)的方法是如何辅助抗体人源化的。
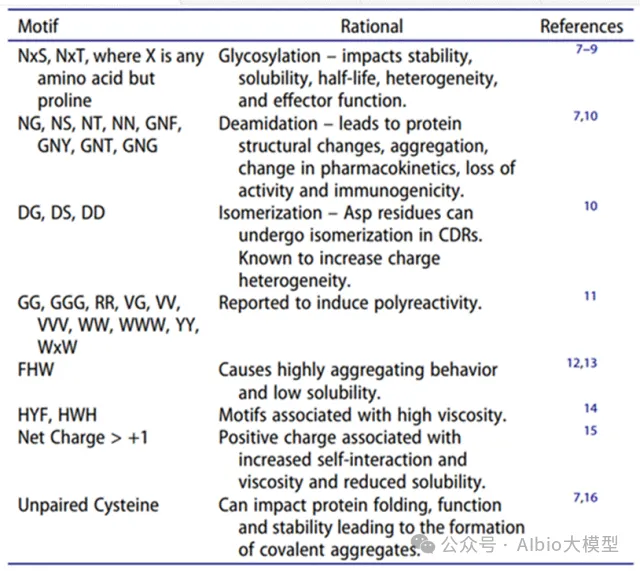
5)排除抗体序列的PTM。
第五天:抗体(scFv, VHH)的从头设计
1.从头设计的意义
1)跨膜蛋白例如GPCR,难以稳定表达为可溶性蛋白
2)VHH动物免疫羊驼成本高。
3)更高效快速获得候选分子
2.基础模型方法概念介绍:Diffusion模型、 flow-matching、全原子(all-atom)建模等
3.不同公司和方法模型、实验结果讲解
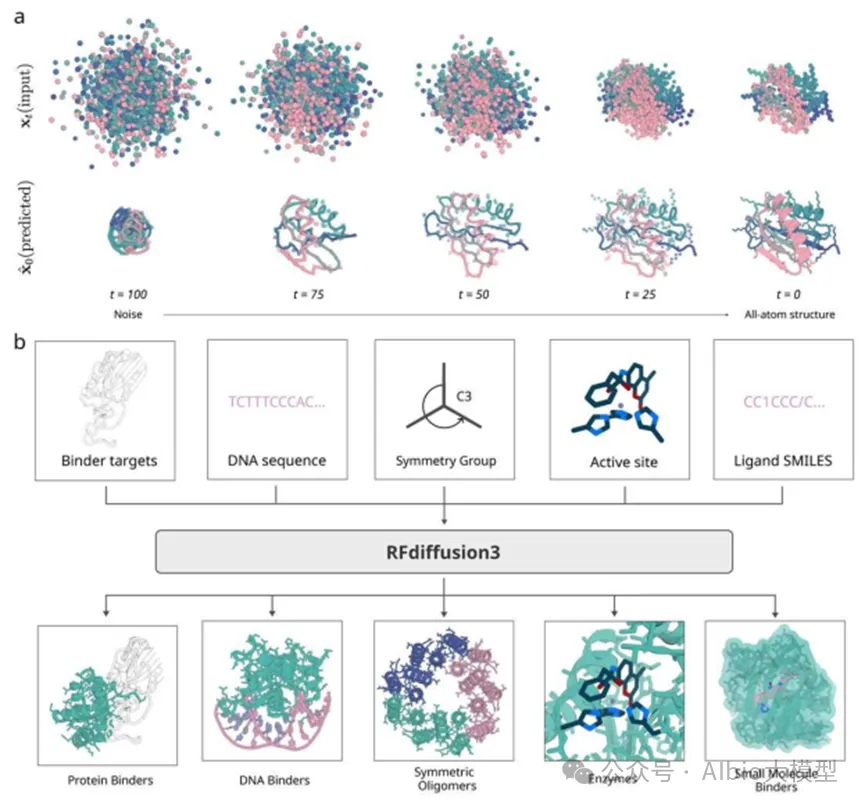
1)Rfdiffusion3+ProteinMPNN生成序列,AphaFold2筛选序列。将学会各个包的安装,不同参数的选择,结合的hotspot位点选择。
a)Rfdiffusion3结构设计,生成~10000个蛋白质主链结构;根据hotspot位点,生成新的结构:
./scripts/run_inference.py 'contigmap.contigs=[B1-100/0 100-100]' 'ppi.hotspot_res=[A30,A33,A34]' inference.output_prefix=test_outputs/binder_test inference.num_designs=10000
b)ProteinMPNN-FastRelax进行序列设计,每一个主链结构两个对应的序列,共设计~20000个序列;
c)筛选:使用AlphaFold2预测设计结构,预测的置信度pAE<10,预测结构与设计结构的RMSD<1A,从中挑选95个进行实验验证。
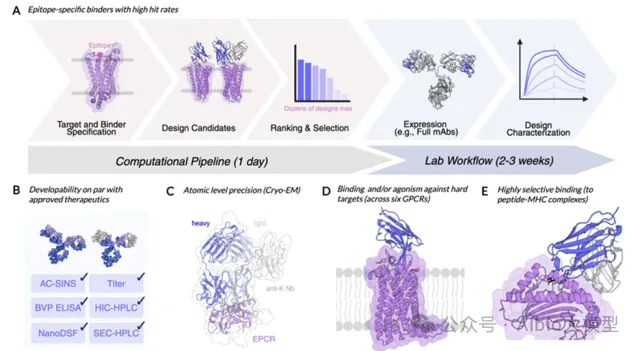
2)Nabla Bio开发的JAM(Joint Atomic Modeling)系统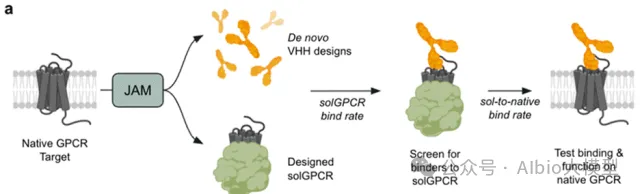 3)Chai2 Discovery开发的Chai-2方法,用以实现抗体的从头生成
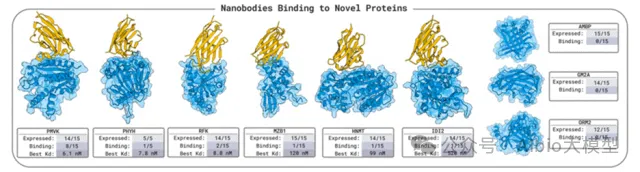
 4)MIT开发的Bolzgen方法原理、安装使用讲解。
安装和使用boltzgen讲解,将详细讲解yaml配置文件的写法,以一个靶点为例,从头生成VHH与该靶点结合。
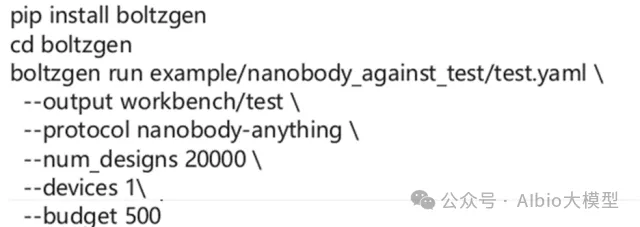 5)PPIFlow:基于flow-matching的生成方法,原理,安装和使用方法。
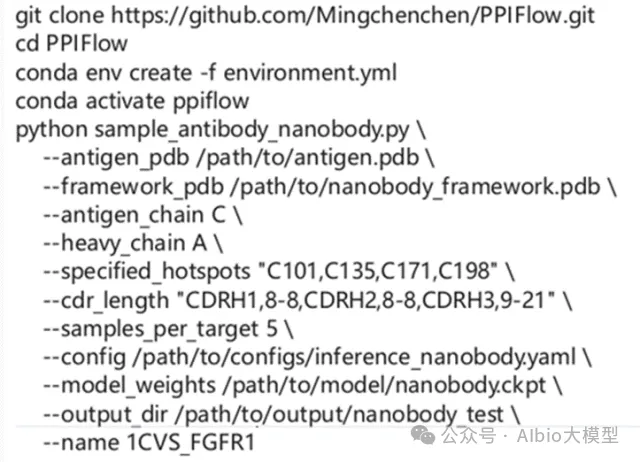
4.VHH的生成实践
1)确定纳米抗体序列框架(Framework区域)序列,生成CDR区域序列。分析整理纳米抗体序列,绘制序列保守性的Logo图,以此确定在生成VHH时,哪些位置的氨基酸需要固定。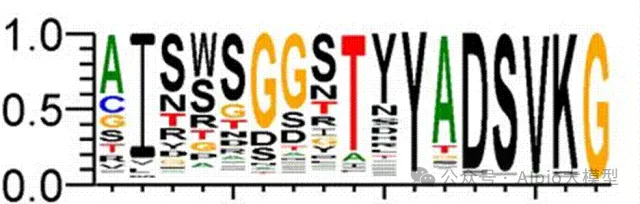 2)对生成的序列进行筛选。在亲和力、序列稳定性、可开发性等各个方面进行筛选。
a)预测结构与设计结构的RMSD,AlphaFold预测设计结构的置信度pAE等
b)筛选Cys,Met等氨基酸含量
c)减少电荷patch
d)根据等电点等性质筛选。
上下滑动查看更多


一、AI合成生物学总览与数据基础


第1天 AIDD基础——环境搭建、基本工具使用与数据库学习
从药物发现流程与常见数据形式入手,完成环境配置和工具练习,再通过ChEMBL案例掌握活性数据的获取与整理。
1. 【基础概念】AIDD概述:从CADD到AIDD,药物发现流程与常见AI任务
2. 【基础概念】分子与蛋白质数据:SMILES、SDF、FASTA与PDB
3. 【基础概念】常用数据库:PubChem、ChEMBL、PDB、UniProt;KEGG、Rhea及常用基准数据集简介
4. 【工具使用】Anaconda/Miniconda、VS Code、虚拟环境、环境变量与pip/conda镜像源配置
5. 【工具使用】requests数据下载,NumPy与pandas基本数据处理
6. 【工具使用】RDKit分子读写、描述符、指纹、构象与药效团;Open Babel格式转换
7. 【工具使用】Biopython、Biotite的蛋白质序列与结构读取
8. 【实战】创建虚拟环境、安装工具包并运行示例脚本
9. 【实战】使用RDKit计算分子描述符、指纹与相似性,生成简单构象并提取药效团特征
1. 【实战】RDKit分子操作与描述符计算
2. 【实战】RDKit分子指纹与相似性计算
3. 【实战】RDKit分子构象生成算法
4. 【实战】RDKit药效团提取与处理
5. 【实战】RDKit生化反应规则与应用
10. 【实战】使用requests下载文本、图片及数据库记录,获取分子结构与活性、蛋白质序列与结构
11. 【顶刊复现】Nucleic Acids Research|ChEMBL数据库:《The ChEMBL Database in 2023: a drug discovery platform spanning multiple bioactivity data types and time periods》
1. 【基础概念】理解分子、靶点、测定实验与活性记录的关联
2. 【实战】获取示例靶点的结构与活性数据,完成单位核对、去重与导出
3. 【复现重点】数据库使用与数据整理流程
第2天 药物分子虚拟筛选——分子性质预测
围绕分子性质预测与候选筛选,依次学习分子表示、模型训练和结果评价,再以abaucin发现案例串联完整的计算筛选流程。
1. 【基础概念】虚拟筛选与性质预测:生物活性、ADME与毒性,分类与回归任务
2. 【基础概念】分子表示:描述符、分子指纹与原子—化学键图
3. 【基础概念】模型评价:随机与骨架划分、交叉验证、分类与回归指标;候选排序与早期富集
4. 【AI技术】scikit-learn:决策树、随机森林、支持向量机与朴素贝叶斯
5. 【AI技术】PyTorch:张量、Dataset、DataLoader与简单神经网络训练
6. 【AI技术】GNN与PyG:消息传递、图级预测、Data对象与自定义Dataset
7. 【实战】基于ADME相关规则的分子过滤、基于相似性的配体筛选与分子聚类
8. 【实战】基于分子指纹和机器学习的生物活性或毒性预测,运行简单神经网络作为对照
9. 【实战】SMILES转分子图、构建Dataset,开展GNN分子毒性预测或HIV抑制活性预测
10. 【顶刊复现】Nature Chemical Biology|深度学习发现针对鲍曼不动杆菌的窄谱抗菌分子abaucin:《Deep learning-guided discovery of an antibiotic targeting Acinetobacter baumannii》
1. 【基础概念】理解实验抑菌数据、活性标签与定向消息传递神经网络(D-MPNN)
2. 【实战】使用公开数据子集开展小规模训练,或加载作者提供的模型预测候选分子
3. 【结果分析】结合预测得分、Tanimoto相似性与理化性质,完成候选排序和结构分析
4. 【复现重点】从实验数据整理、模型预测到候选筛选的计算流程;作用机制与生物实验验证作为结果解读内容
第3天 新型药物分子从头设计——分子语言模型与多模态条件生成
从分子序列表示与Transformer出发,通过Hugging Face衔接MolGen预训练模型,再用SPMM学习结构—性质多模态建模与性质条件生成,重点练习模型推理和结果核验。
1. 【基础概念】从性质预测到分子设计:根据已有分子生成候选、性质条件生成与生成后筛选
2. 【基础概念】分子序列表示:SMILES与SELFIES,分词、词表、特殊标记、编码与解码
3. 【基础概念】多模态与生成条件:分子结构序列与数值性质向量,结构到性质、性质到结构的双向建模
4. 【基础概念】生成评价:化学有效性、唯一性、新颖性、多样性、目标性质与条件满足程度
5. 【AI技术】序列建模与Transformer
1. 【AI技术】RNN与Seq2Seq简介,Attention与Transformer基本原理
2. 【AI技术】编码器与解码器、自回归生成与下一token预测
6. 【AI技术】Hugging Face框架使用
1. 【AI技术】pipeline、模型与分词器,预训练、微调与推理的区别
2. 【实战】使用AutoTokenizer与AutoModelForSeq2SeqLM加载MolGen,完成输入编码、模型生成与输出解码
3. 【AI技术】束搜索与随机采样的基本思路,生成长度与返回候选数量的设置
7. 【AI技术】从分子语言模型到多模态条件生成
1. 【AI技术】MolGen:以SELFIES为输入和输出的分子序列建模
2. 【AI技术】SPMM:分子结构序列与性质向量的编码、信息交互及条件生成
3. 【AI技术】性质向量的计算与标准化,生成条件的设置和结果核验
8. 【实战】通过简单pipeline示例熟悉Hugging Face,理解分词器、模型与推理流程
9. 【实战】调整生成参数,比较候选分子的有效性、唯一性、与输入分子的相似性及结构多样性
10. 【拓展实战】基于分子预训练模型微调毒性分类任务,熟悉训练、保存与加载流程
11. 【顶会复现】ICLR(2024)|MolGen分子语言模型:《Domain-Agnostic Molecular Generation with Chemical Feedback》
1. 【AI技术】理解SELFIES表示、Transformer编码器—解码器与分子序列生成
2. 【实战】从Hugging Face加载预训练模型与分词器,完成“示例分子输入—候选生成—结构解码”的流程
3. 【结果分析】分析生成参数对候选结构、性质与多样性的影响;化学反馈机制作为论文方法解读内容
4. 【复现重点】预训练模型推理与候选分析,复用Hugging Face的模型使用流程
12. 【顶刊复现·进阶案例】Nature Communications|SPMM结构—性质多模态建模与条件生成:《Bidirectional generation of structure and properties through a single molecular foundation model》
1. 【AI技术】理解分子SMILES与数值性质向量两种模态,以及结构与性质之间的双向建模
2. 【实战】使用预训练模型,根据给定性质条件生成少量候选分子,观察条件变化对生成结果的影响
3. 【结果分析】用RDKit重新计算生成分子的性质,比较条件满足程度、有效性与结构多样性
4. 【复现重点】性质条件设置、模型推理与结果核验;复杂预训练目标作概念介绍
第4天 蛋白质任务——功能预测、突变效应与酶工程
将前面学习的模型使用方法拓展到蛋白质,先理解序列、结构与预训练嵌入,再通过功能预测和酶工程案例学习对比学习与配对特征融合。
1. 【基础概念】蛋白质任务:功能分类、突变效应与酶催化性质预测
2. 【基础概念】蛋白质表示:氨基酸序列、预训练嵌入与残基结构图
3. 【基础概念】酶—底物配对数据及常见动力学参数简介
4. 【AI技术】蛋白质分词器与ESM等预训练模型的表示提取
5. 【AI技术】复用机器学习、MLP与GNN开展蛋白质预测
6. 【实战】从序列和PDB文件构建蛋白质数据结构,自定义原子与残基属性
7. 【实战】提取蛋白质序列嵌入,结合简单分类器开展功能预测
8. 【实战】基于序列预测TEM-1 β-内酰胺酶突变对实验测得功能的影响
9. 【顶刊复现】Science|CLEAN基于对比学习的酶功能预测:《Enzyme function prediction using contrastive learning》
1. 【AI技术】蛋白质嵌入、对比学习与EC编号分配
2. 【实战】使用预训练模型开展功能预测,分析低相似性样本与多功能酶
3. 【结果分析】评价功能预测结果,理解置信度与类别不平衡
10. 【顶刊复现·进阶案例】Nature Communications|CataPro辅助酶挖掘与工程改造:《Robust enzyme discovery and engineering with deep learning using CataPro》
1. 【AI技术】酶与底物的联合表示、动力学参数预测与候选排序
2. 【实战】使用整理好的配对样本开展预测,分析不同酶或突变体的排序
3. 【基础概念】衔接第5天:从蛋白质任务过渡到两个研究对象的联合建模
第5天 相互作用与复合物——亲和力预测、口袋与条件分子生成
在分子与蛋白质建模的基础上,进一步学习复合物表示、三维等变建模和条件扩散,通过OpenVS与DiffSBDD串联结构虚拟筛选和口袋条件生成。
1. 【基础概念】复合物任务:相互作用预测、亲和力预测与口袋条件分子生成
2. 【基础概念】复合物表示:蛋白质—配体配对特征、结合口袋、三维坐标与联合图
3. 【基础概念】生成条件与评价:口袋、性质或固定片段;区分亲和力、对接评分与结构适配性
4. 【AI技术】GNN特征融合与蛋白质—配体联合建模
5. 【AI技术】不变性与等变性、EGNN基本原理;e3nn的Irreps与TensorProduct简介
6. 【AI技术】扩散模型:前向加噪、反向去噪、训练目标与条件采样
7. 【实战】读取蛋白质与配体,提取口袋、坐标与特征,开展GNN亲和力预测
8. 【实战】运行简单EGNN与e3nn示例,理解三维数据输入、特征与坐标更新
9. 【实战】运行简单加噪与去噪示例,调用预训练模型开展口袋条件生成,结合已有筛选代码评价候选分子
10. 【顶刊复现】Nature Communications|OpenVS:主动学习加速超大规模结构虚拟筛选
1. 【工具使用】RosettaGenFF-VS打分与VSX/VSH分层对接。
2. 【AI技术】Morgan指纹、MLP代理模型与对接分数伪标签。
3. 【AI技术】高分选样与随机探索相结合的迭代筛选。
4. 【结果分析】候选过滤、结构聚类及KLHDC2/NaV1.7实验结果解读。
5. 【复现重点】小规模主动筛选循环、计算预算与候选富集分析。
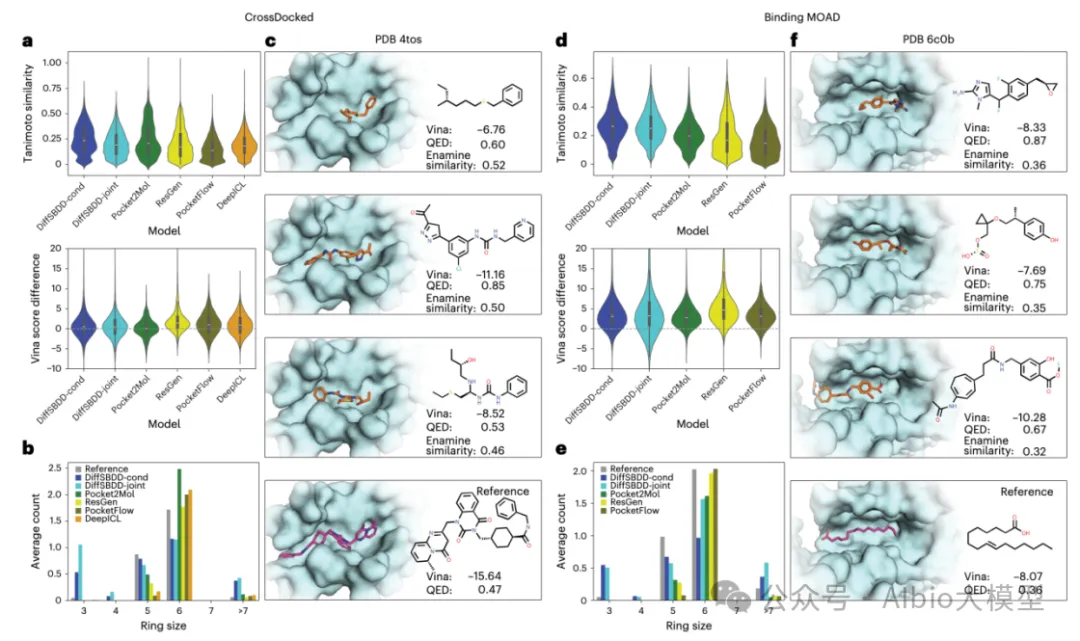
11. 【顶刊复现·进阶案例】Nature Computational Science|DiffSBDD基于等变扩散的结构条件药物设计:《Structure-based drug design with equivariant diffusion models》
1. 【AI技术】蛋白质口袋条件下的配体三维生成
2. 【实战】使用预训练模型完成口袋条件采样与固定片段补全案例
3. 【结果分析】结合第2天的性质预测与第3天的生成评价方法,形成候选分子的综合筛选结果
讲师介绍


AI蛋白质设计与AI抗体设计
主讲老师在学术界和工业界都有丰富算法开发和应用经验,博士毕业于国内顶尖课题组,从事蛋白质结构预测和蛋白质设计的研究工作,相关工作成果已在Cell Systems、Angew. Chem. Int. Ed.、JCIM等国际知名期刊发表论文。目前在知名药企担任高级研究员,主导AI驱动的大分子药物设计平台开发与团队管理。

AI多肽抗菌肽设计
。主讲老师长期从事人工智能驱动的多肽/蛋白质设计研究,主要方向为多肽从头设计、生成式大模型与深度学习算法开发及应用,在Nature biotechnology、Nature Communications、Advanced Science、ICLR、AAAI、KDD等顶级期刊和会议发表论文十余篇,在多肽药物设计、抗菌肽与靶点结合肽设计、生物序列建模等方向具有丰富的算法开发与实战经验。

AIDD药物设计
主讲老师来自天津大学,有十余年的计算机算法研究和程序设计经验。研究方向涉及深度学习药物发现,药物合成路径设计等。发表SCI高水平论文10篇,包括BMC Bioinformatics, Journal of Biomedical Informatics, International Journal of Molecular Sciences等知名期刊!讲课一致受到学员极高评价

AI合成生物学
主讲教师来自清华大学,兼具学术研究与产业应用背景,,来自国内顶尖生命科学与人工智能交叉研究团队。其研究方向与本课程“AI 驱动的合成生物学”高度契合,能够从前沿算法、真实科研案例和产业转化应用三个层面,系统讲解人工智能如何结合生物元件设计、基因线路构建、代谢工程优化与 DBTL 闭环。主讲教师及所在团队相关研究成果已发表于 PNAS、Angew. Chem. Int. Ed.、Nature、Science 等国际知名期刊,团队累计发表论文 300 余篇,具备扎实的科研积累与前沿课程开发基础。

AI类器官技术多场景应用与转化
主讲老师在学术界和工业界均有丰富的类器官开发与应用经验,博士毕业于国内顶尖课题组,长期从事类器官与人工智能交叉、类器官高通量构建与智能分析的研究工作,相关工作成果已在 microsystems&nanoengineering、Journal of Nanobiotechnology、Bio‑Design and Manufacturing 等国际知名期刊发表论文。目前在知名研究所担任副研究员,主导类器官自动化与 AI 辅助设计平台的开发与团队管理。
2026.11.17 -2026.11.20(19:00-22:00)
2026.11.21 -2026.11.22(09:00-11:30--13:30-17:00)
2026.11.25 -2026.11.26(19:00-22:00)
2026.12.19-2026.12.20(09:00-11:30--13:30-17:00)
2026.12.26 -2026.12.27(09:00-11:30--13:30-17:00)
AI合成生物学
AIDD人工智能药物设计进阶
培训费用
课程报名费用:
AI蛋白质设计、AI+多肽抗菌肽设计、AI抗体设计、AI合成生物学:
公费价:每人每班¥6880元 (含报名费、培训费、资料费、提供课后全程回放资料)
自费价:每人每班¥6280元 (含报名费、培训费、资料费、提供课后全程回放资料)
AIDD药物发现与设计,AI类器官技术多场景应用与转化:
公费价:每人每班¥5880元 (含报名费、培训费、资料费、提供课后全程回放资料)
自费价:每人每班¥5280元 (含报名费、培训费、资料费、提供课后全程回放资料)
重磅优惠:
优惠1:报二送一(同时报名两个班赠送一个学习班,赠送班任选)
两班同报:10880元
三班同报:14880元
四班同报:18880元
特惠一:24880元 (可免费学习一整年本单位举办的任意课程)
特惠二:28880元(可免费学习两整年本单位举办的任意课程)
特惠三:48880元(终身会员可终身参加本单位举办的任意课程)
优惠2:提前报名缴费可享受300元优惠(仅限前15名)
优惠3:报名直播课程可赠送往期课程回放
(报名一个直播课可以赠送两个回放)
(报名三个直播课赠送下面全部课程回放)
(可点击跳转详情链接):
回放五: 本课程为视频课!CRISPR-Cas9基因编辑培训!
回放六:本课程为视频课!蛋白质晶体结构解析培训!
报名费用可开具正规报销发票及提供相关缴费证明、邀请函,可提前开具报销发票、文件用于报销 。报名缴费后即可获得全套预习资料供大家课前准备
1、课程特色--全面的课程技术应用、原理流程、实例联系全贯穿
2、学习模式--理论知识与上机操作相结合,让零基础学员快速熟练掌握 3、课程服务答疑--主讲老师将为您实际工作中遇到的问题提供专业解答
授课方式:通过腾讯会议线上直播,理论+实操的授课模式,老师手把手带着操作,从零基础开始讲解,电子PPT和教程开课前一周提前发送给学员,所有培训使用软件都会发送给学员,有什么疑问采取开麦共享屏幕和微信群解疑,学员和老师交流、学员与学员交流,培训完毕后老师长期解疑,培训群不解散,往期培训学员对于培训质量和授课方式一致评价极高!

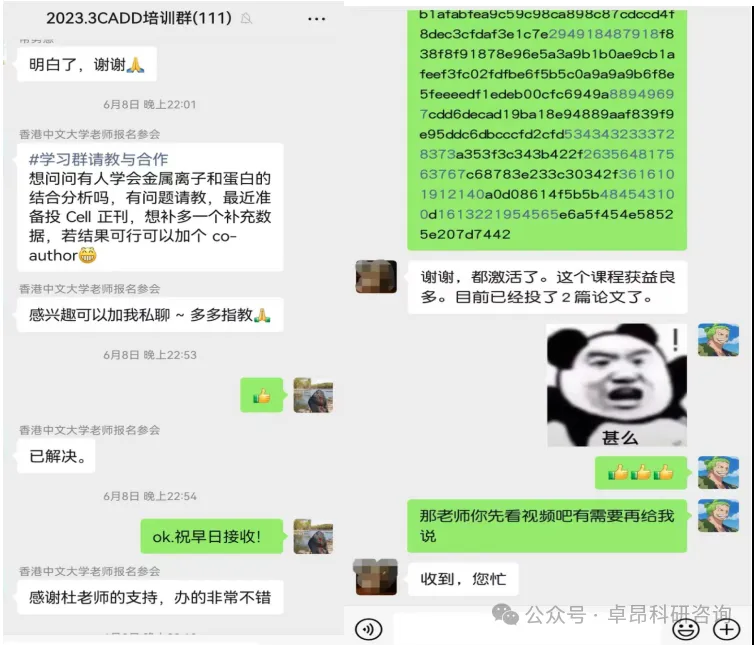
学员对于培训给予高度评价
联系人:叶老师
报名电话:13838281574 ( 微信同号)
邮箱:y13838281574@163.com
引用往期参会学员的一句话: