ARTICLE · 1329655
不装插件不用数据库,我用三个文本文件给 Claude 治失忆.
有人用三个普通文本文件,把 Claude Code 每天失忆的毛病给治好了。
没有装插件,没有连向量数据库,甚至一行复杂的 Python 脚本都没写。前后花了一分多钟,给 AI 丢过去一份几百字的说明书,它就在项目目录里自己把记忆系统搭起来了。
这事有意思的地方,不在于那个博主有多聪明,而在于它把很多人心里的一个执念给敲碎了。过去一整年,只要提到让大模型拥有长期记忆,整个行业的标准答案几乎都是同一套东西。去买向量数据库服务,把所有的聊天记录切成小碎片,算成几千维的浮点数向量存进去,每次提问的时候再做相似度检索。一堆晦涩难懂的技术名词砸过来,普通人还没开始动手,就已经觉得自己被淘汰在门外了。
结果现在有人站出来说,其实根本用不着这么费劲。你在项目里建两个文件夹,建三个 Markdown 文件,一个叫工作日志,一个叫索引目录,一个叫决定本。每次让 AI 关掉窗口之前把今天干了什么记下来,下次开工先扫一眼目录。
就这么简单。
很多人可能还没反应过来,这件事真正值得琢磨的地方到底在哪。
■ 记忆不是脑子里的回音
大模型在本质上是个没有过去也没有未来的运算引擎。哪怕你花钱买了最贵的会员,哪怕官方宣传上下文窗口已经支持到几百万个 token,只要你关掉当前的对话框,或者只要你的代码改动超过了一定的量,上一轮对话积累的所有上下文,立刻被清理得干干净净。
下一次你再打开终端,叫醒它的时候,站在你面前的又是一个刚从学校毕业、第一天办入职的新员工。
你昨天跟它千叮咛万嘱咐的那些规则,比如在这个项目里同名文件千万不能直接覆盖,没下载完的临时文件要跳过,测试之前必须先演练一遍。它全部忘得一干二净。它会兴高采烈地用它那套标准的大模型直觉,把你前一天好不容易纠正过来的逻辑,再原原本本地写烂一遍。
很多人对这种失忆感到愤怒,然后试图把上下文窗口塞得越来越大。但是上下文窗口其实不是长期记忆,上下文窗口是计算机里的内存条。
内存条再大,它也不是硬盘。断了电,它就什么都没有了。
十七世纪的远洋帆船在大西洋上航行,一出海就是几个月。那时候船上的水手和水手长经常轮换,甚至船长在航程中间因为意外死掉都是常有的事。但是一艘船能走完几万海里准确靠港,靠的从来不是哪个水手脑子好使。靠的是大副桌子上那本厚重的航海日志。
几点几分起锚,风向是多少,航速有几节,下午两点避开了哪片暗礁,做出了什么转向决定。这些东西只要落到了纸面上,哪怕整艘船的人都换了一拨,新上任的人翻开上一页,依然知道这艘船走到了哪里。
人类文明延续了几千年,积累经验的方法从来都不是等一个过目不忘的天才降生。人类解决记忆问题的办法,就是做记录。
你不用去改变 AI 的神经网络权重,你甚至不用指望大模型厂商哪天大发慈悲给你开放一个底层的记忆接口。你只需要给它一根笔,给它两张白纸,立下一条规矩,在每次动手写代码之前,先把桌上的记录翻一遍。
■ 复杂技术的尽头往往是一张白纸
那个方案里具体写了什么,拆开看简单得甚至有点简陋。
第一个文件是工作日志,放在 devlog 文件夹里。每做完一个需求,让 AI 自己去写一篇,格式死板得像流水账。改了什么,为什么改,定了什么新规矩,踩了什么坑,还有哪些没想清楚的。最后在文件头打上几个具体的标签。
第二个文件是目录,只占一页。每一行记一条记录,最新的一条永远放在最上面。格式甚至精确到了字符,写明时间、文件名、一句话总结,后面跟着具体的标签。
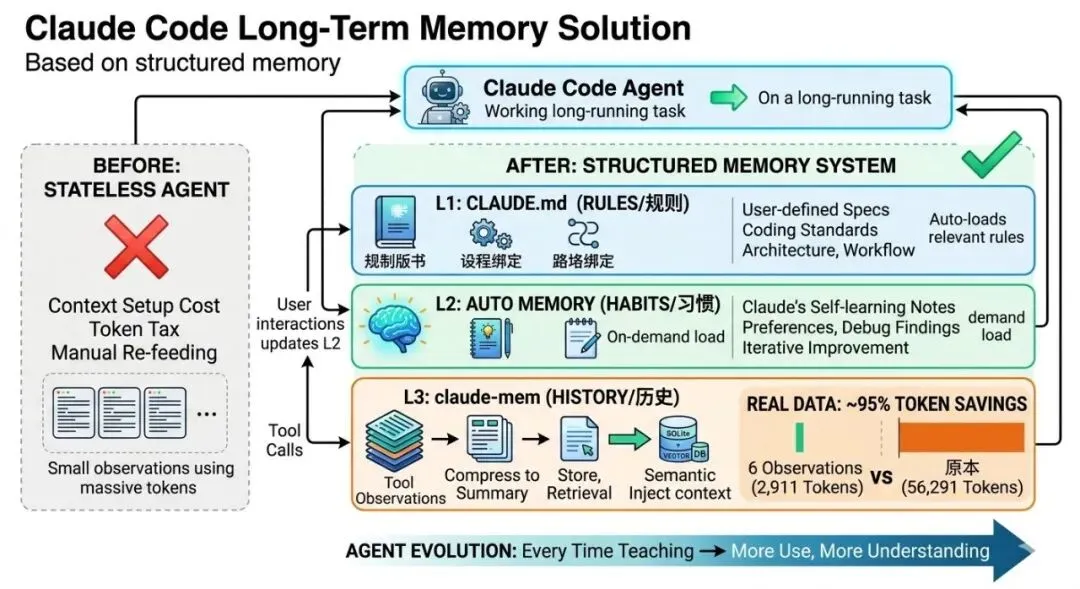
第三个文件是决定本。里面没有废话,一条就是一句话,哪年哪月哪一天,因为什么原因,做了一个什么不可逆的架构决定。决定一旦写进去就只准往后追加,以后哪怕推翻了之前的决定,也不能把旧的那条删掉,而是再写一条新的,写明这一条取代了哪一条。
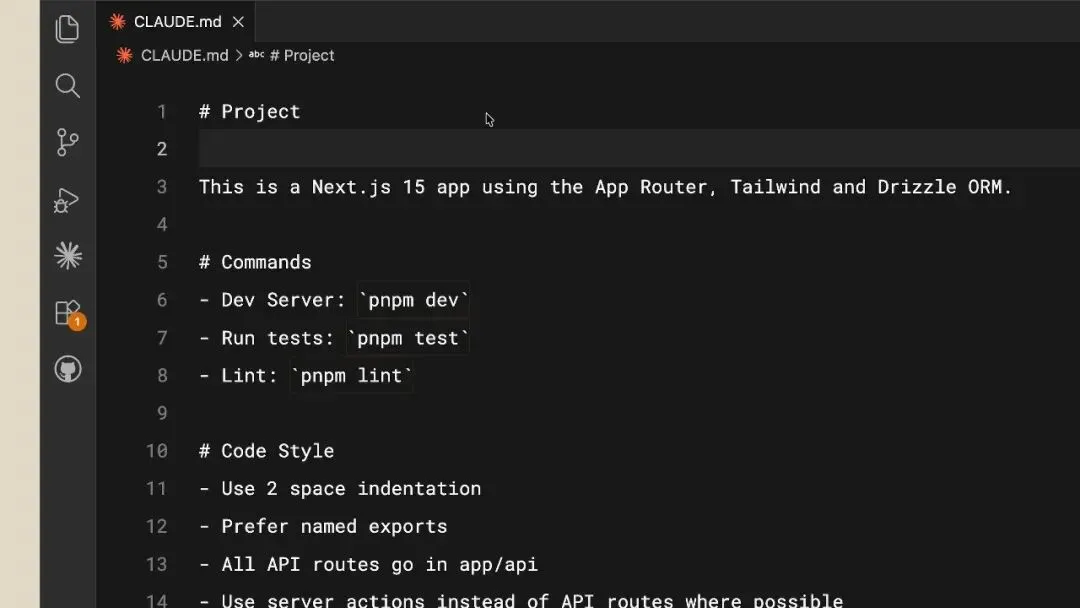
最后在 Claude Code 启动时默认会读的系统文件里加一行字,告诉它每次开工,第一步先看目录。改以前改过的地方之前,先翻旧账。
整套系统里最核心的检索逻辑,甚至连 Python 搜索脚本都没用,直接用了一条几十年前就写进 Unix 操作系统的原生文本过滤命令。
这件事最讽刺的地方就在这里。
过去这两年,整个技术圈在 AI 记忆这件事上耗费了海量的投资。无数创业公司在路演 PPT 上画着极其复杂的拓扑图,从知识图谱到向量嵌入,从分块重排到动态剪枝。每个人都在试图用一套极其高深的技术,去解决一个其实非常朴素的问题。
计算机历史上有个非常著名的哲学,来自创造了 Unix 系统的那些老工程师。他们有一条铁律,叫做尽可能让程序的输入和输出都是纯文本。
因为文本是透明的。
当你用向量数据库存记忆的时候,你根本不知道 AI 到底记住了什么,也不知道它遗漏了什么。那些被切成碎片的数字飘在服务器里,你看不懂,改不了,排查不出问题,就像一个不可名状的黑盒子。
但是当记忆变成几个 Markdown 文件的时候,情况完全不一样了。
你可以随时用任何一个文本编辑器打开它。你一眼就能看明白 AI 今天都干了什么,它把哪个参数理解错了,它在决定本里记下了哪条愚蠢的逻辑。如果你发现它记错了,你连提示词都不用写,光标移过去,按几下退格键,把那行字改成对的。
把记忆的控制权,重新拿回到人类的手里。
能看懂的系统,才靠得住。
■ 一个人怎么统领一群不知疲倦的帮手
很多人可能还没意识到,一旦把记忆从 AI 的脑子里抽出来,变成项目里的独立文件,会带来什么连锁反应。
如果一个 AI 的记忆只存在于它自己的对话窗口里,那这个 AI 永远只能单打独斗。你今天开了三个窗口,就等于招了三个互不相识、各自为战的实习生。一号窗口改了数据库字段,二号窗口还在按照老的接口写逻辑,三号窗口甚至在试图把你刚刚重构过的代码还原回去。
这是为什么很多人在试着用多智能体协作的时候,最后都会陷入混乱的原因。它们没有共识,它们在同一个项目里互相打架。
但是如果记忆是写在项目目录里的日志和决定本呢。
一号 AI 敲完最后一行测试,在目录里加上一行更新记录,在决定本里记下一笔,然后退出。两秒钟之后,你在另一个窗口里拉起来二号 AI,它根本不知道上一秒发生了什么,它也不需要知道。它只需要按照规则读一眼第一行的目录,立刻就能接上一号留下的所有资产。
甚至更进一步,当你的团队里有五个、十个 AI 在同时跑的时候,它们不需要复杂的集群通信协议,也不需要什么中央大脑。它们只要遵守同一个航海日志的写入规则。
二十世纪初有个著名的社会学家叫卢曼,一生写了七十多本书、几百篇高质量的学术论文。那时候没有电脑,更没有大模型。别人问他怎么能有这么恐怖的产出,他指了指书房里的卡片盒。他说他的脑子其实根本记不住那么多东西,他只是每天都在往那个盒子里塞卡片,给每一张卡片编上编号,建好交叉引用的目录。
他的卡片盒自己会思考。
现在的这套文件记忆,其实就是给每个代码项目配了一个卡片盒。AI 只是那个负责从盒子里抽卡片、读卡片、然后往盒子里塞新卡片的工人。
工人每隔几个小时就会疲惫,就会下班,就会被重置。但是放在桌上的卡片盒不会。
那个盒子一直在那里。
一个项目的生命力,从来不在于写代码的工具换了多少代。它在于那些踩过的坑有没有被落成文字,在于那些推翻过的重构方案有没有留下原因,在于那些深夜做出的妥协有没有被后人知晓。
多花一点点时间,去看看这些最朴素的纯文本方案。
在所有人都忙着追逐更复杂的新工具时,往往是那些存在了几十年的简单规矩,真正把事情推向前去。