ARTICLE · 1346230
排版插件开发手记3:三种文档,我用一条流水线吃掉Markdown、Word、HTML 进来,一种结构出去
一 · 问题:输入太杂
第 2 篇定下规矩:复刻能力,本地优先。能力第一条是「读得进用户的文档」。
但用户的文档来源很乱。
某位读者发来一份 Word,说「帮我看看这个导进去为什么歪」;我自己写的是 Markdown;从某个网站存下来的,是一份带 <style> 的 HTML。三种格式,三种脾气。
如果为每种单独写一个解析器,会发生三件坏事:代码重复,边界各写各的,样式引擎要对着三套输入分别适配——最后一定乱。
所以我的目标不是「三个解析器」,而是「三种格式,一种结构」。
二 · 中间表示:一块统一的画布
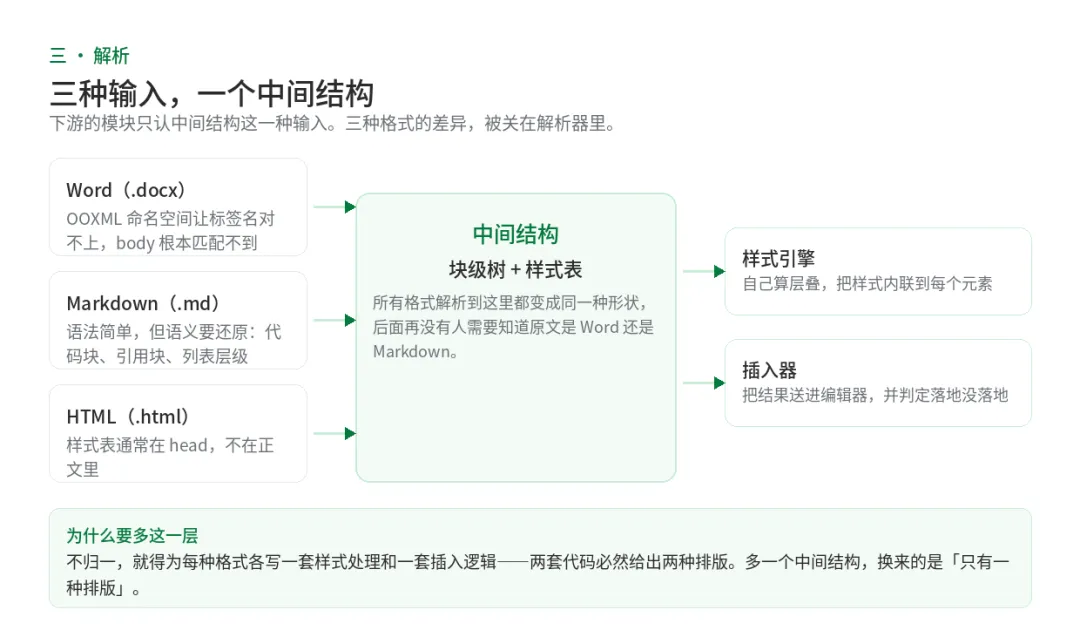
我把三种格式归一为一个中间结构:块级树 + 样式表。
块级树:文档的语义骨架。段落、标题、引用、列表、代码块、图片、表格,各安其位。 样式表:所有样式来源收敛到这里。元素自带的 style属性、<style>块里的规则、Markdown 隐含的语义样式,都投影进同一张表。
下游的样式引擎和插入逻辑,只认这一种输入。
这么做有三个好处,后来都救过我:
- 错误被隔离在入口。
某种格式解析出错,不会污染后面的算法。 - 样式算法只写一遍。
不管来源是 Word 还是网页,算层叠的代码是同一份。 - 加新格式只需写适配器。
再来一种奇怪的来源,我只要把它翻译成中间结构,下游一概不动。
三 · 各格式的坑
三种格式,三个各不相同的坑。
Word(docx):命名空间陷阱
docx 是 OOXML,标签都带命名空间前缀,比如 <w:body>。
我第一版用 getElementsByTagName('body') 找正文容器,结果匹配不到——qualified name 对不上。<w:body> 的 localName 是 body,但带前缀的全名是 w:body。
修法是遍历 getElementsByTagName('*'),按 localName 去找。这不是边角问题:正文容器找不到,整篇 Word 就解析成空。
HTML:样式在 head,不在正文
HTML 的样式表通常写在 <head> 里,正文全是带 class 的标签。
如果判据只看「正文里有没有 <style> 或 class=」,就会判成「无需内联」——结果整页的 <head> 样式一个字节都没搬过去。不报错,结构完好,但排版全丢。
判据必须连 <head> 一起看,把 headStyles 也算进来。这条坑,第 4 篇算样式时会再遇到一次。
Markdown:语义还原与配对
Markdown 没有显式样式,但有语义:引用块、代码块、嵌套段落。
坑在「比对时的配对键」。<blockquote> 和它的内部 <p> 文字相同,如果只用纯文字配对,会把 blockquote 的 15px 和内部 p 的 16px 比出假差异。配对键必须带上「同文字序号」,否则对照组会误导你改错地方。
四 · 验证:让解析器自己证明自己
解析是下游一切的地基,地基错了后面全错。所以验证要硬。
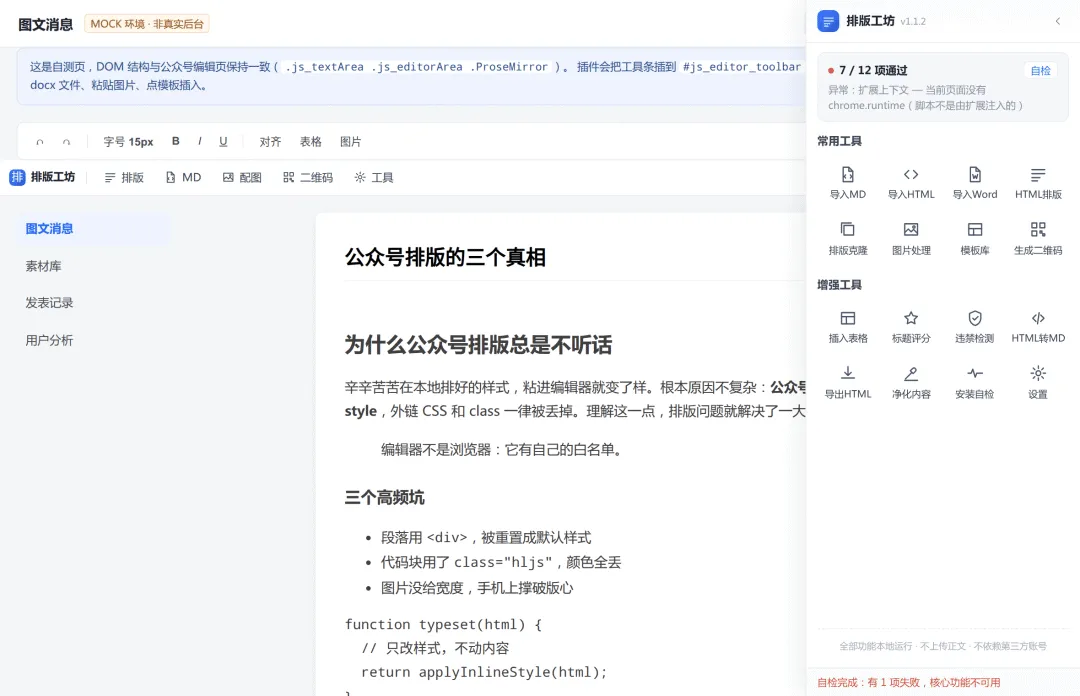
纯逻辑单测 276 项覆盖解析器(这是排版工坊自有数据,可公开)。 断言不写死数量:主题套数、检查项数会随产品演进变化,写死就假红。只断言结构与不变量。 黄金对照:以真浏览器原生渲染为基准,逐元素比对,而不是「重新导入再看一眼」——后者分不清「本来就这样」和「被我改坏了」。
五 · 衔接:读进来不等于算对
这一篇解决的是「入口」。文档读进来了,归一成一种结构了,错误被隔离了。
但「读进来」不等于「算对了」。
样式这关,才是第 1 篇说的第一个坑:最直觉的做法是把正文塞进隐藏 iframe 读 getComputedStyle,结果把浏览器默认值当成了文件样式。为什么,以及我怎么改成自己算层叠,留到第 4 篇。
最后
三种格式,一条流水线。进来的是乱的,出去的是同一种结构——这是后面所有「算得对、送得进、说得清」能成立的前提。
下一篇,从那把最危险的「尺子」说起。