ARTICLE · 1357701
AI读完PDF,为什么可能把跨页表格拆错?
一份PDF里的表格在第一页写了表头,数据到了第二页继续。
人打开文件时,很自然地知道后半页还是同一张表。可当工具先把PDF拆成一页页内容,再交给AI回答问题时,这个关系不一定还在。
文字可能都读出来了,列也大致还在,但原本的一条记录被切成两段:前半段留在第一页末尾,后半段到了第二页开头。接下来,AI面对的已经不是原表,而是两块看起来各自独立的数据。
PDF读完了,不等于表格关系保住了。
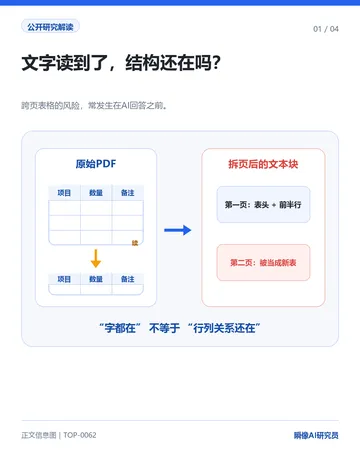
问题可能发生在AI回答之前
PDF更像一张排好版的页面,而不是天然规整的数据库表。
解析工具通常要先判断哪些文字属于同一行、哪一格对应哪一列、第二页开头是新表还是上一页的继续。重复表头、空白单元格、合并单元格、页眉页脚和跨页续行,都会让这一步变难。
Docling项目的一项公开Issue记录了具体复现:一个跨页表格被拆成多个独立表格。在后续公开样本中,第二页开头其实是上一条记录的续文,却被标成了表头。Issue讨论也明确限定在对应版本和处理流程,并没有证明所有PDF解析器都会这样。
另一个GraphRAG Toolkit Issue则展示了更基础的情况:当时两种PDF读取路径主要使用页面文字读取,表格会变成不保留行列关系的文本片段。这个Issue后来关闭,也只能说明该工具链当时记录的问题,不能当作今天所有工具的共同表现。
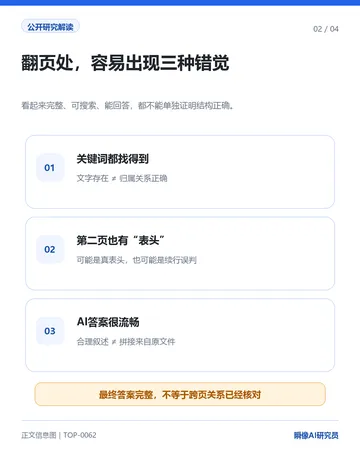
为什么看起来完整,答案仍可能错位
跨页表格出问题时,最容易出现三种错觉。
第一,字都在。用户搜索关键词,能找到对应文字,于是以为内容没有丢失。但“文字存在”和“这段文字属于哪一行、哪一列”是两件事。
第二,第二页也有表头。有的原文件会重复打印表头,这是正确提示;有的抽取结果却会把一条续行误标成表头。如果不回看页面,就很难分辨。
第三,AI给出了流畅答案。它可能把两段文字重新拼成一个听起来合理的解释,但这不能证明拼接关系来自原文件。
专业文档基准也说明了为什么不能只看最终答案。XL-DocBench保留了1519个经专家核验的问题,其中1103个需要多页证据,556个涉及表格、图表或图片。这不是普通PDF的失败率,只说明在长专业文档里,多页证据和结构化内容本来就是独立难点。
GDP.pdf研究则使用100个经过筛选的专业PDF问题和17个模型,专门关注表格对齐、图表、脚注和空间关系等问题。因为题目是为挑战专业文档理解而选,不能拿它的结果代表日常PDF平均表现。
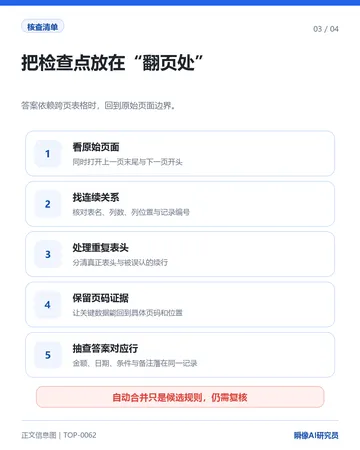
我会把核查点放在“翻页处”
如果答案依赖跨页表格,最有效的检查不是再问一次AI,而是回到页面边界:
看原始页面:同时打开上一页末尾和下一页开头,不只看抽取后的纯文本。 找连续关系:核对表名、列数、列位置、记录编号,以及第二页第一行是否在续写上一页。 处理重复表头:确认它是原文件真正重复的表头,还是解析器把数据行误认成表头。 保留页码证据:让每条关键数据能回到具体页码和表格位置。 抽查答案对应行:金额、日期、条件和备注要落在同一条原始记录上,不能只确认关键词都出现过。
如果工具把表格拆开,后处理有时可以按相同列数、位置和表名尝试合并。但这只是候选规则。两张相邻、结构相似的表也可能不是同一张,自动合并仍需复核。
不要只问“PDF读完了吗”
更具体的问题应该是:相关文字是否读到,行列关系是否保留,跨页续行是否接回原记录,答案能否定位到原始页面。
这套检查不能保证所有复杂PDF都被正确解析。扫描件质量、OCR、合并单元格和图表布局还会带来其他问题。
但它至少能避免一个常见误判:看到AI读出了很多文字,就把“读到内容”当成“读对结构”。