ARTICLE · 1359808
一套内网文档查重工具的开发实践
从人工比对到自动化查重
一套内网文档查重工具的开发实践
—— 文档横向查重系统开发纪实
文中截图均为脱敏演示样例数据
数百页文档逐对人工比对,一个下午起步——这类活,多数人都干过。这篇纪实,记录了我如何把这件事交给一套纯内网工具,几分钟拿到结果:设计思路、四个踩坑、一次「404 惊魂」,以及一轮实打实的性能优化。 |
一、为什么要做这件事
在文档编制与审核工作中,存在这样一类需求:将同一批次的多份文档交叉比对,识别其中的大面积雷同内容,以评估文档编制的独立性与规范性。
这类工作若完全依赖人工,需在数百页文本间反复检索比对——耗时长、易遗漏,结论也难以量化。
为解决这一问题,笔者开发了一套「文档横向查重系统」。系统部署于单位内部网络:用户上传同一批次的多份文档,系统自动完成解析与比对,输出带高亮标注与出处定位的查重报告。本文记录它的设计思路、开发过程中的典型问题与性能优化实践。
二、设计思路
横向查重在计算上可归结为「两两比较」。若不加甄别地对全部段落做全量比较,计算量将随文档规模呈平方级增长——人工如此,机器亦然。
设计的核心不在于「算得多快」,而在于「能否不算那么多」。 |
判断两段文字的相似程度,存在三个由廉价到昂贵的层次:
●字面层面的字符相似度,成本最低;
●语义层面的含义相似度,需将文本转化为向量后计算,成本高一个数量级;
●大模型复核,对仍难以判定的片段做最终判定,成本最高。
基于此,系统采用「三层漏斗」结构:本地引擎承担前两层比对,筛除绝大多数无关段落;内网大模型仅对少量疑似片段做最终复核。昂贵的计算资源,只用于最必要的环节。
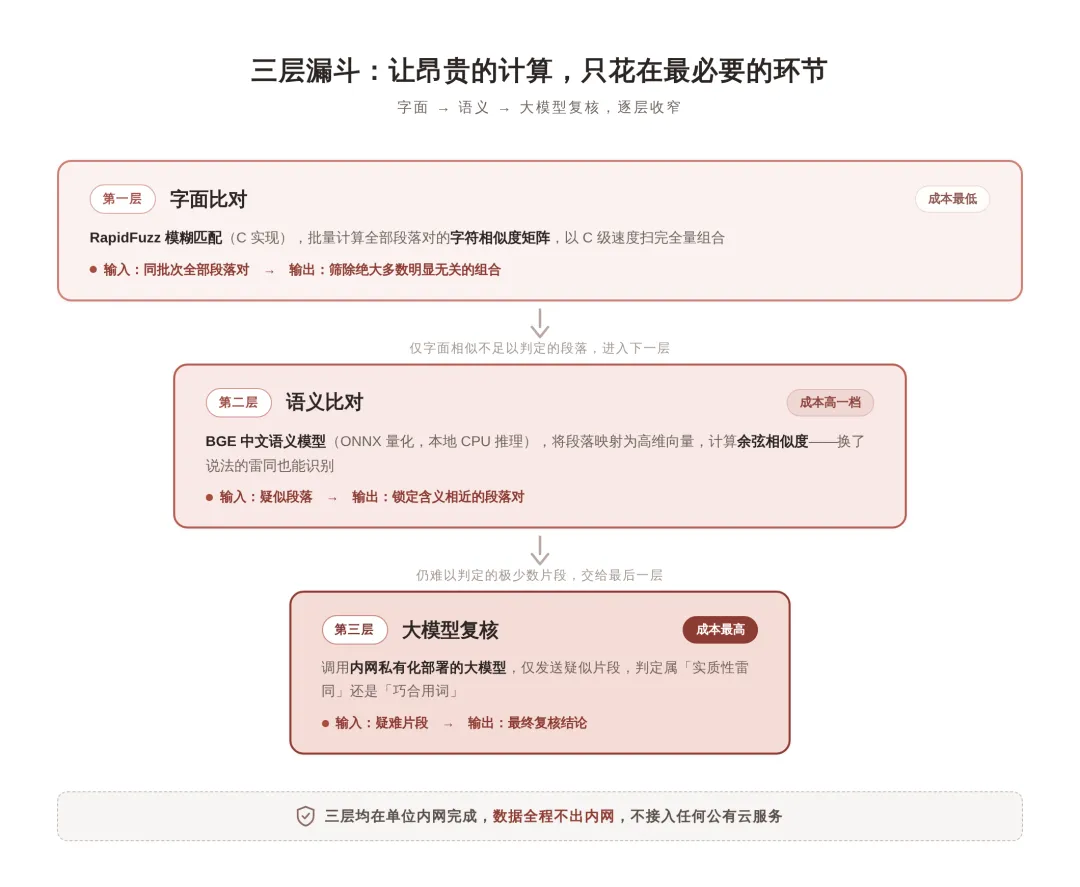
图 1 三层漏斗:逐层过滤,逐层升级成本
三、技术方案:数据不出内网
鉴于所处理文档的敏感性,方案自始至终坚持纯内网部署,三层各有分工:
●字面层:模糊匹配算法(RapidFuzz),以 C 实现批量计算相似度矩阵;
●语义层:开源中文语义模型(BGE),转换为 ONNX 量化格式后在本地 CPU 推理,将段落映射为高维向量并计算余弦相似度;
●复核层:调用内部私有化部署的大模型,仅发送疑似片段,由其判断属「实质性雷同」还是「巧合用词」。
模型文件随系统一同部署于安装目录,模型调用端点在代码层以白名单方式固化,前端与配置接口均不可修改。数据全程不出内网。
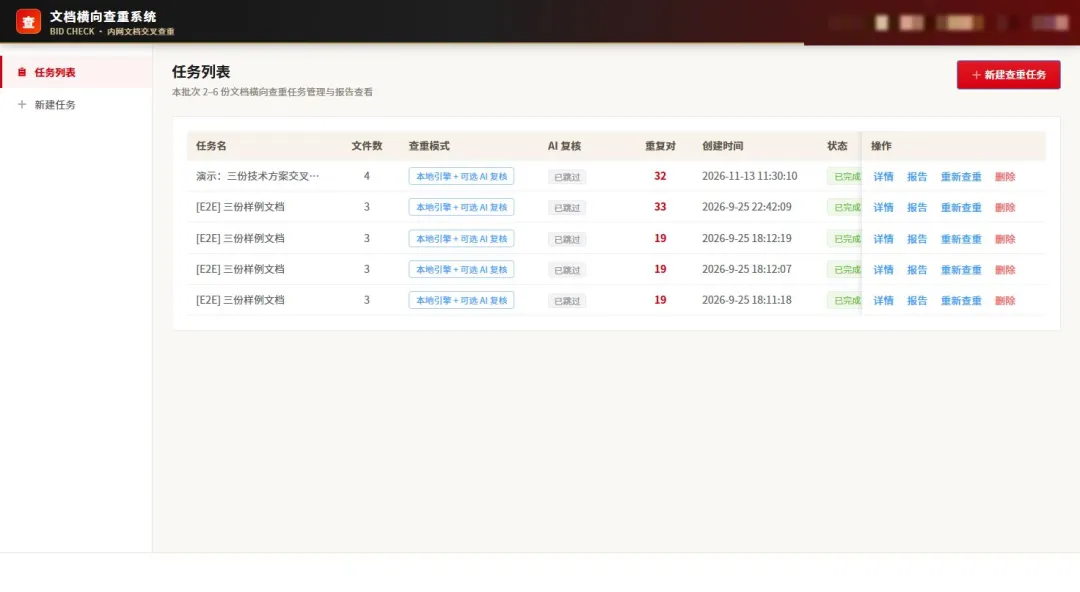
图 2 任务列表:上传文档后自动执行解析、字面查重与语义查重(演示样例数据)
四、四个坑,与一次「404 惊魂」
开发过程并非一帆风顺。下面这几个问题,每一个都值得记下来。
坑一:报告归属错位
初版报告曾出现比对对象与实际展示段落不一致的情况。经排查,原因为排序去重所用的键被下游逻辑误读为段落归属标识。
字段命名相同,不代表语义相同——跨模块复用数据结构时,必须明确契约。 |
坑二:打包后模型目录丢失
分析发现,PyInstaller 打包的资源收集阶段会先清空整个输出目录,放置于其中的约 312MB 模型文件随之被删除。现流程改为:打包前将模型目录移出,构建完成后再复位。
坑三:压缩包兼容性
Windows 系统工具压缩的发布包,其内部路径分隔符为反斜杠,不符合 ZIP 规范,在部分平台解压时产生大量异常条目。后改用标准库重新打包,并增加分隔符校验。
坑四:调试脚本误杀进程
在 PowerShell 中以管道截取命令输出时,「取前 N 条即断流」的语义会终止上游进程。此后调试统一改为将输出重定向至文件后再读取。
番外:一次「404 惊魂」
另有一次颇具代表性的经历:更换模型网关后,端口连通、页面正常,但接口调用返回 404,页面显示「Welcome to Higress」——网关在运行,路由未配置(主因是测试中无法自主打开VPN)。
「网络可达」与「服务可用」是两个层面的问题,部署验证须以真实业务请求为准。 |
五、性能优化:从十余分钟到四分钟
初版功能完整但性能欠佳。优化围绕两个原则展开:
减少计算
●字面比对仅计算「不同文档之间」的组合——同一文档内部的比较不产生价值;
●语义编码前先按归一化文本去重,重复出现的模板句、表头仅推理一次,实测节省近一半;
●批量推理按文本长度分桶,避免短文本随长文本补零浪费算力。
并行化
●大模型复核由串行改为多路并发;
●全量模式的块对并发度由 3 提升至 6,并可通过环境变量按网关承载能力调整。
此外修正了一处截断策略:当块对数超出上限时,原实现按生成顺序截断,可能遗漏靠后章节的真实重复;现改为按块级相似度排序后保留前 N 对,同样的调用规模下命中更准。
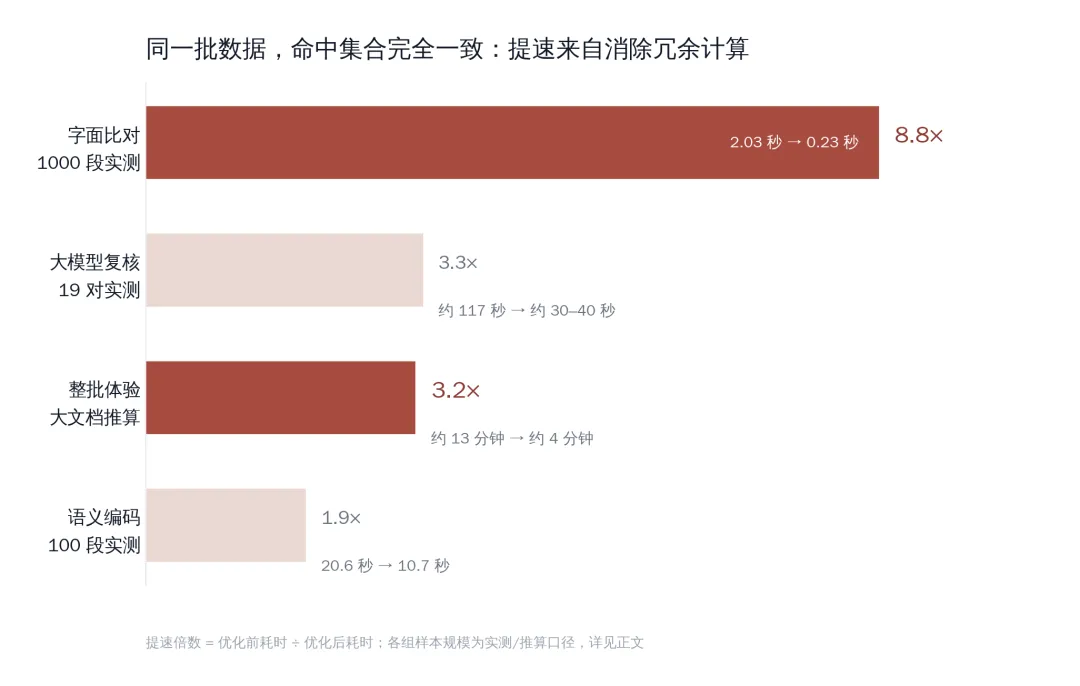
图 3 优化前后耗时对比:提速来自消除冗余计算
表 1 各环节优化前后耗时(实测/推算)
环节 | 优化前 | 优化后 |
字面比对(1000 段小样本实测) | 2.03 秒 | 0.23 秒 |
语义编码(100 段小样本实测) | 20.6 秒 | 10.7 秒 |
大模型复核(19 对实测) | 约 117 秒 | 约 30–40 秒 |
整批体验(几份大文档,推算) | 约 13 分钟 | 约 4 分钟 |
上述优化前后,使用同一批数据逐项比对,命中的重复集合完全一致——性能提升来自消除冗余计算,而非降低判定标准。
六、系统长什么样
系统对每处重复标注出处:Word 文档标注「章节与段落序号」,PDF 直接标注页码,可凭编号快速定位原文。
报告提供网页交互版、Word 归档版与 Excel 台账版三种格式,分别对应查阅、存档与筛选场景。
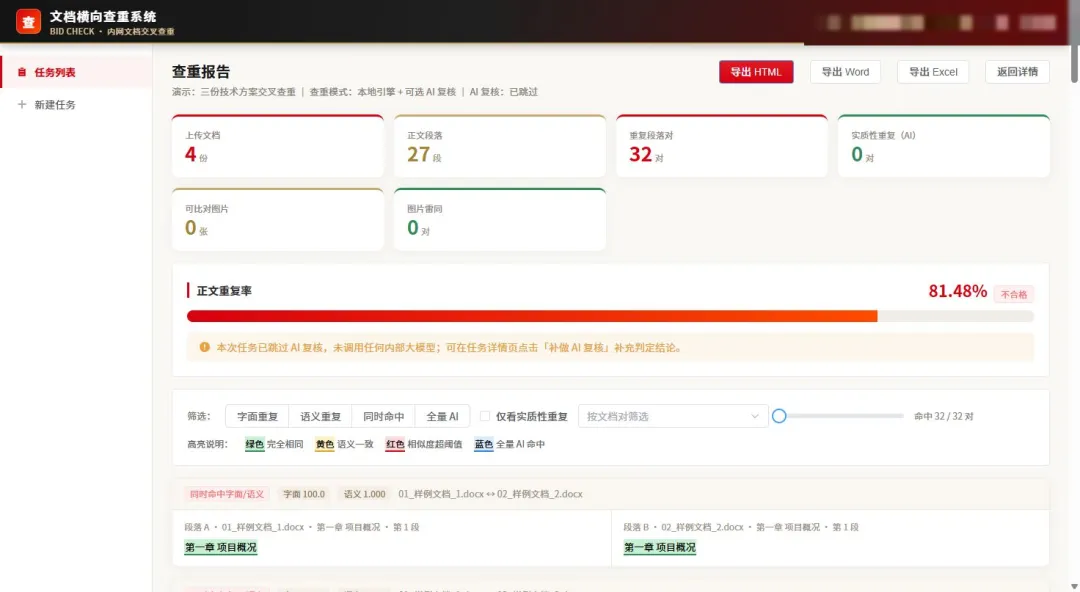
图 4 报告总览:重复率与判定等级一目了然(演示样例数据)
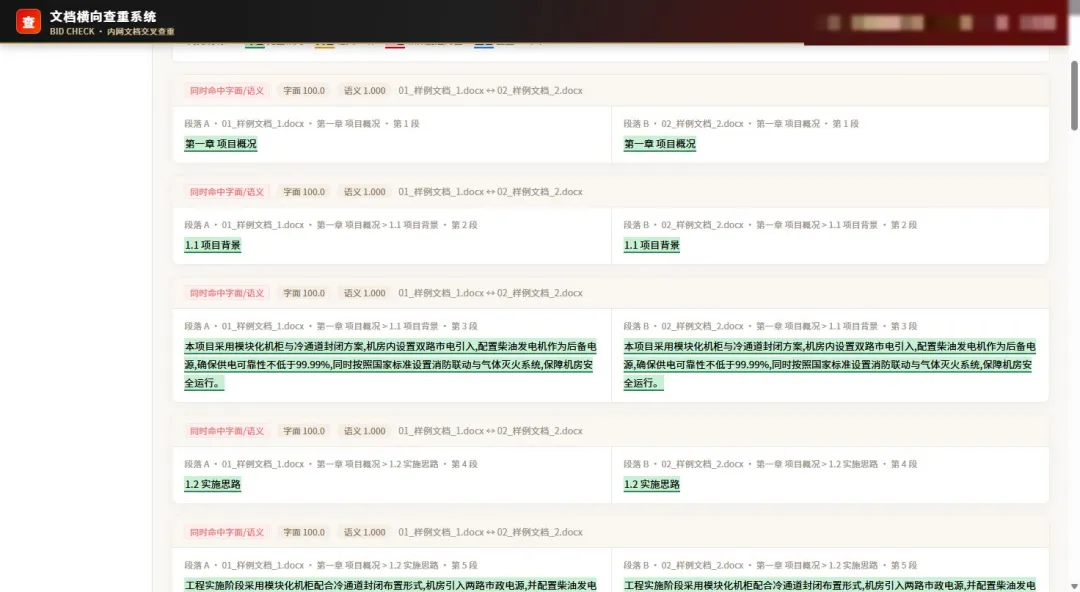
图 5 明细卡片:两段原文对照、重复句高亮、出处精确到章节段落(演示样例数据)
七、它能做什么,不能做什么
需要强调,该系统的定位是「编制过程中的独立性与质量自查工具」,而非「抄袭判定工具」。
●其一,系统仅提示「内容相似」,不对「何者为源」下结论。文字相似可能源于对同一份国家标准、行业通用条款的正当引用,最终判断须由专业人员作出。
●其二,数据全程在内部网络流转,不接入任何公有云服务。
●其三,报告措辞采用「疑似重复」「建议人工复核」等克制表述。
工具的价值在于把人从机械检索中解放出来,判断权始终在人。 |
八、写在最后
从一句需求到可用的 v5.2 版本,这一开发实践最大的收获并非性能指标本身,而是将一类重复性人工劳动转化为可复现、可审计的自动化流程。
同事试用后的评价是:
「以前要一个下午的工作,现在几分钟就能拿到结果。」
如果你在工作中也存在类似的重复性比对需求,不妨尝试将它转化为一个自动化工具。
你的工作中还有哪些「靠人肉硬扛」的重复劳动?欢迎在评论区聊聊。
说明:本文为开发过程纪实,所有界面截图均为脱敏演示样例数据;系统仅部署于内部网络,不连接公有云服务。