ARTICLE · 1373588
发票批量识别进 Excel:本地跑 PaddleOCR-VL,1000 张 1.6 元
发票批量识别进 Excel:本地跑 PaddleOCR-VL,1000 张 1.6 元
一张发票敲进 Excel,熟手两分钟。1000 张就是 33 个小时,按 50 元一小时算 1650 元。这是很多小公司每月月底的真实开销。
用本地 OCR 跑,1000 张的 GPU 成本是 1.6 元,加人工抽检 10% 的时间,总共 3.7 小时、约 200 元。
差的不是工具贵不贵,是有没有人告诉你怎么装。
先把账算干净
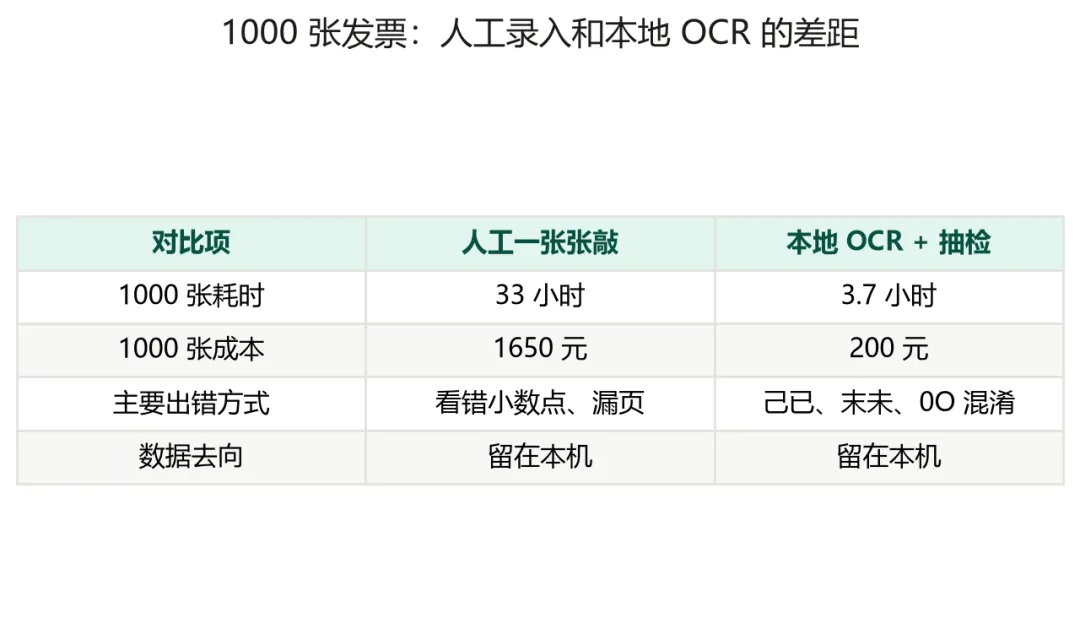
人工那边:一张 2 分钟含核对,1000 张 33 小时,1650 元人工。
OCR 那边:单张 1.1 秒,1000 张 18 分钟;抽检 10% 即 100 张,每张看 2 分钟,3.3 小时。合计 3.7 小时。GPU 成本按公开基准是每 1000 页 0.2214 美元,约 1.6 元(ImageToTable 2026 年 8 月八引擎基准,按 0.76 美元一小时算)。
抽检那一遍不能省,原因下面讲。
选哪个模型:PaddleOCR-VL-1.6
PaddleOCR-VL-1.6 只有 0.9B 参数,2026 年 5 月 28 日发布,Apache 2.0 协议,商用不用授权。在 OmniDocBench v1.6 这个文档解析榜上得分 96.33,同榜单 Gemini 3 Pro 是 92.91,GPT-5.2 是 86.59。
一个不到 1B 的模型压过两个前沿大模型,这件事本身就说明文档解析不需要通用智能,需要的是版面理解加字符识别这两件专门的事。
注意一句:它不是第一名。 同一个榜单上 TeleOCR 96.91、OvisOCR2 96.47 都更高。所以准确说法是前三,不是最强。
选它的理由是另外两条:模型小,消费级显卡能跑;输出直接给 JSON 和 Markdown,Markdown 里连表格都还原好了,财务要的正是表格。
三步装起来
第一步,装环境。有 N 卡的话装 GPU 版,CUDA 12.6 对应的包是 paddlepaddle-gpu 3.2.1,然后装 paddleocr 的 doc-parser 组件,版本要 3.6.0 以上。
第二步,调模型。代码里把 pipeline_version 设成 v1.6,加载 PaddleOCR-VL,传图片路径进去。返回结果里既有 JSON 也有 Markdown,把 JSON 存下来喂给下一步,把 Markdown 存下来给人看。
第三步,接 Excel。JSON 里按字段取日期、发票号、金额、税额、供应商、品名,用 pandas 拼成一张表写成 xlsx。这一段二十行代码,可以让 AI 帮你写,把 JSON 样例贴进去说清楚要哪几个字段就行。
用 Windows 的话有一条要注意:官方模型卡建议在 WSL 或者 Docker 里跑,原生 Windows 装 Paddle 的 GPU 版容易卡在依赖上。别在这上面耗时间,直接开 WSL。
准确率这件事,别信宣传页
老版本有个坑值得说清楚。PaddleOCR 2.7 的 ch_PP-OCRv4 模型,拿去识别发票和合同扫描件,1000 张测试集上字符准确率只有 82.3%(陆零云 2026 年测试)。
错得最多的是三组字:己和已、末和未、数字 0 和字母 O。这三种错最阴,因为看起来对,金额栏一个 0 看成 O,整张表就废了。
更麻烦的是整行漏检。表格线和印章遮挡的位置,整行识别不出来,备注那一栏直接消失。你不逐张看,根本发现不了。
三处预处理能把准确率从 82.3% 拉到 93.7%:
代价是单张从 0.42 秒变成 1.1 秒。批量跑完全能接受。
复核规则:只查三类字段
93.7% 意味着 1000 张里有 63 张会出错。全查等于没省时间,所以要定规则。
我的做法是只死盯三类字段,其余抽检:
剩下的供应商名称、品名、数量,抽 10% 看就行,错了不影响申报,改起来也快。
一句话的结论
月发票量不到 200 张的公司,别折腾这套,人工两三天就干完了,装环境的时间比省下的还多。超过 500 张、而且每个月都有的,值得花半天装一次,之后每个月省 30 个小时。
问题留给你:你公司现在月底是谁在录发票,她一个小时的成本按多少算?