ARTICLE · 1393637
一个 App 打通数据库、SSH、终端和 AI,这个 Rust 开源神器有点东西
你是不是也有过这种体验:手头开着七八个窗口,Navicat 在导数据、Xshell 连着服务器、文件管理器开着传文件、浏览器里还挂着一段 AI 对话,切来切去晕头转向。等你终于搞明白自己要干什么,一杯咖啡已经凉了。
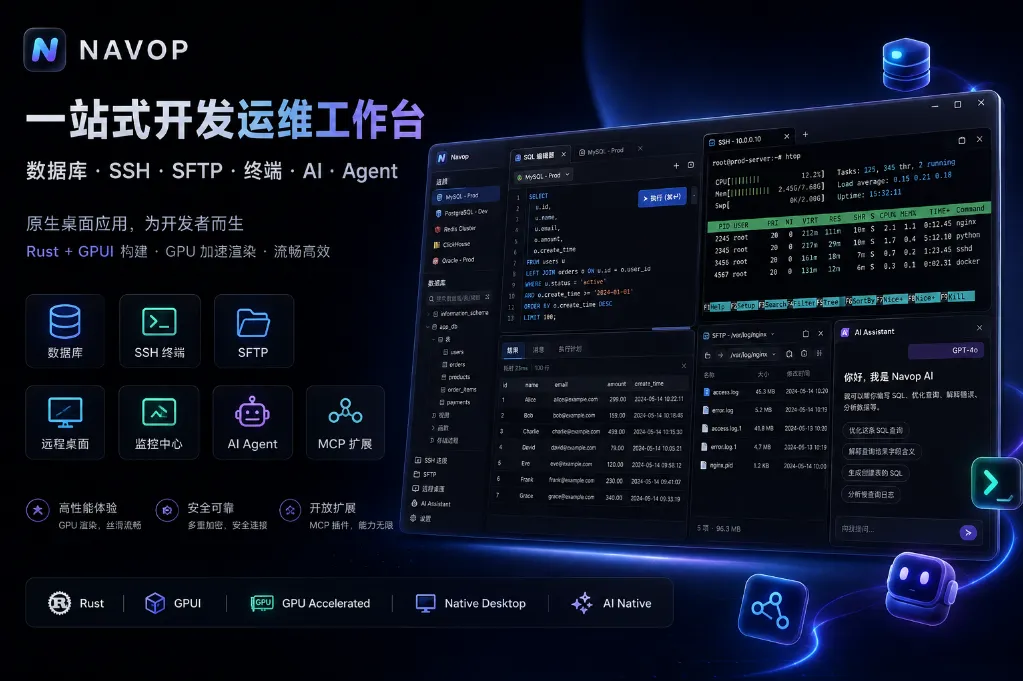
今天要聊的这个开源项目,就是想把这些窗口「收进一个门」里。它叫 Navop,一个基于 Rust 和 GPUI 构建的原生桌面应用。
它的自我介绍其实很朴素:一套原生内核,三个应用。听起来像营销词,但往下看你会发现,它确实是这么拆的。
项目亮点
这个项目最抓人眼球的,是它把「重」和「轻」这件事想明白了。很多工具是越做越臃肿,什么都往里塞,结果启动一次要等半天。Navop 反着来,把一个大而全的东西拆成了三个能并排安装、互不干扰的产品。
🚀 三个产品,同一个版本号一起发
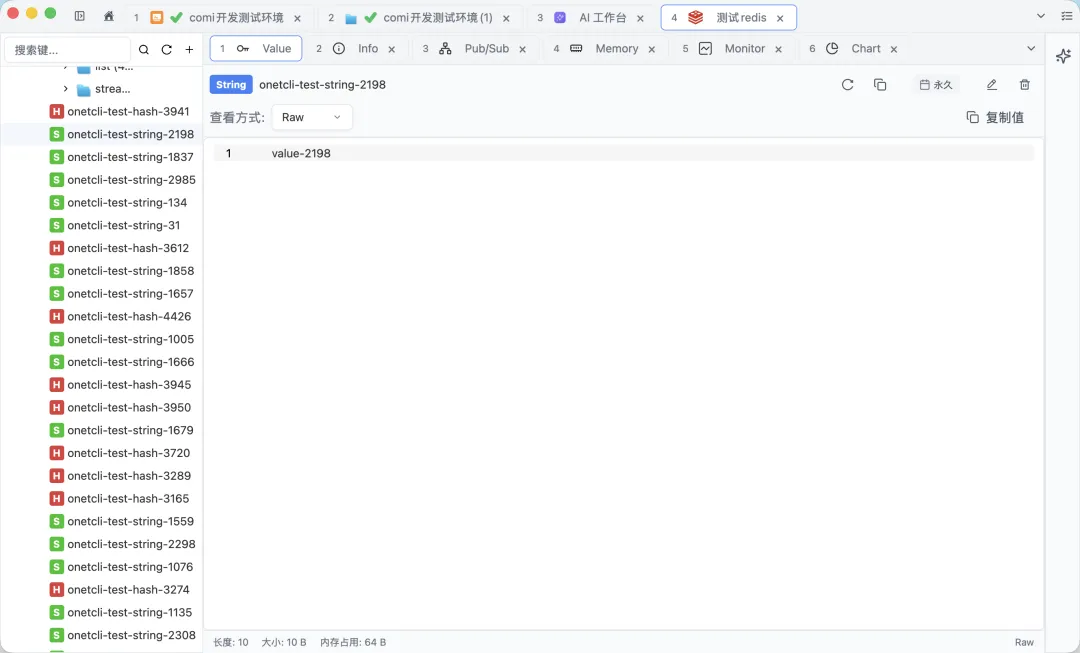
Navop 全量版:数据库 + SSH/SFTP + 终端 + 远程桌面 + AI,全家桶 Navop Shell:专注远程运维,SSH/SFTP、本地终端、端口转发、RDP/VNC Navop Data:只干数据这摊事,PostgreSQL、MySQL、SQLite、SQL Server、Oracle、ClickHouse,还有 Redis 和 MongoDB 视图
三个产品各有独立安装包、独立数据目录、独立钥匙串条目。图标是「N + 领域脚标」的体系,托盘和退出提示都会写明是哪个产品。这点很贴心,不至于开三个窗口自己都分不清。
🖥 不套 WebView,纯原生渲染
很多所谓「桌面应用」本质上是套了个浏览器壳,内存占用高、滚动卡顿、快捷键还打架。Navop 用的是 GPUI 加 Rust,GPU 加速渲染,没有 WebView 那一层。用一个生活类比:别人是把网页塞进展柜里假装是实物,它直接给你一件真家具。
🗄 多协议数据库一站管理
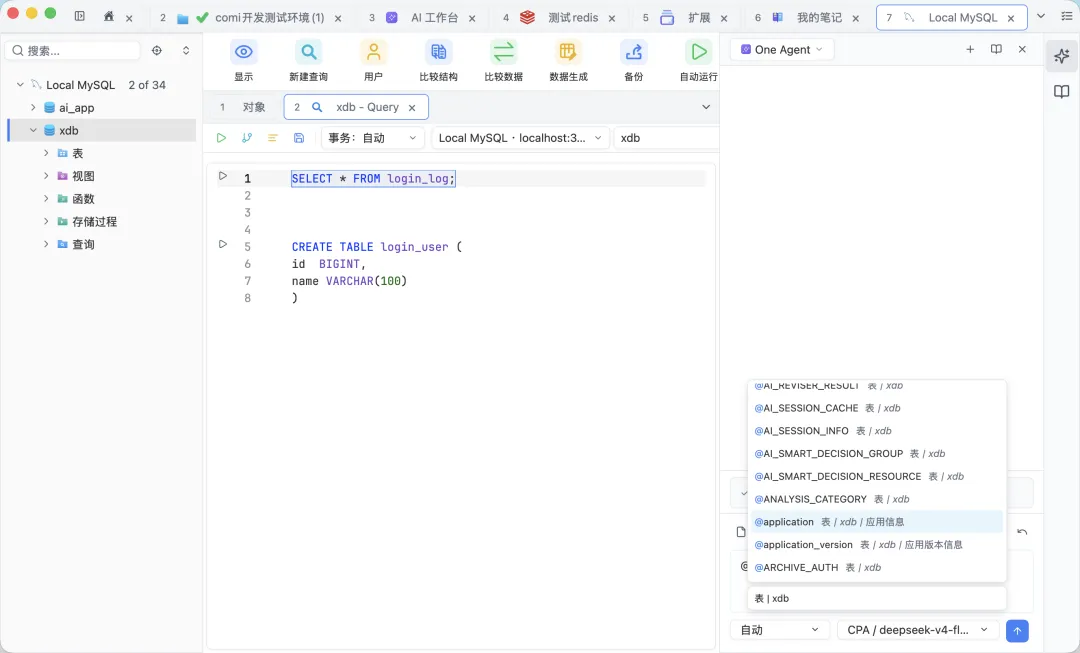
原生支持 MySQL、PostgreSQL、SQLite、DuckDB、ClickHouse、SQL Server、Oracle,Redis 和 MongoDB 也有专门的视图。新建连接还恢复了两步向导:先选类目(全部 / 数据库 / 国产数据库 / 时序数据库 / NoSQL / 中间件 / 终端),再选具体卡片,比一上来甩你一脸协议图标要友好得多。
🧩 插件平台整体换代
插件从「一页一个包」收成了「一个扩展一个 app」,页面用 TSX 编写,能力按扩展清单收敛,越权调用直接拒绝。更妙的是,插件可以把自己的能力声明成 AI 工具(contributes.tools),内置 Agent 和外部 MCP 都能调用,默认关闭,设置里按扩展逐个开关。
🤖 内置 AI,能真正动手操作资源
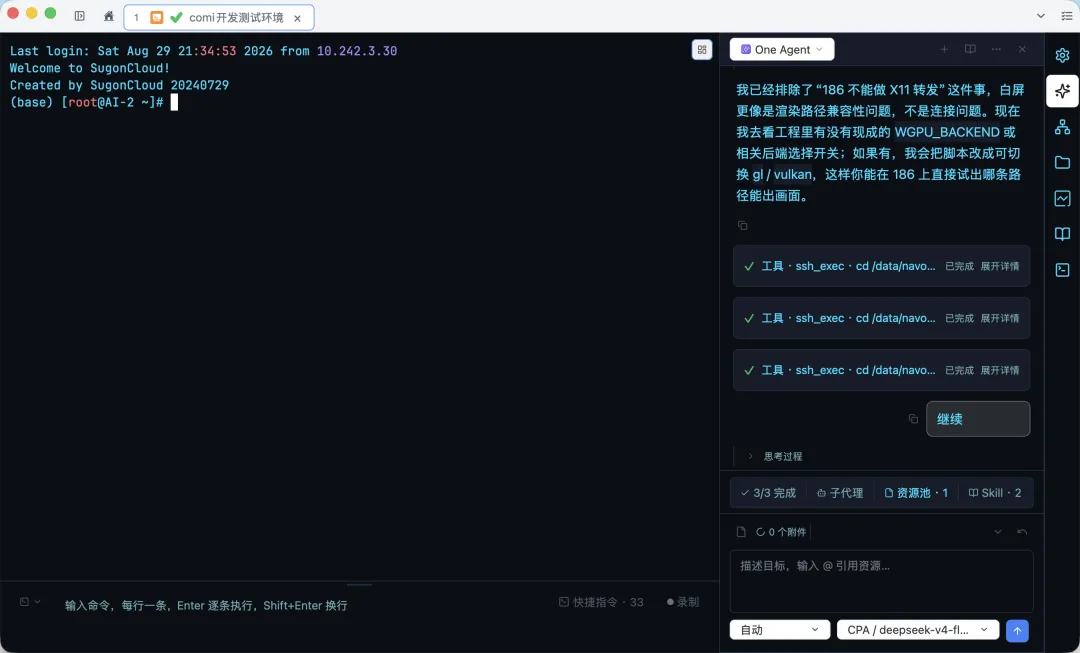
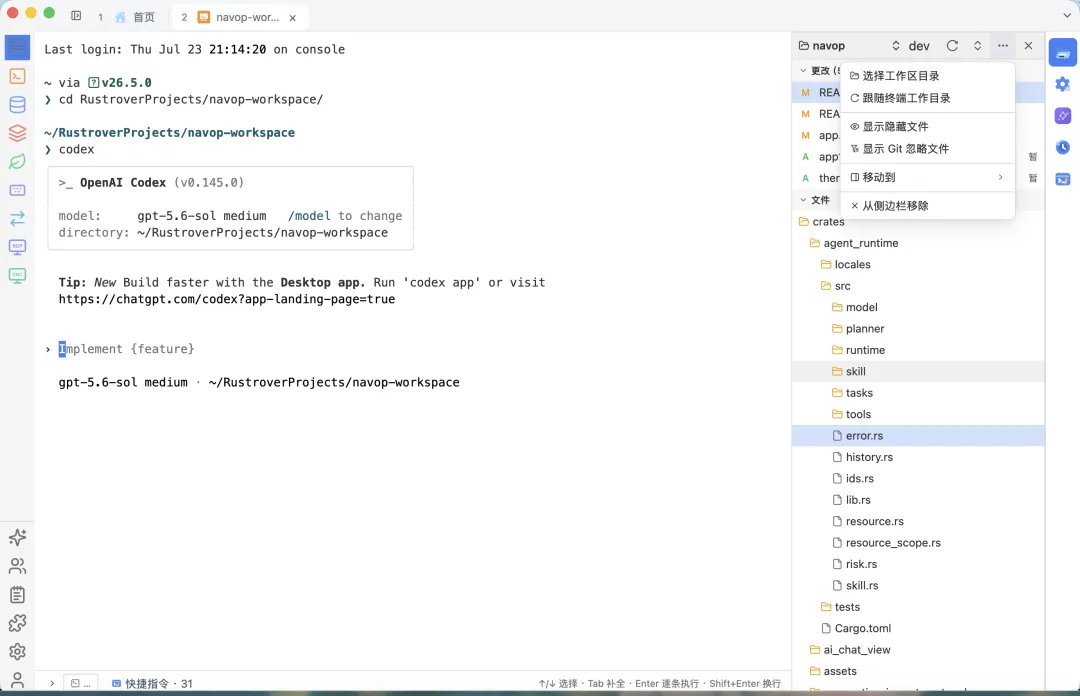
这不是那种只会聊天的装饰性 AI。项目里有一整套 agent_runtime,参考 Codex 的运行时骨架,模型驱动,按需调用业务工具。简单问题直接回答,复杂任务它自己调用 update_plan 维护一张 checklist,面板就挂在输入框上方。
解决什么痛点?
说个真实场景。
假设你是一个后端或者运维,某天线上报错,你打开工具箱:先用数据库客户端连生产库查一条数据,发现某张表的字段类型不太对,得改;改完要登录服务器看看日志,于是切到 SSH 工具,敲命令,翻日志;日志里提到某个文件有问题,再开 SFTP 把文件拖下来看一眼;看完想写个脚本批量处理,又得开个终端。
四个工具,四套连接配置,四次输密码。中间你还得记住哪个窗口连的是测试环境哪个是生产环境,手一抖就可能在生产库上执行了一条 DELETE。
Navop 想做的,是把这一串动作串在同一个会话里。
它的 AI 助手有一条清晰的循环:用户输入,模型流式采样,如果模型要调用工具就去执行,把结果写回历史,再继续采样,直到给出最终回答。而工具背后连接的,正是你当前会话里能操作的资源——SSH 主机、MySQL 实例、Redis、终端。
换句话说,你可以在一个对话里说「帮我看看这个库这张表有多少行,顺便去服务器上确认下磁盘空间」,它能把两件事都办了,而不用你亲手切窗口。
翻到项目里数据库比较功能的开发总结,还有一处细节特别值得说。它做了一个「双引擎」:数据比较和结构比较完全独立。更重要的是,所有破坏性操作默认不选中:
这个设计就像飞机上的弹射座椅——平时用不上,但真要用的时候,它替你挡住了一次灾难。DROP 类操作默认不勾选,还带警告提示,另配有 SQL 注入防护。
还有一个细节,SSH 登录方式里新增了「无认证」这一项,服务器监控加了 NVIDIA GPU 和昇腾 NPU 视图,终端侧栏还能写「连接笔记」记录服务器信息。这些都是踩过坑的人才会想到的功能。
手把手教程
先说明一点:这是一个桌面应用,不是纯库,所以「安装」这一步是下载安装包,而不是 pip install。
➤ 第一步:去 Releases 下载
打开项目的 Releases 页面,根据你的系统选择对应产物。三个产品是分开的:
想要全家桶,装 Navop 只做远程运维,装 Navop Shell 只做数据管理,装 Navop Data
三个可以并排装,数据目录和钥匙串条目互相独立,不会打架。
➤ 第二步:如果你要自己编译
项目是 Rust 工作区结构,动手之前先把系统依赖装上。项目提供了脚本,这是最省事的方式:
./script/bootstrapWindows 用户用 PowerShell:
.\script\install-window.ps1装完依赖,跑起来:
cargo run -p navop如果只想跑某个产品的 shell 版本,工作区里也有对应的 crate 入口。项目根的应用 crate 只负责「装配」:选定产品身份、领域包与初始化流程,主页、设置、标签、AI、Notes、团队、扩展、凭据库、云同步、托盘、更新这些能力全部来自共享的外壳 crate。
这句话翻译成人话就是:三个产品共用一套发动机,只是外壳配置不同。保养一次,三个都受益。
➤ 第三步:新建连接打开应用后走两步向导:
1.先选类目:全部 / 数据库 / 国产数据库 / 时序数据库 / NoSQL / 中间件 / 终端2.再选具体卡片,填连接信息
已安装的外部数据库驱动(比如国产数据库)会自动接回向导。Navop Data 首次启动会检查驱动,可以直接在应用内安装。
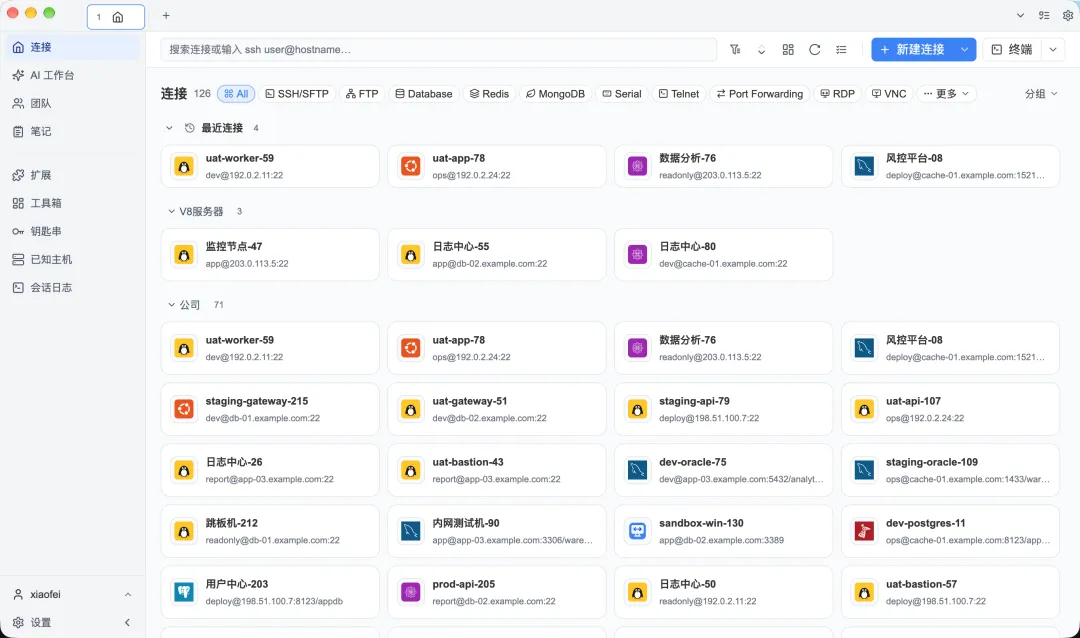
连接建好后,首页和连接树都能手动拖拽排序。设置里新增了「手动排序(拖拽调整)」选项,工具栏还支持导出连接与分组迁移包,换设备导入时分组层级会保留。这个功能对经常换电脑的人来说是救命的。
➤ 第四步:玩转终端
终端这块有几个细节值得试试:
-多行粘贴可以先「检查并编辑」再发送,也可以直接「逐行发送」,避免一不小心把整段脚本拍进去-行时间戳精确到毫秒-标签页可以「断开连接」并保留会话内容,SSH 标签页能直接打开 SFTP 文件视图-支持 X10 鼠标协议,在 htop 这类老式 TUI 里点表头排序、点选进程都恢复正常了
➤ 第五步:让 AI 帮你干活
每个插件标签页都自带 AI 侧边栏,右侧浮钮,默认收起,可以拖宽。它会自动带上当前扩展、路由、连接和可用工具。页面还能主动把当前状态上报给 AI。
插件可以声明自己的 AI 工具能力,配置长这样:
"contributes": {"tools": [ ... ]}默认是关闭的,设置里按扩展逐个开关,也能单独禁用某个工具。调用带超时、结果上限,高风险操作还会要求确认。
➤ 第六步:数据库比较(如果你用了这个功能)
项目里有一个完整的数据库比较模块,核心引擎和 UI 层是分开的。从开发总结看,核心引擎层已经完成,包含数据比较和结构比较两个引擎,15 个单元测试全部通过,编译零错误零警告。
使用时,破坏性操作默认不选中,这是安全底线。同步计划的生成也做了 SQL 注入防护。如果你要比较两张表,先看清楚哪些操作是默认勾上的,再决定要不要手动加上那些带警告的。
同类项目对比
市面上的数据库 / 运维工具不少,各有各的路数。这里拿几个常见方向做个横向对比,维度是功能、性能、生态。
需要坦白一点:Navicat 和 DBeaver 在数据库管理这个单点上耕耘多年,功能深度和稳定性是实打实的。Navop 的优势在于「整合」——它不指望在某个单点上打赢所有老牌选手,而是解决「工具太多、来回切换」这个问题。
至于插件生态,它走的是另一条路。扩展用 WASM 组件承载,连接导入器支持 DBeaver、Navicat、Navicat Lite、Termius 这些常见工具的数据迁移。也就是说,你之前积累的连接配置,不用手抄一遍。
还有个细节挺有意思:项目里有专门的 IPC 数据库驱动规范,driver.json 声明能力,JSON-RPC 走本地传输,语言不限,Rust、Node.js、Python 都行。这意味着你熟悉的数据库只要有 SDK,理论上都能接进来。这就像给插座装了个万能转换头,什么插头都能插。
最后聊两句
看完这些代码文件和文档,我最大的感受是:这个项目是「想清楚了才动手」的类型。
它没有一上来就堆功能,而是先把产品身份拆清楚(三个产品)、把契约定清楚(driver.json、WIT、协议模型)、把安全底线划清楚(破坏性操作默认不选)。这些东西用户在界面上看不见,但正是它们决定了一个工具用三个月之后会不会变成一堆不敢碰的祖传代码。
项目里有句话挺打动我——「桌面端正式拆成三个产品、同一个版本号一起发」。这背后其实是一种取舍:承认自己不可能讨好所有人,干脆把选择权交出去。想轻装上阵的装 Shell,天天跟数据打交道的装 Data,什么都想要的装全量版。
如果你恰好也是那种「窗口开太多会焦虑」的人,不妨去项目主页看看。装上试试,也许能省下你每天切窗口的那十几分钟。积少成多,一年下来也是好几个钟头。
毕竟,省下来的时间,够你多喝好几杯不凉的咖啡了。
github项目地址: https://github.com/feigeCode/navop.git