 夜雨聆风
递归智能:AI 的下一站,是学会改造自己
2025 年 10 月,Meta 对 AI 部门裁员约 600 人,受影响的包括 FAIR、产品 AI 和基础设施团队。
在这场裁员里,一个名字格外显眼:田渊栋。
他曾是 Meta FAIR 的研究科学家总监,也是强化学习、围棋 AI 和大模型研究圈里非常硬核的人物。被裁当天,他在 X 上写得很克制:自己和部分团队成员受到了影响。但随后,他又补了一句更尖锐的话:
真正应该为问题负责的人,并不是被裁掉的人。
几个月后,另一条新闻出现了。
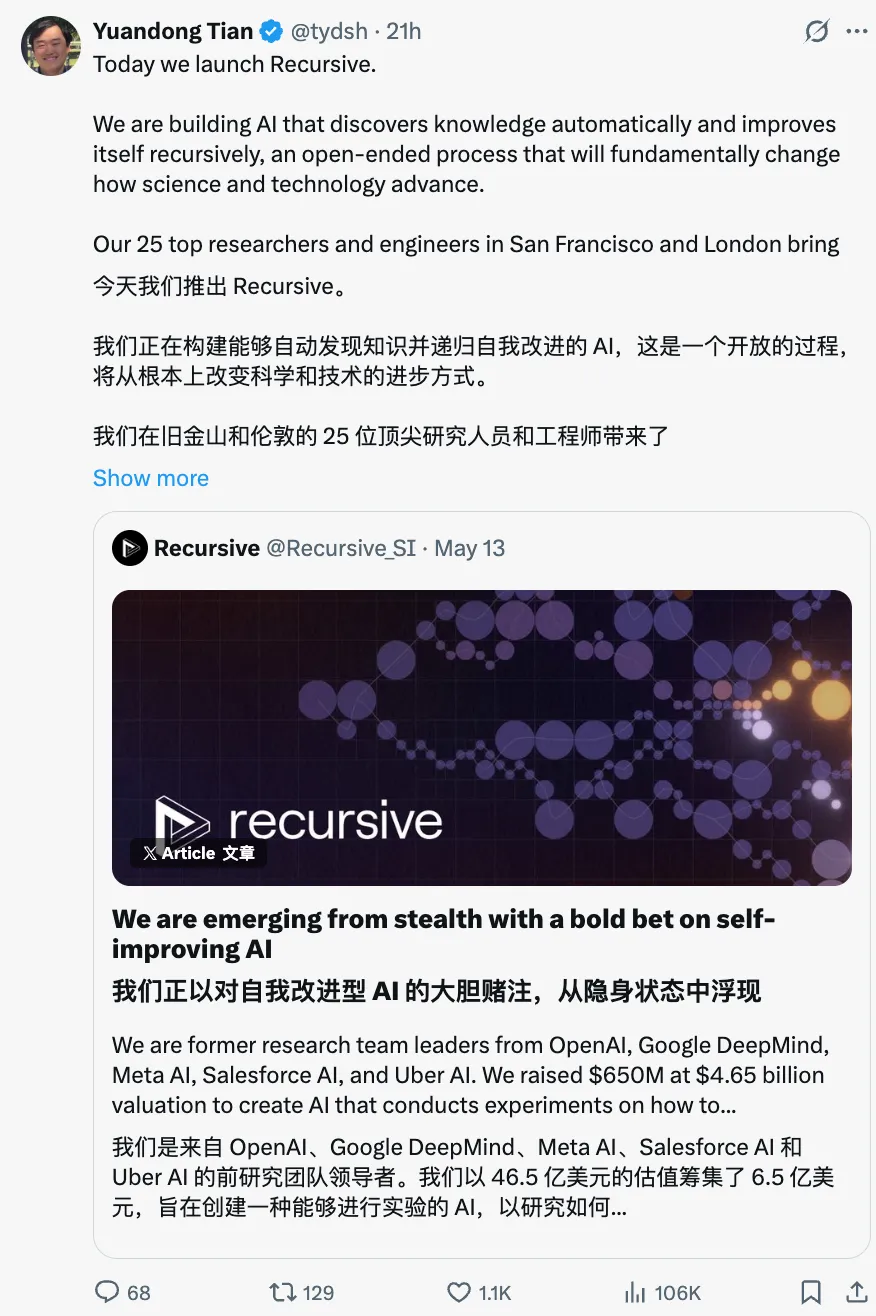
田渊栋加入 Recursive Superintelligence,成为联合创始人之一。这家公司由 Richard Socher 领导,团队里还有 Jeff Clune、Alexey Dosovitskiy、Tim Rocktäschel、Caiming Xiong 等一批顶级 AI 研究者。GV 官方文章披露,Recursive 早期融资 6.5 亿美元,估值 46.5 亿美元。
这不是一笔普通融资。
因为 Recursive 押注的不是"再做一个更强的聊天机器人",而是一个更底层的方向:
让 AI 参与制造下一代 AI。
这就是递归智能。
01递归智能到底是什么?
递归智能,听起来很玄,其实可以用一句话理解:
过去是人类改进 AI;未来可能是 AI 改进 AI。
今天的大模型已经能写代码、读论文、跑实验、分析结果。那下一个问题自然出现了:
如果 AI 能写普通软件,为什么不能写训练 AI 的软件?
如果 AI 能发现代码 bug,为什么不能发现模型训练流程里的 bug?
如果 AI 能设计测试用例,为什么不能设计新的 benchmark?
如果 AI 能优化一个系统,为什么不能优化自己所在的系统?
这就是递归智能的基本逻辑。
它不是简单地让 AI 帮程序员写几行代码,而是把 AI 研发拆成一个闭环:
发现自己的能力短板;
提出新的改进假设;
设计实验和评测;
修改模型、数据、训练流程或推理系统;
再用结果指导下一轮改进。
一旦这个闭环能够稳定运转,AI 的进步就不再完全依赖人类研究员的灵光一现,而会变成一种可以自动加速的研发机器。
02它和普通 AI Agent 有什么不同?
很多人会问:这不就是 AI Agent 吗?
不完全是。
普通 Agent 的目标,是帮人完成任务。比如写报告、查资料、改代码、做客服。
递归智能的目标,是让 AI 改进 AI 系统本身。
前者是在应用层提高效率;后者是在研发层改变生产方式。
这就像区别于:
让 AI 帮你开车;
和让 AI 参与设计下一代发动机、下一代道路系统、下一代交通规则。
它改变的不是某一个产品功能,而是技术进步的来源。
如果说过去十年 AI 的主线是 Scaling Law,也就是更多数据、更多参数、更多算力,那么递归智能想回答的是另一个问题:
当继续堆数据和算力的边际收益下降之后,AI 还能不能自己找到新的增长曲线?
03为什么是现在?
递归智能不是今天才有人想到。
"自我改进的 AI"几十年前就存在于科幻、控制论和 AGI 讨论里。过去它之所以一直停留在概念层,是因为缺了几个关键条件。
第一,AI 以前不会可靠地写代码。
现在最强模型已经能承担一部分软件工程工作,尤其是在目标清晰、测试明确、代码边界明确的任务上。
第二,研发流程以前很难自动化。
现在有了更成熟的自动评测、合成数据、实验管理、代码执行环境和 Agent 工具链,AI 不只是能"想",还可以真的"试"。
第三,行业需要新的增长路径。
预训练 Scaling Law 仍然重要,但越来越贵。继续把模型做大,当然还能进步,但每一步都要吞下更大的数据、算力和资本。
所以行业开始寻找新的杠杆。
不是只问:我们能不能训练一个更大的模型?
而是问:我们能不能训练一个更会做研究的模型?
这就是递归智能成为焦点的原因。
04顶级研究者为什么都盯上这件事?
Recursive 不是孤例。
Ilya Sutskever 离开 OpenAI 后创办 Safe Superintelligence,把目标直接指向安全超级智能。
David Silver 创办 Ineffable Intelligence,押注用强化学习和自我生成经验来创造不依赖人类数据的"superlearner"。据 TechCrunch 报道,这家公司已融资 11 亿美元,估值 51 亿美元。
Anthropic 联合创始人 Jack Clark 在 2026 年 5 月的一篇文章里给过一个激进判断:到 2028 年底,出现"无须人类参与的 AI 研发",也就是 AI 系统强到能自主构建后继系统的概率超过 60%。
这些方向并不完全相同。
SSI 讲安全超级智能;
Ineffable 讲从经验中自我学习;
Recursive 讲开放式算法和递归自我改进。
但它们共同指向同一件事:
AI 的竞争,正在从"谁拥有最强模型",转向"谁拥有最快的智能生产系统"。
05真正的分水岭是什么?
递归智能真正成立的标志,不是 AI 会写代码。
会写代码只是起点。
真正的分水岭,是它能不能持续做出"可验证的有效改进"。
比如:
它能不能发现现有模型在某类推理任务上的系统性弱点?
能不能设计一个不会被轻易刷分的新 benchmark?
能不能提出一个训练改动,并在实验中稳定提升结果?
能不能判断哪些提升是真进步,哪些只是评测幻觉?
能不能在多轮迭代后,避免把错误越放越大?
这才是递归智能最难的地方。
因为 AI 改进 AI,不只是"生成代码",而是要完成完整的科学循环:提出假设、控制变量、实验验证、结果解释、失败复盘。
人类研究员最稀缺的部分,也恰恰在这里。
不是敲代码,而是判断什么问题值得问,什么实验值得做,什么结果值得相信。
06AI 的下一站
如果递归智能跑通,AI 行业的节奏会被彻底改写。
今天模型发布周期已经在压缩。过去一个大版本可能要半年到一年;后来变成几个月;现在一些团队已经开始按月迭代。
但这还只是"人类团队用 AI 工具加速"。
下一步更关键:
当 AI 可以自动发现瓶颈、自动设计实验、自动写 benchmark、自动改训练代码,迭代的主体就开始改变了。
不是人类用 AI 加速研发,
而是 AI 本身成为研发过程的一部分。
当然,递归智能不等于无限飞升。它也可能优化错目标,学会刷 benchmark,在复杂代码库里引入难以发现的错误,甚至把一次小偏差在多轮自我改进中放大成系统性风险。
所以递归智能真正重要的,不只是"更强",还有"可验证""可解释""可控"。
没有后者,递归自我改进就不是生产力飞轮,而可能是风险飞轮。
过去几年,AI 行业最重要的问题是:
我们能不能训练出一个更大的模型?
接下来几年,问题会变成:
我们能不能训练出一个会做 AI 研究的模型?
这就是递归智能的核心。
它不是让 AI 更会聊天,也不是让 AI 多写几行代码。它真正想改变的,是智能本身的生产方式。
如果说大模型让 AI 成为一种产品,那么递归智能想让 AI 成为一种研发机器。
而一旦 AI 开始参与制造下一代 AI,行业竞争就会进入一个完全不同的阶段。
真正的差距不再只是今天谁的模型更强。
而是谁的系统,能更快地产生明天更强的模型。