 夜雨聆风
跟 AI 聊了半天,第二天它全忘了
腾讯混元刚发的这个插件,想让 Agent "长脑子"
你一定经历过这种事。
跟某个 AI 助手聊了一晚上——告诉它你的口味、预算、出行习惯,它帮你做了一份完美的旅行攻略。你觉得太好了,省了大把做功课的时间。
第二天打开,白纸一张。
这事儿怪不了谁。大模型本身就是"无状态"的,每次对话都从零开始。各家产品做了各种补丁,什么对话历史、上下文窗口,本质上还是把聊天记录往里塞。记录多了就乱,旧的跟新的撞一块儿,到底听哪个?
腾讯混元昨天发了 Hy-Memory,专门给 AI Agent 做长期记忆的插件。我看完官方介绍之后觉得,这个方向对了——不是存更多,而是想明白记忆到底是什么。
还有一点现在大家都在竞相开发代理记忆,这很合理。权重是固定的,所以跨会话传递的内容是唯一能够累积的东西。好奇 System1/System2 分裂是如何决定什么值得保留,什么会被丢弃的。
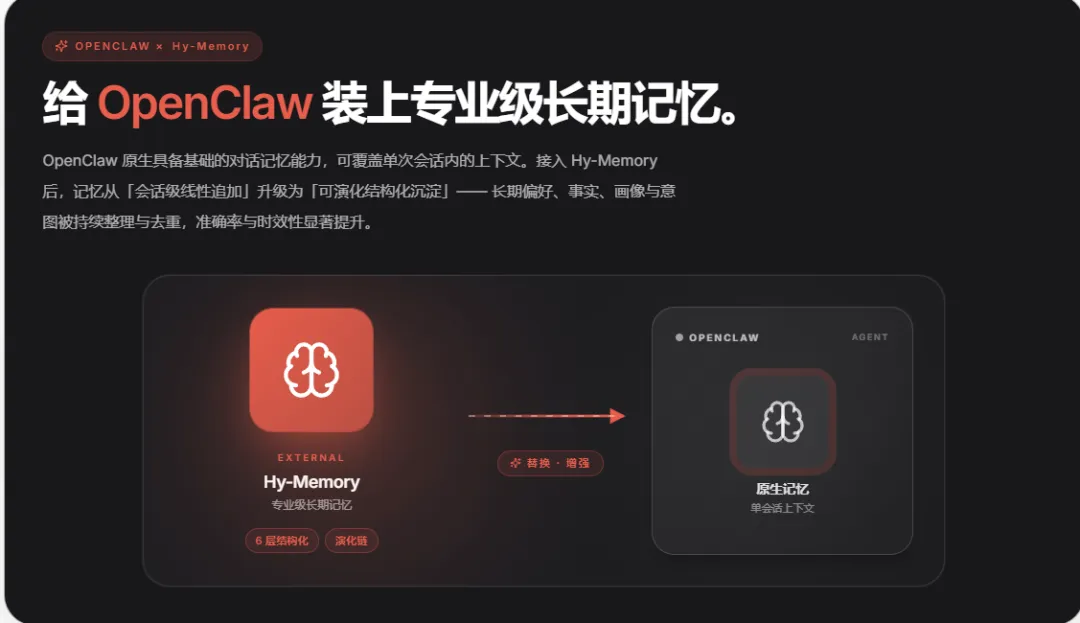
记忆不是存东西,是整理
大部分 AI 记忆方案的问题出在一个字:堆。
比如你说"我喜欢吃辣",存一条。过了俩月你说"最近胃不好改清淡了",又存一条。等到下次推荐餐厅的时候,它手上攥着两条互相打架的信息,不知道该信哪个。
人的大脑不是这么干的。
你会自然地更新认知——"哦这人以前爱吃辣,现在改口了"。旧信息不是被删掉,而是被新信息覆盖、合并,最终变成一个更准确的印象。
Hy-Memory 把这个过程拆成了六层:
打个不太精确的比方:L1 是录音笔,L2 是记事本,L3 是认识了你三年的朋友,L4-L6 是开始理解你为什么做每个决定。
这六层不是各存各的,而是一条加工流水线——新信息进来,旧的会被更新、合并甚至淘汰。不是越攒越多,而是越用越准。
两套系统:一边聊一边想
光分层还不够。人脑有两种处理模式——这个概念在卡尼曼的《思考,快与慢》里讲得很清楚。
Hy-Memory 借鉴了这个思路:
System 1 是"快思考"。你说话的同时它就在处理——每条对话必写 L1,实时抽 L2 事实和 L3 画像。毫秒级,你感觉不到。
System 2 是"慢思考"。对话结束了,后台开始干重活——从 System 1 留下的材料里抽象出 L5 心智模型和 L6 前瞻意图。有点像人睡觉的时候大脑在整理白天的记忆。
一个管实时,一个管沉淀,两条线并行。
真正厉害的:演化链
这是 Hy-Memory 最让我觉得有意思的地方。
传统记忆系统找信息靠"语义相似度"。你问"线上发行方案",它就去翻历史聊天记录里跟"发行"语义相近的内容。问题是——情绪和决定,离"发行方案"的语义距离很远。
官方给了一个很好的例子:
有个独立音乐人,之前满怀期待上了 Spotify,结果被算法归类为"背景音乐",完播率惨淡。他一气之下主动下架,只留了 Bandcamp。后来他出了黑胶,卖得不错。
现在他找 Agent 讨论"线上发行方案"。
传统方案会怎样?有的只记得"黑胶卖得好",忘了之前对线上的失望。有的虽然记得"上过 Spotify",但不知道为什么离开,于是傻乎乎地建议回到 Spotify——直接踩雷。
Hy-Memory 的做法不一样。它在写入记忆的时候就建好了因果指针——每条新记忆都带着"它取代了哪条旧记忆"的标记。检索的时候只要命中链条上任何一个节点,整条因果线自动展开。
所以 Hy-Memory 能还原出完整的"拥抱→失望→决裂→重建"故事线,然后给出这样的建议:
"如果重新做线上,核心不是'要不要上',而是'能不能找到一种不背叛你创作初衷的线上形态'。"
这才是真正理解用户。
跑分也很能打
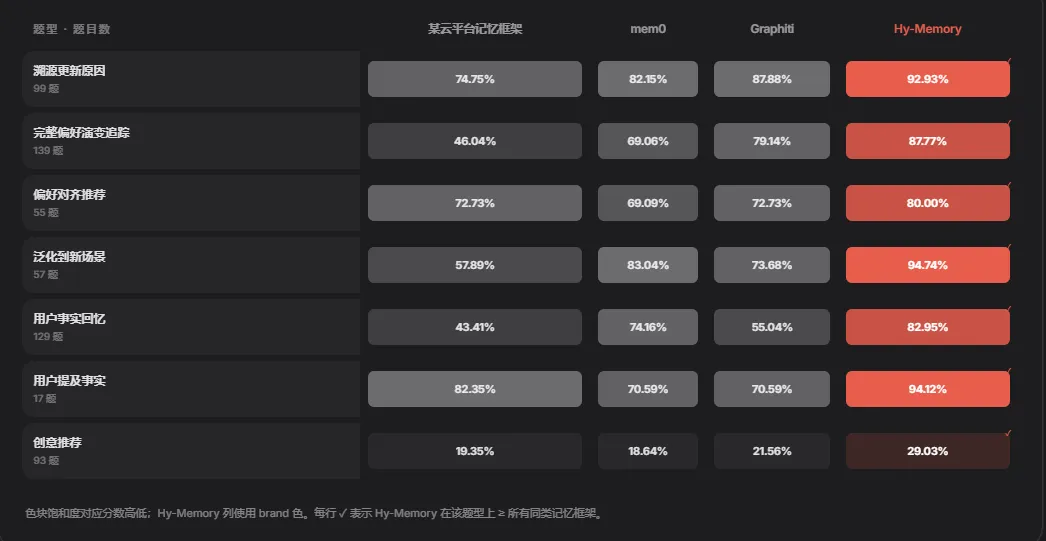
在两个公开评测基准上,Hy-Memory 都拿了同类第一:
LongMemEval:85.20%(500 题),6 个题型全部胜出。对比之下 mem0 是 47%,Graphiti 是 68%。
PersonaMem:76.91%(589 题),7 个题型逐项胜出。
更关键的是效率:写入速度是 Graphiti 的 8 倍,记忆条数只有 mem0 的四分之一,单条信息密度是 mem0 的 2.5 倍。
用更少的记忆、更快的速度,拿到更高的准确率。这个"少即是多"的思路是对的。
怎么用
Hy-Memory 现在通过 OpenClaw 插件市场分发,三档可选:
| Lite | ||
| Pro | ||
| Ultra |
一行命令装上:
class="language-bash">openclaw plugins install openclaw-hy-memory --dangerously-force-unsafe-install
LLM 可以用混元 3.0 Preview(通过 OpenRouter),Embedding 用 SiliconFlow 的 bge-m3,开箱即用。
几句题外话
AI 行业正在经历一个从"单次对话"到"长期协作"的转变。个人助手也好,客服机器人也好,工作流 Agent 也好,记不记得住你,是区分"工具"和"伙伴"的那条线。
Hy-Memory 的思路我比较认同:不是简单堆存储,而是建一套认知基础设施——让任何 Agent 都能接上一个"第二大脑"。
当然,这事儿刚起步。记忆的准确性、隐私安全、跨平台互通,都是要持续解决的问题。但方向是对的:AI 不应该只记住你说了什么,而应该理解你为什么这么说。
官网:https://memory.hunyuan.tencent.com/
接入指南:https://memory.hunyuan.tencent.com/openclaw/