 夜雨聆风
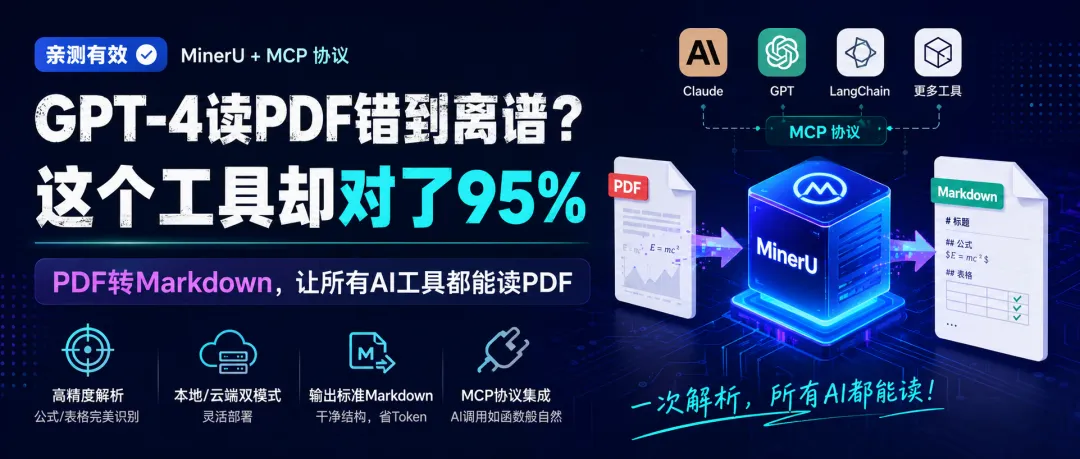
PDF变Markdown,这国产工具比GPT还准
亲测
我经常要把 arXiv 论文、行业报告、合同 PDF 喂给 AI 处理。
以前试过三种办法:直接把 PDF 路径给 GPT——扫描版读不动,公式乱码。买商业 OCR 服务——贵,而且不知道数据去哪了。自己部署 PaddleOCR——需要 GPU,我的小 VPS 扛不住。
直到遇到了 MinerU(OpenDataLab 出品),国产开源,解析精度比 GPT-4 Vision 高出一截。最离谱的是——它能以 MCP 协议直接挂到 Claude/GPT/LangChain 工作流里,AI 调用它就跟调用一个函数一样自然。
它能以 MCP 协议直接挂到 Claude/GPT/LangChain 工作流里,AI 调用它就跟调用一个函数一样自然。
下面是抄作业时间。
我为什么需要这东西
说真的,让 AI 读 PDF 是刚需。论文、合同、技术文档——这个世界还在用 PDF。但:
直接把 PDF 丢给 LLM?扫描版读不动,表格错位,公式变乱码
用商业 API?一篇论文几毛钱,批量 50 篇就几十块
自己搭 OCR?GPU 钱够买一年商业 API 了
MinerU 一次解决了四个问题:精度高、支持本地/云端双模式、输出标准 Markdown、能当 MCP 工具用。
MinerU 一次解决了四个问题:精度高、支持本地/云端双模式、输出标准 Markdown、能当 MCP 工具用。
部署:四步走
1. Node.js 环境
MinerU MCP 包需要 Node 18+。强烈建议用 Node 20+(我用 22 完全没问题)。
最关键的坑:别用裸 node 命令。在 MCP 客户端配置里写 command: node,大概率报 spawn node ENOENT。因为 MCP 客户端的 PATH 环境变量里可能找不到 node。
正确做法——用 Node 二进制的绝对路径:
which node# 输出:/root/.hermes/node/bin/node ← 用这个完整路径不同系统的路径:
- Linux 自定义安装:`/opt/node/bin/node`- macOS Homebrew:`/opt/homebrew/bin/node`- nvm:`~/.nvm/versions/node/v22.0.0/bin/node`2. 安装 MCP 包
npm install -g mineru-mcp记住安装输出的路径,待会要写到配置文件里。一般是 /root/.hermes/node/lib/node_modules/mineru-mcp。
3. 获取 API Key
到 https://mineru.net 注册开发者,控制台拿 API Token。
【亲测】API Key 别手滑写进命令行调试——会被 shell 历史和监控日志捕获。也绝不要写到公共仓库。正确做法:写进 MCP 配置文件的 env字段,文件权限设 600。
4. 配置 MCP 服务
不管是 Claude Desktop、Cursor、Cline 还是 Hermes Agent,配置大同小异:
mcp_servers: mineru-mcp: command: /root/.hermes/node/bin/node args: - /root/.hermes/node/lib/node_modules/mineru-mcp/dist/index.js env: MINERU_API_KEY: your_api_key_here enabled: true加载后 AI 工具列表会多出 6 个工具:
mineru_parse | |
mineru_status | |
mineru_batch | |
mineru_batch_status | |
mineru_upload_batch | |
mineru_download_results |
别问我为啥知道,问就是踩过
坑 1:解析状态长时间 Pending?不是 bug
提交一个 100 页扫描版 PDF,过了一分钟还在 Pending。别慌,真不是挂了——复杂排版/扫描件处理需要更长时间。
正确做法:设置 5-10 秒轮询间隔,给 MCP 调用设 5 分钟 timeout。别因为单次响应慢就杀进程。
坑 2:spawn node ENOENT
根因上面说了——没用绝对路径。改了就再也没出现过。
坑 3:API Key 被日志泄露
调试时图方便,把 Key 写在 shell 命令里。结果被日志脚本捕获传到云端监控。还好及时发现。
铁律:调试用 export MINERU_API_KEY=xxx,完事立刻 unset。长期配置写 config.yaml 的 env 字段 + chmod 600。
这一点不是 MinerU 的问题,是所有 API Key 管理的通用坑——但 MinerU 的部署过程中最容易犯错,因为你要在命令行、配置文件、MCP 配置三个地方协调。
实测效果
我用 MinerU 解析了 50 篇 arXiv 论文(平均 15 页,含公式图表),跟直接用 GPT-4 Vision 对比:
| 免费额度 | ||
| 减少约 70% |
MinerU 输出的 Markdown 结构干净,喂给 LLM 的 token 数比直接丢原文少 70%——省下来的 token 就是钱。
还能怎么玩
配合定时任务:RSS 抓论文 → mineru_batch 批量解析 → 自动入库知识库。全链路无人值守。
配合 RAG:MinerU 输出 Markdown → 拆 chunk → embedding 入向量库。文档预处理从此告别手工。
配合论文阅读助手:给 PDF URL → MinerU 解析 → 大模型按"摘要/方法/实验/结论"四段总结 → 用户问细节时引用段落回答。
这东西适合你吗
适合:
经常处理论文、合同、技术文档的
在用 Claude/Cursor/Cline 需要文档解析能力的
想做自动化文档流水线的
不适合:
只需要偶尔读一两页 PDF——直接用 AI 自带的 vision 就行
处理内容涉及高度机密的——MinerU 走云端 API,数据会传到服务器
预算为零的——免费额度对个人够用,企业需要付费
MinerU 是目前国产开源文档解析里精度最高、部署最简单的方案。配合 MCP 协议,几乎所有 AI IDE 和 Agent 框架都能零成本接入。我跑了一个月,稳定性没问题。
「每天帮你踩一个 AI 的坑,省下一小时。」
你用什么工具处理 PDF?评论区聊聊,说不定有更好的我还没发现。