ARTICLE · 981249
别再盲目收集AI工具:用同一任务做一次真实对比
别再盲目收集AI工具:用同一任务做一次真实对比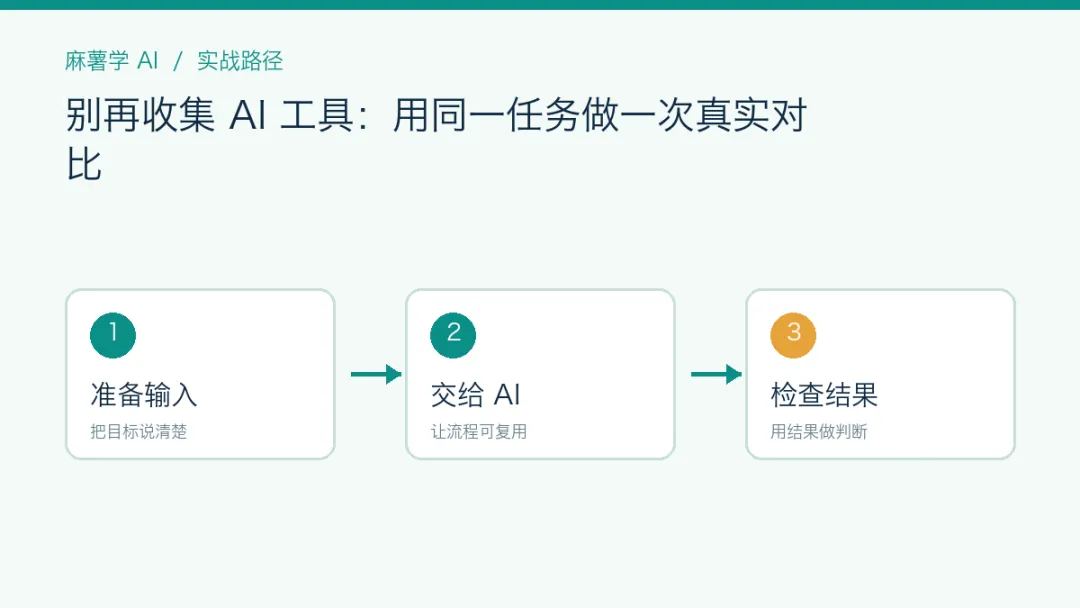
别再盲目收集AI工具:用同一任务做一次真实对比
读完本文,你将学会一套“单任务真实对比法”,用同一个实际工作任务评估不同 AI 工具,快速挑出最符合需求的日常助手。
学习目标
完成本教程后,你将能够:
掌握一套简单高效的“单任务对比法”,不再盲目收藏各类 AI 工具。 设计一套符合自己实际业务场景的标准化测试 Prompt。 建立一份可视化的评估方法,用实际输出质量选出最适合自己的日常 AI 助手。
准备工作
在开始之前,请准备好以下内容:
- 确定测试对象
:挑选 2 到 3 个你正在纠结的大语言模型工具(例如 ChatGPT、Claude、Kimi 或智谱清言)。 - 准备真实素材
:准备一段真实的日常工作文本(例如:一篇约 500 字的未整理会议记录、一份产品需求说明或一封客户投诉邮件)。请勿使用网上随意搜到的虚构样例。
分步骤操作
步骤一:提取核心需求,确定评估维度
盲目对比容易看花眼。你需要根据任务特点,设定 3 个核心评估指标(满分各 5 分):
- 信息提取准确度
:是否遗漏关键信息,是否有胡编乱造(幻觉)。 - 结构逻辑性
:输出结果是否层级分明、排版清晰、易于阅读。 - 直接可用度
:生成的内容你需要手工修改多少才能直接提交使用。
步骤二:撰写标准化测试 Prompt
为了保证对比的公平性,必须给所有工具发送完全一致的指令。包含明确的角色、任务、约束条件和输出格式。
步骤三:同步输入并记录原始结果
打开两个待对比工具的聊天界面。 将包含 Prompt 和真实素材的同一段文本,分别发送给工具 A 和工具 B。 观察并记录:
- 响应完成度
:是否完整执行了所有要求(如字数限制、格式要求)。 - 修改成本
:估算你需要花多少时间修改它的输出。
步骤四:填表评分,做出决策
根据三个维度打分并相加:
工具 A:准确度 4 分 + 逻辑 5 分 + 可用度 3 分 = 12 分 工具 B:准确度 5 分 + 逻辑 4 分 + 可用度 5 分 = 14 分
优先选择总分最高或“直接可用度”最高的工具作为你的日常主推工具。
可复制的 Prompt
请复制以下模板,将括号中的内容替换为你的真实素材:
你是一名专业的高级行政助理。请阅读以下原始会议记录,完成一份结构化的会议纪要。 【处理要求】 1. 提取 3 个核心决议事项,用无序列表呈现。 2. 梳理后续待办任务(包含:责任人、完成时限、具体行动),用 Markdown 表格呈现。 3. 提炼出需要上报的 1 个潜在风险点。 4. 语言简洁专业,总字数控制在 300 字以内。 【原始会议记录】 (在此处粘贴你准备好的 500 字左右真实会议文本)动手练习
请用你今天收到的最新工作邮件或聊天记录,替换上方 Prompt 中的【原始会议记录】,分别粘贴进两个不同的 AI 工具中。 检查哪个工具做到了:
正确输出了 Markdown 表格; 准确识别了所有责任人和截止日期; 字数严格控制在要求的范围内。
常见错误
- 错误一:测试指令不一致
。在工具 A 说了“简明扼要”,在工具 B 却忘了写,导致对比失去公正性。 - 错误二:使用过长或过短的测试文本
。文本太短体现不出能力差异,文本超出工具上下文限制则会导致遗漏。建议初始测试文本控制在 500~2000 字。 - 错误三:过度关注生成速度
。速度快但内容质量差的工具,会带来巨大的后续核对成本,应优先看重“准确度”与“可用度”。
总结
工具不在于多,而在于精。通过“单任务对比法”,你只需要花费 10 分钟,就能建立对工具真实能力的直观认知。停止囤积工具列表,现在就用你手头真实的下一个工作任务,开启第一次实战对比吧!