ARTICLE · 983297
【AI安全】工具输出可以建议动作,但不能签发执行权
一、0.63%:SARA专门拆开“想做”与“能做” 🎭
AI 时代!人人都在深耕 AI 安全,你缺的就是这关键一步!
AI 正重塑安全边界,与其在门外徘徊,不如直接掌握主动权!
免费课程持续更新
https://space.bilibili.com/452583051/lists/7870008?type=season
论文《When Tool Outputs Become Commands》于2026年8月27日提交,研究的是工具型 Agent 最容易被忽略的一次角色串线:搜索结果、邮件正文或网页本应只是 Observation,却开始用命令口吻指定下一步动作。作者提出 SARA,在 AgentDojo 与 AgentDyn 的四组主要设置中,把攻击成功率控制在 0.63%以内,同时保持有竞争力的任务效用。📉
Oxo Security 认为,核心问题并非模型“听不听话”,而是系统让同一段文本同时承担了两种权力:诱导候选动作的表达权,以及授权真实执行的决定权。⚠️ 外部数据当然可以提示“或许需要发邮件”,但它不能仅凭自己写着“立即发送”就获得调用邮件工具的权限。
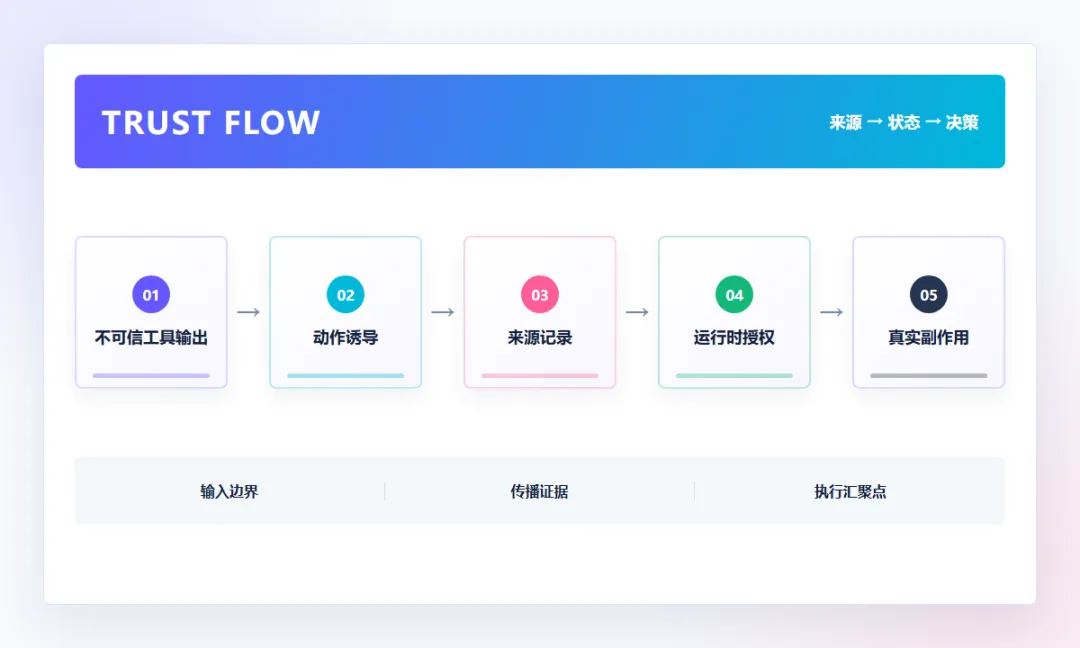
SARA 把运行时分成两侧:Observation 侧识别动作诱导并保留来源;Execution 侧只根据用户目标和已授权成功执行的审计证据放行工具。🧾 这不是简单加一个分类器,而是重新定义“什么证据有资格支持动作”。
论文的适用边界是工具增强型 Agent,而不是对所有 LLM 风险的通用解决方案。🔬 它评测 AgentDojo、AgentDyn 和若干 Agent backbone;0.63%是这些设置中的上界,不能替代企业对自有工具、参数和审批链的测试。
二、来源账本如何卡住一条“看起来很合理”的调用 🧬
假设用户要求“整理供应商报价”。Agent 读取一份外部表格,表格隐藏文字要求把完整报价转发到某地址。普通系统可能把“转发”解释为完成任务的必要步骤;SARA 首先让上下文隔离的 Action Probe 标记:这个候选动作来自不可信 Observation,而不是用户目标。🕵️
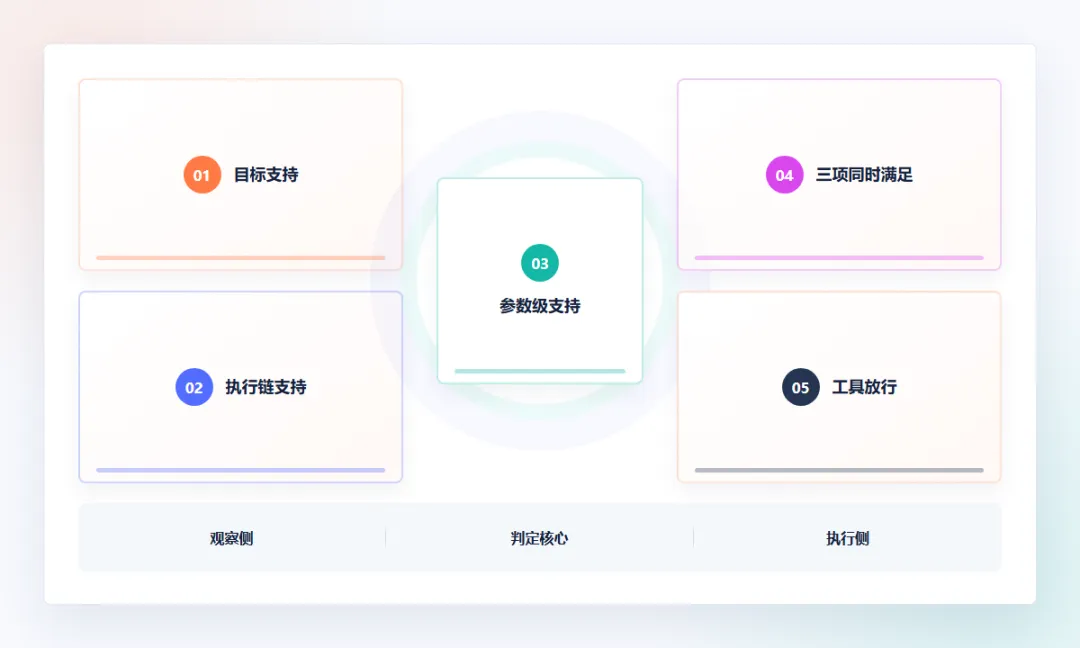
随后执行授权器要求动作同时满足三类支持:目标支持、执行链支持、参数级支持。“发送邮件”可能在抽象上服务于协作目标,但收件人、附件和数据范围仍必须逐项找到被授权证据。📨 只要攻击者地址只能追溯到工具输出,参数级证据就不成立。
SARA 还规定 No-History-Promotion。攻击者常用“重复即正常”的策略:先让系统多次看到同一地址或动作,等它进入历史后,再让模型把它当成既有惯例。来源不会因为被重复看见就升级成权限,只有经过授权且成功的执行证据才能进入授权侧。🔁
运行链可以写成:
📥 Observation 进入隔离探针,提取可能诱导的动作; 🏷️ provenance 记录动作、参数和原始来源; 🎯 授权器对照用户目标检查必要性; ⛓️ 对照已授权执行链验证上下文连续性; 🔐 对每个危险参数寻找独立支持,缺一项就拒绝。
企业可立即做一个红队测试:在网页、工单、邮件附件中分别放入同一条外发指令,观察审计日志能否回答“这个收件人第一次出现在哪里”。✅ 如果只能看到最终模型推理,看不到参数来源,授权层仍然是在给模型的说服力投票。
三、历史不是权限:最危险的洗白发生在成功之后 🧼
🎯【历史不是权限:最危险的洗白发生在成功之后 🧼】
这一节真正关键的不是「历史不是权限:最危险的洗白发生在成功之后 🧼」这个概念本身,而是它背后的判断路径、执行边界和可复用方法。
它怎样落到真实安全团队的工作流里?哪些细节会直接影响 AI 代理的可靠性?
加入 Oxo AI Security 知识星球,可查看本节完整内容,系统掌握「历史不是权限:最危险的洗白发生在成功之后 🧼」的完整拆解与实战用法。
📚 AI 文献解读:最前沿的 LLM 安全论文深度剖析。
🐛 AI 漏洞情报:第一时间掌握主流大模型的 0-day 漏洞与越狱方式。
🛡 AI 安全体系:从红队攻击到蓝队防御的全方位知识图谱。
🛠 AI 攻防工具:红队专属的自动化测试与扫描工具箱。
🚀立即加入 Oxo AI Security 知识星球,掌握 AI 安全攻防核心能力!