ARTICLE · 983717
我给自己做了一个离线背单词 App,顺便上了一堂工程课
OFFLINE · ANDROID · 一个人的项目
事情的起因很简单:我想在手机上刷一本词根词汇书。结果刷着刷着,刷出了 30 个单元、1,200 个词条、3,220 道题,还有一个不联网、没账号、没广告的安卓应用。这篇文章讲讲它是怎么长出来的。
2026 年 8 月 · 文中截图全部来自真机操作,未裁切未修图
|
| |||
|
|
最终回归成绩 193 项全部通过 · 设备测试 5/5 Android 8 起可用 · 无网络权限 · 无账户 · 无广告 · 无云同步 |
01 · 先看看成品
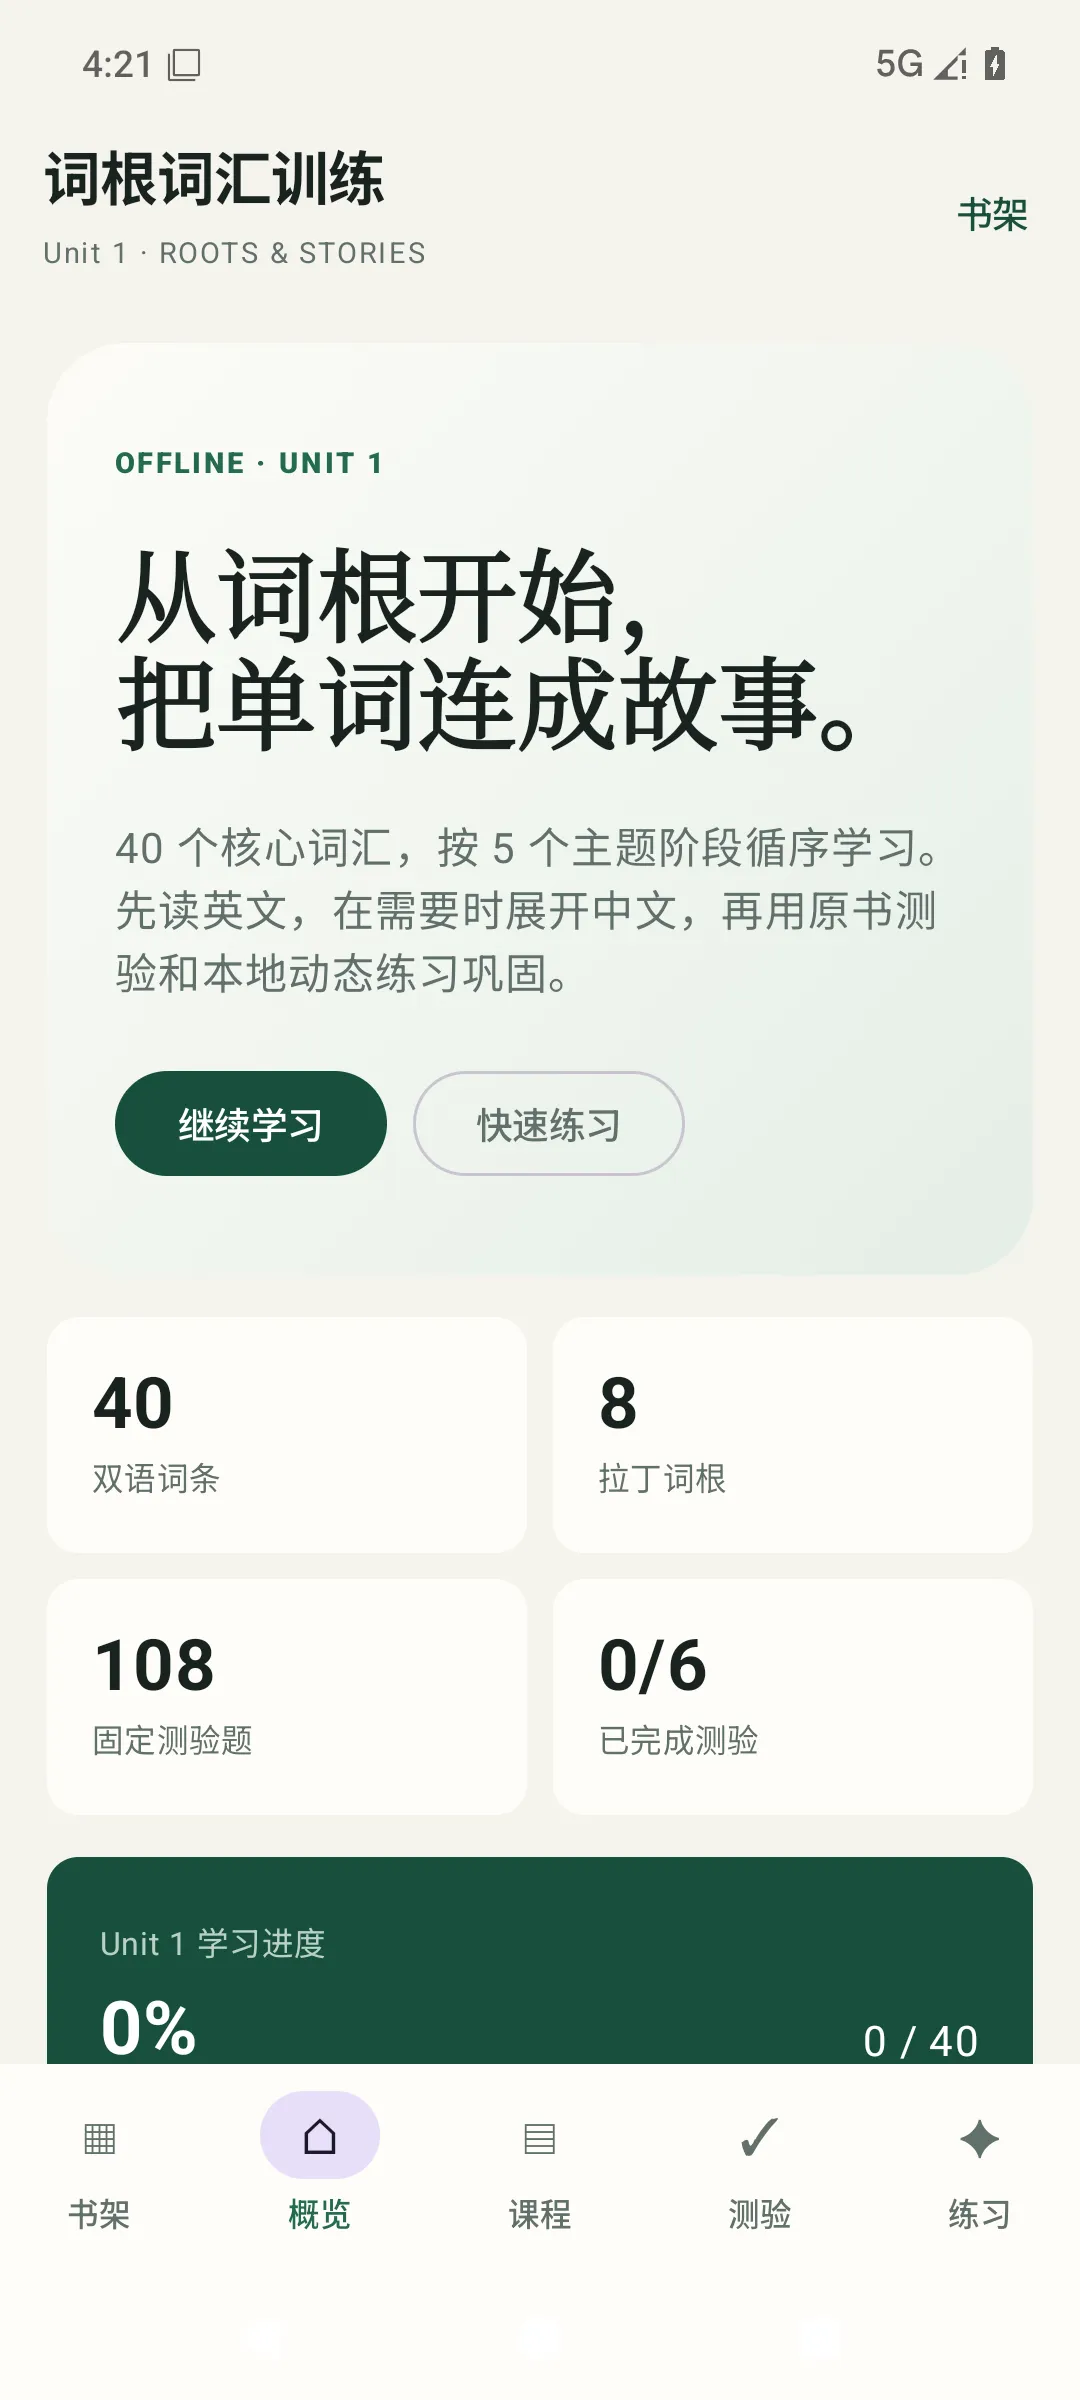
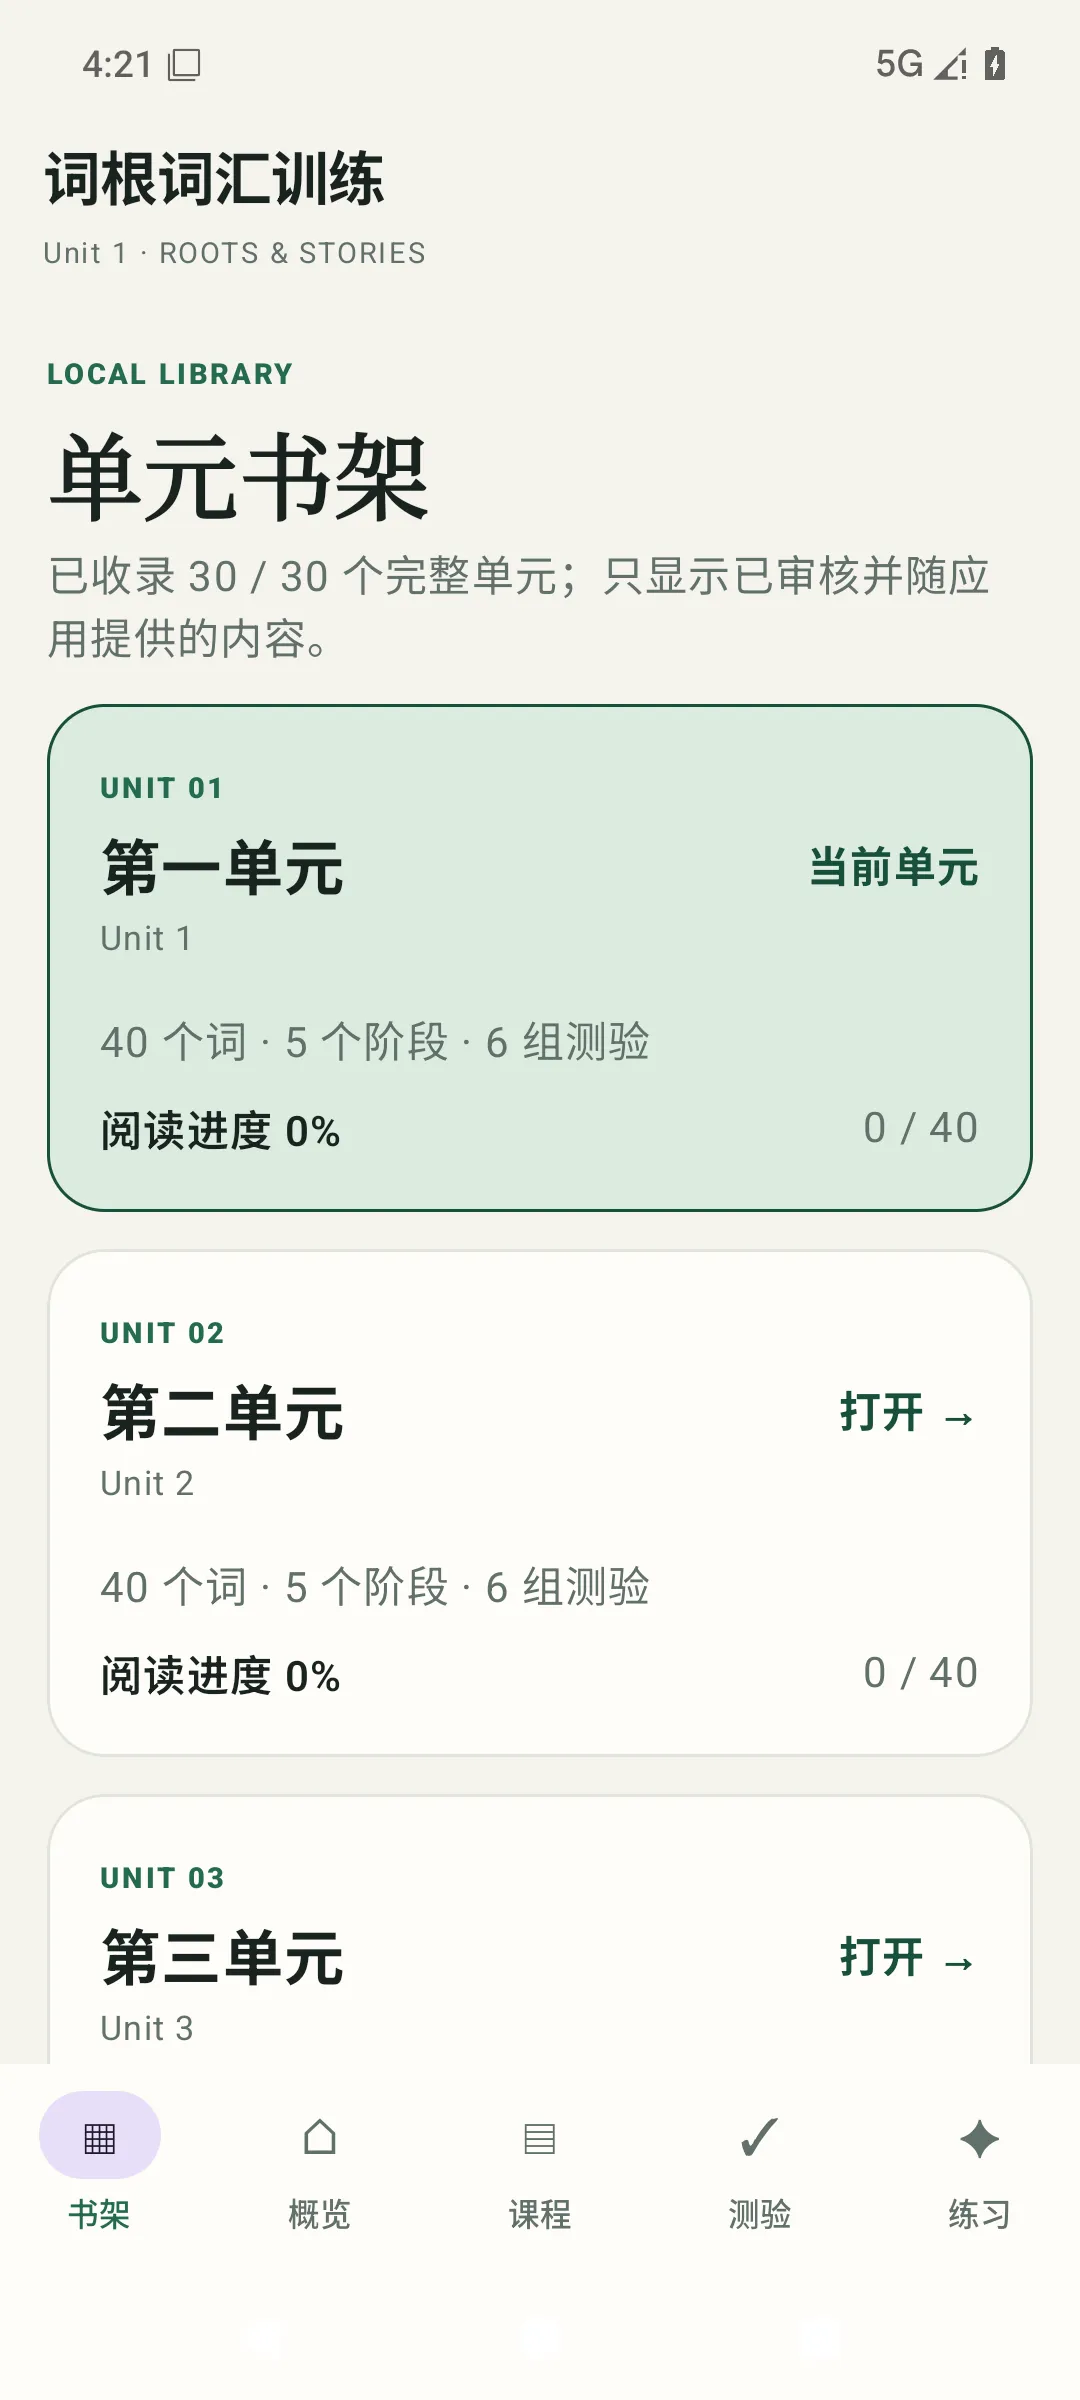
我对“做完”的定义很朴素:打开应用,从第一单元一路滑到第三十单元,每一张卡片点进去都有真东西。
|
|
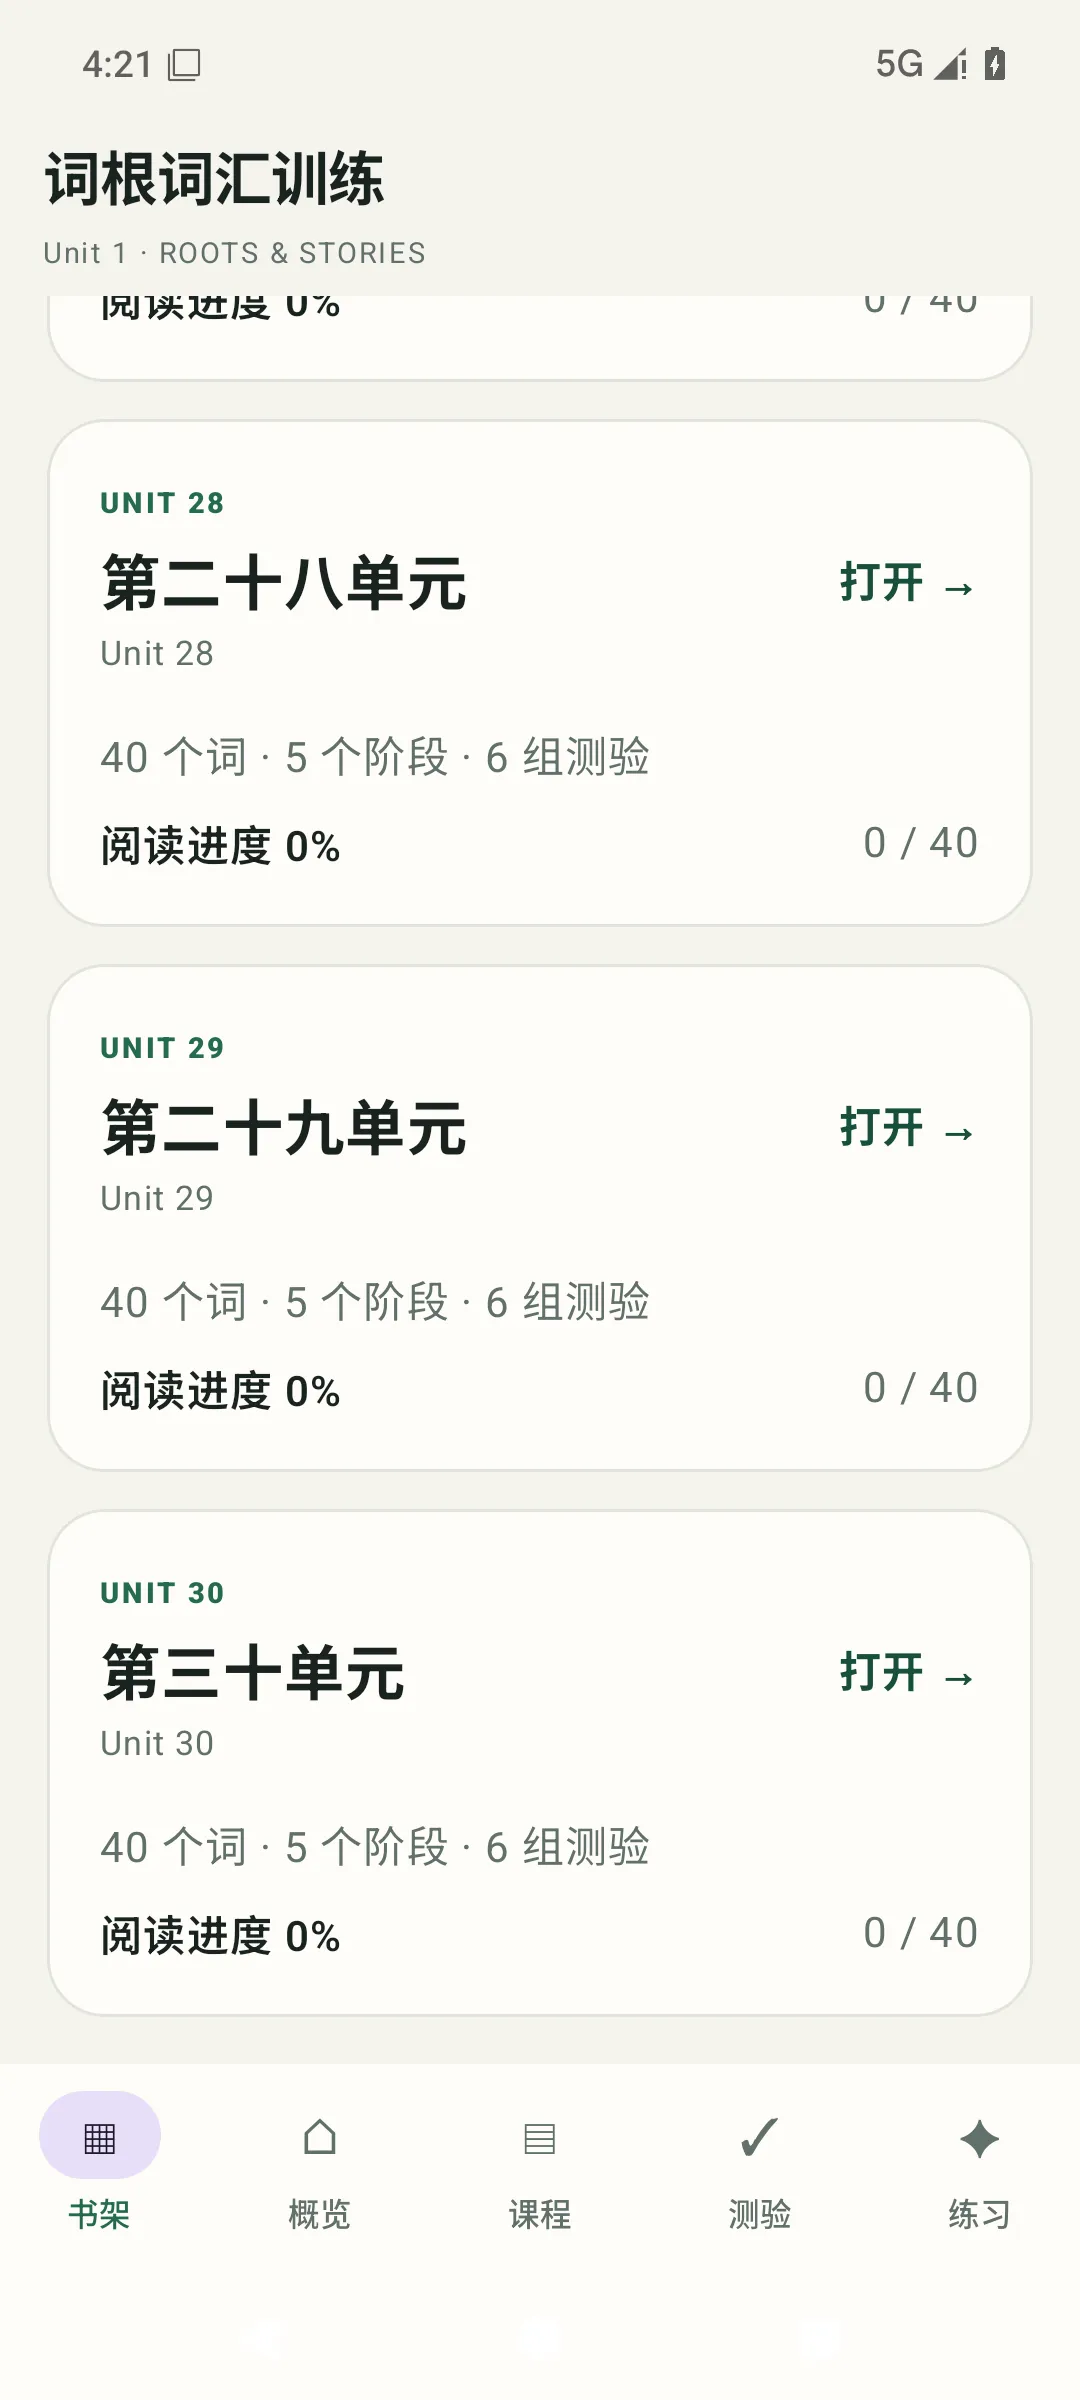 |
| 图 3 |
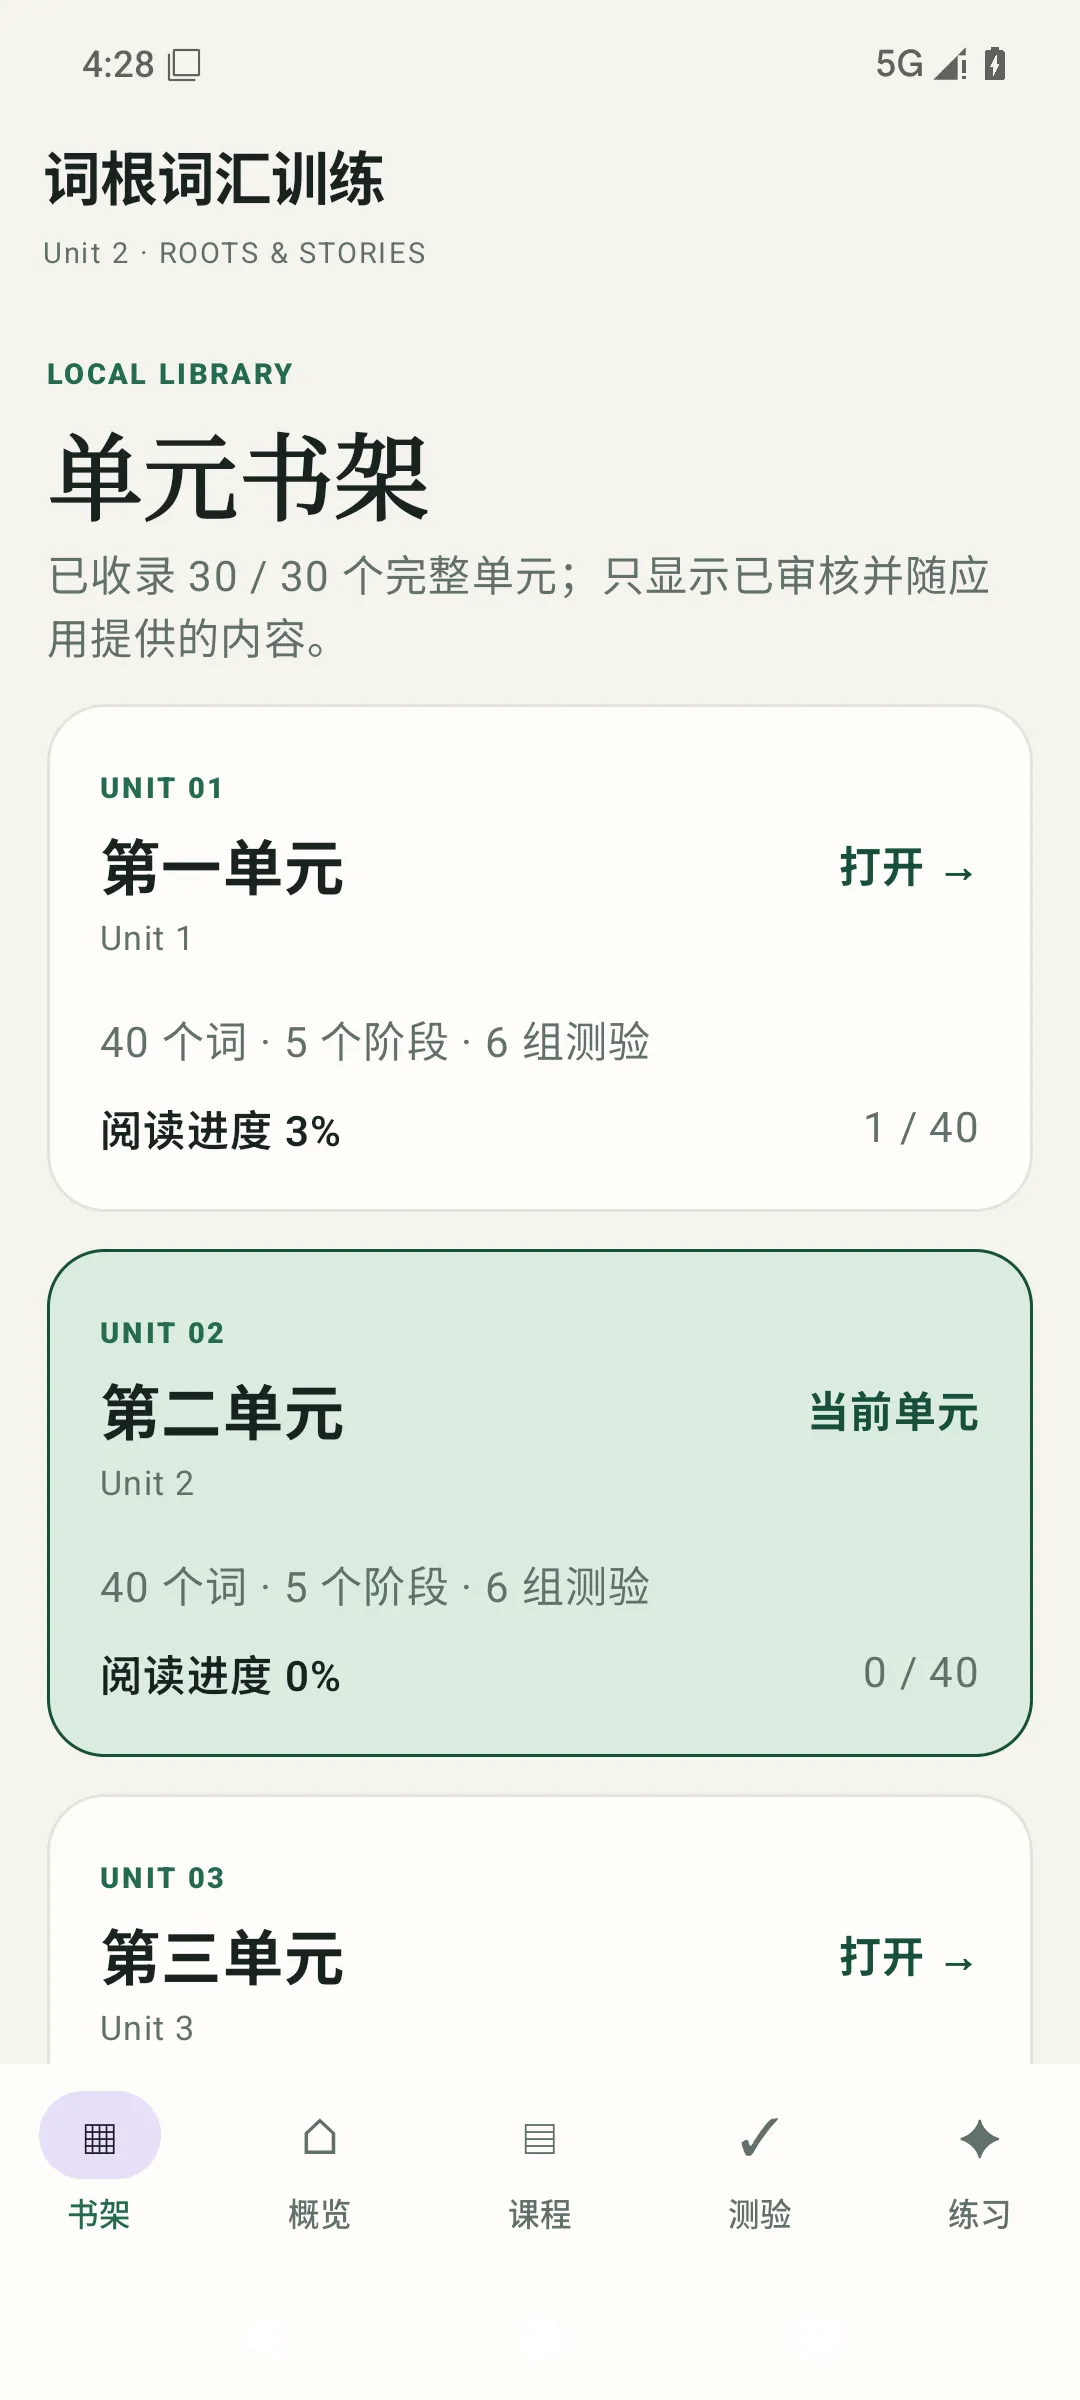
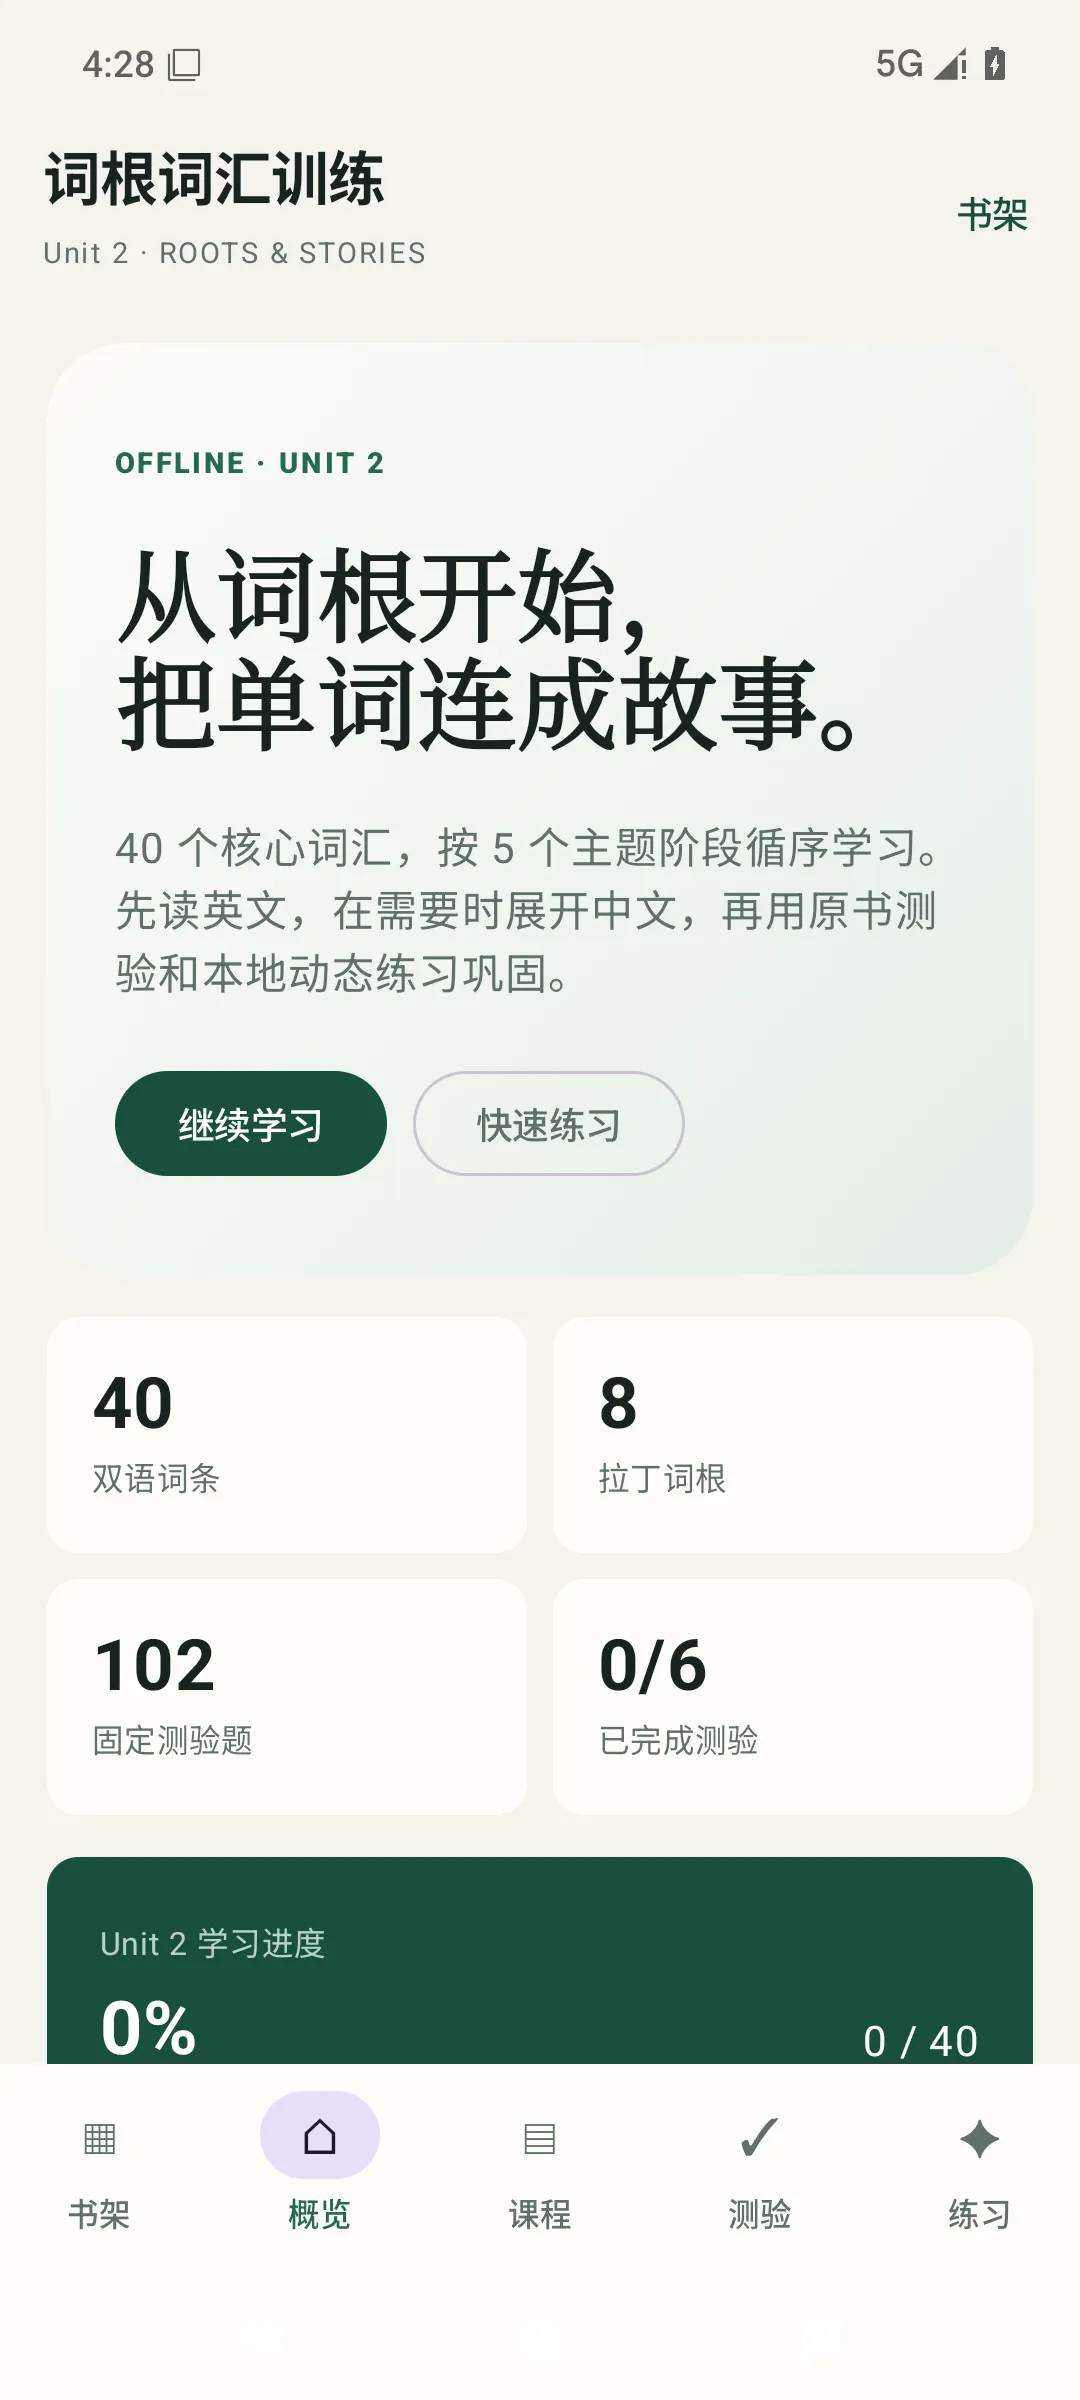
底部五个入口各管一件事:书架选内容,概览看进度,课程负责学,测验负责考,练习负责用。各管各的,互不抢戏。
02 · 课程
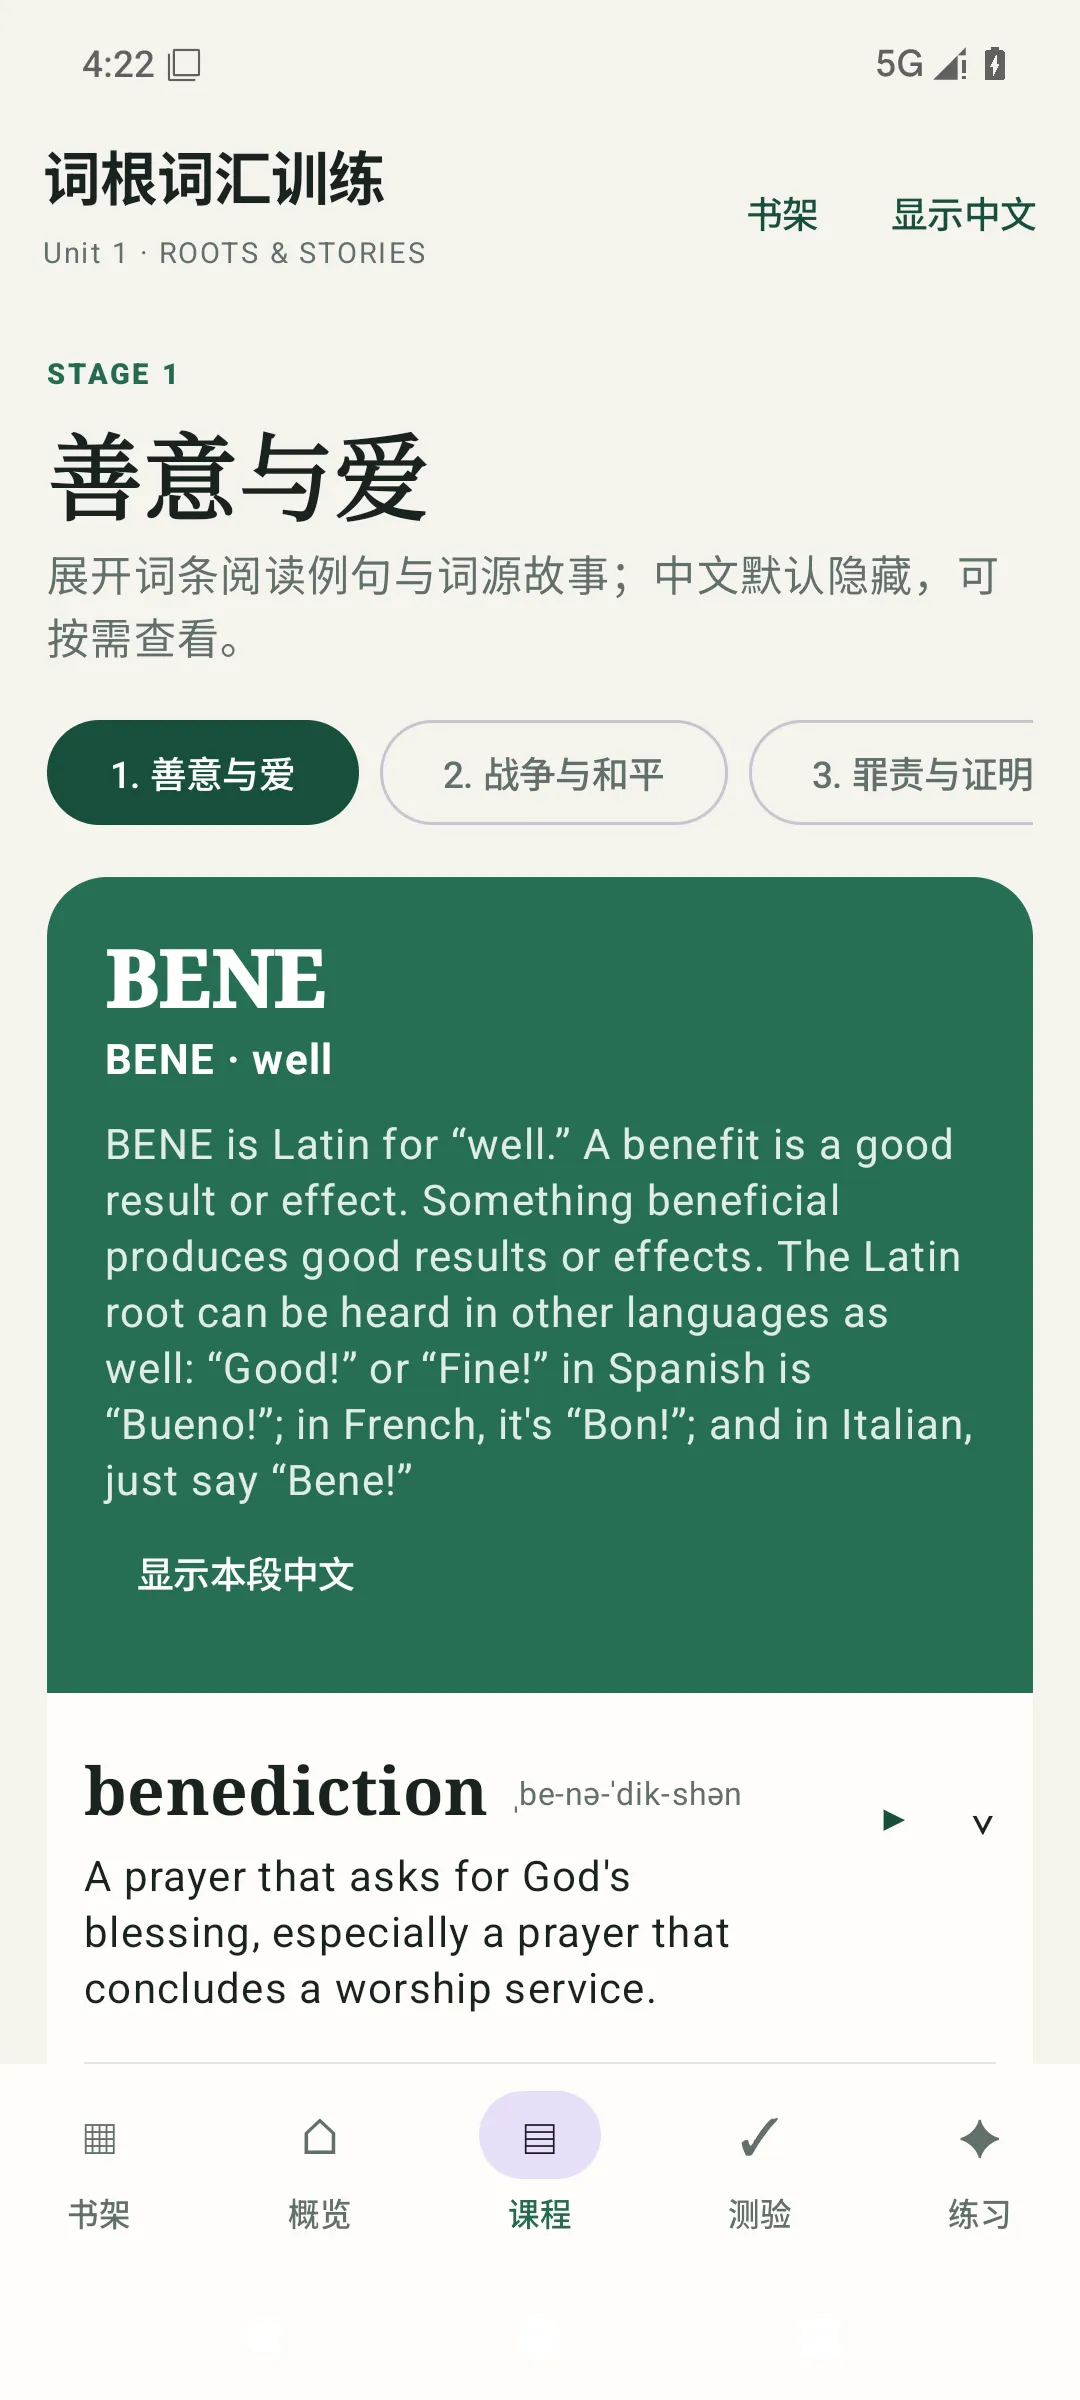 |
| 图 4 |
做 Unit 1 的时候,我偷了个懒,差点把阶段信息直接写进代码。Unit 2 一来就发现不行——于是把整套结构搬进数据模型。后来的事实证明这一步很关键:之后 28 个单元只需要喂数据,一行界面代码都不用改。
03 · 双语设计
|
|
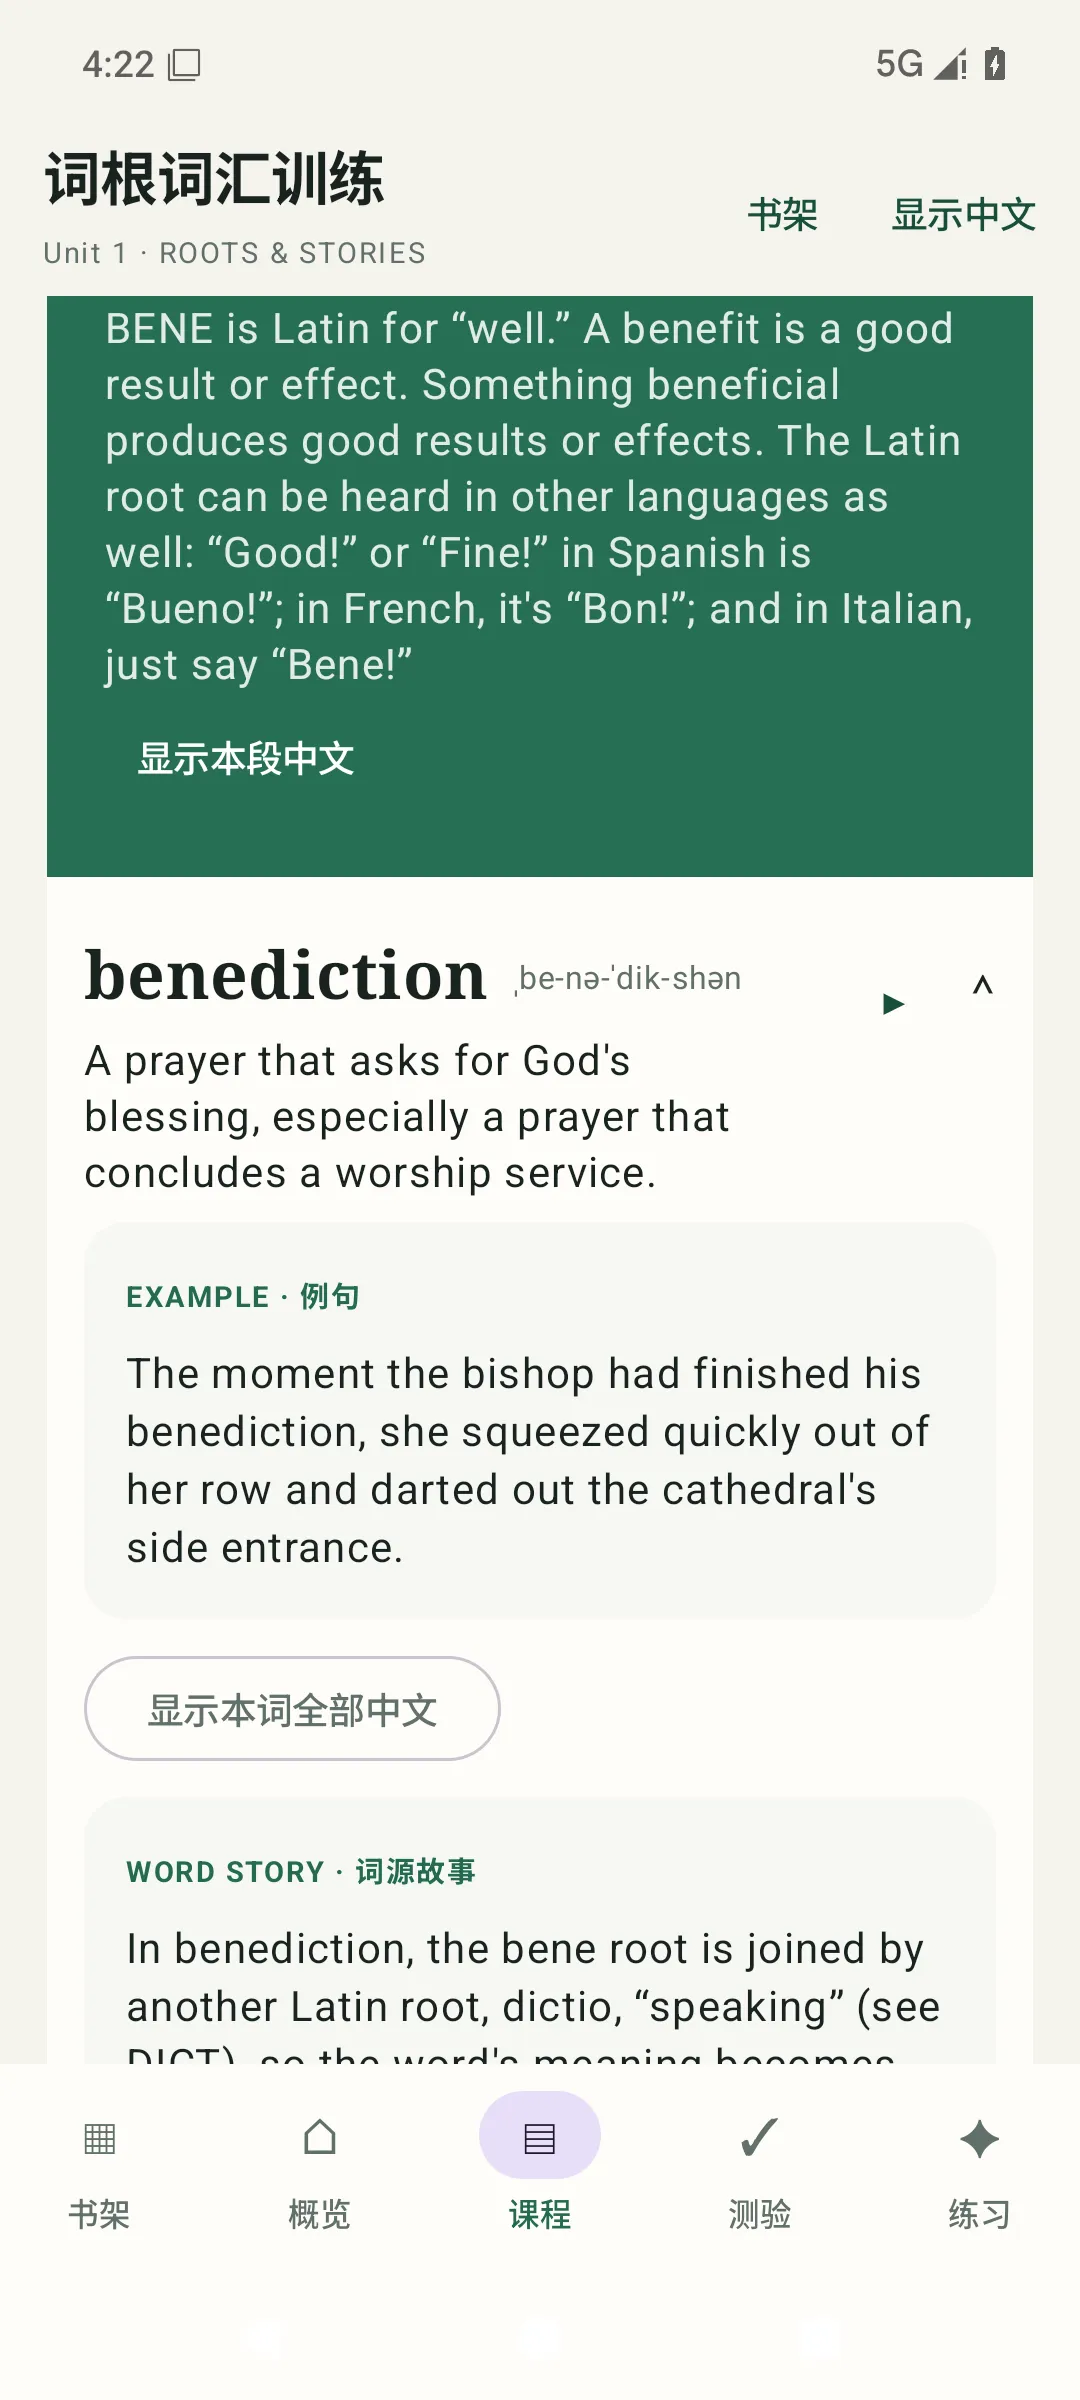
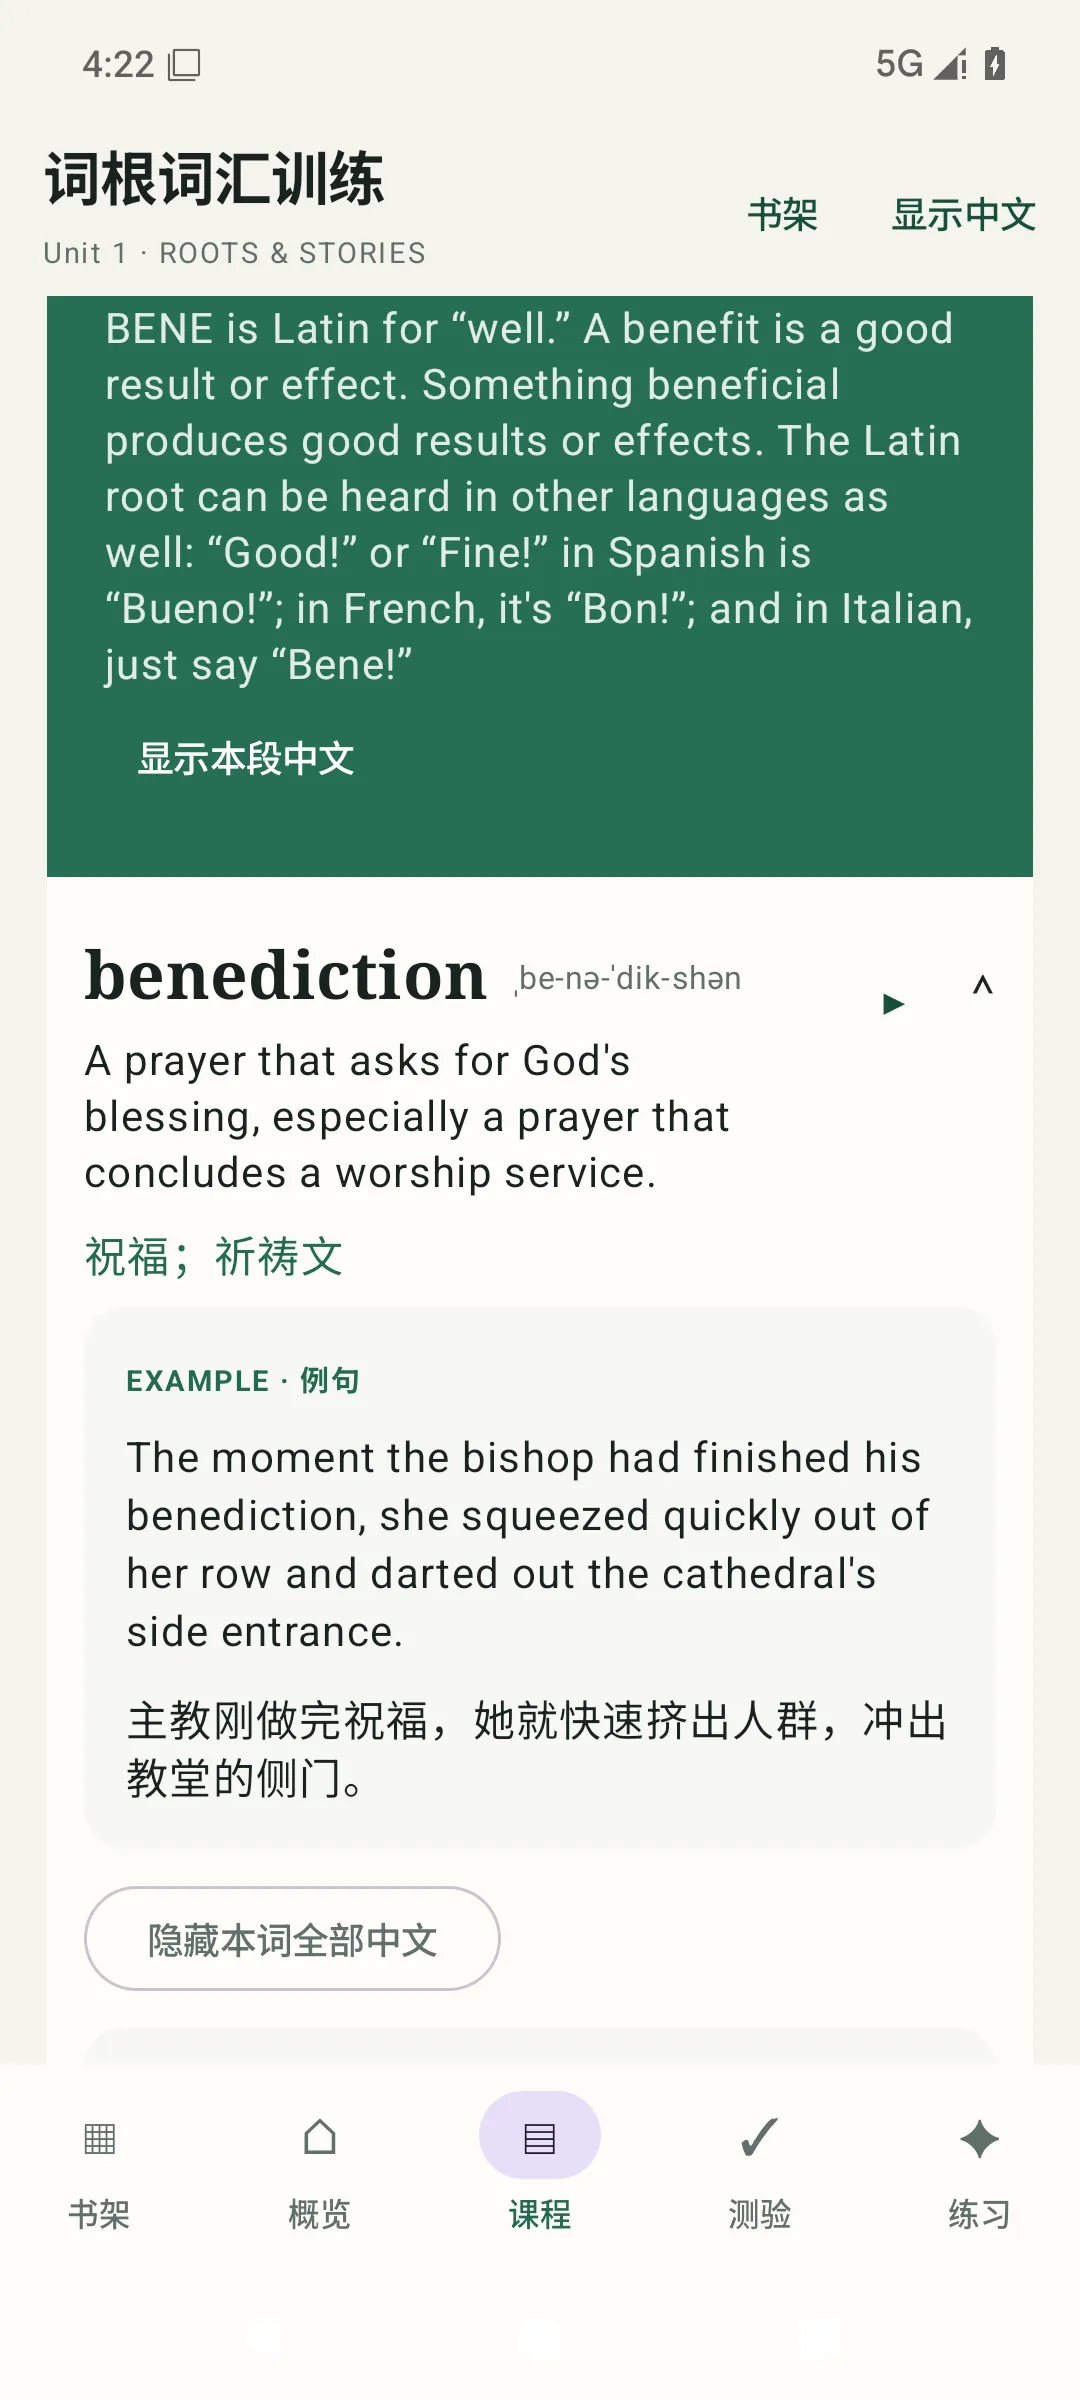
我的想法是:先逼自己用英文理解,实在扛不住再叫中文来救场。中文是脚手架,不是天花板。而且展开精度可以到单个词条、单段词根,很克制。
04 · 测验
|
|
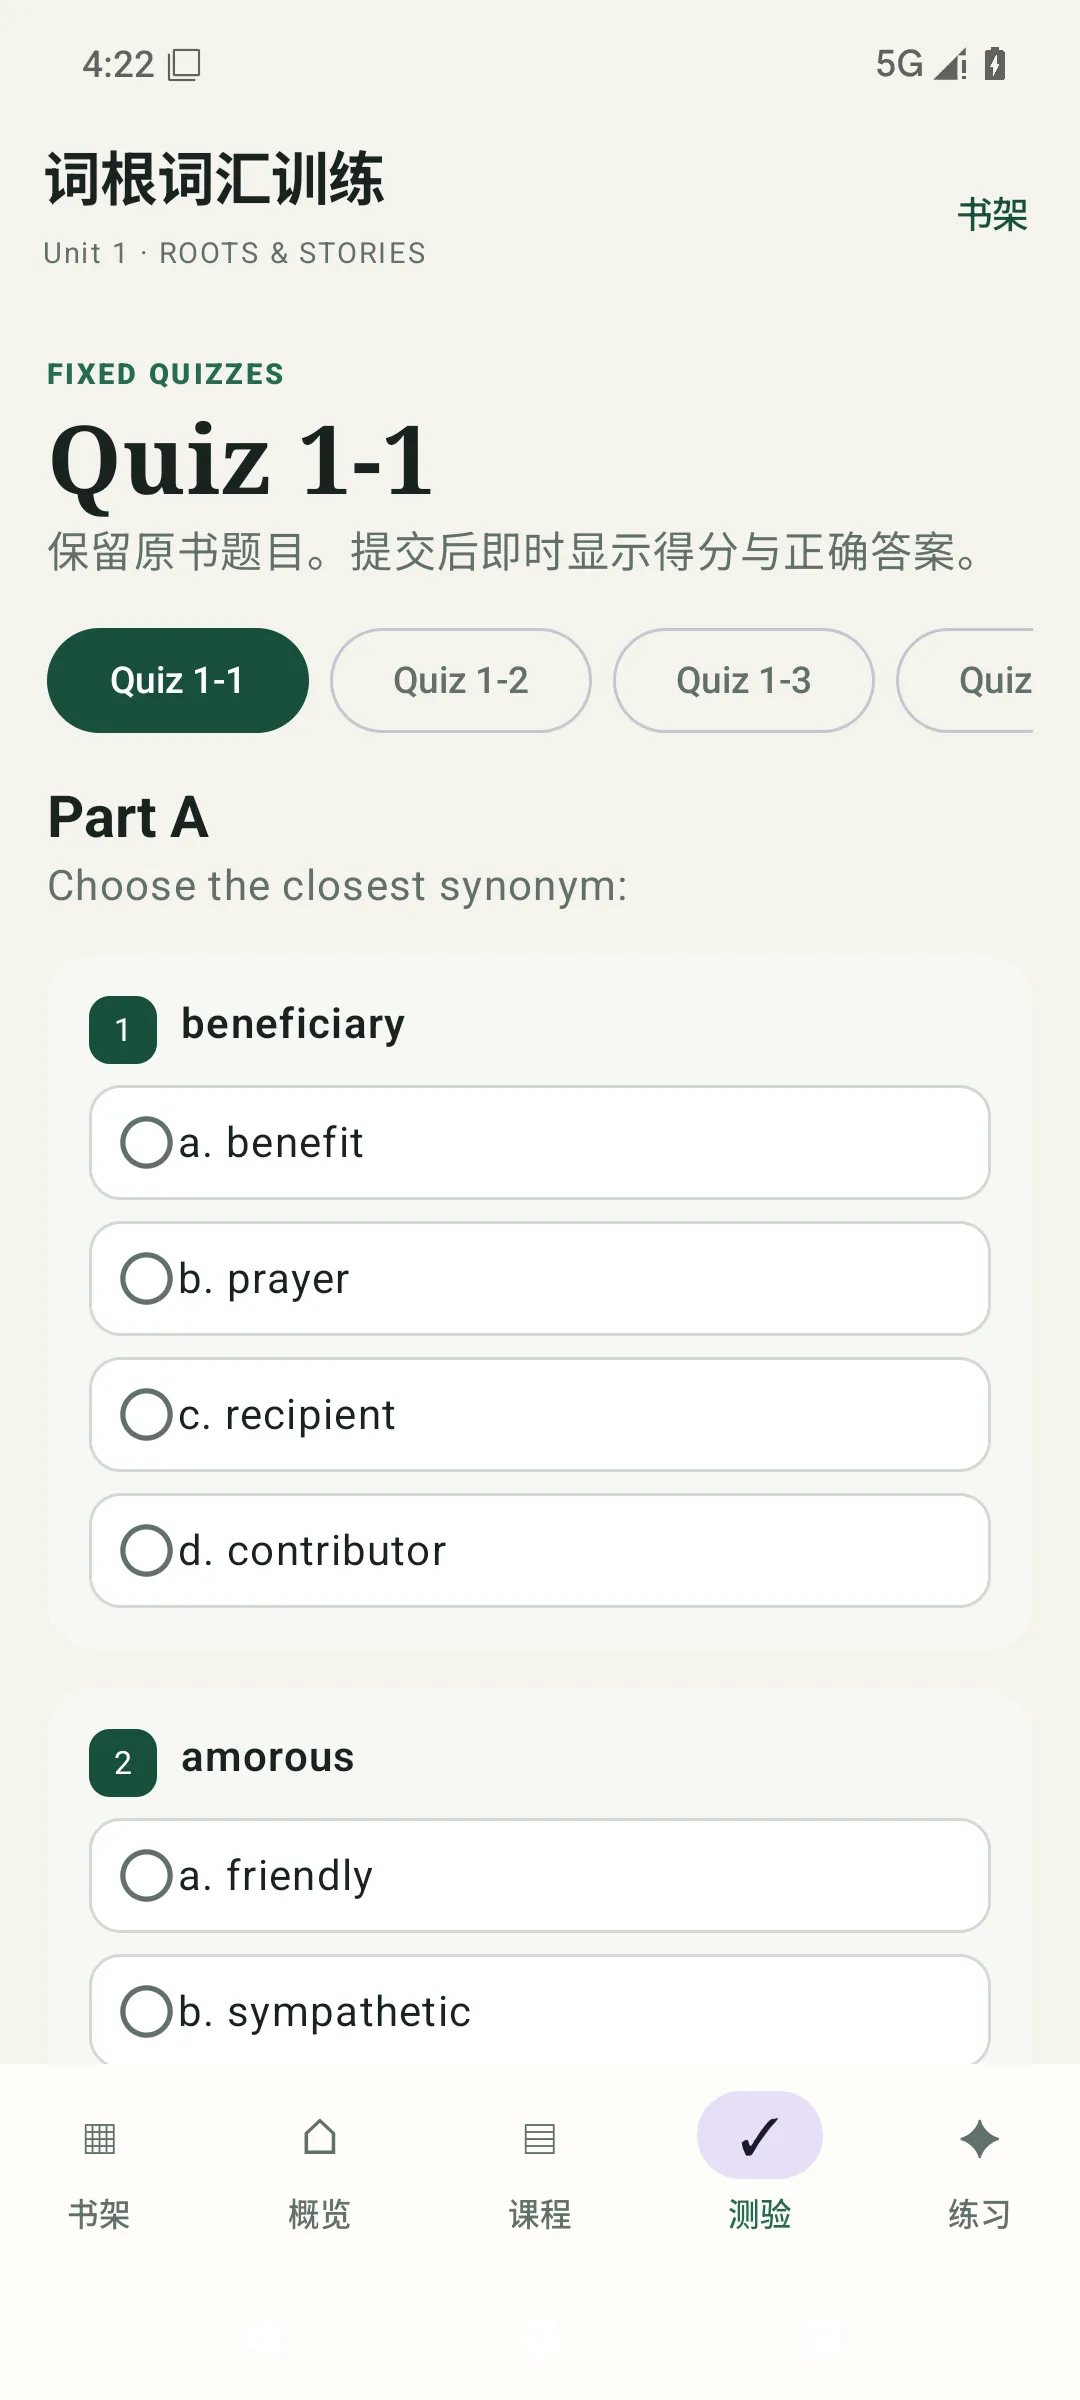
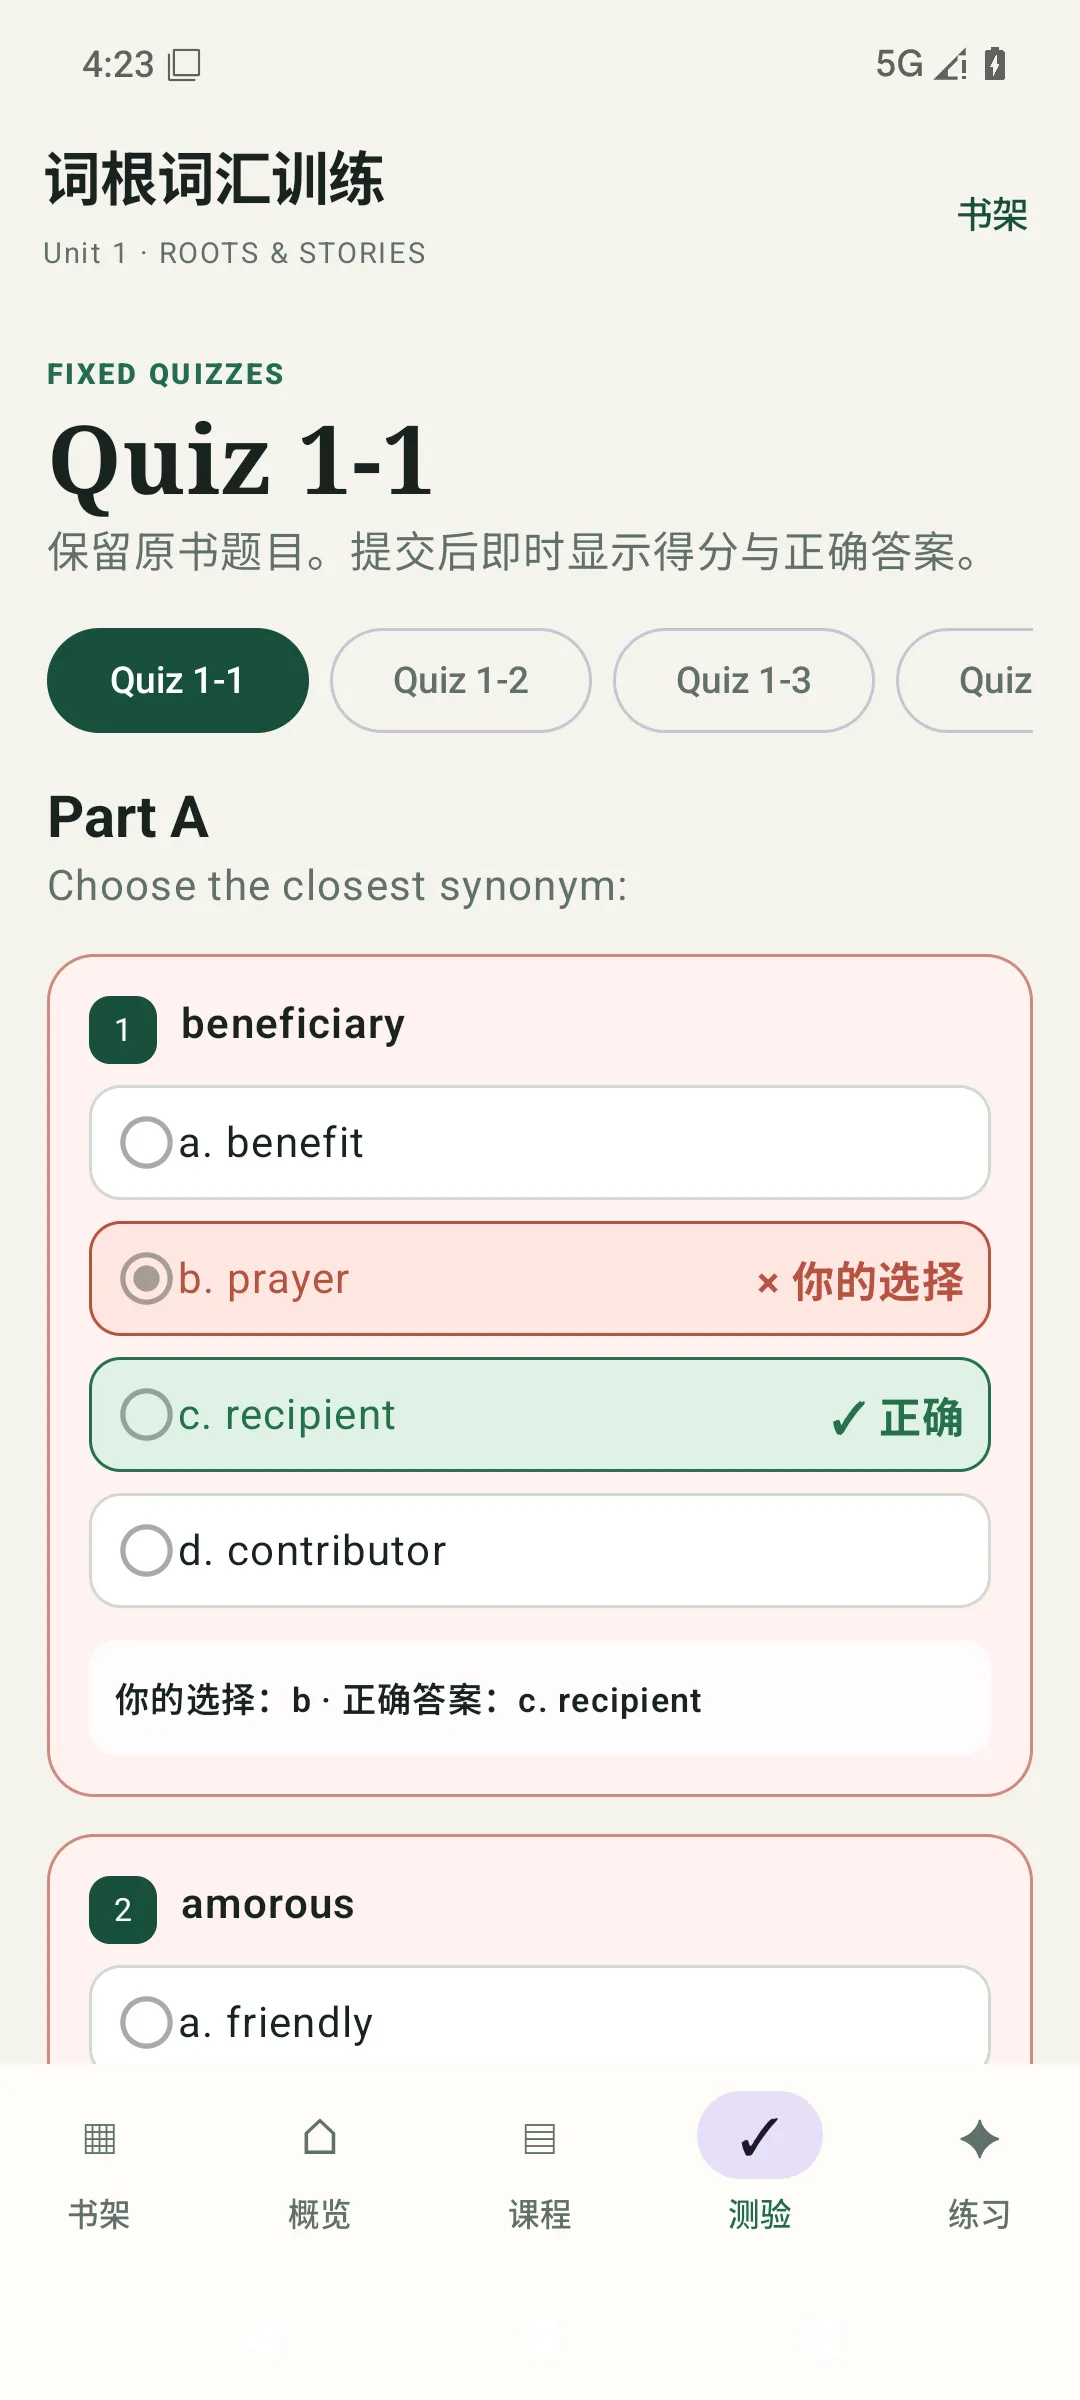
 |
| 图 9 |
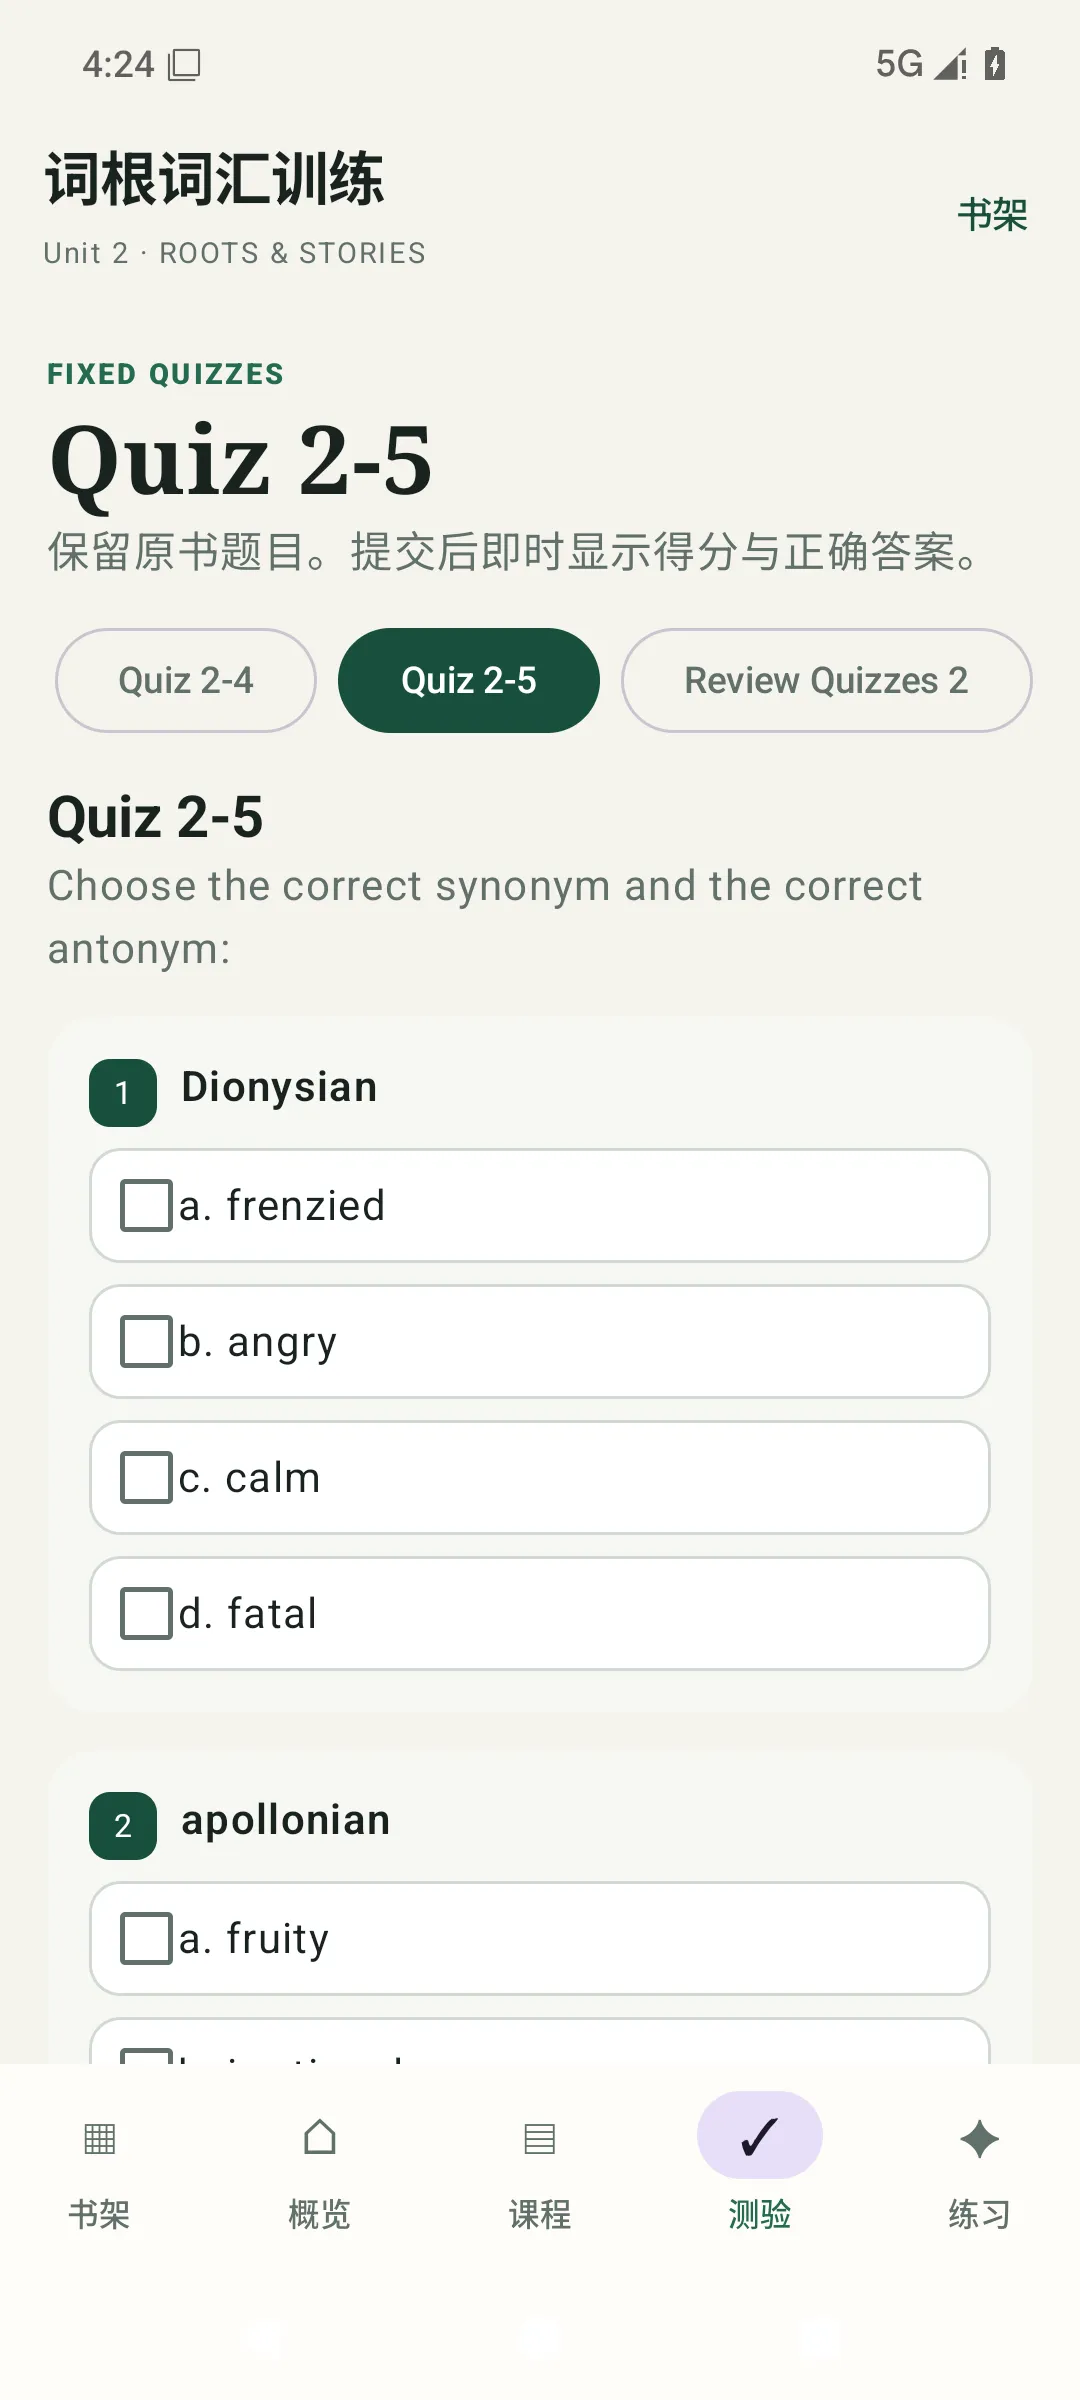
测验题严格保留原书的题干和选项——内容忠实,交互现代。即时出分、逐题解析、最佳成绩存在本地。
05 · 练习
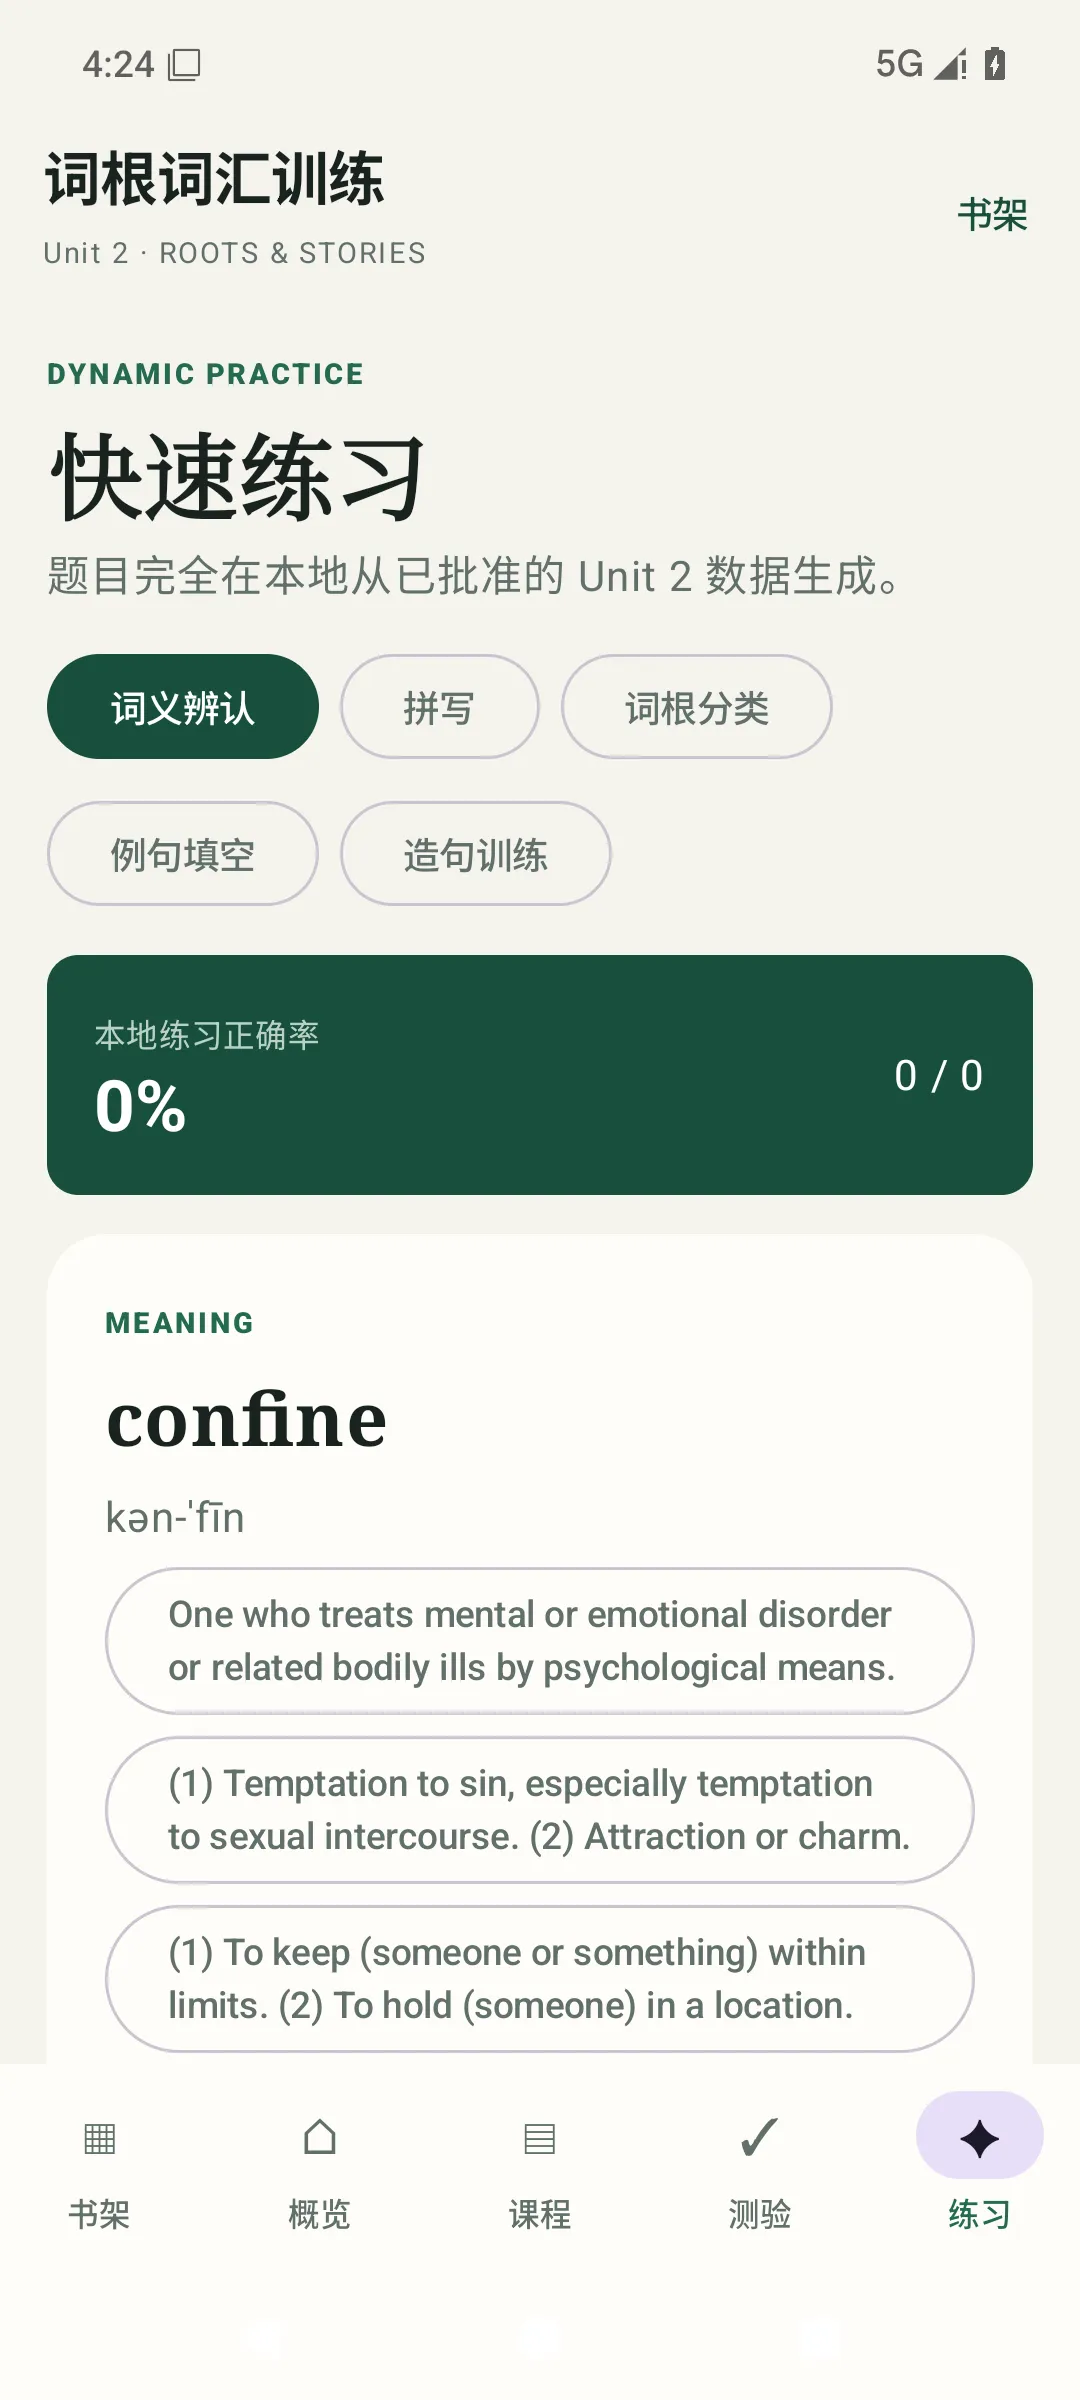
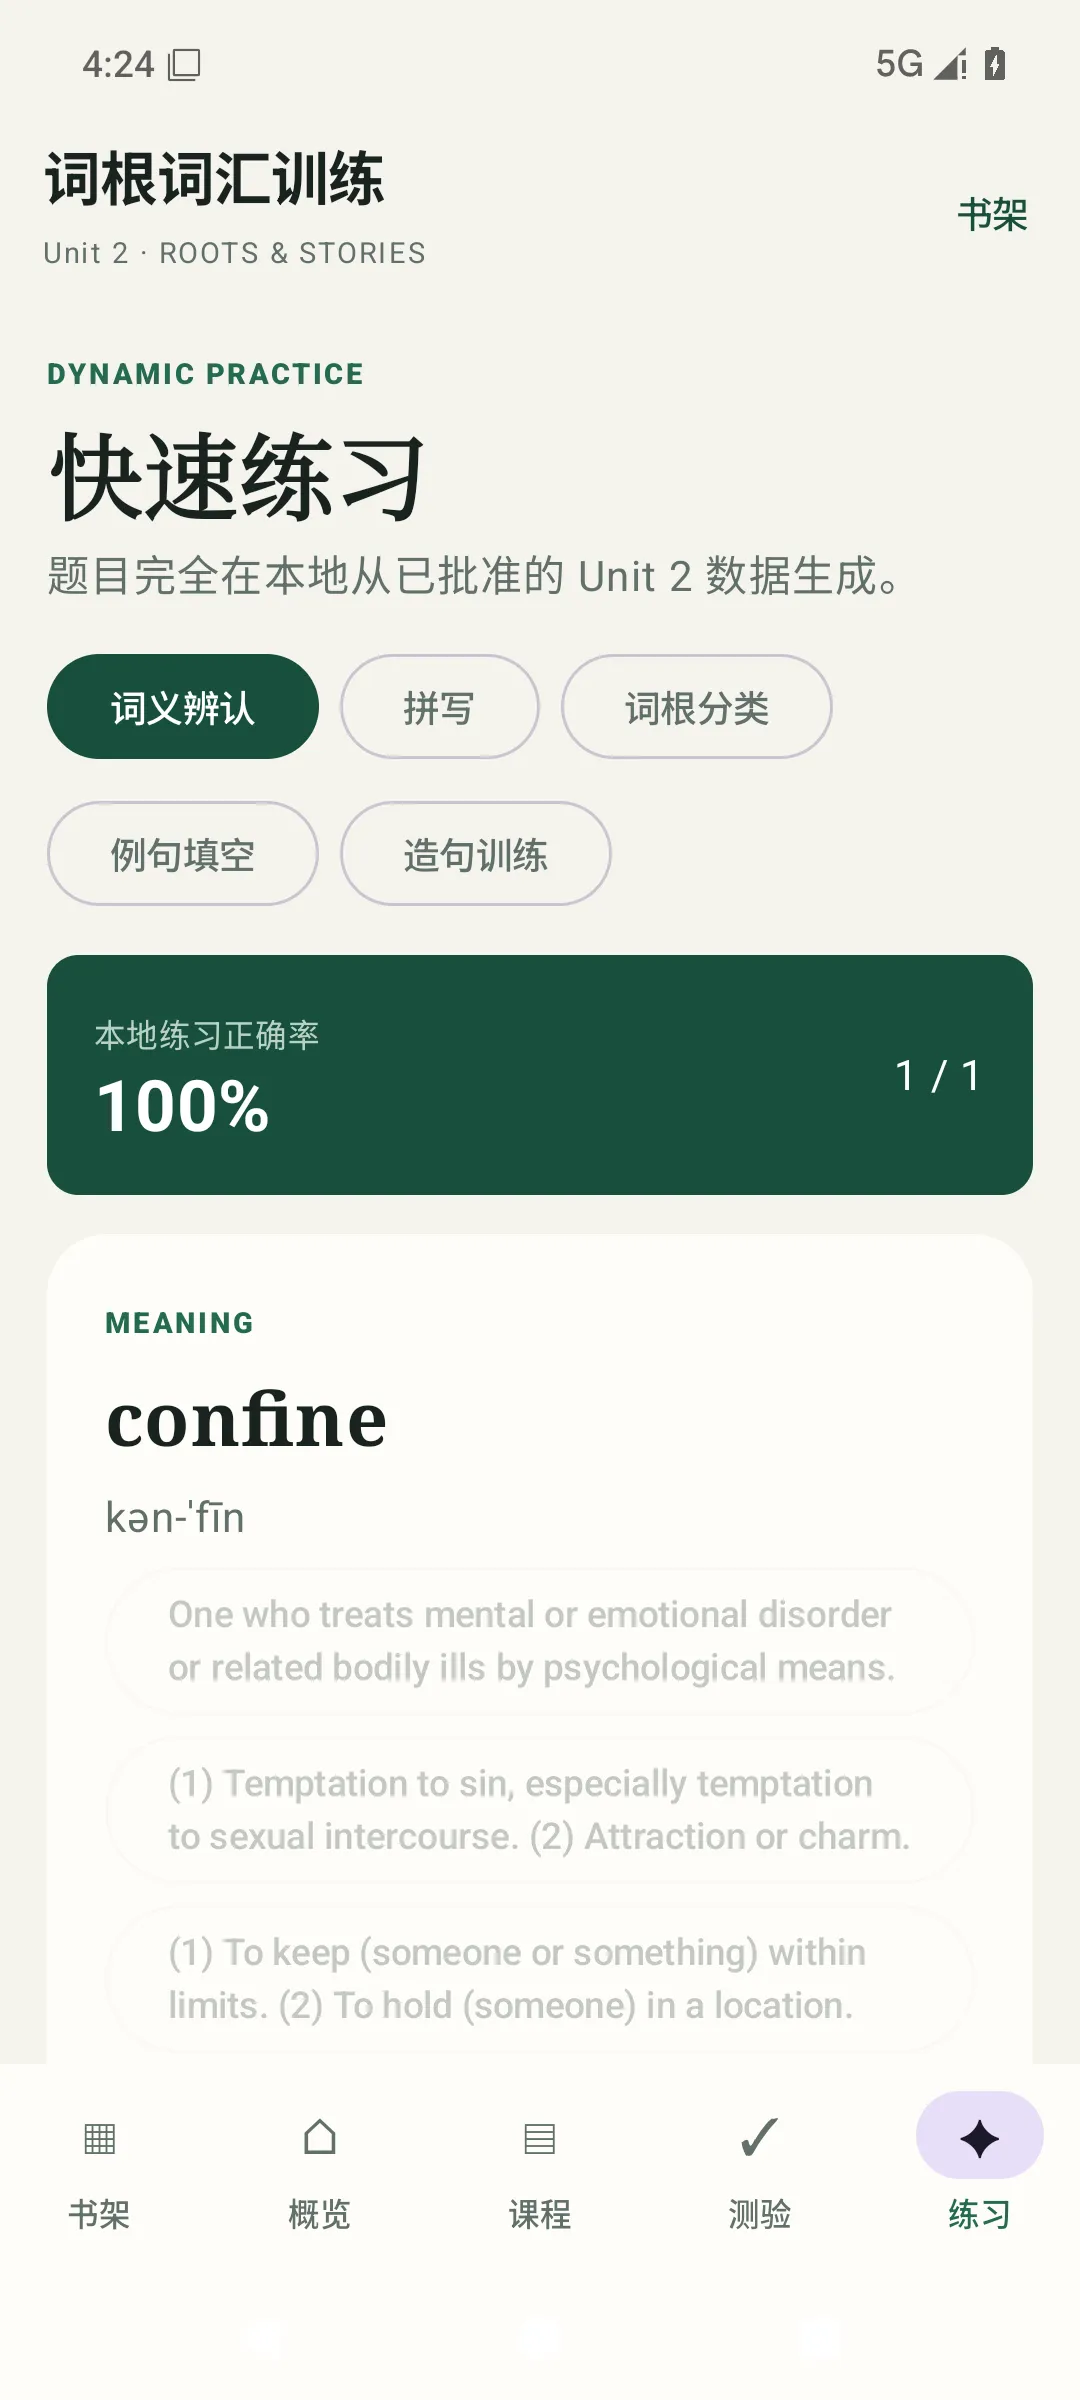
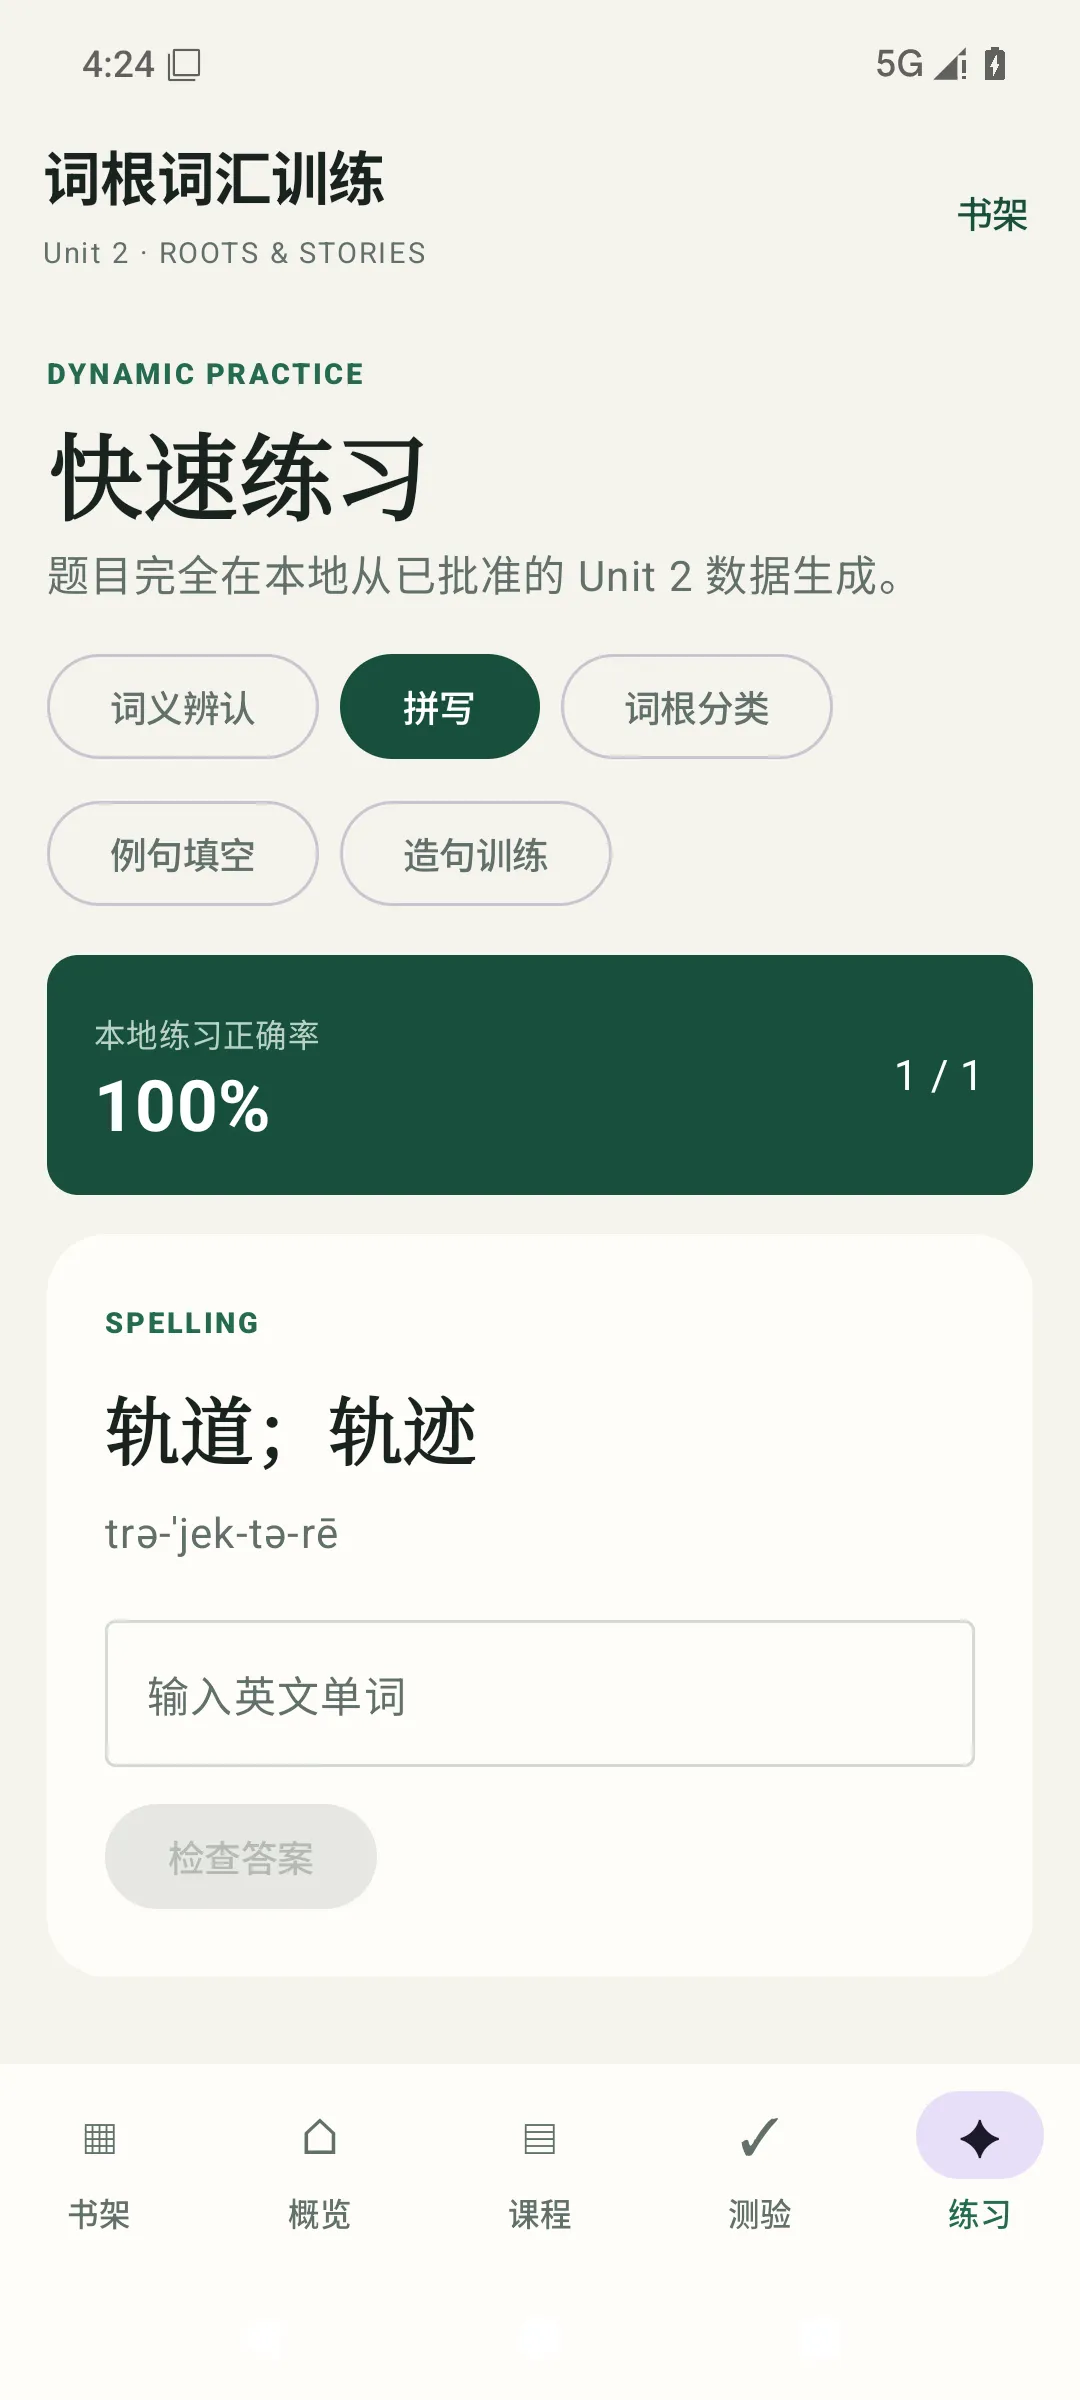
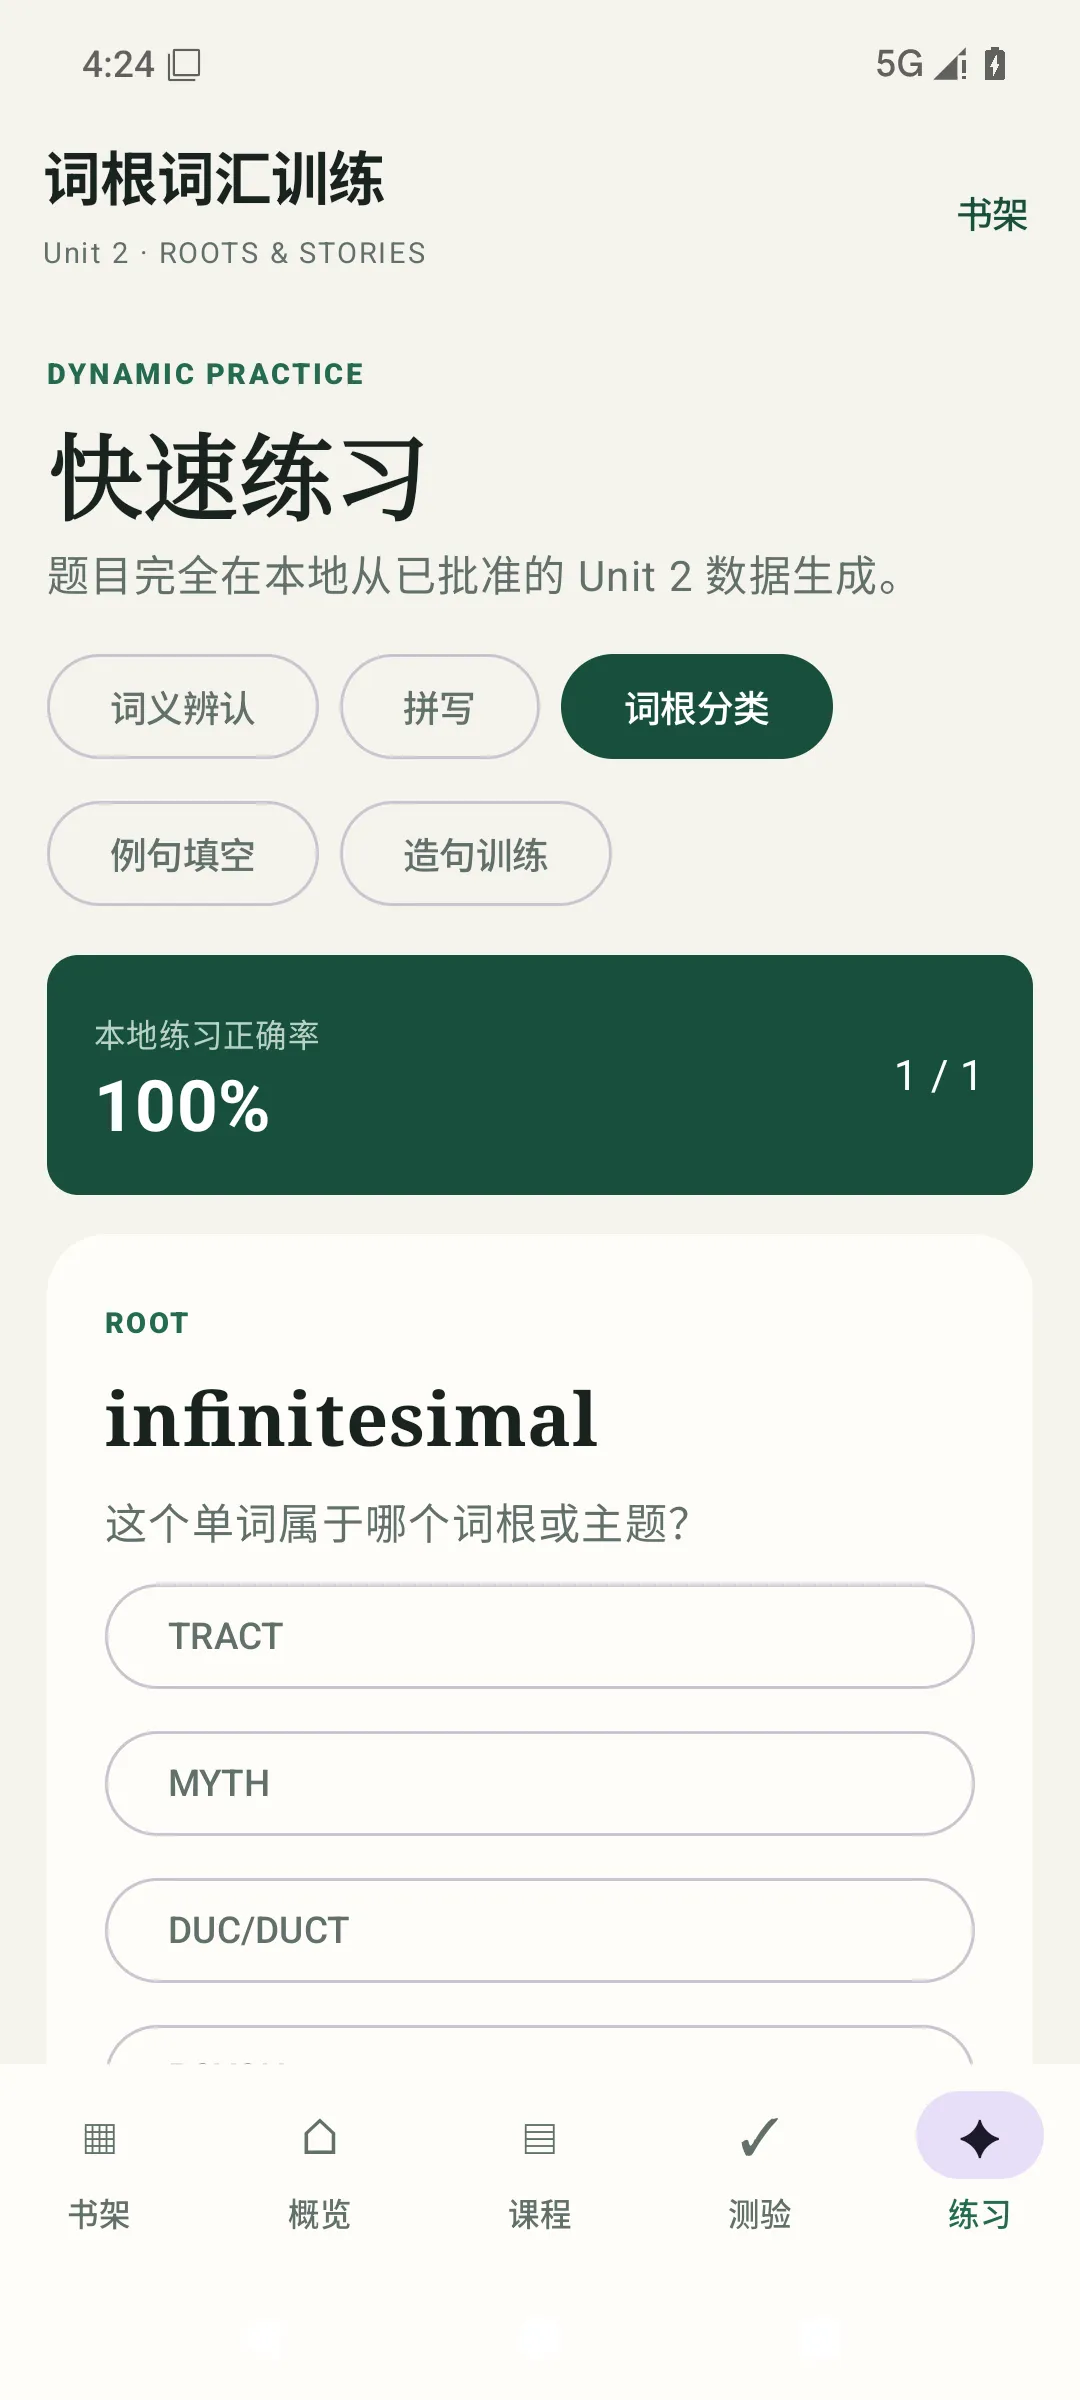
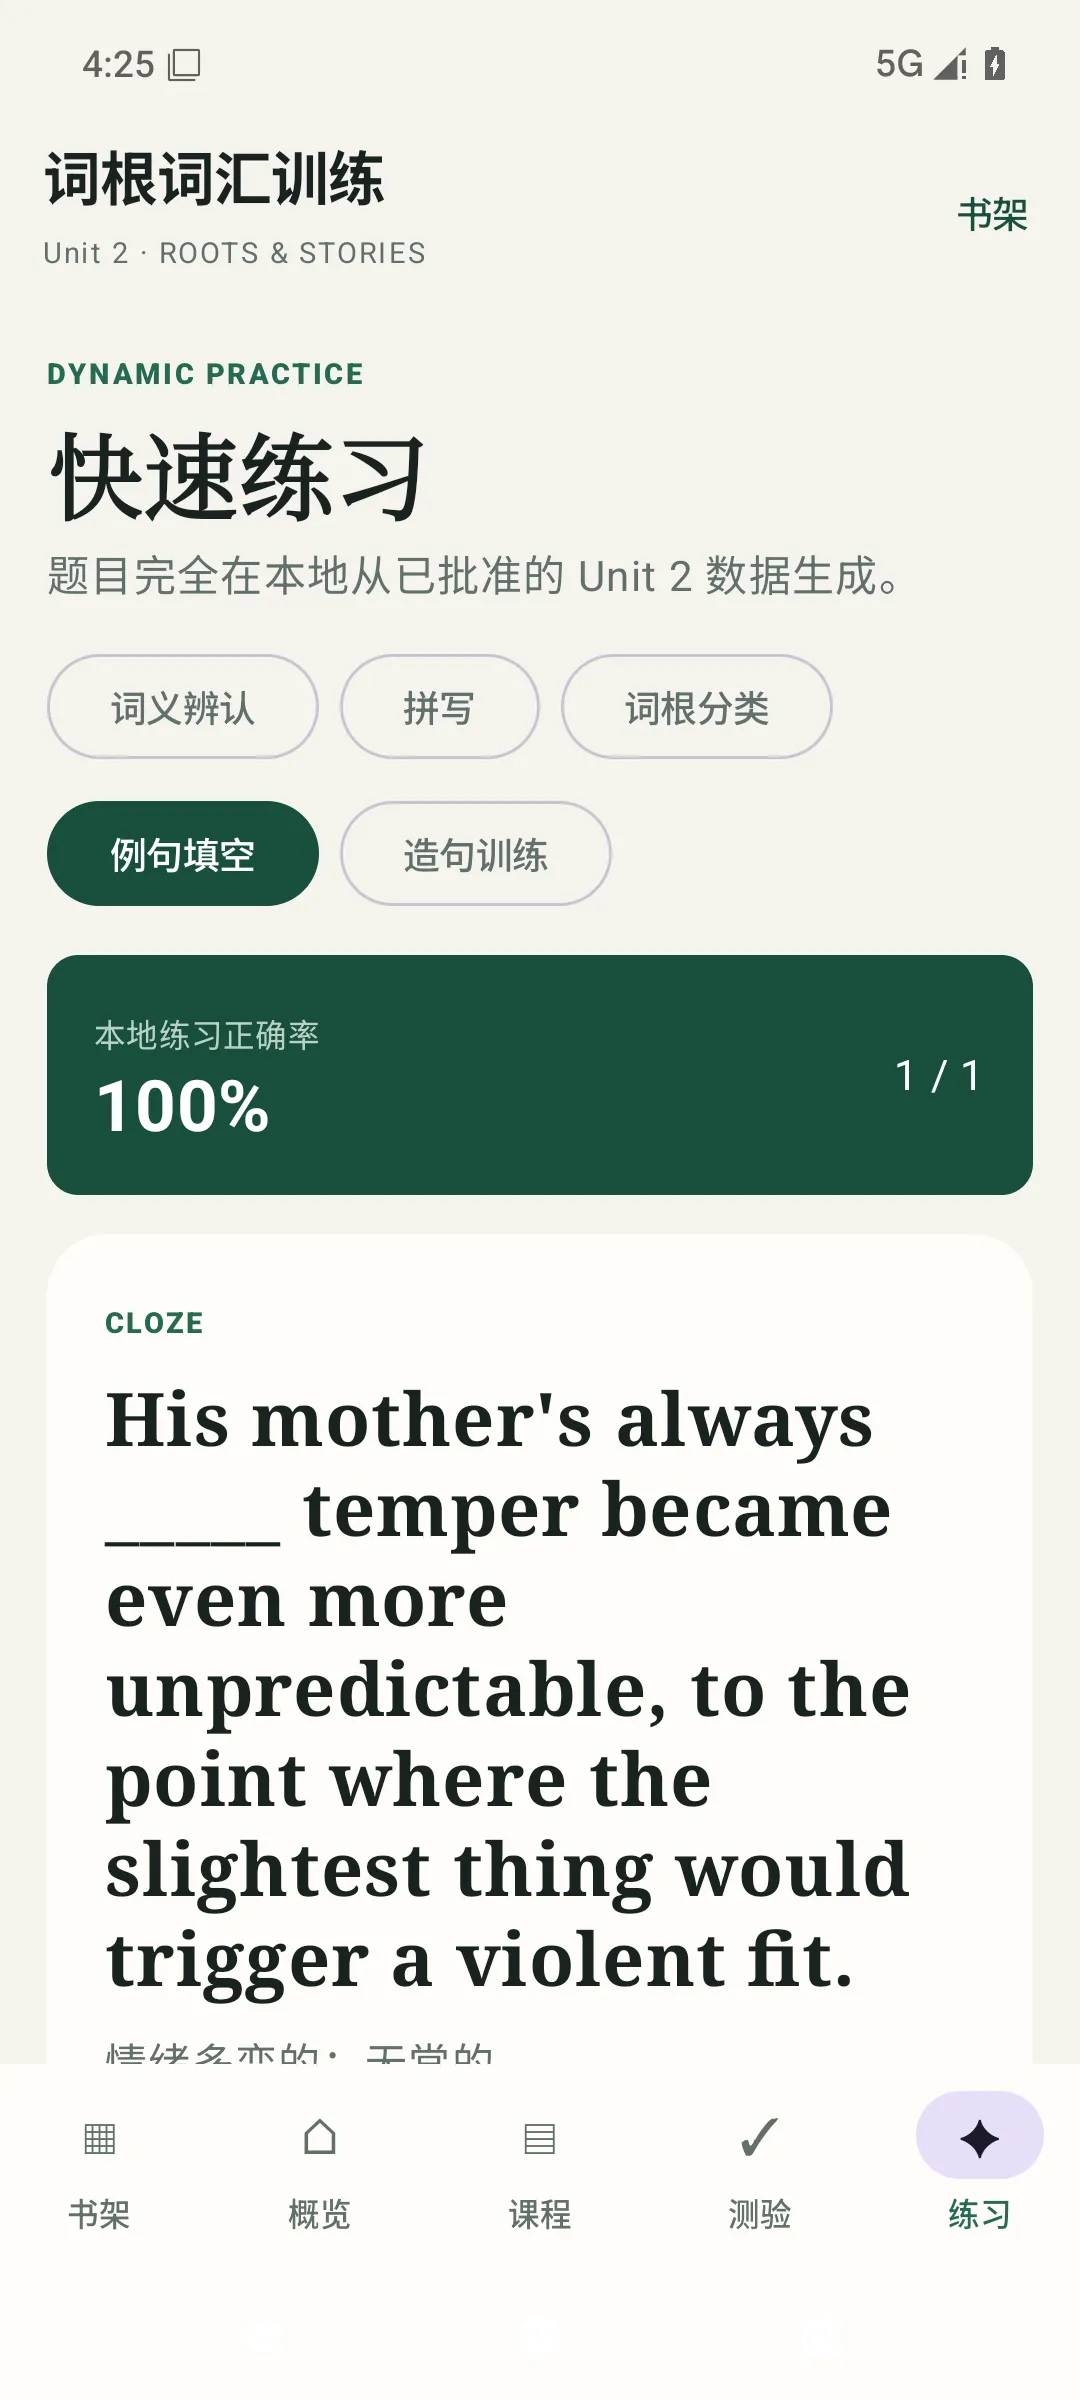
题目从已审核的单元数据里现场出,不要网络,也不会冒出莫名其妙的随机知识。
|
|
|
|
 |
| 图 14 |
四种模式分别练识别、主动回忆、结构归类、语境运用——同一份数据,四条记忆通路。
06 · 写作工坊
 |
| 图 15 |
 |
| 图 16 |
|
|
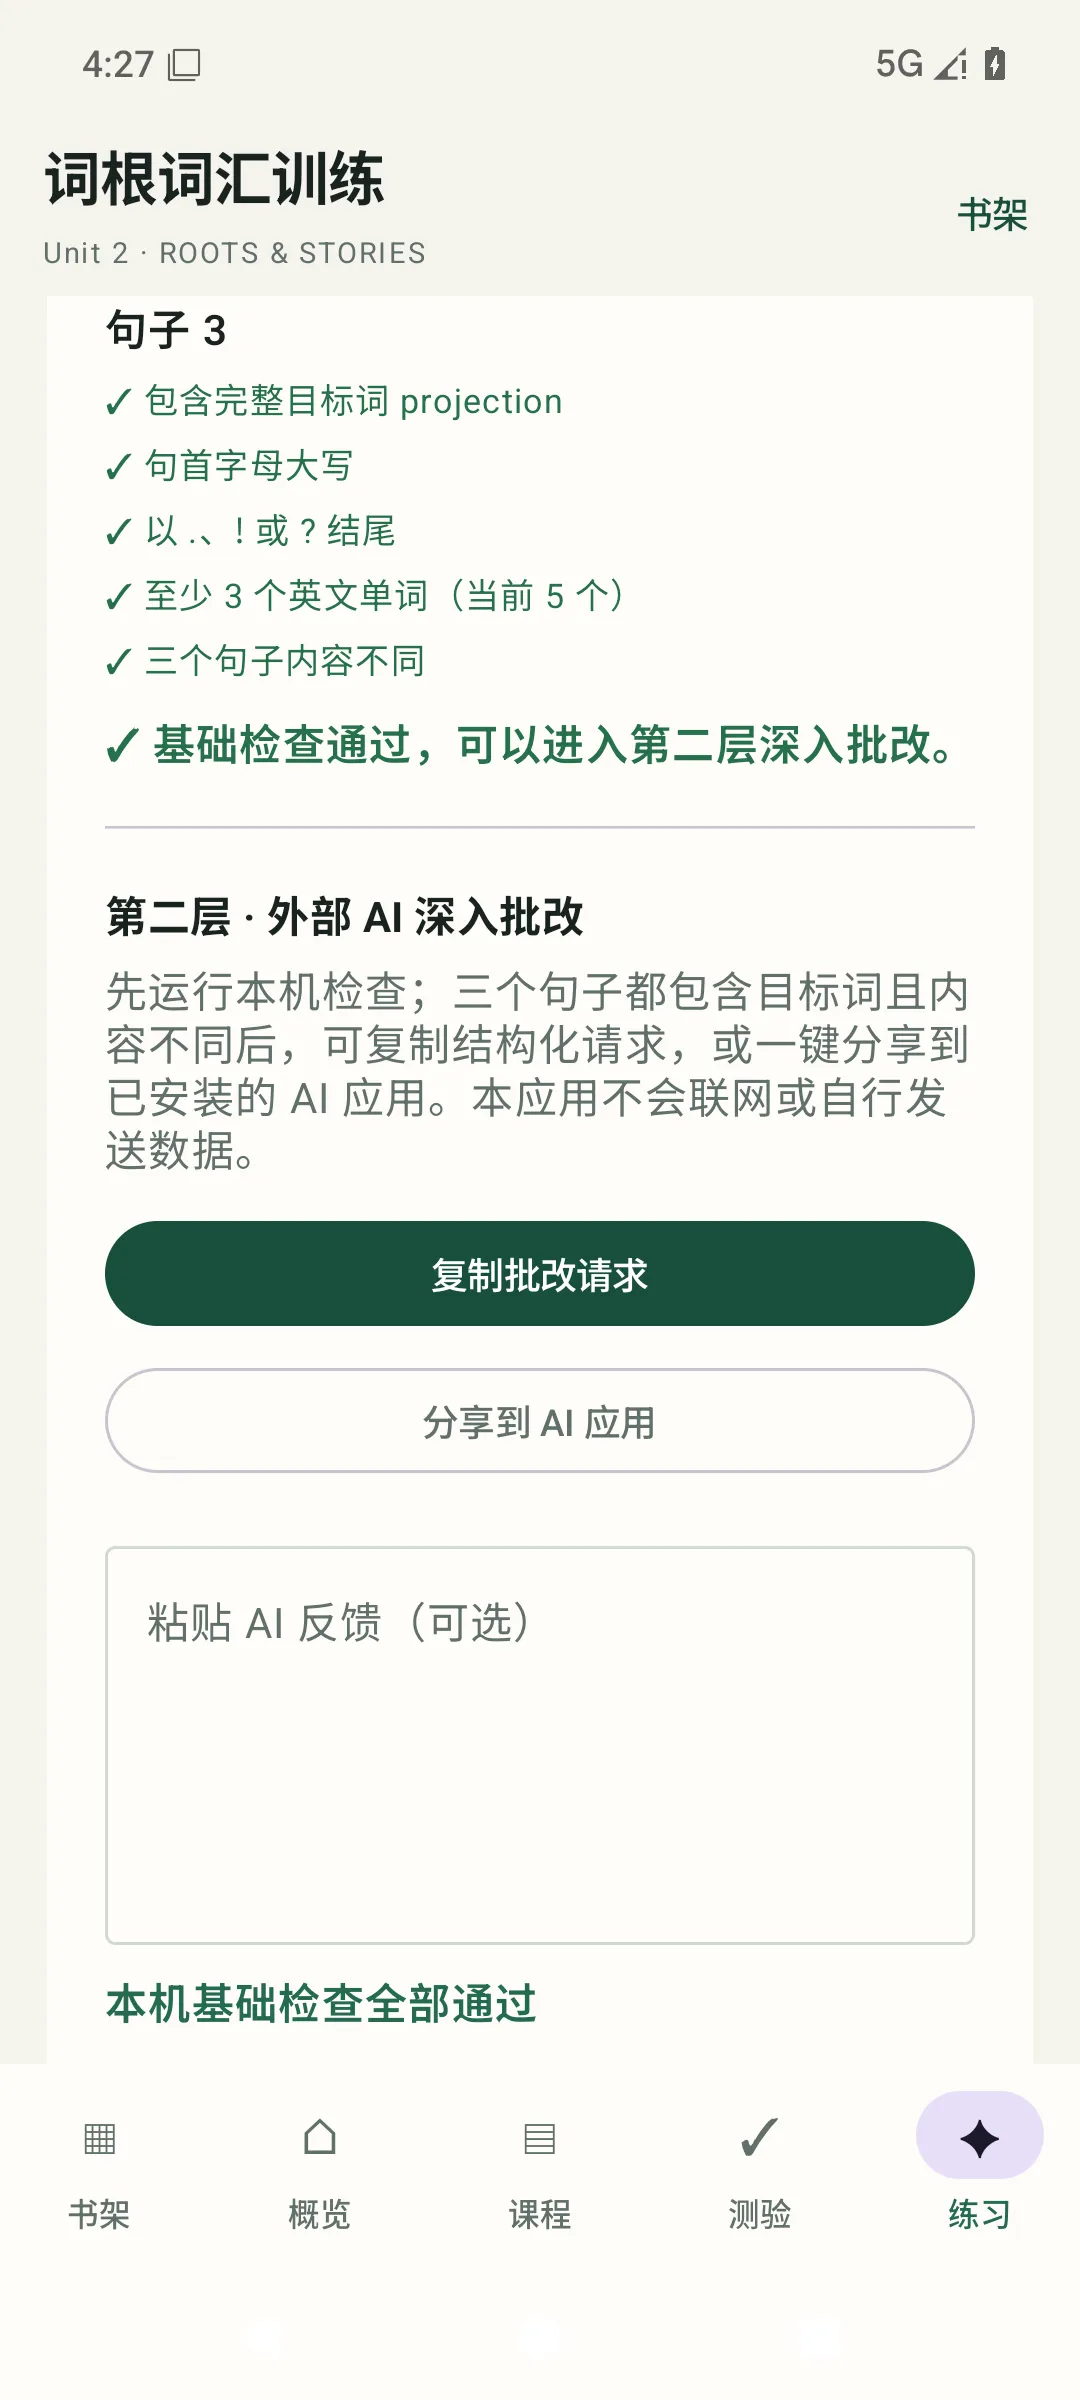
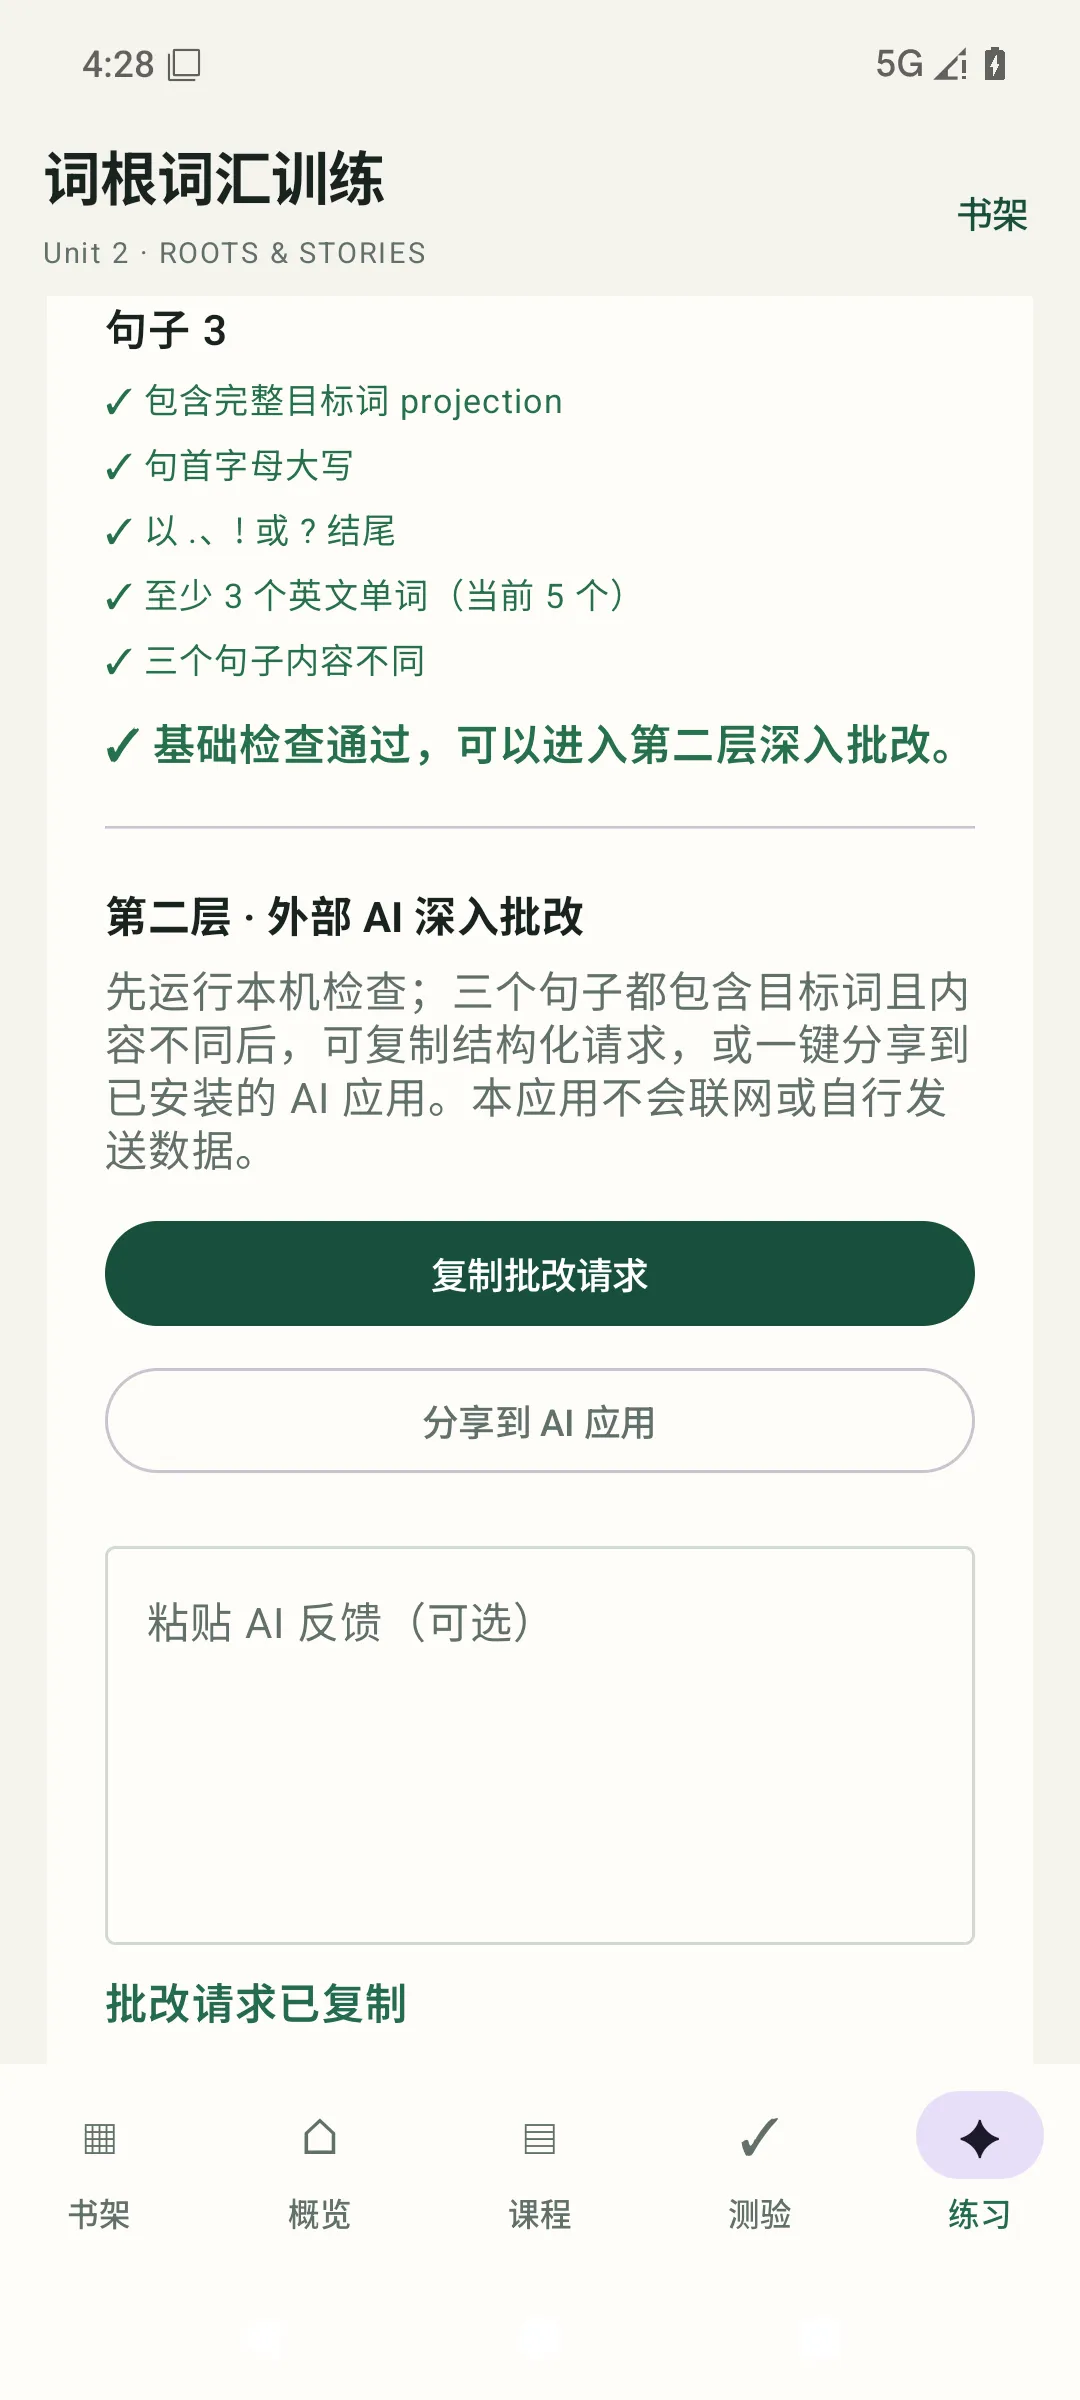
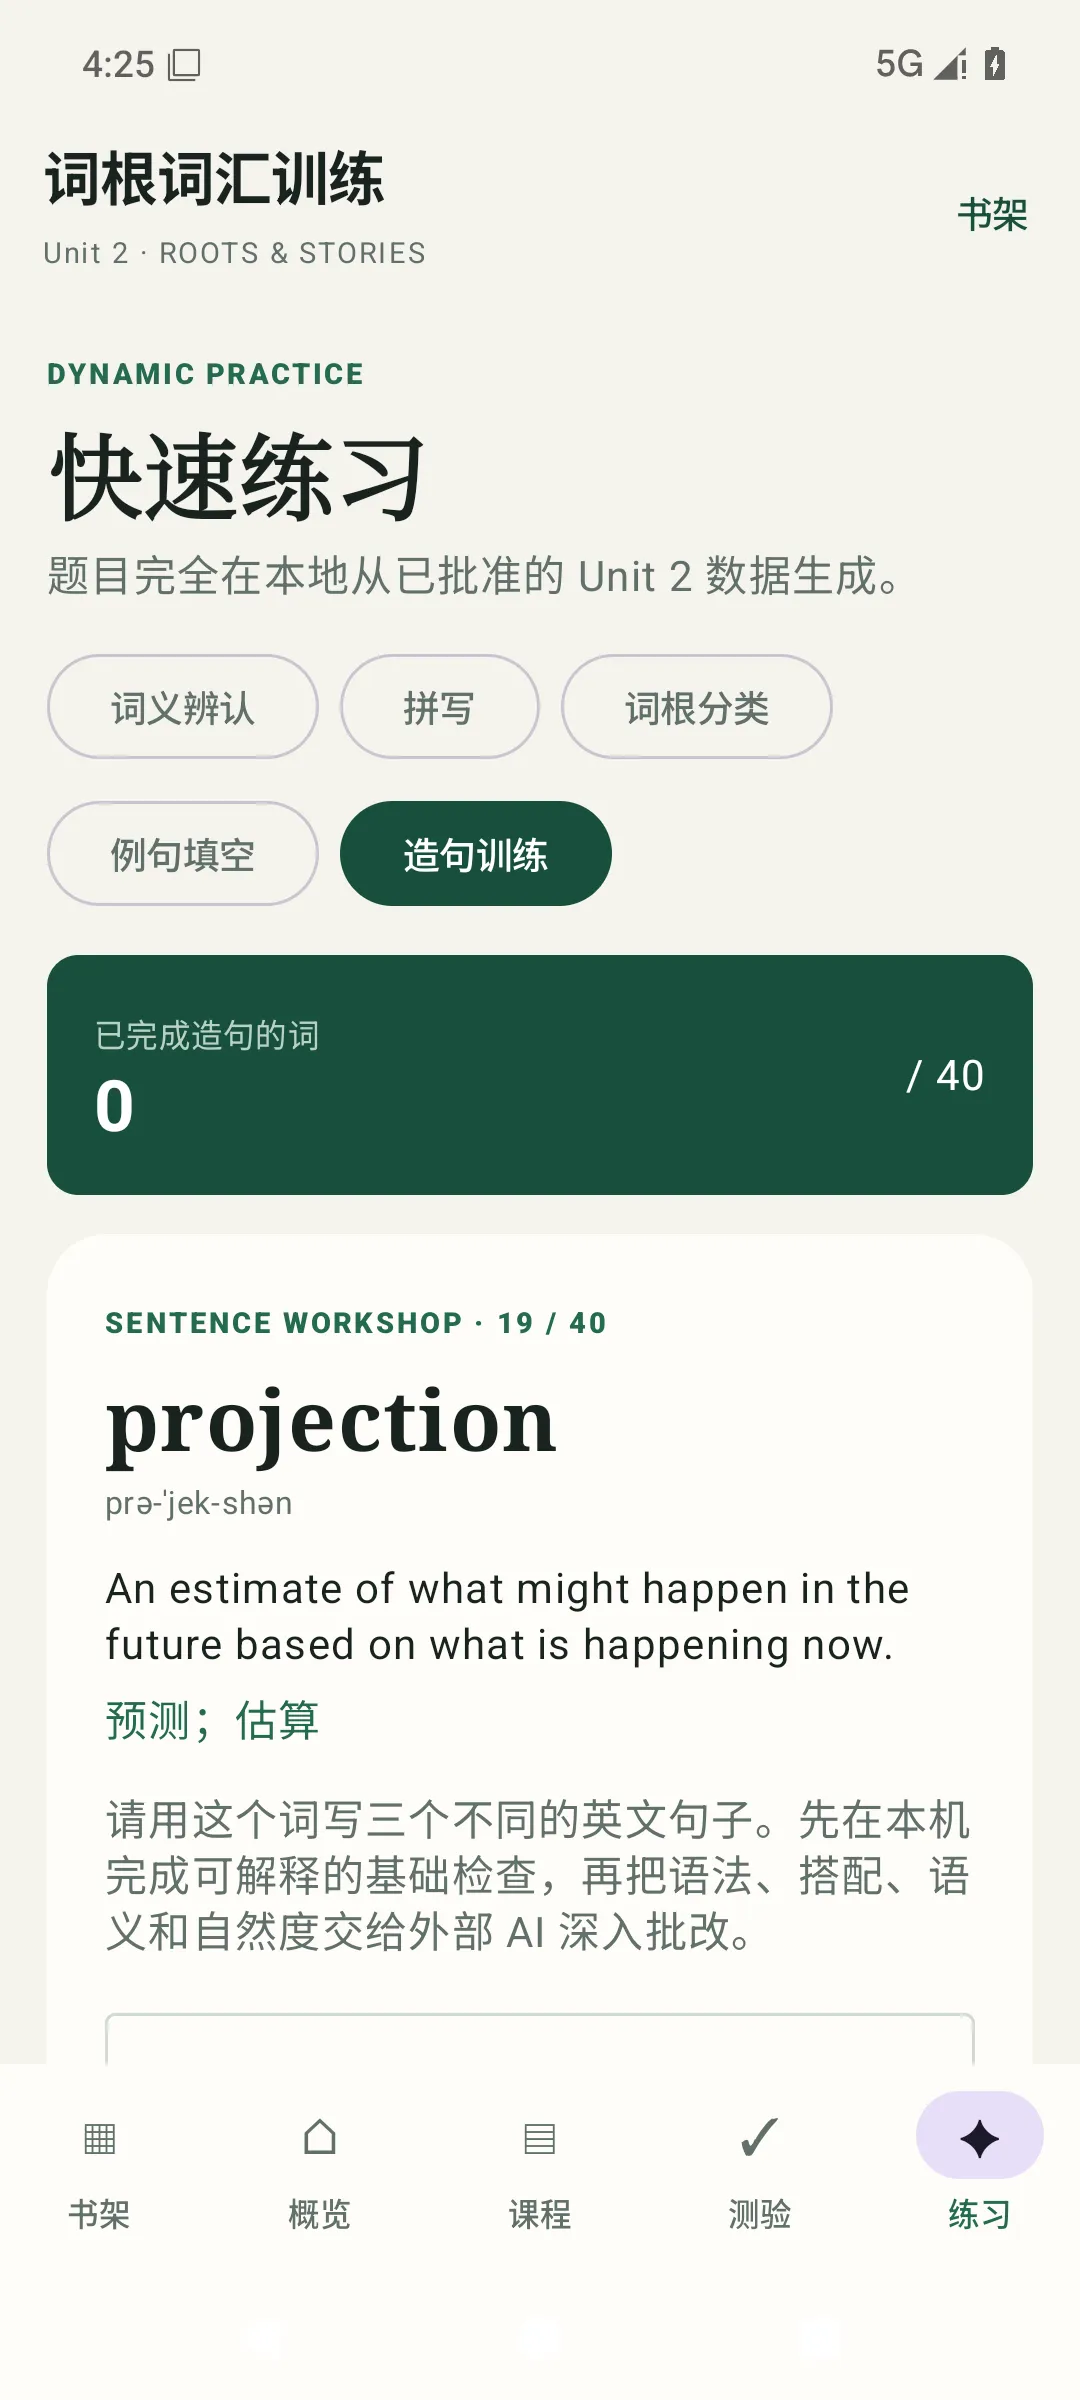
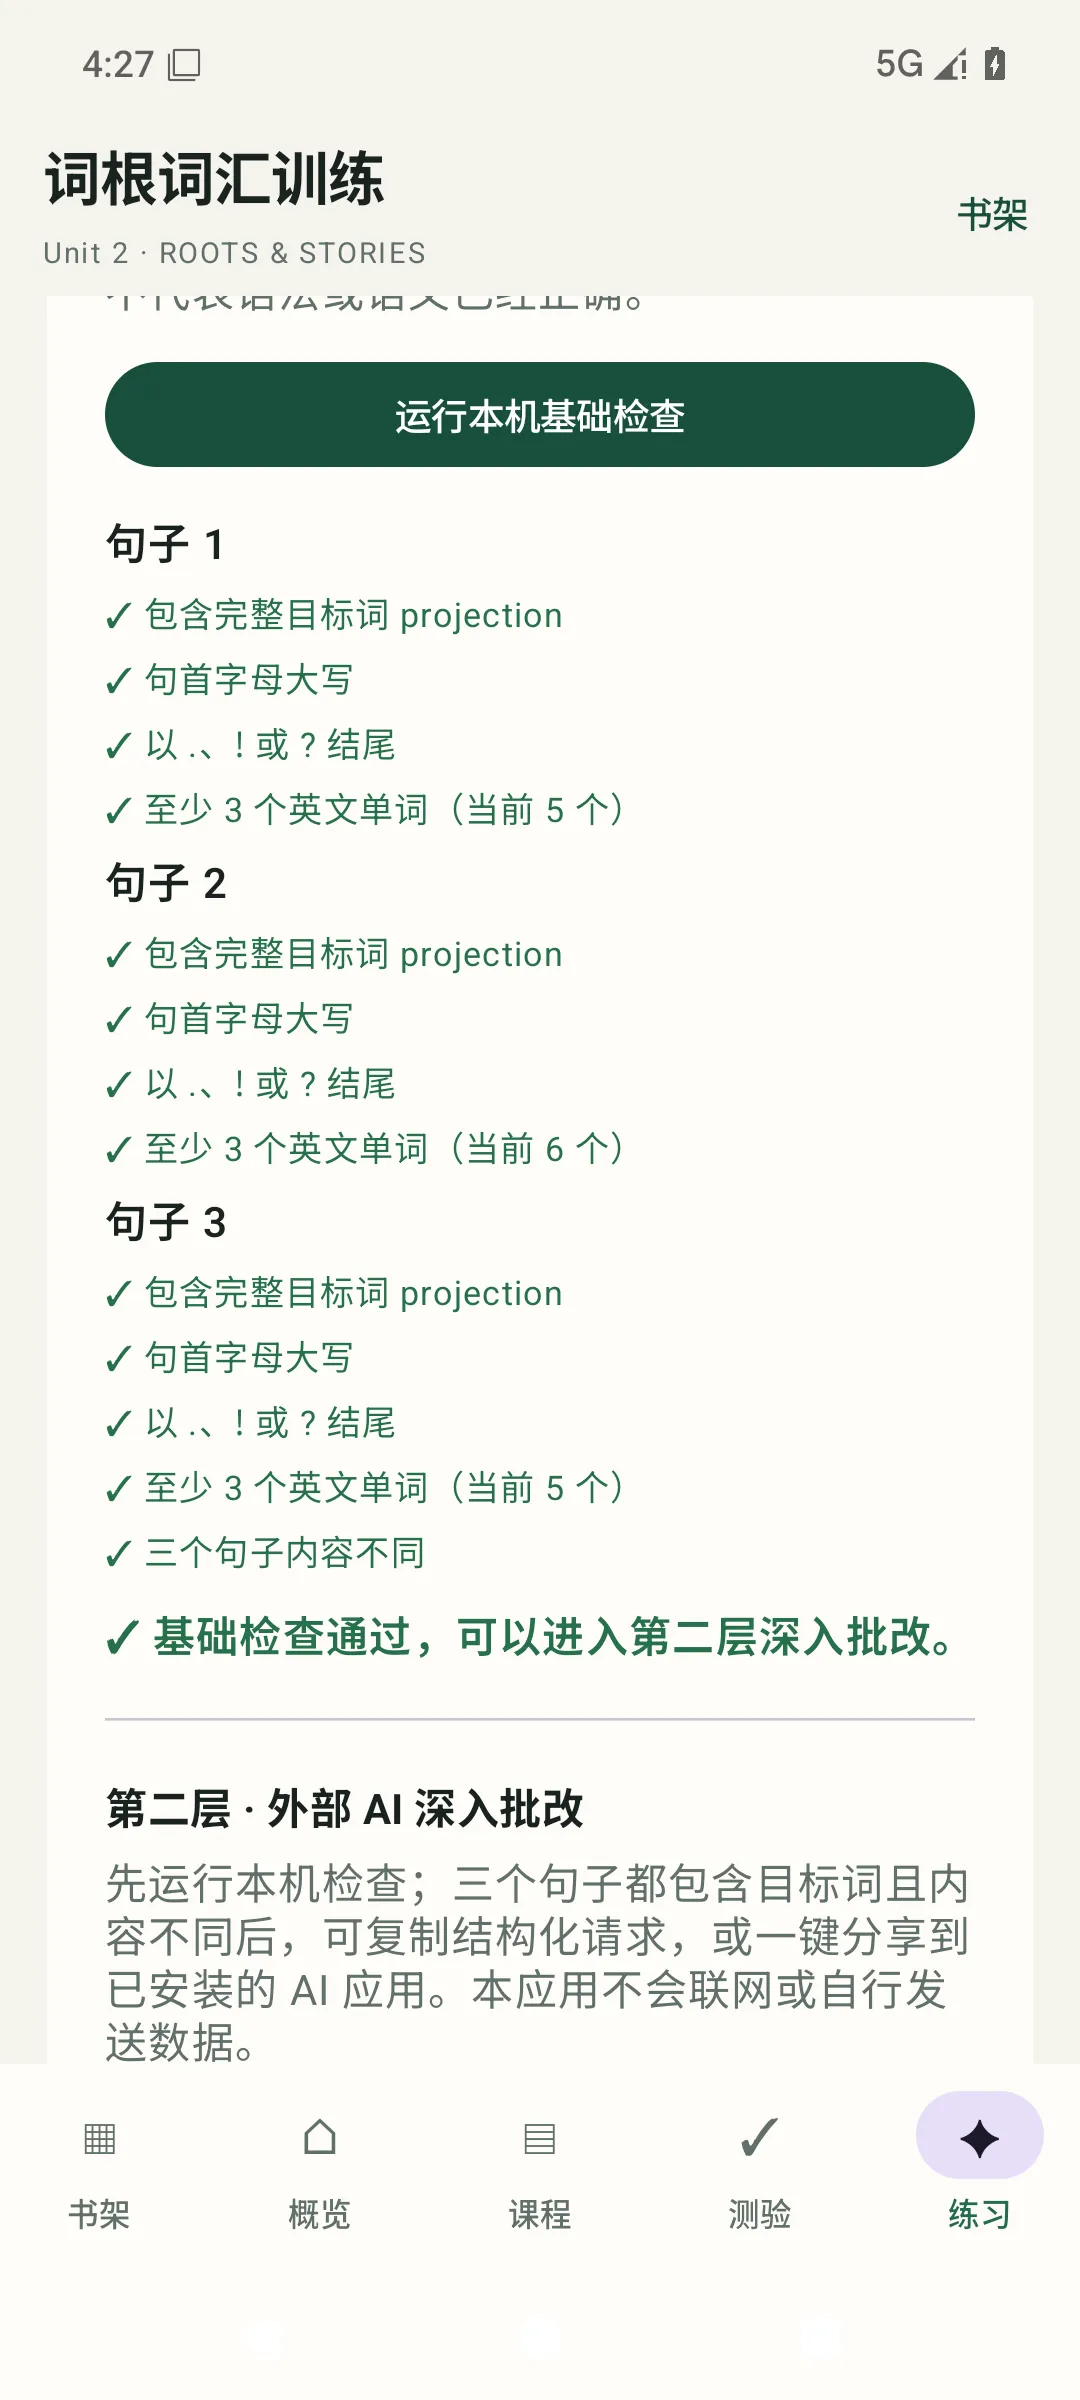
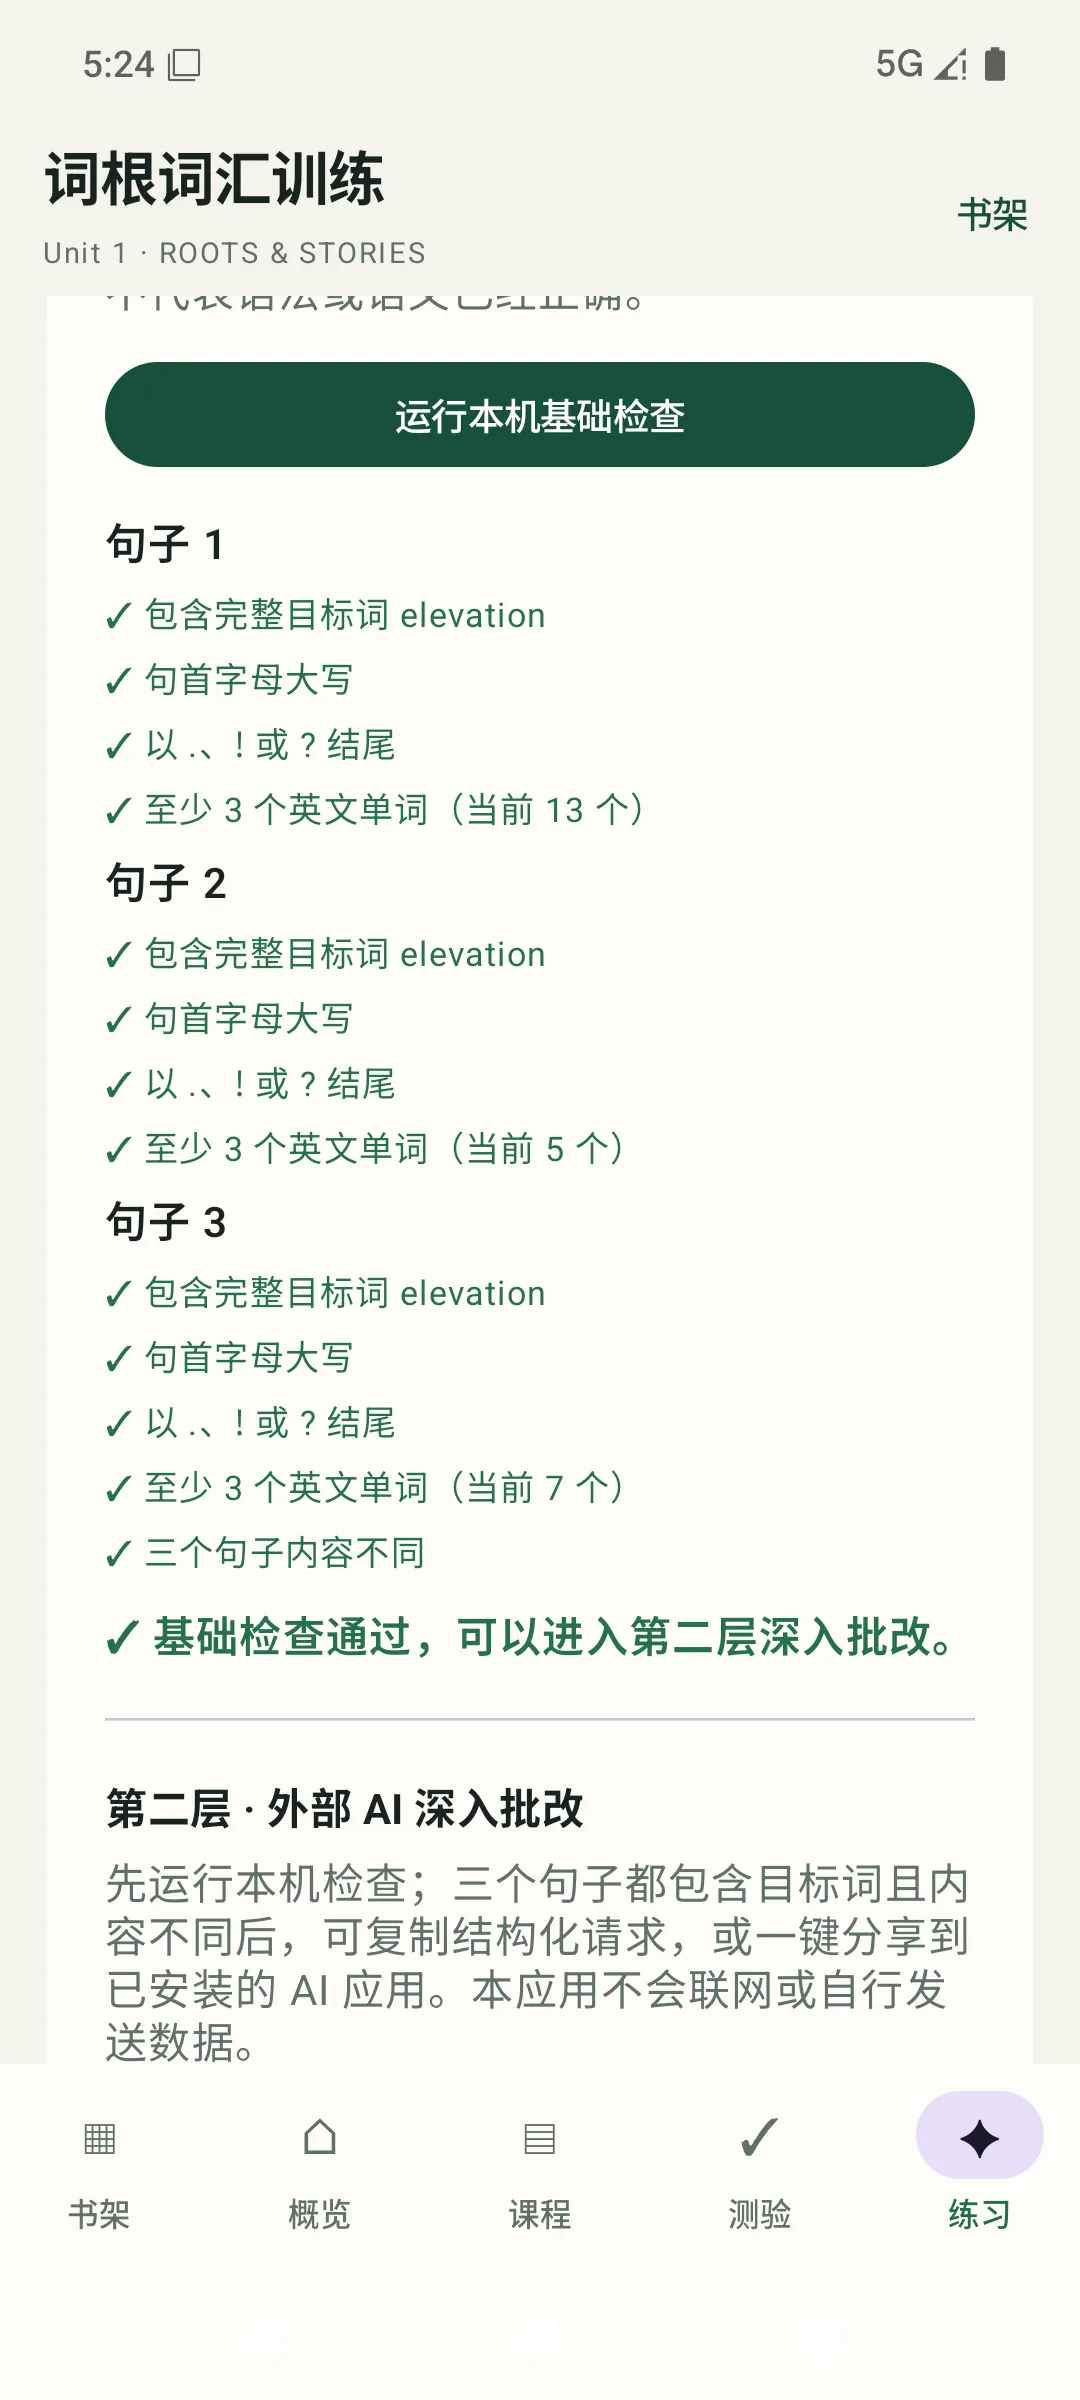
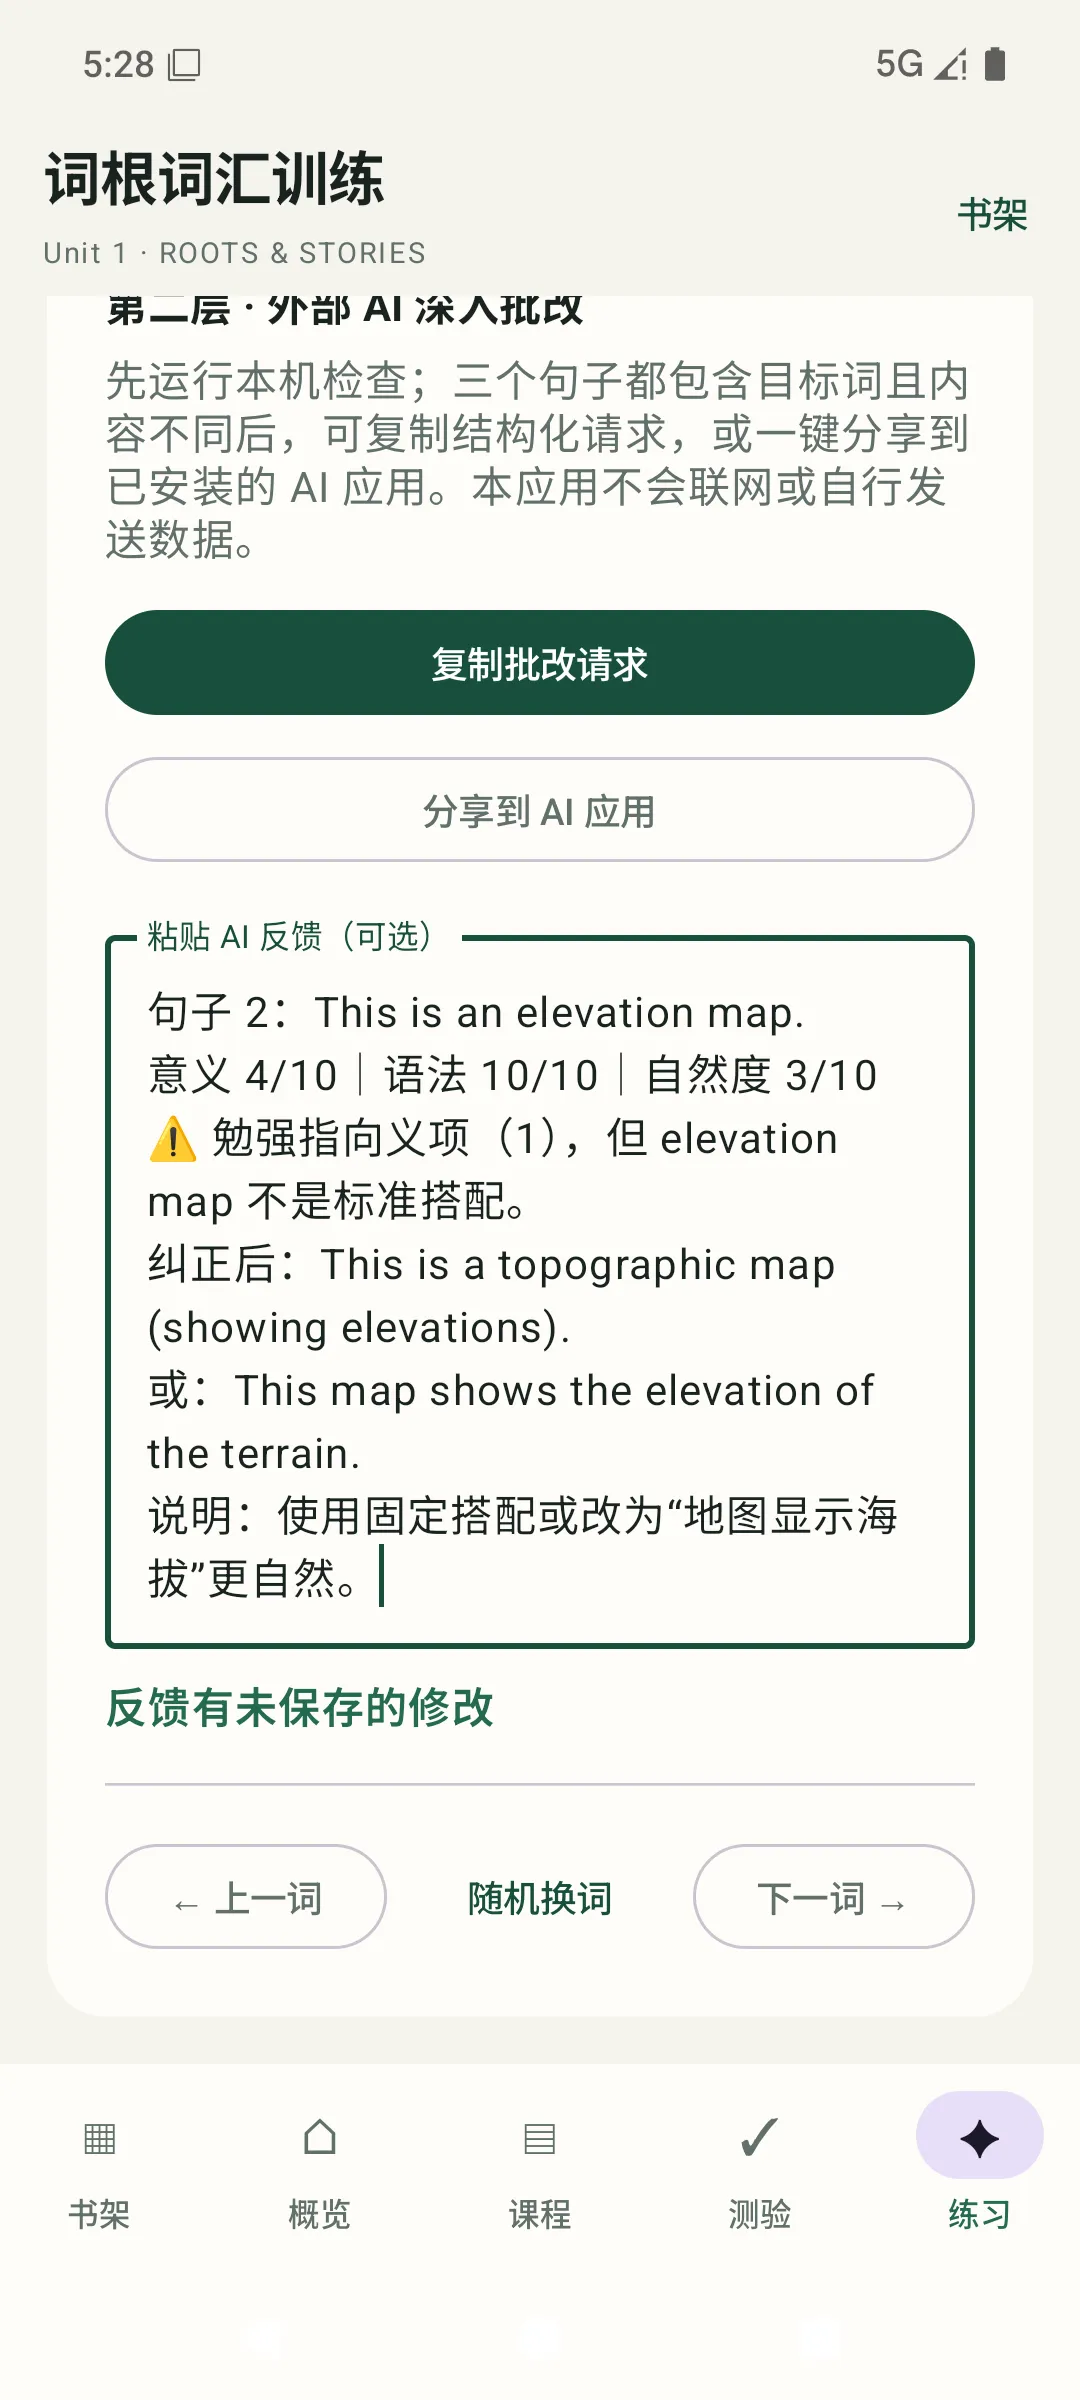
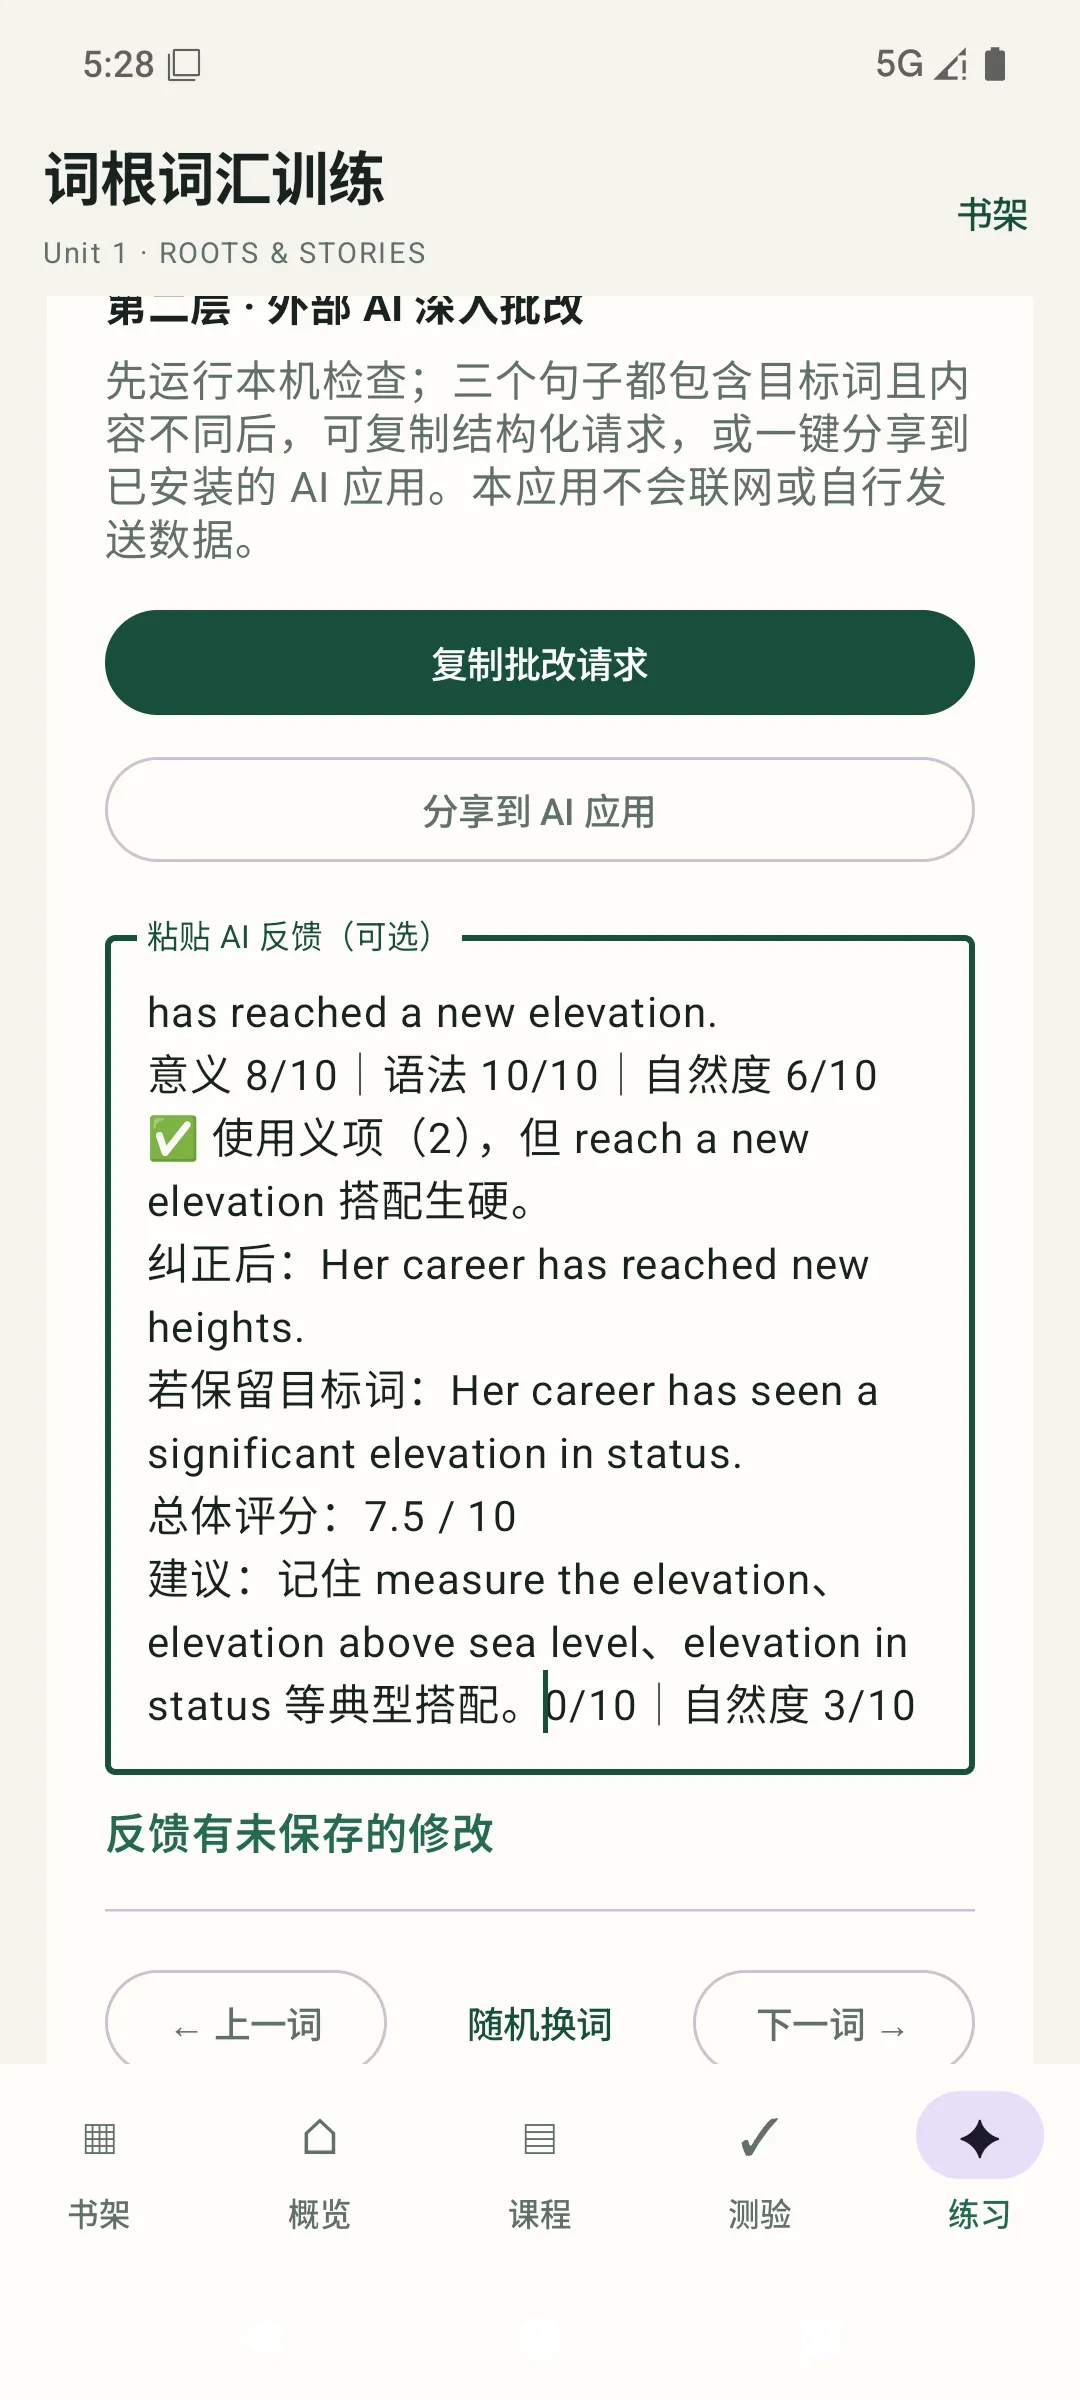
为什么这么绕? 因为简单规则判不了“地不地道”,而一个号称离线的应用又不该偷偷联网调大模型。所以分工:本机管形式,透明、确定、离线;AI 管语感,可选、外部、你说了算。 |
 |
| 图 19 |
|
|
| 图 22 |
07 · 隐私
|
|
所有内容打包进安装包,运行时一个字节都不下载; 应用根本没申请网络权限——想联网都没门; 没有账号、没有统计上报、没有广告、没有云同步; 连系统备份都关了,学习记录不会悄悄跑进云端; 发音用的是手机系统自带的 TTS。
进度和成绩存在本地,靠稳定 ID 挂靠:以后加新单元,旧的学习记录纹丝不动。
08 · 内容工程
这本书有四份来源文件:结构化英文、英文 PDF、双语 PDF、OCR 文本。听起来很多?问题是它们互相打架。双语 PDF 里断词、错字、栏目错序是家常便饭,OCR 更是只能用来定位,不能直接信。
所以规则是:每一段中文、每一个音标、每一道答案,都要对着渲染出来的页面人工核一遍。程序能证明“这个字段有值”,但证明不了“这个翻译是对的”。
内容工程的坑,和搬数据不一样 搬数据的错误是“缺了”;内容工程的错误是“看着挺通顺,其实是错的”——地名对不上、音乐术语翻错、例句整段讲了两件事。这种坑只能靠逐页核对和人来拍板。 |
09 · 生产线
Unit 1是探路:设了六道关卡,从工具链到样本、到完整数据、到网页预览、到原生预览、最后才打包安装。内容不靠谱之前,绝不动手写界面。
Unit 2逼着架构长大:书架、目录、数据驱动课程、双答案题、进度隔离,全在这一步补齐。Unit 3跑通了从审核到上架的完整流水线,还正式复了一次盘。
后面 27 个单元就上了流水线:最多三个单元同时备料,但真机验证只有一条通道,进“正式书架”也只有一条通道。备料可以乱序完成,上架必须按 4、5、6……30 排队——慢的不挡路,快的不插队。
10 · 踩坑记录
- 校验规则太紧也会误伤
:早期规则只认短词条,真实的三词词条被拒收。系统停下来,人工批准后才谨慎放宽——这种“拦错了”比“放错了”值钱。 - 环境抽风 ≠ 产品坏了
:构建缓存、沙箱权限抽风时,正确姿势是记录环境、重跑检查,而不是安慰自己“大概没问题”。 - “我建了任务”不算数
:批处理时一个内部子任务被误当成正式任务,其实根本没启动。从此任务必须绑定外部可见的 ID 和产出物。 - 不可信的草稿整个扔
:词数不对、题目缩水、占位题的旧草稿,不打补丁,回到原书完整重建。 - 格式合法 ≠ 人人会读
:有个字段允许为空数组,结果安卓端压根没处理这种情况,真机一跑就露馅——端到端验证省不得。
11 · 一点感想
模型会不会写代码,不是交付的关键。可信来自另外一些东西:明确的授权、每条结论背后的证据、人来做的内容判断、可复现的构建、受控的并行,以及——证据不够的时候敢于停下来。
- 上下文长不等于记得清
:窗口再长,也分不清“三个月前的禁令”和“昨天的新授权”,项目记忆得按事件建模。 - 批准会漂移
:同意做架构 ≠ 同意批量生产 ≠ 同意发布。授权最好变成机器可检查的清单,而不是靠回忆。 - 并行有隐形成本
:三个任务同时跑,速度不是乘三——模拟器、构建目录、状态文件都是共享的。这个项目最有效的一句话是:
| T | ||
| R | ||
| A | ||
| C | ||
| E |
写在最后
回头看,这个项目做的不只是一个背单词应用。它验证了一件事:当输入是四份互相矛盾的双语材料,当干活的是人加一堆 AI 代理,当任何一处“看着没问题”的错译都会顺着流水线灌进 30 个单元——工程要做的事,远比“生成代码”多。
词根词汇训练 · Roots & Stories 一个私人自用、可侧载、完全离线的安卓词汇学习应用。 文中 24 张截图均来自真机实际操作,未裁切、未拼接、未修图。 ● github.com/Page67/vocabularybuilder_clean 2026 年 8 月 · 私人项目记录 · 想找的人自然知道去哪儿找 |