ARTICLE · 985291
AI光互连超级周期 算力狂奔300倍,连接只跟上30倍 10倍差距如何催生下一个万亿赛道
DEEP RESEARCH · AI INFRASTRUCTURE
一个值得注意的事实:过去三年,AI算力增长了约300倍,而支撑这些算力互联互通的光互连带宽,只增长了约30倍。算力不再卡在「算」,而是卡在「连」。
这10倍的差距,正在催生一个接近万亿美元的市场——光互连超级周期。这不是一个简单的「光纤替代铜缆」的故事,而是一场从芯片封装到数据中心架构的系统性变革。
本文将沿着「为什么需要 → 怎么做 → 谁在选 → 钱在哪 → 往哪走」的逻辑线,讲透AI光互连行业的全貌与未来。
目录
| 1 | 10X Gap:算力狂奔,连接掉队 为什么光互连是AI的下一个瓶颈 |
| 2 | 脑灰质与脑白质:自然界的答案 人脑1:1的比例揭示了AI的未来 |
| 3 | 三个维度:Scale Up / Out / Across 不同距离、不同带宽、不同方案 |
| 4 | 光进铜退:物理极限不可逾越 铜缆的尽头,就是光的起点 |
| 5 | 三种路线:可插拔 → NPO → CPO 光接口应该离主芯片有多近 |
| 6 | 经济账:省在互联 = 牺牲算力 为什么大厂争相砸钱做光互连 |
| 7 | 带宽增长双维度:更快 + 更宽 12.8T不是终点,是起点 |
| 8 | OCS vs 电交换:光路直通的新范式 Google的超级大脑实验 |
| 9 | 万亿价值链与行业展望 蛋糕在哪、瓶颈在哪、未来在哪 |
CHAPTER 01
10X Gap:算力狂奔,连接掉队
为什么光互连是AI的下一个瓶颈
算力的发展已经不能只靠单个芯片。过去三年,AI算力大约增长了300倍——从GPT-3时代的训练需求,到今天百万GPU集群的规模。但支撑这些GPU之间数据传输的光互连带宽,只增长了约30倍。
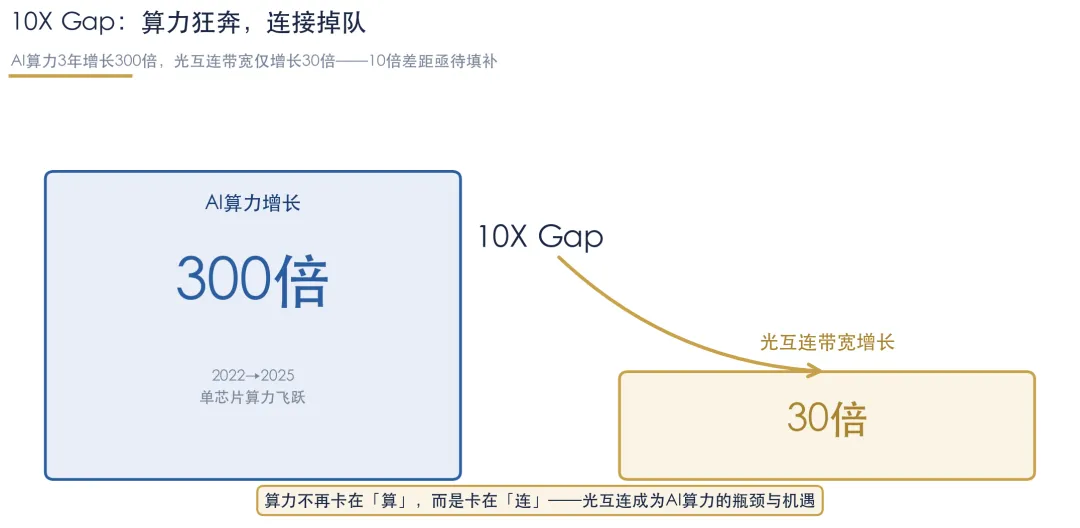
图1:算力增长300倍 vs 光互连增长30倍,10倍差距亟待填补
这意味着什么?大量GPU的计算能力被闲置——因为数据传不过去,算力就在等待。就像建了一座超级工厂,但门口的路太窄,原材料进不来、产品出不去。
核心洞察
算力不再卡在「算」,而是卡在「连」。这10倍差距就是光互连超级周期的根本驱动力——不是锦上添花,而是算力能否释放的瓶颈。
更关键的是,这个差距还在扩大。算力按照摩尔定律(甚至超越)持续增长,而互连带宽的增速跟不上。如果光互连不加速突破,算力增长越多,浪费越大。
CHAPTER 02
脑灰质与脑白质:自然界的答案
人脑1:1的比例揭示了AI的未来
自然界早已给出了答案。在人脑中,负责计算的「脑灰质」和负责连接的「脑白质」的比例大约是1:1。这意味着,对高度智慧的生物来说,连接的投入与算力一样重要。
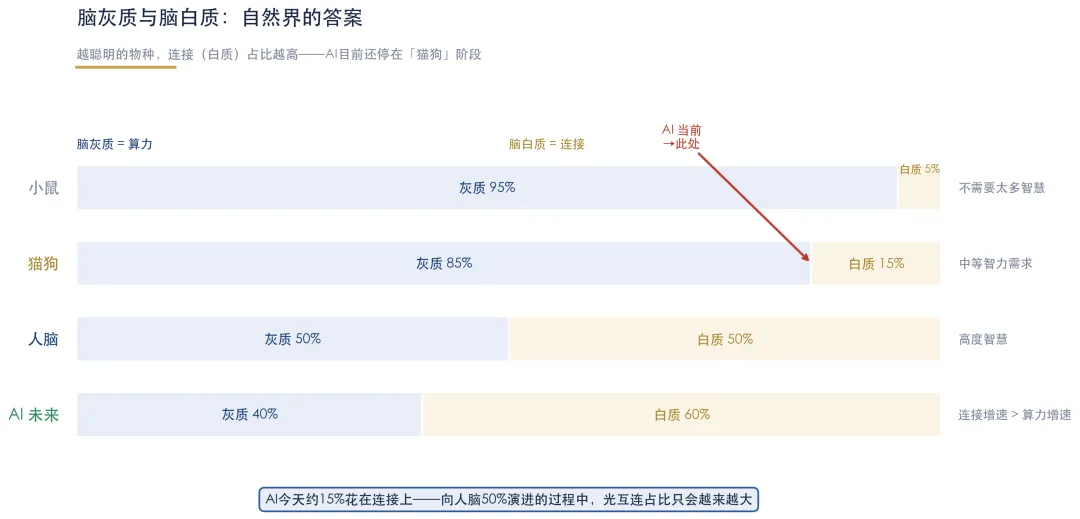
图2:从小鼠到人脑,白质占比持续增加——AI正处于「猫狗」阶段
对比来看,小鼠的脑白质占比极低——它不需要太多智慧,连接投入也很少。猫狗的白质占比约10-20%,而到了人脑,白质和灰质几乎1:1。
核心洞察
AI今天还停留在「猫狗」阶段——连接投入远低于算力投入。随着AI系统越来越复杂,连接的增速将超过算力增速,光互连在整体算力支出中的占比只会越来越大。
这也意味着一个重要的认知转变:光互连不应被视为算力的「附属品」或「成本中心」,而应被视为算力的有机组成部分——就像脑白质不是脑灰质的附属,而是智慧本身不可或缺的一部分。
CHAPTER 03
三个维度:Scale Up / Out / Across
不同距离、不同带宽、不同方案
AI算力的扩展可以分为三个维度,每个维度对光互连的需求不同:
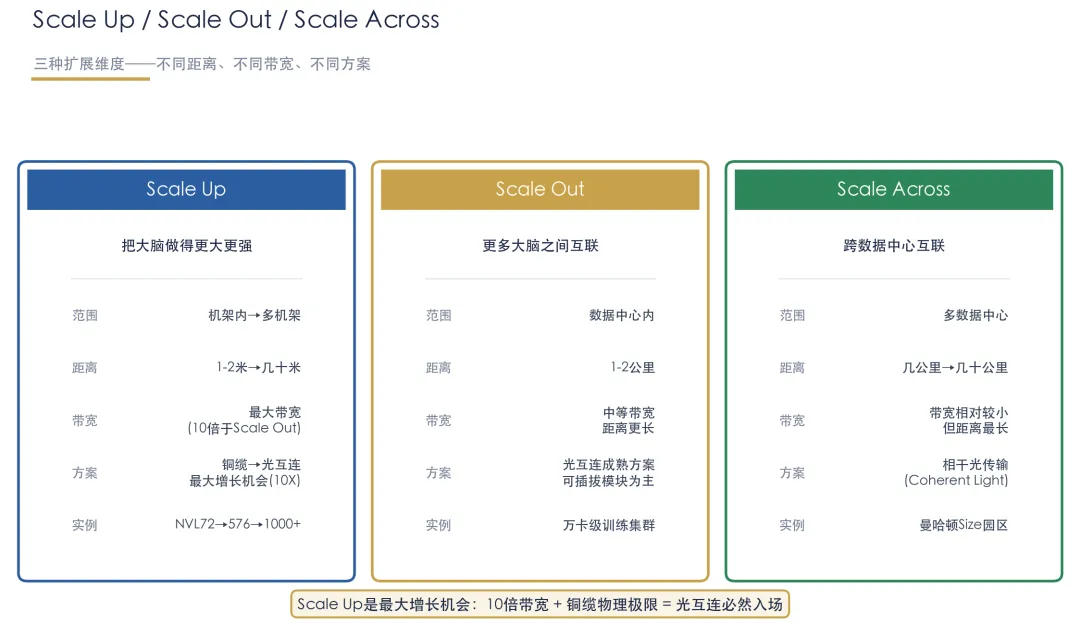
图3:Scale Up/Out/Across——三种扩展维度,三种光互连需求
Scale Up(纵向扩展)——把单个系统做得更大更强,从机架内到多机架。这是带宽需求最大的场景,也是最大的增长机会。传统上用铜缆连接,但随速率提升,铜缆物理距离急剧缩短,光互连必然入场。
Scale Out(横向扩展)——数据中心内部,更多节点之间互联。距离1-2公里,光互连已有成熟方案(可插拔光模块为主),是当前最大出货量场景。
Scale Across(跨域扩展)——跨数据中心互联,几公里到几十公里。带宽需求相对较小,但距离最长,需要相干光传输技术。
Scale Up是最大增长机会:10倍带宽需求 + 铜缆物理极限 = 光互连的必然入场。这就是为什么英伟达NVLink从铜缆转向光互连是迟早的事。
CHAPTER 04
光进铜退:物理极限不可逾越
铜缆的尽头,就是光的起点
行业有一句经典的话:「能用铜的时候用铜,必须用光的时候用光」(Use copper when you can, use optics when you must)。原因很简单:铜便宜、成熟、供应链完善。但铜有一个无法逾越的物理极限——速率越高,能传输的距离越短。
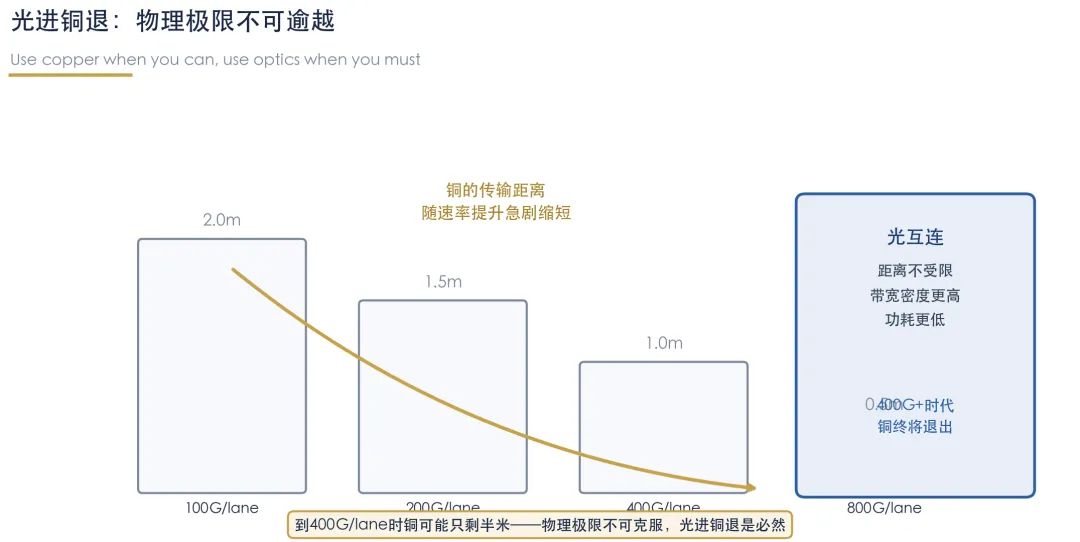
图4:铜的传输距离随速率提升急剧缩短——400G时代铜可能只剩半米
在100G/lane时代,铜缆还能传2米,足够覆盖机架内连接。到200G/lane缩短到1.5米,勉强够用。到400G/lane,可能只剩0.5米——连机架内的距离都快覆盖不了了。
核心洞察
到400G/lane时,铜的传输距离可能只剩半米——这不是工程问题,是物理问题,无法通过工艺优化解决。光进铜退是必然。
这就是为什么整个行业正在经历一场「光进铜退」的系统性变革。不是因为光比铜更好(实际上光更贵、更复杂),而是因为铜已经到了物理极限,光是唯一的选择。
CHAPTER 05
三种路线:可插拔 → NPO → CPO
光接口应该离主芯片有多近
确定了「要用光」之后,下一个问题是:光接口应该放在哪里?离主芯片(ASIC/GPU)有多近?这决定了三种技术路线的分化。
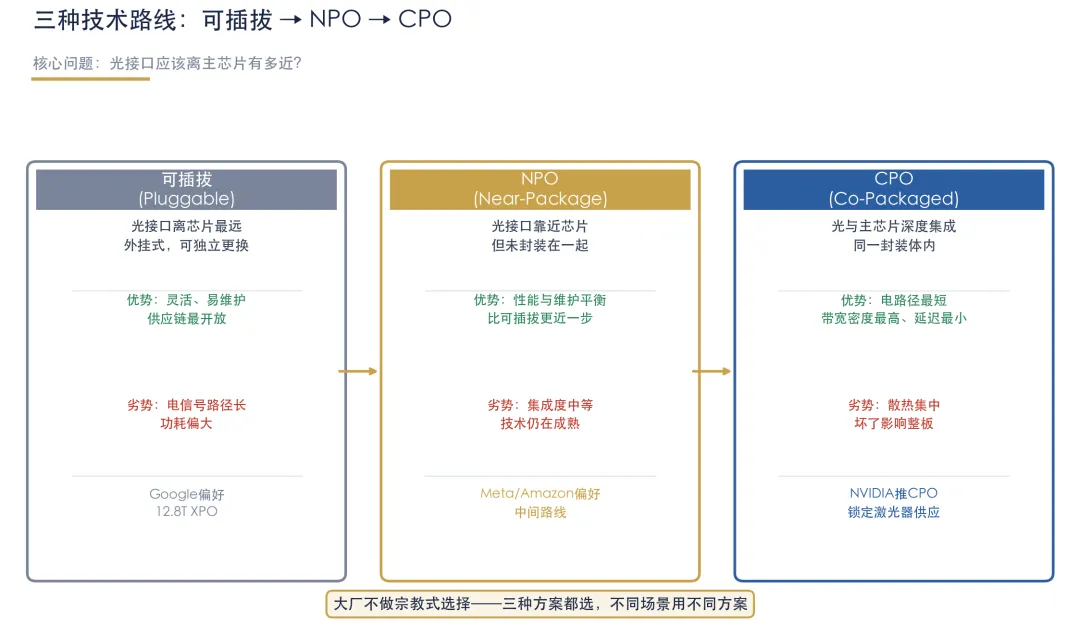
图5:可插拔→NPO→CPO——从外挂式到深度集成
可插拔(Pluggable)——光模块作为独立组件插在交换机面板上,离主芯片最远。优势是灵活、易维护、供应链最开放;劣势是电信号路径长,功耗偏大。
NPO(Near-Package Optics)——光接口靠近芯片但未封装在一起。性能与维护的平衡点,比可插拔更近一步,是中间路线。
CPO(Co-Packaged Optics)——光与主芯片深度集成在同一封装体内。电路径最短,带宽密度最高,延迟最小;但散热集中,坏了影响整板。
核心洞察
大厂不做宗教式选择——三种方案都选。不同场景、不同代际的产品,用不同的方案。这不是非此即彼的选择题,而是「且走且看」的混合演进。
从产业趋势看,可插拔在短期内仍占主流,NPO是过渡方案,CPO是长期方向。但这条演进路径不会一步到位——三种方案将在相当长的时间内共存。
CHAPTER 06
经济账:省在互联 = 牺牲算力
为什么大厂争相砸钱做光互连
很多人有一个直觉:光互连很贵,能不能省一省?这个想法看似合理,但算一笔经济账就会发现——省在互联,等于牺牲算力。
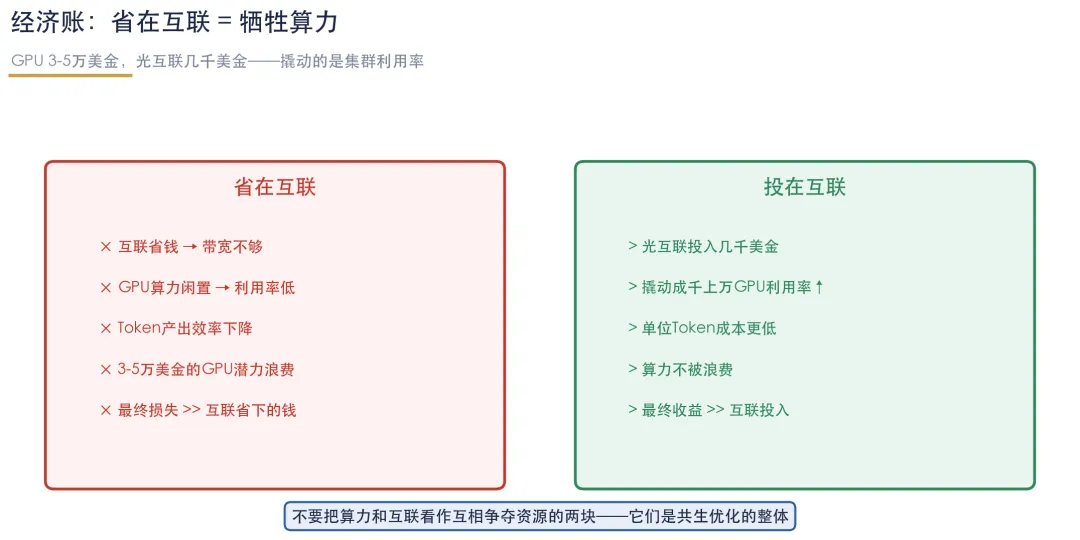
图6:省在互联 = GPU闲置 = 算力浪费
一颗GPU造价3-5万美元,而一个光互连方案只需几千美元。如果为了省几千美元的互联成本,导致价值3-5万美元的GPU利用率下降——这笔账怎么算都亏。
核心洞察
正确的思路不是「省互联的钱去花在算力上」,而是把互联看作算力的一部分——最终目标是整个系统的算力产出最大化,而不是单个环节的成本最小化。
更具体地说,光互连的投入撬动的是整个集群的利用率。一个好的光互连方案,可以让成千上万个GPU的利用率从50%提升到80%甚至更高。这意味着同样的硬件投入,产出更多的Token——单位Token成本更低。
CHAPTER 07
带宽增长双维度:更快 + 更宽
12.8T不是终点,是起点
光互连的总带宽增长来自两个维度:单通道速率提升(更快)和通道数量增加(更宽)。两者相乘,才是总带宽的倍增。
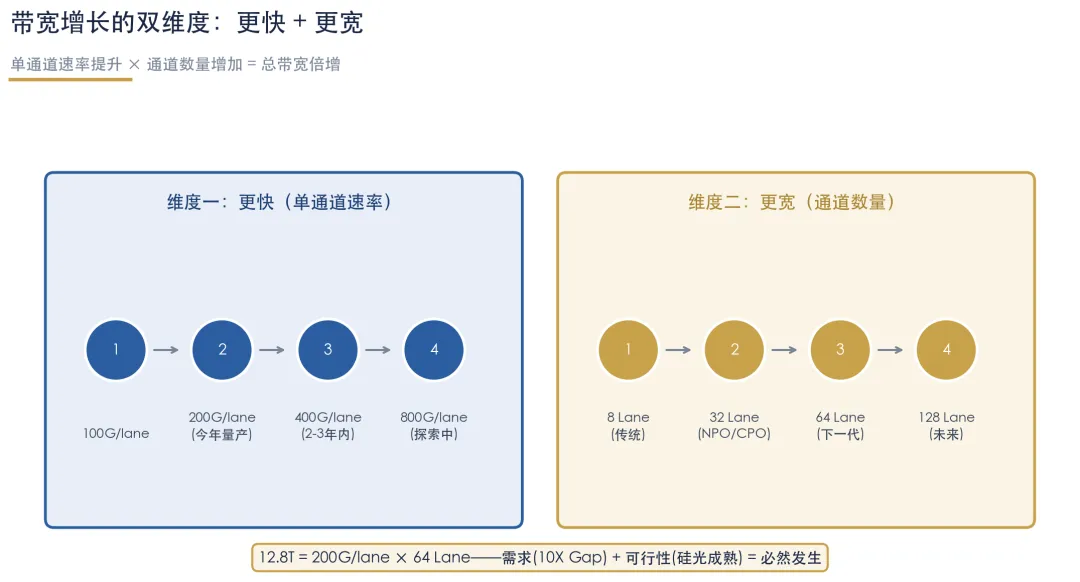
图7:速率从100G→800G/lane,通道从8→128 Lane——双维度增长
维度一:更快——单通道速率从100G/lane到200G/lane(今年量产),再到400G/lane(2-3年内),800G/lane(探索中)。每一步都面临巨大的工程挑战。
维度二:更宽——通道数量从传统8 Lane扩展到32 Lane(NPO/CPO)、64 Lane(下一代)、128 Lane(未来)。通过「慢而宽」(Slow and Wide)的策略,用更多通道弥补单通道速率提升的困难。
12.8T = 200G/lane × 64 Lane。这不是天方夜谭——需求端有10X Gap的拉动力,供给端有硅光技术成熟的可行性。12.8T XPO的标准化已经在推进中,100+公司参与。
在400G/lane时代,三种技术路线正在激烈竞争:硅光(Silicon Photonics)、薄膜铌酸锂(TFLN)、EML激光器。目前还在PK阶段,没有人能确定谁是主流。甚至有可能走向混合集成——比如把薄膜铌酸锂嫁接到硅光平台上。
CHAPTER 08
OCS vs 电交换:光路直通的新范式
Google的超级大脑实验
在光互连的更深层,还有一种架构级的变革正在发生——OCS(光交换,Optical Circuit Switch)。传统数据中心使用电交换机,每个数据包都要经过光电转换、处理、转发,功耗大、延迟高。OCS则直接在光层建立端到端的连接路径——光路直通,无需处理。
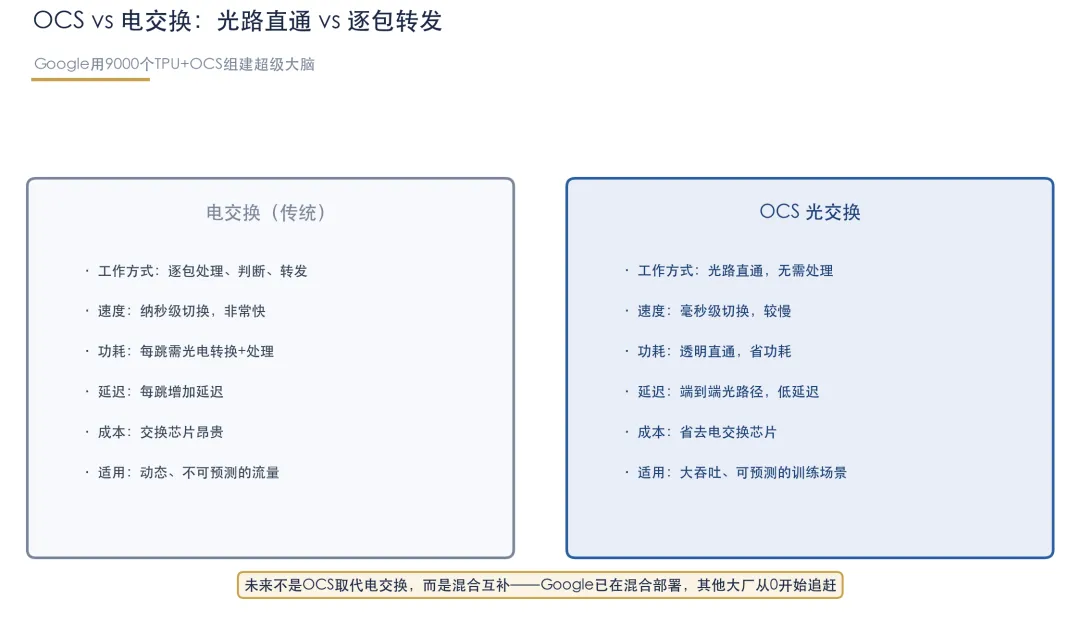
图8:电交换逐包转发 vs OCS光路直通——两种范式
Google是最早押注OCS的公司,大约十年前就开始布局。它用9000个TPU配合OCS组建了一个「超级大脑」——这是目前业界最大规模的光交换部署。其他互联网公司的OCS比例基本为零,都在追赶。
核心洞察
OCS的优势是省功耗、低延迟、省成本;局限是切换速度慢(毫秒级 vs 电交换的纳秒级),且光路切换会带来额外损耗。未来不是OCS取代电交换,而是混合互补——长期共存。
值得注意的是,OCS与Coherent Optics(相干光)是一个好的配对。因为OCS会引入额外2-3dB的损耗,而相干光有本征放大的作用,链路预算更高。随着速率提升到下一代,这个配对可能成为重要趋势。
CHAPTER 09
万亿价值链与行业展望
蛋糕在哪、瓶颈在哪、未来在哪
光互连的整体市场——包括交换机和光互连——已经接近万亿美元规模。这个赛道足够大,但价值链的每个环节面临的机会和挑战各不相同。
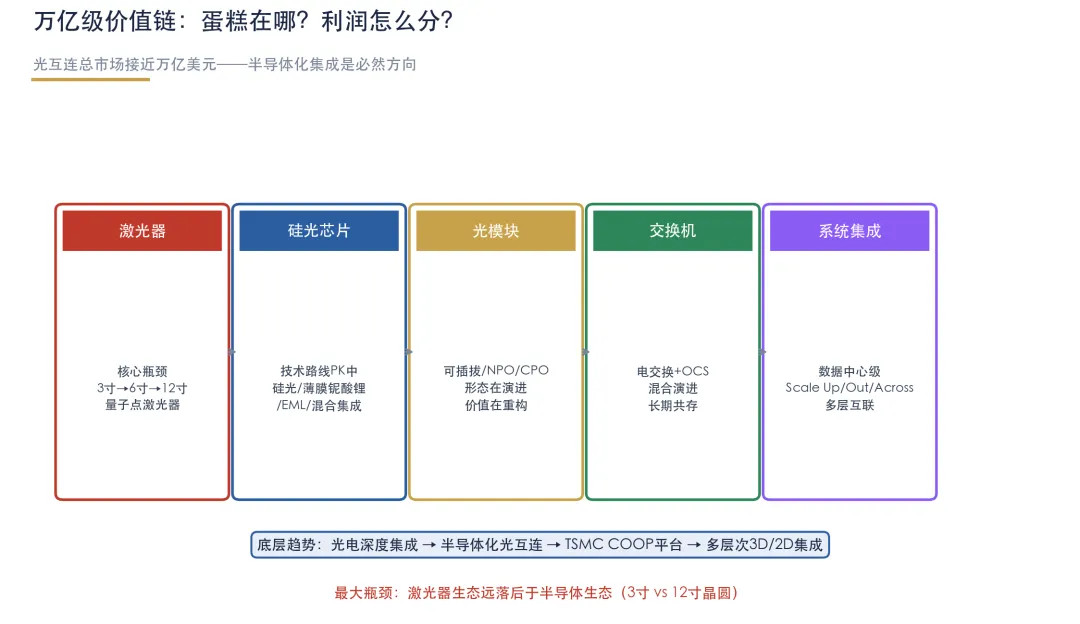
图9:从激光器到系统集成——万亿价值链全景
最大瓶颈在激光器。整个光互连产业还处于半导体集成的早期阶段。硅光芯片用的是12英寸(300mm)晶圆,而激光器厂家还在用3英寸(75mm)晶圆,拍着胸脯说要做到6英寸。这个差距意味着激光器的产能和成本是整个产业链最卡的环节。
一个可能的突破方向是量子点激光器——如果能实现在硅片上直接制造激光器,就能从3-4寸直接跳到12寸,瓶颈将被大大突破。但这仍处于前瞻研究阶段。
底层趋势是光电深度集成。光和电会越来越集成,走向半导体化的光互连。台积电已经建立了COOP(Chip-on-Wafer-on-Substrate)平台,专门做硅光和电芯片的集成。其他Foundry也会跟进。多层次3D/2D集成,让光和电的边界越来越模糊。
不要把算力和互联看作互相争夺资源的两块——它们是共生优化的整体。光互连会成为算力不可或缺的、似单利敌的组成部分。
未来五到十年,光互连在AI算力支出中的占比将持续提升。从传统的10-20%,发展到与算力共生增长——而且增速更快。就像人脑从猫狗进化到人类,白质占比从20%增长到50%——AI的「连接」也正在经历同样的跃迁。
这就是AI光互连的超级周期:不是周期性的波动,而是结构性的、长期的增长。它的驱动力来自算力本身的指数级增长——只要AI还在发展,光互连就不会停下。
本文基于行业公开信息、产业调研及多方数据综合研究撰写,旨在梳理AI光互连行业的技术路径、市场格局与发展趋势,不构成投资建议。文中数据为基于产业研究整理,具体数据请以官方披露为准。