ARTICLE · 995482
我让三个 AI 助手共用同一份记忆:从选型到本地跑通
这是「打工人AI自救」的第 4 期分享。
你好,我是旺旺。
我电脑里同时跑着三个 AI 助手,分别是 CodeBuddy、Claude Code 和 Hermes。写业务代码用 CodeBuddy,折腾 Agent 用 Claude Code,本地常住一个 Hermes 当随身助理。
它们各记各的。
在 CodeBuddy 里聊过的事,到 Claude Code 里要重讲一遍。在 Hermes 里定下的技术决策,到 CodeBuddy 里它一无所知。三个助手,三份互不相识的记忆。
这不是 AI 记性不好,是记忆没有公共底座。
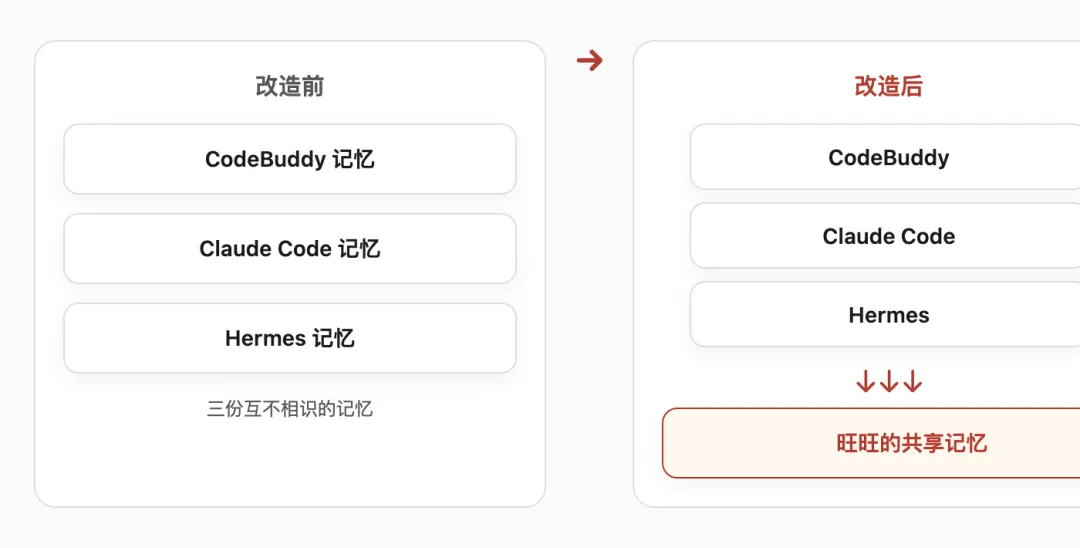
图 1 改造前三个助手各记各的,改造后读写同一份记忆
花了几天把它打通。现在谁知道的事,另外两个马上也知道。这篇不聊原理,只聊我是怎么从零接到跑通的,几个坑都是真踩过。
先说我要什么
动手前我横了四条线,后面所有选择都照它来。
记忆得独立于 Agent 框架。今天用这个助手,明天换那个,记忆不能跟着作废。
数据必须在本地。我的记忆里有不少没公开的项目细节、收入目标、踩过的坑,放别人服务器上我不踏实。
接入成本要低到改一行配置。不想为了记忆去改 Agent 代码、写插件、维护分支,最好配个 MCP 服务就完事。
最关键一条,要做事实抽取,不是向量堆砌。把对话切片、向量化、检索时塞回上下文,那叫 RAG 聊天记录,不叫记忆。真正的记忆要从对话里抽出事实,事实变了就更新旧的那条,而不是新增一条冲突的。
为什么最后是 mem0
市面方案分两派。一派是 Agent 框架自带的记忆,典型如 Letta(原 MemGPT),把记忆做进运行时里,分层管理还带界面。
但它解决的是怎么让我的 Agent 记住事,不是怎么让多个 Agent 共享记忆。要用它的记忆,就得用它的 Agent,直接违反我两条标准。
另一派是独立的记忆层,mem0 属于这一派。它只做一件事,给一段对话,负责抽取事实、去重、更新、检索,不绑定任何 Agent,对外就是一个 API。
再叠加官方有 MCP 服务端 OpenMemory。MCP 可以理解成 AI 助手的 USB 接口,助手支持 MCP,接上就能用,不用改代码。所以定的是 mem0 加 MCP。
这里有个坑我得单说。mem0 官方 OpenMemory 是一套完整服务,Docker Compose 起一整套,带 Web UI,通过 SSE 通信,太重。
我最后用的是第三方 fork wonseoko/mem0-open-mcp,纯 stdio 的 MCP server,pip install 完给个配置就能跑。
同一个开源项目,往往有官方全功能版和社区精简版,选哪个不看谁正统,看你到底要不要那些功能。
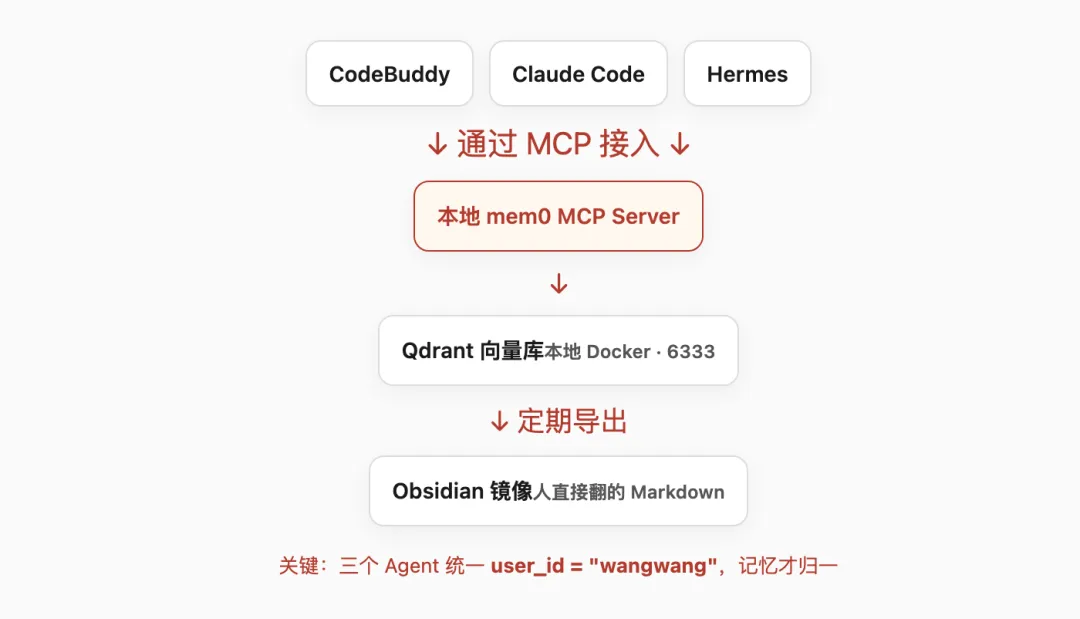
图 2 三个 Agent 通过 MCP 接同一个 mem0 Server,底下是本地 Qdrant,再导出镜像到 Obsidian
三个助手怎么接上
这一节是重点,我把它接通过程拆开讲。
三个助手,全部指向同一个二进制、同一份配置。
CodeBuddy 写进 ~/.codebuddy/.mcp.json,Claude Code 写进 ~/.claude.json,Hermes 写进 ~/.hermes/config.yaml。
三处一模一样,复制粘贴就完事。
MCP 这层长这样
{"mcpServers": {"mem0": {"type": "stdio","command": "~/mem0_mcp_env/bin/mem0-open-mcp","args": ["stdio", "-c", "~/mem0_scripts/openmemory-mcp.yaml"] } }}真正起作用的是那份 openmemory-mcp.yaml,几个点我标了注释
server:user_id: "wangwang" # 三个 Agent 共用,记忆才归一llm:config:model: "deepseek-ai/DeepSeek-V3.2" # 负责抽取事实embedder:config:model: "Qwen/Qwen3-Embedding-4B"embedding_dims: 2560 # 必须和下面一致vector_store:provider: "qdrant"config:collection_name: "wangwang_memory"host: "127.0.0.1" # 注意不是 localhostport: 6333embedding_model_dims: 2560 # 必须和上面一致注意三处必须一模一样,二进制路径、这份 yaml 内容,还有 user_id。尤其 user_id,它是记忆归一的钥匙。ID 不同就是三份记忆,ID 相同才是一份。
整条链路长这样
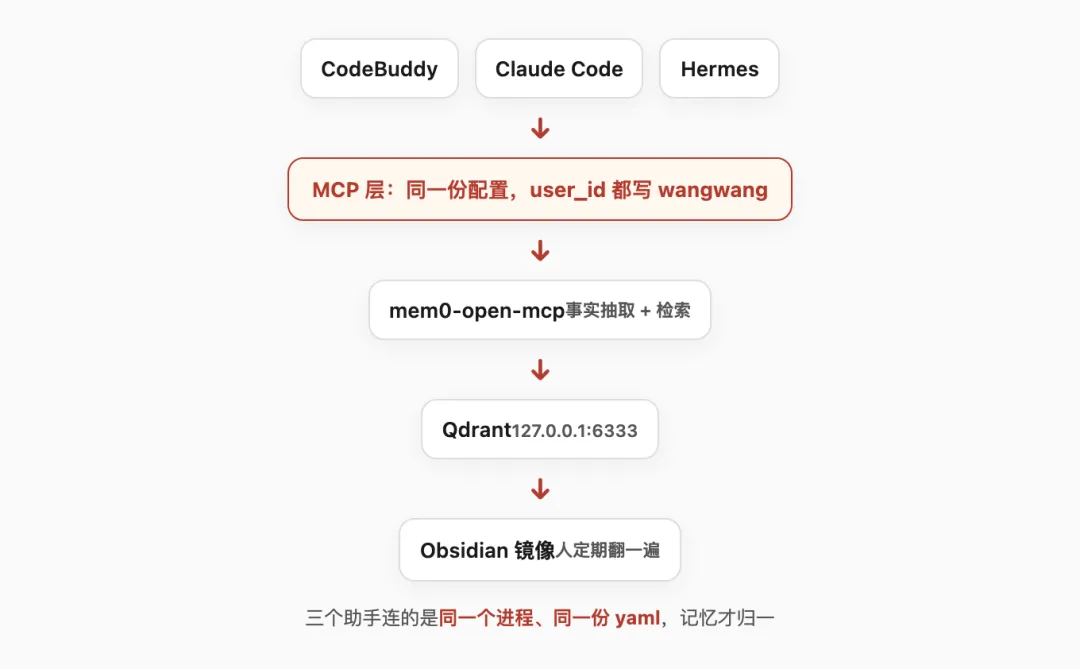
图 3 三个助手经 MCP 接同一份 mem0 配置,落到本地 Qdrant,再导出到 Obsidian
调试时卡住的四个地方
第一关,Python 3.9 直接报语法错。mem0 2.x 用了 X | None 这种新语法,要求 Python 3.10 以上。
我图省事用系统自带的 3.9,服务起不来,满屏语法错。换成 3.11 的虚拟环境后就好了。
第二关,localhost 连不上,Qdrant 报 503。配置里我习惯性写 localhost,结果要么 503 要么超时。
查了才知道,我这机器 localhost 优先解析成 IPv6 的 ::1,而 Qdrant 容器只监听 IPv4。改成 127.0.0.1 立刻通。记一笔,本地容器一律写 IP,别用 localhost。
第三关,Embedding 维度对不上,建库就炸。我用的硅基流动,DeepSeek 系列没有 embedding 模型,得换成 Qwen/Qwen3-Embedding-4B。
维度是 2560,不是常见的 1536 或 768。这个 2560 要在两处写,而且必须一致。
两处是 embedder.config.embedding_dims 和 vector_store.config.embedding_model_dims。
我有次少写一处,Qdrant 建 collection 直接维度冲突,报错还挺隐晦。
第四关,也是最阴的,它悄悄把内容吞了。前三个坑报错都明摆着,这个不报。
mem0 的 add 不是原样存,先让 LLM 做事实抽取,只有抽出了关于用户的事实才入库。
我有次塞了一段操作规则,比如以后遇到 XX 就做 YY,返回空,没报错没警告,就是什么都没存。所以记住,记忆库只存事实,规则清单、流程这类,老老实实写进配置文件或笔记,别往记忆里塞。
怎么确认它真记住了
光能写入不叫记住。我写了个验证脚本,重点测一件事,它会不会更新,而不是只会追加。
先写一条目标是月入 1 万,再告诉它目标改成 3 万。判据是库里应该只剩一条,内容变成 3 万。如果变成两条,一条 1 万一条 3 万,那这套记忆就废了,以后检索会同时召回两个矛盾的答案,比没有记忆还糟。
我还会用靠什么赚钱去查在做 AI 教学、AI 工具、SEO 这条记录。这两句关键词完全不重叠,能召回才说明是向量语义在干活,不是字符串匹配。
本来怕烧 token,结果没发生
我最早担心,Agent 每次提问会不会把整个记忆库灌进上下文,太烧 token。现在这套架构下不会,mem0 是检索式的,只把相关的几条捞出来带上。
但这引出新原则,记忆库要存指针,不要存内容。比如我关注某个开源项目,记忆里记旺旺关注 XX 项目、用于 YY 场景、链接在书签库下,而不是把项目 README 全文塞进去。需要细节时 Agent 顺着指针去读文档。记忆是索引,不是硬盘。
我现在定期把记忆导出成 Markdown 镜像到 Obsidian,自己翻一遍,手动清掉那些不该存在的内容型记忆。
工具链
Qdrant本地向量库,Docker 跑在 6333 端口
mem0-open-mcp第三方 fork 的 MCP server,负责事实抽取与检索
硅基流动提供 LLM 和 Embedding(OpenAI 兼容接口)
Obsidian定期把记忆导出成 Markdown,人直接翻
写在最后。
三个月前,我还在三个助手之间反复讲同一件事,讲得自己都烦。现在它们共用一份记忆,我在 A 里定的事,B 和 C 天然知道。
我是旺旺,一个从 Java 转 AI、正在做一人公司的打工人。我在这个号只写一件事,打工人怎么用 AI 给自己加杠杆,把一个人活成一个小团队。
看到这里,你准备好给自己的 AI 助手们装个公共大脑了嘛?
感谢!