ARTICLE · 997130
PDF表格批量转Excel:我把Docling和MinerU做成了一个Skill
上一篇横测 3 款 PDF 解析器后,我得到一个不太爽快的结论:没有“全能冠军”。Docling 擅长规则数值表,MinerU 更能扛多层表头和合并单元格。真正值得自动化的,应该是先看表格结构,再决定交给谁。
这一次,我把这套判断写成了一个可运行的 Codex Skill,并用上次保留的 19 张真实表格/结构和 1 个负样本做策略回放。
结果是:15 张 A 级、4 张 B 级,19/19 进入可用区间;负样本被直接拒绝。
先说清楚边界:这次没有重新跑三款解析器,而是用上次逐页人工核对后保存的等级,验证“自动分流策略”是否成立。它验证的是路由决策,不是新的逐字符准确率。
为什么不直接固定用 MinerU?
因为“复杂表更强”不等于“所有表都更省事”。
在上次 20 个样本里,MinerU 检出 19/19 个真实表格/结构,确实最稳;但在两个简单数值表上,它把多行内容合到同一个单元格,等级只有 C。相同样本交给 Docling,却是可以直接进入 Excel 的 A。
反过来,遇到多层表头、rowspan/colspan、算法框和复杂结构示例,Docling 又可能压平表头,甚至不输出独立表格。这些样本,MinerU 明显更合适。
所以问题不是“谁赢了”,而是:
能不能在解析前,先做一次便宜、可解释的结构分类?
这个 Skill 实际做了什么
我把它命名为 pdf-table-auto-routing。它不是把两个解析器重新封装成一个黑盒,而是给 Codex 一套明确的工作流、路由规则、输出字段和复核边界。
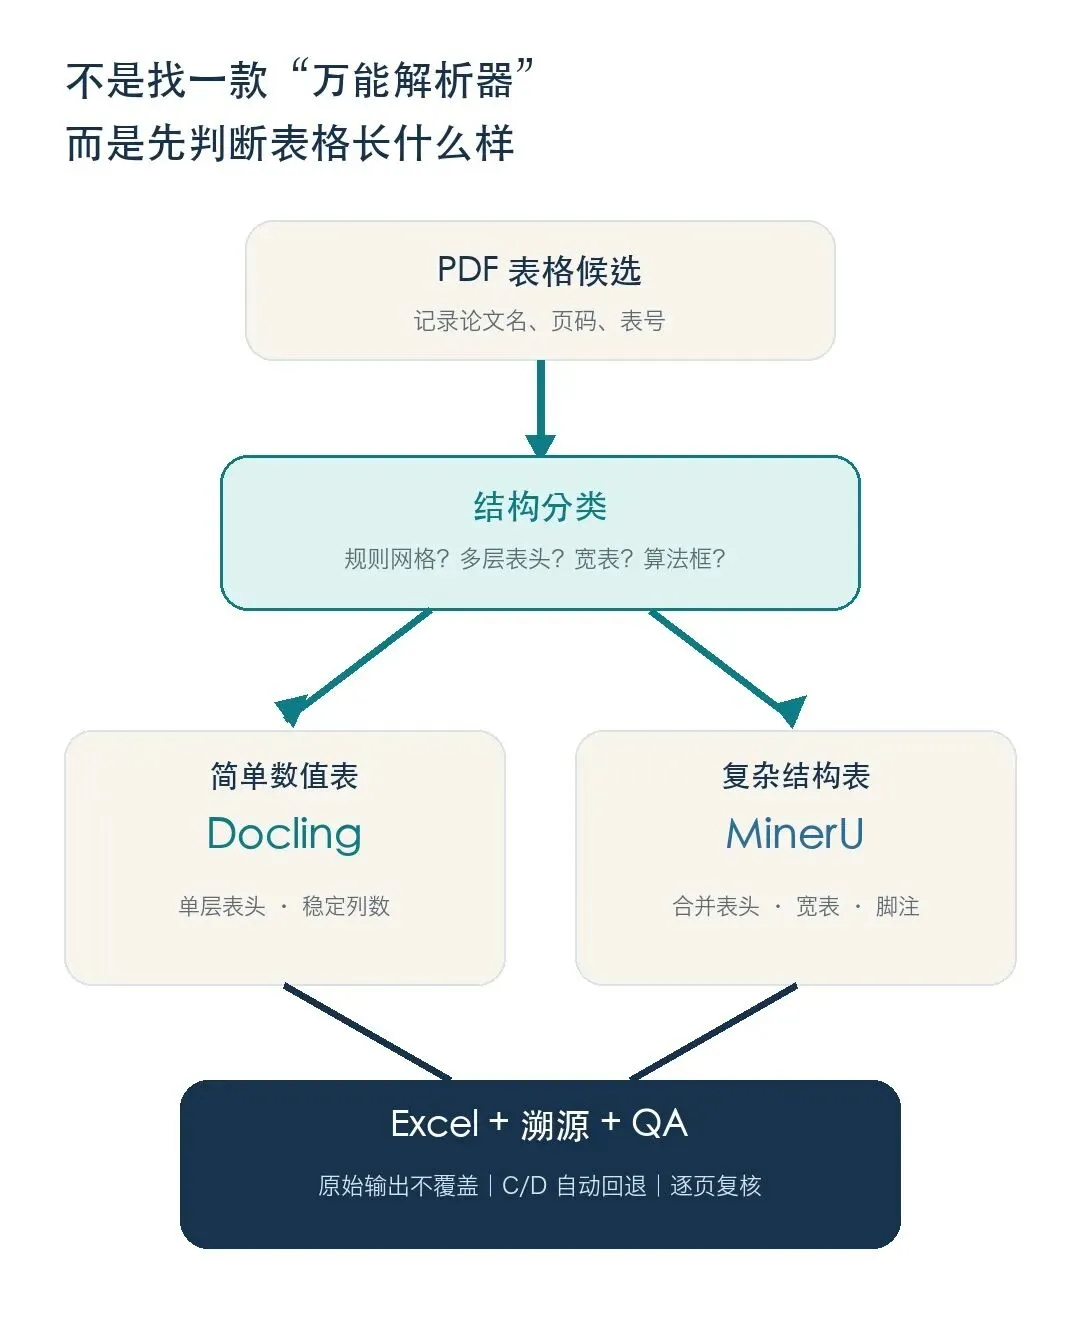
整个流程只有 5 步:
先建立表格清单,记录论文名、页码、表号和结构类型; 规则数值网格优先交给 Docling; 多层表头、合并结构、宽表、脚注和算法框优先交给 MinerU; 如果首选结果是 C 或 D,保留原始输出,再跑回退工具; 最后生成 Excel、溯源表和 QA 清单,逐页复核重要数据。
Skill 目录不是一句 Prompt,而是三个真实文件:
pdf-table-auto-routing/├── SKILL.md├── agents/openai.yaml├── references/routing-policy.md└── scripts/route_table_manifest.py
其中,`route_table_manifest.py` 会读取表格清单,输出每个样本的首选工具、回退工具、路由理由、复核标记和已知等级。它不偷偷运行解析器,因此“做了什么”和“没做什么”都能看见。
路由规则并不复杂
1. 规则数值表 → Docling
适合这些特征:
单层表头; 列数稳定; 主要是文本与数值; 没有重要的跨行、跨列关系。
这类表的目标不是“尽可能保留版式”,而是尽快得到干净二维网格。上次 7 个被这条规则命中的简单数值样本,全部是 A 级。
2. 复杂结构表 → MinerU
只要出现下面任意一种情况,就优先走 MinerU:
多层或合并表头; rowspan / colspan 决定语义; 宽表、长表或脚注密集; 算法框、表格型 Figure; 不规则单元格边界; 公式、符号很多,并且布局本身很重要。
这条规则并不保证字符零错误。比如公式里的 O 与 0、上标和脚注,仍然需要人工看一眼。所以 Skill 会把这些情况标记为 needs_review=true,而不是给出虚假的“全自动完成”。
3. 非表格内容 → 拒绝
负样本很重要。上次的 BERT 输入嵌入示意图,看起来有很多规则排列的 token,但它不是数据表。路由器会直接拒绝,不为了追求“检出率”把示意图硬塞进 Excel。
20 个样本回放,结果怎样?
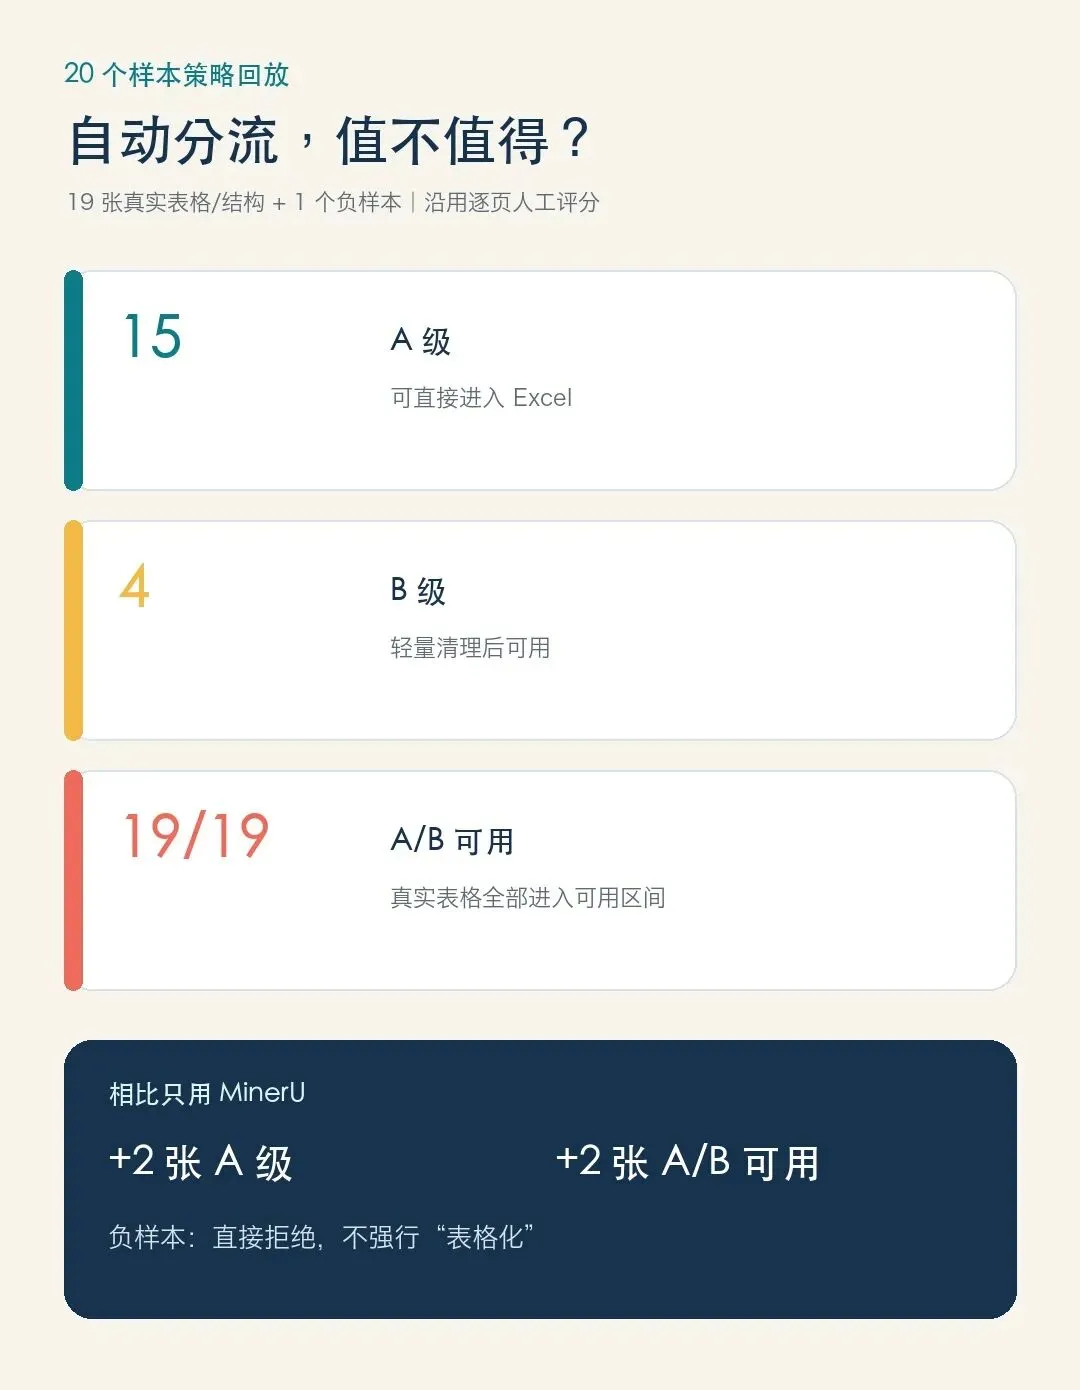
策略回放的结果如下:
19 张真实表格/结构全部达到 A 或 B; 其中 15 张为 A,4 张为 B; 7 张规则数值表交给 Docling; 12 张复杂结构表交给 MinerU; 1 个负样本直接拒绝。
和只使用 MinerU 相比,自动分流多出 2 张 A 级、2 张 A/B 可用。这两个增益主要来自简单数值表:MinerU 在 T05、T06 上是 C,Docling 则是 A。
它也不是“看答案选工具”的理论最优解。T01 是公式/符号表,Docling 的历史等级是 A,MinerU 是 B;但通用策略仍把它交给 MinerU,因为这一类表更依赖结构保留。也就是说,这套规则选择的是更容易泛化、也更容易解释的默认路径,而不是用单个样本作弊。
Excel 不只放结果,还要放证据
这次生成的回测工作簿有 4 个工作表:
结论摘要 19/19、15 个 A 等核心指标与对照图; 逐表路由 :每个样本为什么选 Docling 或 MinerU; 工具对照 :三款工具在同一批样本上的原始等级; 方法与边界 :评分口径、复核边界和回放方法。
真正用于论文数据时,还应该保留这些字段:
sample_id / document / page / item / categoryselected_tool / fallback_tool / route_reasongrade / usable / needs_review / raw_output_path
这样一旦某个数字有问题,可以回到“哪篇论文、哪一页、哪一次解析输出”,而不是只剩一个来源不明的 Excel。
最短使用方式
安装 Skill 后,可以直接这样说:
Use $pdf-table-auto-routing to inventory the PDF tables,route simple grids to Docling and complex structures to MinerU,preserve page provenance, and prepare an Excel-ready QA report.
如果已经有一份 JSON 表格清单,也可以先生成路由计划:
python scripts/route_table_manifest.py \--input benchmark_results.json \--output auto-routing-evaluation.json
需要注意:Docling 和 MinerU 仍然要在本机单独可用。Skill 负责的是编排、选择、溯源和质量门槛,不是把依赖和模型凭空变出来。
它目前还不够“全自动”的地方
第一,结构分类现在主要依赖表格清单中的类别,还没有训练一个新的视觉分类器直接判断 PDF 页面。
第二,A/B 等级来自逐页人工复核,不是单元格级真值。重要科研数据仍应抽查原页。
第三,这批样本来自 8 篇公开论文前 6 页中的表格型内容,不能代表扫描件、中文竖排、财报和所有领域论文。
第四,版本变化会改变结果。本文保留的工具版本是 Docling 2.120.3、MinerU 3.4.5、Marker 2.0.0。
我的结论
PDF 表格转 Excel 最容易踩的坑,是把“识别到表格”当成“已经得到可分析数据”。
更可靠的做法不是迷信一个万能模型,而是建立一条可解释的流水线:简单表走快路,复杂表走强路,失败就回退,所有数字都能回到原页。
如果你希望下一版加入“自动定位表格页 + 批量导出多个 Sheet + 单元格级差异检查”,可以留言告诉我你最常处理的论文类型。我会优先做真实样本,而不是只加功能列表。
参考资料
01 Docling 官方仓库
github.com/docling-project/docling
02 MinerU 官方仓库
github.com/opendatalab/MinerU
03 Marker 官方仓库
github.com/datalab-to/marker
04 Table Transformer / PubTables-1M
arxiv.org/abs/2110.00061
05 Docling Technical Report
arxiv.org/abs/2408.09869