ARTICLE · 998072
327 页 PDF 塞进大模型:我踩了三个坑,最后用分层状态救回来
连载项目:标兵 · AI 招投标应答系统 · 第 2 天 / 共 7 天
串行抽取
7 分 40 秒
并行后
1 分 12 秒
信息丢失
0 处
昨天「标兵」跑通了,但我盯着日志里那个 7 分 40 秒看了很久——327 页串行抽取,占掉总耗时的 94%。更糟的是,我试着把全文一次性塞给模型,换来的是一串 context 超限报错。今天专门解决长文档:怎么切、怎么并行、怎么保证切完不丢东西。
01一、昨天的两个债
Day 1 收工后我列了两个必须还的债:
- 太慢:
327 页串行抽取 7 分 40 秒,用户会以为程序死了。 - 太脆:
按页切分遇到跨页表格就断,昨天已经丢了 2 条藏在附件里的要求,是人工复核捞回来的。
今天上午我先试了个"聪明"的办法:把全文一次性喂给长上下文模型。结果很干脆——直接超限报错。这才意识到,长文档不是"模型够不够长"的问题,是工程上怎么组织的问题。
02二、重新设计:按章节切,不按页切
招标文件有个天然优势:它有目录。我改成解析目录树,按章节边界切块,一个章节内部再按需二次切分。这样跨页的表格、条款清单会被完整保留在一个块里。
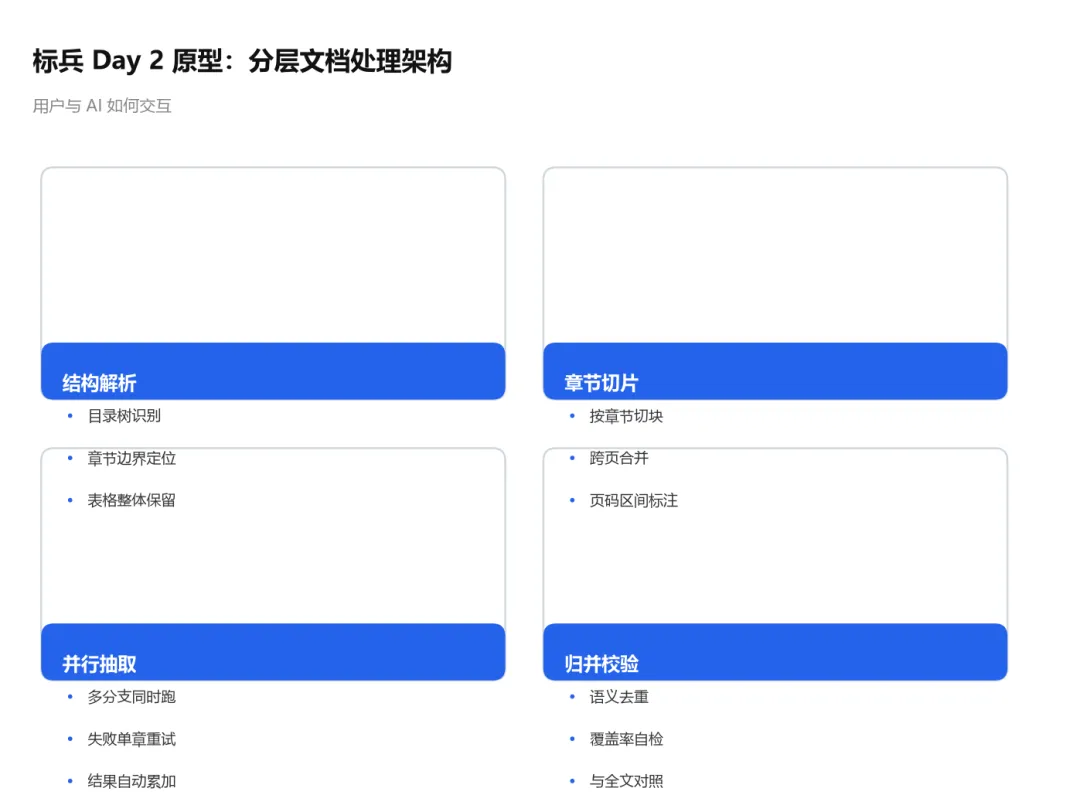
327 页切成了 23 个章节块,最大的一块 1.8 万字,最小的一块 300 字。切完之后我加了一道覆盖率自检:把所有块的字符数加起来,和原文字符数比对,差值超过 1% 就报警。这一步救了我后面好几次。
03三、并行:Send 扇出,Reducer 扇入
LangGraph 做并行有个很干净的原语:Send。它让一个节点把任务分发给 N 个分支,每个分支跑在不同状态上,结果再靠 Reducer 归并。
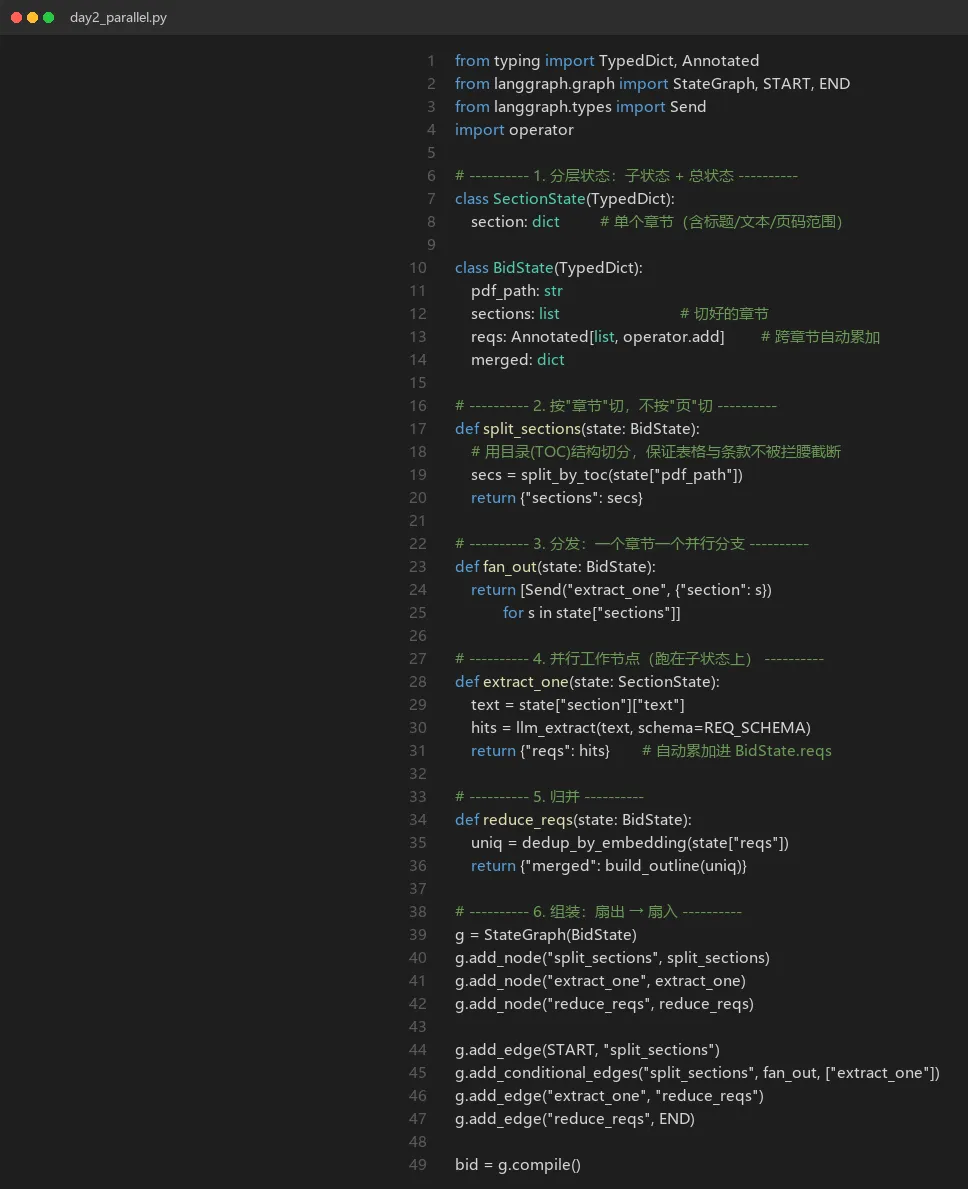
Day 1 那个 Annotated[list, operator.add] 在这里才真正发挥作用:
extract_one跑在 SectionState 上,只关心自己那一章; 它返回的 reqs会被自动累加进总状态的reqs,八路并行也不会互相覆盖;reduce_reqs等所有分支跑完才执行,做最后的语义去重。
如果我昨天把 reqs 定义成普通 list,八路并行会互相覆盖,最后只剩一路的结果——这就是我踩的第三个坑。
04四、完成图:扇出与扇入
图从昨天的一条线,长成了一把扇子。这是「标兵」第一次出现分支结构。
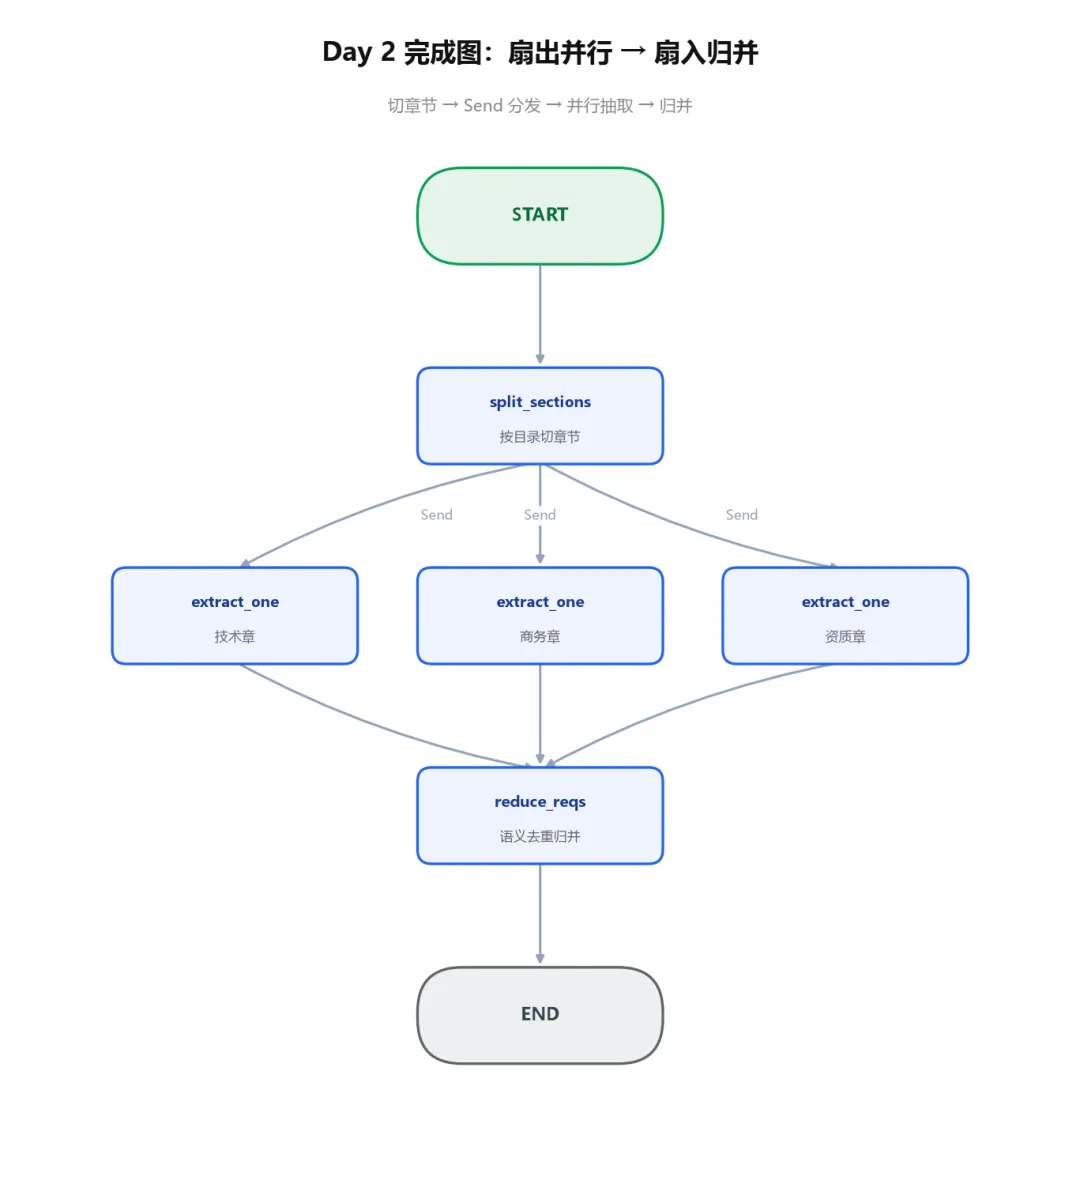
实际运行时我开了 8 路并发(章节 23 个)。并发数不是越大越好——超过 API 限流会触发 429,我在 extract_one 里加了指数退避重试,失败单章单独重试,不影响其他章节。
05五、三种切法实测对比
我用同一份文件跑了三个方案,结果差距很说明问题。
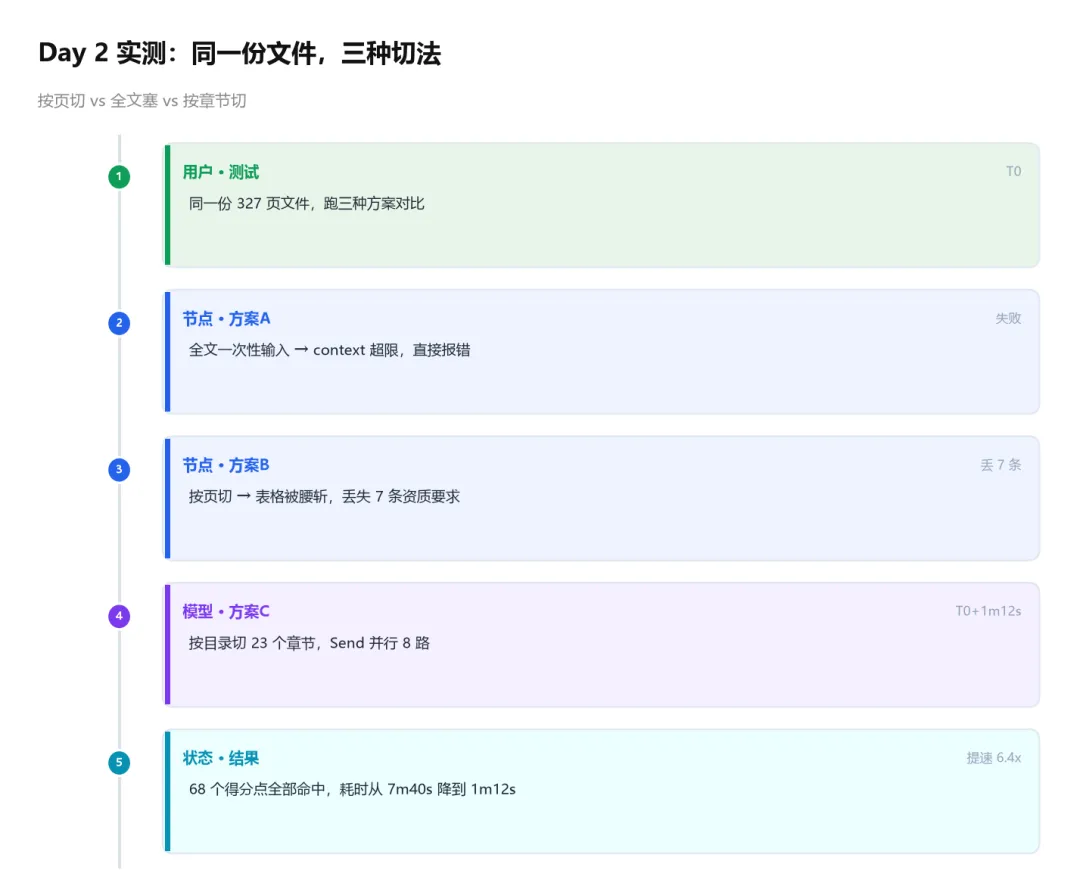
从 7 分 40 秒到 1 分 12 秒,提速 6.4 倍,而且这次 68 个得分点一个没丢。
06六、Day 2 踩的坑
今天交的学费
- 坑一 · 全文塞:
327 页约 40 万 token,再长的上下文也扛不住,而且费用惊人。切块是必须的。 - 坑二 · 按页切:
跨页表格被拦腰斩断,资质要求丢了 7 条。必须按语义边界(章节/条款)切,不能按物理页切。 - 坑三 · 状态覆盖:
并行分支写同一个普通 list 字段会互相覆盖。用 Annotated + operator.add 声明累加语义。 - 坑四 · 并发限流:
并发开太大触发 429。控制在 8 路,并加指数退避重试。
DAY 2 心得
长文档处理的胜负手不在模型,在切分策略。切之前先问一句:这个文档自身的语义边界在哪?答案通常是目录、标题或条款编号。
Day 2 小结
代码图、原型图、完成图、实例图都在上面,照着跑就能复现今天这一步。 明天继续往下做:让 AI 写的每一句话都能点回公司文件——企业资质库 RAG 与溯源。 这是「标兵 · AI 招投标应答系统」连载的第 2 篇,关注小码哥,看一个 AI 应用怎么从 0 长出来。
小码哥 · 标兵 · AI 招投标应答系统 · Day 2 · 2026-08-31