ARTICLE · 999217
需求文档写给 AI 看:先过这 7 道关
需求文档写给 AI 看:先过这 7 道关一份需求文档,过去是写给人看的,现在是写给 AI 看的。读者变了,写法就得跟着变。 人看需求会意会。你说"参考主流竞品",人知道大概是那个意思。AI 不会,它只会照着字面做。你说"筛选体验要流畅",它不知道什么叫流畅,只能猜,猜错了你就返工。 所以产品团队交付给开发团队的需求文档和高保真原型,在 AI 写代码的前提下,有 7 道关要过。这 7 道关不是玄学,每一条都对应 AI 编码的一个具体坑。 AI 读需求靠的是结构,不是排版。 PRD 要用结构化的 Markdown,标题层级清楚、编号统一、能用表格就用表格。高保真原型要用语义化的 HTML,标签和组件命名有规范。 一份截图拼出来的"文档",人看着还行,AI 读不了。它需要的是能被稳定解析成章节、条目、字段的东西。人肉排版越花哨,AI 解析越费劲。 每条需求必须带可判定的验收场景,写成 Given、When、Then 三段。 AI 判断"做完没",靠的是可判定的 Then。"体验要流畅"、"要高大上"这类话,它没法验证,也就没法收工。没有 Then 的需求,等于没给 AI 一个收工的信号。 明确写清"这次不改什么"。 AI 写代码最常犯的错,是顺手把无关的东西也改了。你让它加个筛选,它顺手把列表分页重构了。非目标这一节就是护栏,告诉它别碰哪里。 不写"像微信那样"、"参考主流做法"、"差不多就行"。 这类话是人跟人之间偷懒用的,AI 听不懂。它要的是具体到字段名、状态值、交互细节。写"点击按钮后 300 毫秒内出现加载状态",别写"响应要快"。AI 不会意会,只会照字面做,含糊一个字,偏一公里。 每条需求要能指到原型的某个具体页面或区块。 让 AI 交叉验证"界面到底实现没实现这条需求",靠的是两边的 ID 对得上。需求条目有个编号,原型区块挂个 data-spec-id,两边一一对应,AI 才能自己核对。两份对不上的文档,AI 只能各说各话。 交付物要带版本号,开发侧只读引用固定版本。 AI 写到一半,产品又改了需求,这是规格漂移的根源。锁版本,变更走提案流程,而不是偷偷改文档。开发侧引用的是 v1.2 的 PRD,不是"最新版"。这听着是流程问题,其实是给 AI 一个稳定的输入。 交付物要能区分"系统已经是什么样"和"这次要改什么"。 如果只描述"最终想要的样子",AI 分不清哪是新增、哪是改动、哪要删。标出新增、修改、删除,AI 执行时才能精准控制范围,不会把已有的东西当成要新建的。 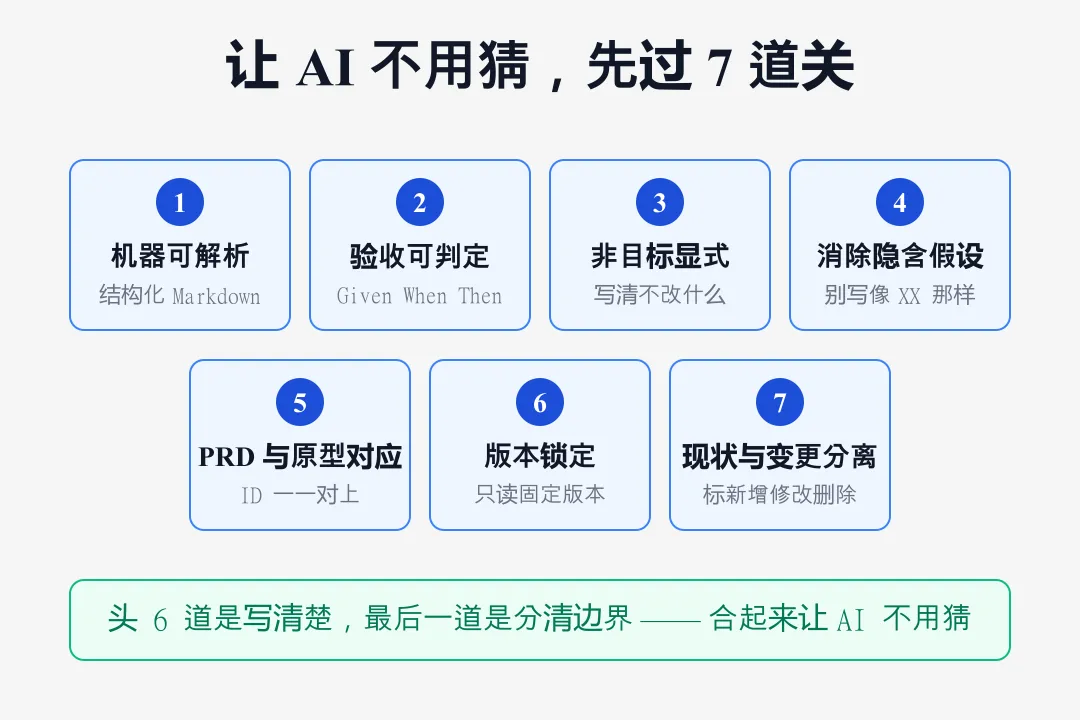
头 6 道关是"写清楚",最后一道是"分清边界"。合起来就一件事:让 AI 不用猜。 这 7 条不能写在黑板上,人不会天天看。要落成三层东西,放进版本库。 第一层,填空式模板。给产品团队一份 PRD 骨架和原型规范,照着填,天然满足格式要求,不用从空白页开始。 第二层,校验脚本。提交时自动跑,逐条检查这 7 条,不符合就报错,指到具体哪一行。验收场景缺了、冒出一句"参考主流"、Non-goals 空着,脚本都会抓出来。 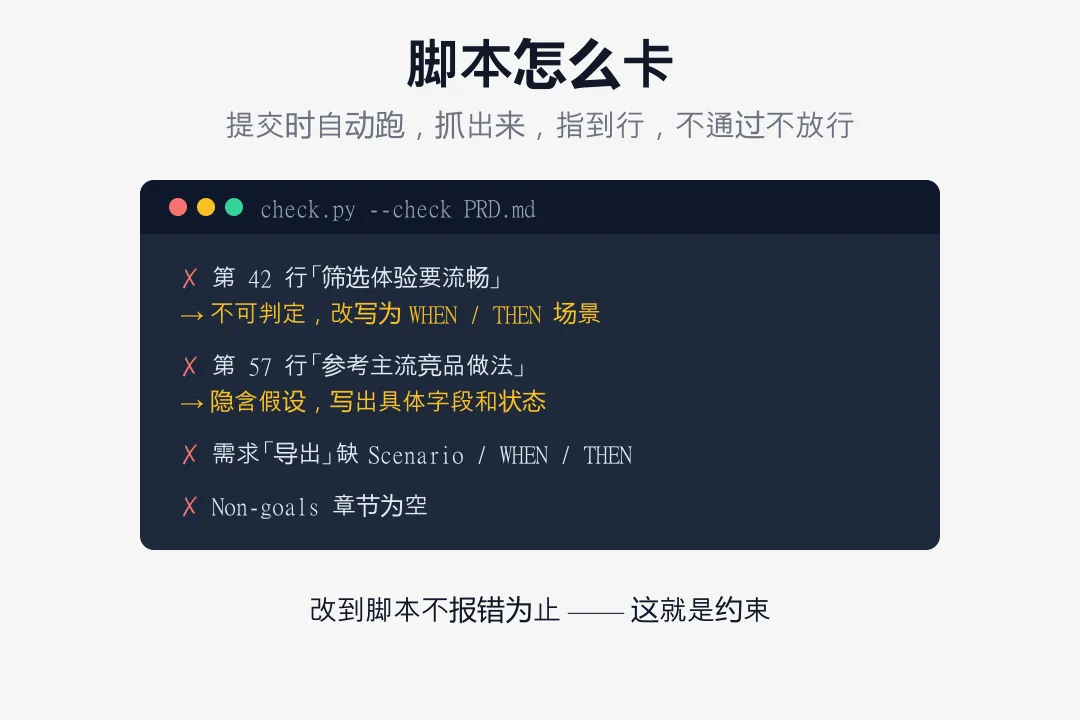
第三层,CI 门禁。校验不过,不能合并、不能打版本号。 这三层放一起,约束就从黑板上的口号,变成了提交就卡你的机器。 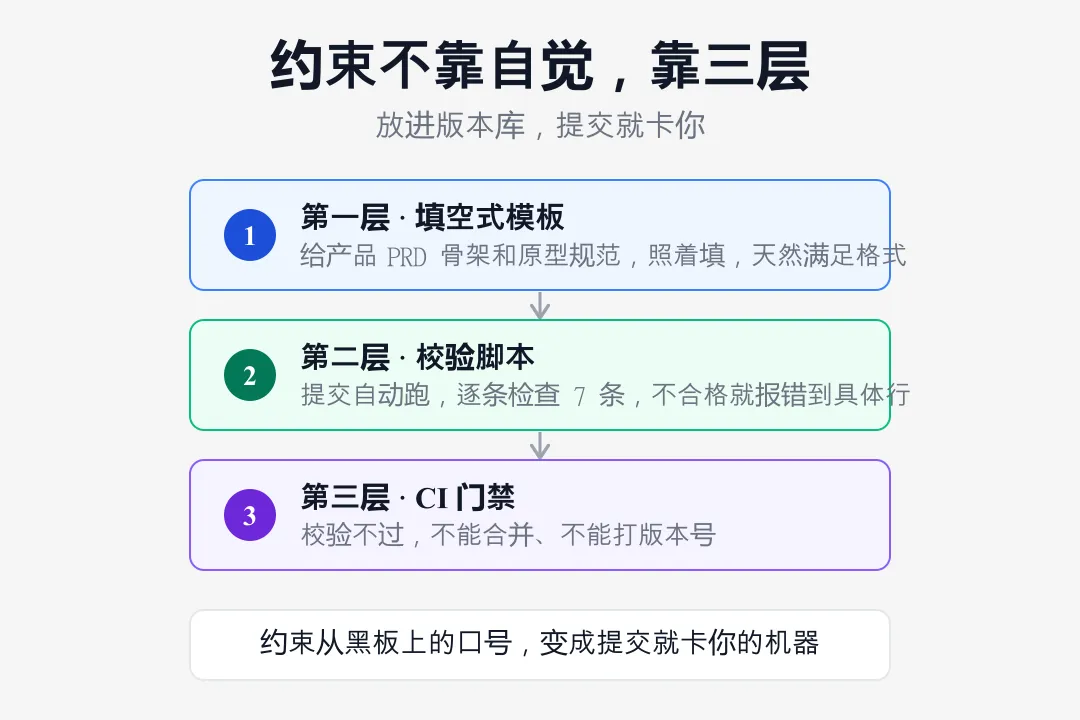
这里容易搞混。OpenSpec 自带的 validate 命令,校验的是它自己目录里的规格文件,不校验产品那份原始 MD。 所以产品侧这份 PRD 的 7 道关,得自己写脚本;开发侧规格落地后的格式校验,才轮到 OpenSpec 白嫖。两道关,各管各的。 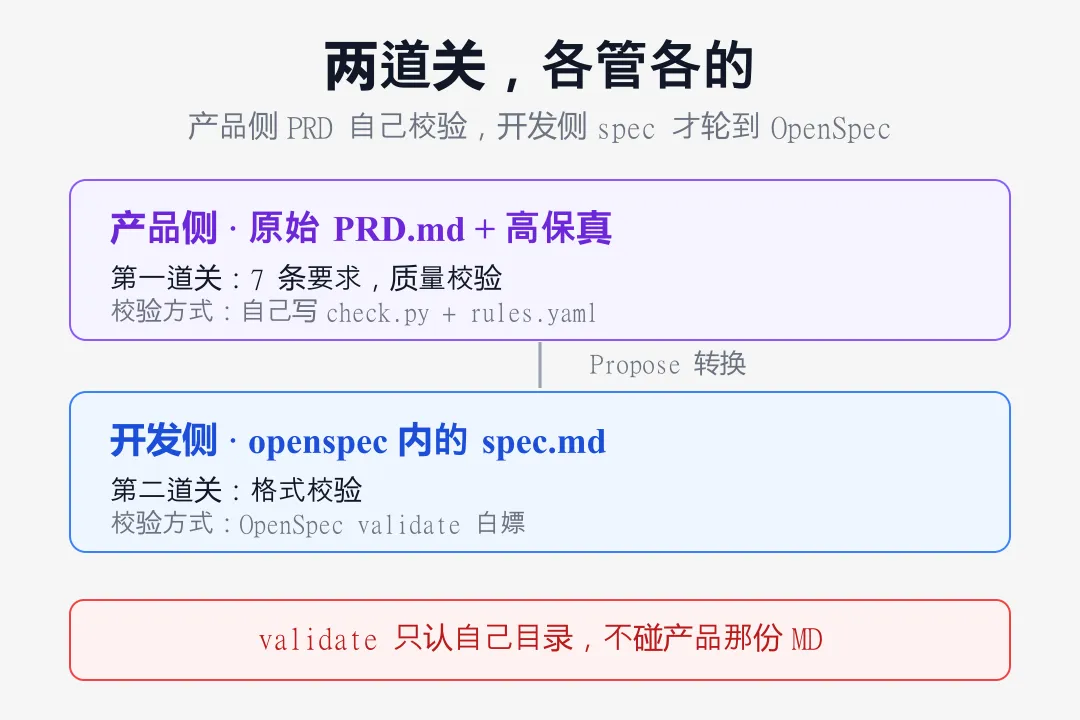
AI 写代码的瓶颈,早就不在代码本身,在喂给它的需求干不干净。 需求文档写得越像"给机器看的说明书",返工就越少。这 7 道关,就是那份说明书的最低标准。产品把需求写干净了,开发侧的工具才能跑得起来,AI 才不会在第一步就跑偏。
需求文档写给 AI 看:先过这 7 道关
第 1 关:机器可解析
第 2 关:验收可判定
Given 用户已登录When 用户点击导出Then 系统下载一个 CSV 文件
第 3 关:非目标显式
第 4 关:消除隐含假设
第 5 关:PRD 与原型一一对应
第 6 关:版本锁定、只读
第 7 关:现状与变更分离
光靠自觉没用,得靠三层约束
一个澄清:两道关,别混