第九讲:数组和字符串
主讲人:刘财政
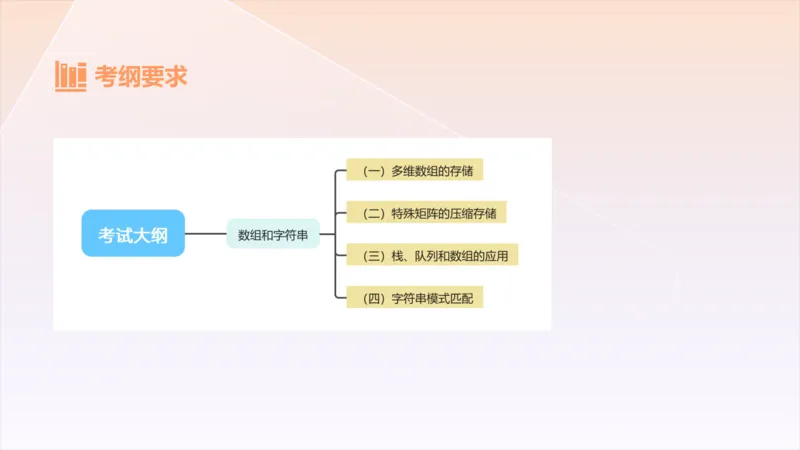
B站:@计算机考研刘财政考纲要求CON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★CON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考点一: 数组定义
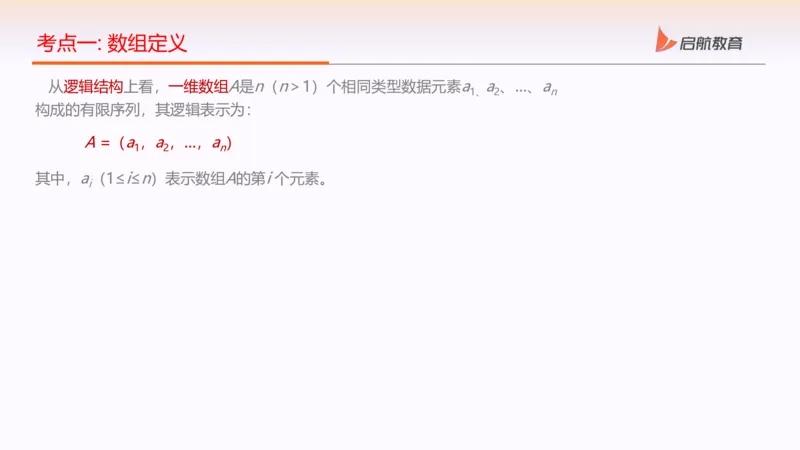
从逻辑结构上看,一维数组A是n(n>1)个相同类型数据元素a a、…、a
1、 2 n
构成的有限序列,其逻辑表示为:
A=(a,a,…,a)
1 2 n
其中,a(1≤i≤n)表示数组A的第i个元素。
i考点一: 数组定义
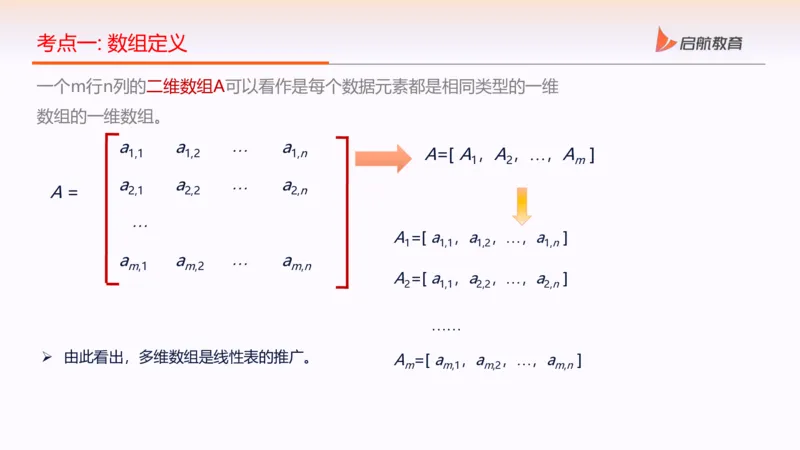
一个m行n列的二维数组A可以看作是每个数据元素都是相同类型的一维
数组的一维数组。
a a a
1,1 1,2 1,n A=[ A,A,,A ]
1 2 m
a a a
A = 2,1 2,2 2,n
A=[ a ,a ,,a ]
1 1,1 1,2 1,n
a a a
m,1 m,2 m,n
A=[ a ,a ,,a ]
2 1,1 2,2 2,n
➢ 由此看出,多维数组是线性表的推广。 A =[ a ,a ,,a ]
m m,1 m,2 m,n考点一: 数组定义
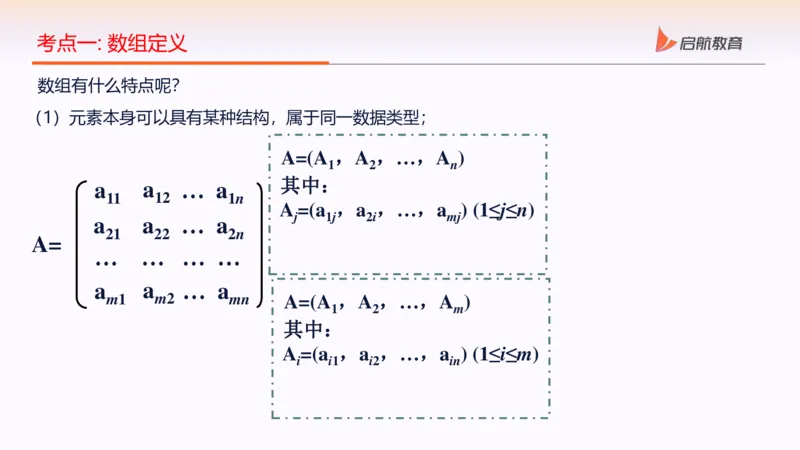
数组有什么特点呢?
(1)元素本身可以具有某种结构,属于同一数据类型;
A=(A ,A ,…,A )
1 2 n
其中:
a a … a
11 12 1n
A =(a ,a ,…,a ) (1≤j≤n)
j 1j 2i mj
a a … a
21 22 2n
A=
… … … …
a a … a
m1 m2 mn A=(A ,A ,…,A )
1 2 m
其中:
A =(a ,a ,…,a ) (1≤i≤m)
i i1 i2 in考点一: 数组定义
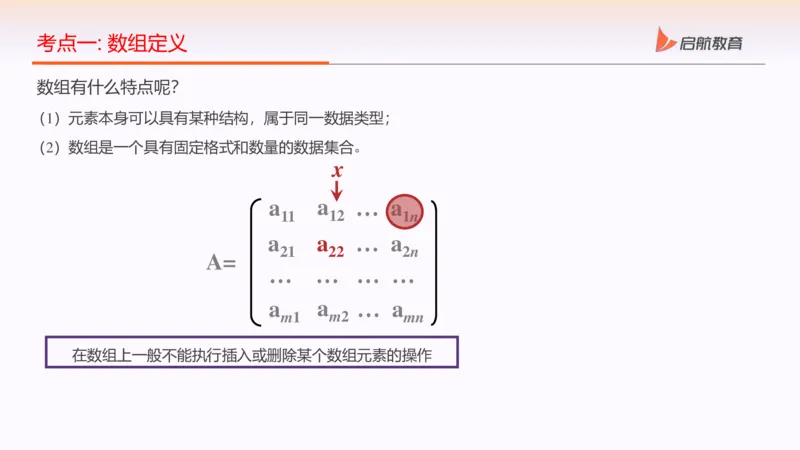
数组有什么特点呢?
(1)元素本身可以具有某种结构,属于同一数据类型;
(2)数组是一个具有固定格式和数量的数据集合。
x
a a … a
11 12 1n
a a … a
21 22 2n
A=
… … … …
a a … a
m1 m2 mn
在数组上一般不能执行插入或删除某个数组元素的操作THANKSCON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考点二: 数组的地址计算
数组特别适合采用顺序存储结构 将数组所有元素存储在一块地址
连续的内存单元中。
➢ 数组不能采用链式存储结构吗?
➢ 为什么数组一般采用顺序存储结构?
数组没有插入和删除操作,所以,不用预留空间,适合采用顺序存储
二维数组 内 存
二维结构 一维结构考点二: 数组的地址计算
一维数组的存储
一维数组(a ,a ,…,a ),按元素顺序存储到一块地址连续的内存单元中。
1 2 n
假设第一个元素a 的存储地址用LOC(a )表示,每个元素占用k个存储单元,则任
1 1
一数组元素a 的存储地址LOC(a )即可由以下公式求出:
k k
LOC(a )= LOC(a )+(i-1) * k (2<i≤n)
k 1考点二: 数组的地址计算
二维数组的存储
按行优先:先存储行号较小的元素,行号相同者先存储列号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“行优先顺序”存储时
①第1行中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+(j-1)L j=1,2, …,n
1j 11考点二: 数组的地址计算
二维数组的存储
按行优先:先存储行号较小的元素,行号相同者先存储列号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“行优先顺序”存储时
②第2行中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+nL+(j-1)L j=1,2, …,n
2j 11考点二: 数组的地址计算
二维数组的存储
按行优先:先存储行号较小的元素,行号相同者先存储列号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“行优先顺序”存储时
③第m行中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+(m-1)nL+(j-1)L j=1,2, …,n
mj 11考点二: 数组的地址计算
二维数组的存储
按列优先:先存储列号较小的元素,列号相同者先存储行号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“列优先顺序”存储时
①第1列中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+(j-1)L j=1,2, …,m
j1 11考点二: 数组的地址计算
二维数组的存储
按列优先:先存储列号较小的元素,列号相同者先存储行号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“列优先顺序”存储时
②第2列中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+mL+(j-1)L j=1,2, …,m
j2 11考点二: 数组的地址计算
二维数组的存储
按列优先:先存储列号较小的元素,列号相同者先存储行号较小的元素
l h
2 2
l 设有二维数组A=(a ) ,若每个元素占
ij mn
1
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“列优先顺序”存储时
③第n列中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+ (n-1)mL+(j-1)L j=1,2, …,m
jn 11THANKSCON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考点三: 特殊矩阵的压缩存储
什么是特殊矩阵?
特殊矩阵:矩阵中很多值相同的元素并且它们的分布有一定的规律
特殊矩阵如何压缩存储?
为值相同的元素分配一个存储空间
特殊矩阵压缩存储后有什么要求吗?
保证随机存取,即在O(1)时间内寻址考点三: 特殊矩阵的压缩存储
对称矩阵
3 6 4 7 8
6 2 8 4 2
A=
4 8 1 6 9 对称矩阵特点:a =a
ij ji
7 4 6 0 5
8 2 9 5 7
如何压缩存储对称矩阵呢? 只存储下三角部分的元素考点三: 特殊矩阵的压缩存储
1 … j … n
1
a 在一维数组中的序号
ij
= i×(i+1)/2+ j
…
∵一维数组下标从 0 开始
∴a 在一维数组中的下标
ij
k = i×(i+1)/2+ j-1
i a
ij
n
0 1 2 3 4 5 k n(n+1)/2-1
a a a a a a … a … a a … a
11 21 22 31 32 33 ij n1 n2 nn
第1行 第2行 第3行 第n行考点三: 特殊矩阵的压缩存储
对称矩阵压缩存储后的寻址方法
对于下三角中的元素a(i≥ j):k=i×(i+1)/2+j -1
ij
对于上三角中的元素a(i<j),因为a=a,则 k=j×(j+1)/2+i-1
ij ij ji
0 1 2 3 4 5 k n(n+1)/2-1
a a a a a a … a … a a … a
11 21 22 31 32 33 ij n1 n2 nn
第1行 第2行 第3行 第n行考点三: 特殊矩阵的压缩存储
三角矩阵
3 4 8 1 0
3 c c c c
c 2 9 4 6
6 2 c c c
c c 1 5 7
4 8 1 c c
c c c 0 8
7 4 6 0 c
c c c c 7
8 2 9 5 7
(a) 下三角矩阵 (b) 上三角矩阵
下(上)三角部分的元素
如何压缩存储三角矩阵呢?
相同的常数只存储一个考点三: 特殊矩阵的压缩存储
下三角矩阵的压缩存储
0 1 2 3 4 5 k n(n+1)/2
a a a a a a … a … a a … a c
11 21 22 31 32 33 ij n1 n2 nn
第1行 第2行 第3行 第n行
3 c c c c
下三角矩阵压缩存储后的寻址方法
6 2 c c c
对于下三角中的元素a (i ≥ j):k=i×(i + 1)/2 + j -1 4 8 1 c c
ij
7 4 6 0 c
对于上三角中的元素a (i<j):k=n×(n + 1)/2
ij
8 2 9 5 7
(a) 下三角矩阵考点三: 特殊矩阵的压缩存储
3 4 8 1 0
c 2 9 4 6
c c 1 5 7
(b) 上三角矩阵
c c c 0 8
c c c c 7
在数组a中,位于元素a (i<=j)前面的元素个数为
i,j
①第1行:n个元素(a ,a ,……,a )
1,1 1,2 1,n
②第2行:n-1个元素(a ,……,a )
2,2 2,n
③……
④第i-1行:n-i+2个元素(a ,……,a ),前面i-1行满足i<=j的元
i-1,i-1 i-1,n
素都要存储在B中考点三: 特殊矩阵的压缩存储
3 4 8 1 0
c 2 9 4 6
c c 1 5 7
(b) 上三角矩阵
c c c 0 8
c c c c 7
在数组a中,位于元素a (i<=j)前面的元素个数为
i,j
⑤第i行:j-1个元素(a ,……,a )
i,i i,j-1
因此,元素a (i<=j)在数组B中的下标
i,j
k = [n+(n-1)+……+(n-i+2)]+(j-i) = (i-1)(2n-i+2)/2+(j-i)。考点三: 特殊矩阵的压缩存储
3 4 8 1 0
c 2 9 4 6
c c 1 5 7
(b) 上三角矩阵
c c c 0 8
c c c c 7
下三角矩阵元素a 保存在向量sa中时的下标值k与(i,j)之间的对应关系是:
i j考点三: 特殊矩阵的压缩存储
对角矩阵
对角矩阵:所有非零元素都集中在以主对角线为中心的带状区域
中,所有其他元素都为零
a a 0 0 0 如何压缩存储对角矩阵呢?
11 12
a a a 0 0
21 22 23
A =
只存储非零元素
0 a a a 0
32 33 34
0 0 a a a
43 44 45
0 0 0 a a
54 55考点三: 特殊矩阵的压缩存储
a a 0 0 0
元素 a 在一维数组中的序号
11 12 ij
=2 + 3(i-2)+( j-i + 2)
a a a 0 0
21 22 23 =2i + j-2
A =
0 a a a 0 ∵一维数组下标从 0 开始
32 33 34
∴元素 a 在一维数组中的下标
ij
0 0 a a a
= 2i + j-3
43 44 45
0 0 0 a a
54 55
0 1 2 3 4 5 6 7 8 9 10 11 12
a a a a a a a a a a a a
11 12 21 22 23 32 33 34 43 44 45 54
a
55
第1行 第2行 第3行考点三: 特殊矩阵的压缩存储
3 0 0 7
稀疏矩阵
0 0 1 0
什么是稀疏矩阵?
A = 2 0 0 0
0 0 0 0
稀疏矩阵:矩阵中有很多零元素
0 0 0 8
稀疏矩阵如何压缩存储?
只存储非零元素,零元素不分配存储空间
如何只存储非零元素?
三元组:(行号,列号,非零元素值)考点三: 特殊矩阵的压缩存储
三元组表:将稀疏矩阵的非零元素对应的三元组所构成的集合,
按行优先的顺序排列成一个线性表
如何存储三元组表?
typedef int DataType; ((1, 1, 3), (1, 4, 7), (2, 3, 1), (3, 1, 2), (5, 4, 8))
typedef struct
{
int row, col;
3 0 0 7
DataType item;
} Element; 0 0 1 0
A = 2 0 0 0
0 0 0 0
三元组:(行号,列号,非零元素值)
0 0 0 8考点三: 特殊矩阵的压缩存储
三元组顺序表需要预留存储单元吗?
((1, 1, 3), (1, 4, 7), (2, 3, 1), (3, 1, 2), (5, 4, 8))
3 0 0 7
稀疏矩阵的修改操作
0 0 1 0
A = 2 0 0 0
0 0 0 0
三元组表的插入/删除操作
0 0 0 8考点三: 特殊矩阵的压缩存储
row col item
1 1 3
0 是否对应惟一的稀疏矩阵?
1 4 7
1
2 3 1
2 3 0 0 7
3 1 2
3
0 0 1 0
5 4 8
4
A = 2 0 0 0
空 空 空
0 0 0 0
0 0 0 8
闲 闲 闲
MaxTerm-1
5(非零元个数)
5(矩阵的行数)
6(矩阵的列数)考点三: 特殊矩阵的压缩存储
三元组顺序表不适合什么情况?
稀疏矩阵的加法、乘法等操作,非零元素的个数及位置都会发生变化,
则在三元组顺序表中就要进行插入和删除操作,顺序存储就十分不便
row col item typedef struct OrthNode
{
down right
Element data;
struct OrthNode *right, *down;
} OrthNode;考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(1)对于稀疏矩阵中每个非零元素创建一个结点存放它,包含元素的行号、列号和
元素值。这里有4个非零元素,创建4个数据结点。考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(2)将同一行的所有结点构成一个带头结点的循环单链表,行号为i的单链表的头
结点为hr[i]。这里有3行,对应有3个循环单链表,头结点分别为 hr[0]~hr[2]。
hr[i](0<i<2)头结点的行指针指向行号为i的单链表的首结点。考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(3)将同一列的所有结点构成一个带头结点的循环单链表,列号为i的单链表的头
结点为hd门。这里有4列,对应有4个循环单链表,头结点分别为 hd[0]~hd[3]。
hd[j](0<j<3)头结点的列指针指向列号为j的单链表的首结点。考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(4)再将所有头结点h[i](0<i<3)连起来构成一个带头结点的循环单链表,这样需
要增加一个总头结点hm,总头结点中存放稀疏矩阵的行数和列数等信息。考点三: 特殊矩阵的压缩存储THANKSCON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考纲框架
字符串的基本概念
字符串的顺序存储结构
字符串的链式存储结构
字符串匹配【字符串的基本概念】考点四: 字符串和字符串匹配
串(或字符串)是由零个或多个字符组成的有限序列。
串 线性表
⚫ 串中所含字符的个数称为该串的长度(或串长)。
⚫ 含零个字符的串称为空串,用Ф表示。考点四: 字符串和字符串匹配
串的逻辑表示:
“a a … a ”
1 2 n
双引号不是串的内容,起标识作用
串的逻辑表示, a(1≤i≤n)代表一个字符。
i考点四: 字符串和字符串匹配
串相等:两个串的长度相等并且各个对应位置上的字符都相同时。
如:
“abcd” ≠ “abc”
“abcd” ≠ “abcde”
所有空串是相等的。考点四: 字符串和字符串匹配
子串:
一个串中任意个连续字符组成的子序列(含空串)称为该串的子串。
例如, “abcde”的子串有:“”、“a”、“ab” 、“abc”、
“abcd”和“abcde”等
真子串是指不包含自身的所有子串。考点四: 字符串和字符串匹配
串抽象数据类型=逻辑结构+基本运算(运算描述)
串的基本运算如下:
StrAssign(&s,cstr):将字符串常量cstr赋给串s,即生成其值等于
cstr的串s。
StrCopy(&s,t):串复制。将串t赋给串s。
StrEqual(s,t):判串相等。若两个串s与t相等则返回真;否则返回
假。
StrLength(s):求串长。返回串s中字符个数。
Concat(s,t):串连接:返回由两个串s和t连接在一起形成的新串。
SubStr(s,i,j):求子串。返回串s中从第i(1≤i≤n)个字符开始的、
由连续j个字符组成的子串。考点四: 字符串和字符串匹配
InsStr(s1,i,s2):插入。将串s2插入到串s1的第i(1≤i≤n+1)个
字符中,即将s2的第一个字符作为s1的第i个字符,并返回产生的新
串。
DelStr(s,i,j):删除。从串s中删去从第i(1≤i≤n)个字符开始的
长度为j的子串,并返回产生的新串。
RepStr(s,i,j,t):替换。在串s中,将第i(1≤i≤n)个字符开始
的j个字符构成的子串用串t替换,并返回产生的新串。
DispStr(s):串输出。输出串s的所有元素值。【字符串的顺序存储结构】考点四: 字符串和字符串匹配
串中元素逻辑关系与线性表的相同,串可以采用与线性表相同的存储结构。
逻辑结构
线性表
顺序表 链 表
顺序串 链串 存储结构考点四: 字符串和字符串匹配
顺序串中的字符被依次存放在一组连续的存储单元里。
#define MaxSize 100
typedef struct
{ char data[MaxSize];
用来存储字符串
int length;
} SqString;
用来存储字符串长度考点四: 字符串和字符串匹配
1、生成串StrAssign(&s,cstr)
将一个C/C++字符串常量cstr(以'\0'字符标识结尾)赋给顺序串s,即生成
一个其值等于cstr的串s。
void StrAssign(SqString &s, char cstr[]) //s为引用型参数
{
int i;
for (i=0;cstr[i]!='\0';i++)
s.data[i]=cstr[i];
s.length=i; //设置串s的长度
}考点四: 字符串和字符串匹配
2、 串比较运算Strcmp(s,t)
1)比较s和t两个串共同长度范围内的对应字符:
① 若s的字符>t的字符,返回1;
② 若s的字符<t的字符,返回-1;
③ 若s的字符=t的字符,按上述规则继续比较。
2)当1)中对应字符均相同时,比较s和t的长度:
① 两者相等时,返回0;
② s的长度>t的长度,返回1;
③ s的长度<t的长度,返回-1。考点四: 字符串和字符串匹配
int Strcmp(SqString s,SqString t)
{
int i,comlen;
if (s.length<t.length)
comlen=s.length; //求s和t的共同长度
else
comlen=t.length;
for (i=0;i<comlen;i++) //在共同长度内逐个字符比较
if (s.data[i]>t.data[i])
return 1;
else if (s.data[i]<t.data[i])
return -1;
if (s.length==t.length) //s==t
return 0;
else if (s.length>t.length) //s>t
return 1;
else return -1; //s<t
}考点四: 字符串和字符串匹配
3、串连接Concat(s,t)
"abcd"
Concat "abcd123"
返回由两个顺序串s和t连接在一起形成的结果串。
"123"
SqString Concat(SqString s,SqString t)
{ SqString str; //定义结果串
int i;
str.length=s.length+t.length;
for (i=0;i<s.length;i++) //将s.data[0..s.length-1]复制到str
str.data[i]=s.data[i];
for (i=0;i<t.length;i++) //将t.data[0..t.length-1]复制到str
str.data[s.length+i]=t.data[i];
return str;
}考点四: 字符串和字符串匹配
4、求子串操作
返回pos到len之间的字符子串。
int SubString (SqString s, int pos, int len, SqString &sub){
int k, j ;
if (pos<1||pos>s.length||len<0||len>(s.length-pos+1))
return 0 ; /* 参数非法 */
sub->length=len-pos+1 ; /* 求得子串长度 */
for (j=0, k=pos ; k<=leng ; k++, j++)
sub->str[j]=s.str[i] ; /* 逐个字符复制求得子串 */
return 1 ;
}考点四: 字符串和字符串匹配
5、串的复制 StrCopy(&s,t)
将顺序串复制给顺序串s。
void StrCopy(SqString &s, SqString t){ //s为引用型参数
int i;
for(i=0;i<t.length;i++) //复制t的所有字符
s. data[i]=t.data[i];
s.length=t.length; //设置串s的长度
}【字符串的链式存储结构】考点四: 字符串和字符串匹配
⚫ 链串的组织形式与一般的链表类似。
⚫ 链串中的一个结点可以存储多个字符。通常将链串中每个结点所存
储的字符个数称为结点大小。考点四: 字符串和字符串匹配
s
…
ABCD EFGH MN## ∧
结点大小为4的链串
s
…
A B N ∧
结点大小为1的链串考点四: 字符串和字符串匹配
链串结点大小1时,链串的结点类型声明如下:
typedef struct snode
{ char data;
struct snode *next;
} LinkStrNode;
s
…
A B N ∧考点四: 字符串和字符串匹配
1、生成串StrAssign(&s,cstr)
将一个C/C++字符串常量cstr(以'\0'字符标识结尾)赋给链串s,即生成一个
其值等于cstr的链串s。
void StrAssign(LinkStrNode *&s,char cstr[])
{
int i;
LinkStrNode *r,*p;
s=(LinkStrNode *)malloc(sizeof(LinkStrNode));
r=s; //r始终指向尾结点
for (i=0;cstr[i]!='\0';i++)
{
p=(LinkStrNode *)malloc(sizeof(LinkStrNode));
p->data=cstr[i];
r->next=p; r=p;
}
r->next=NULL; //尾结点next域置为空
}考点四: 字符串和字符串匹配
2、串连接Concat(s,t)
求由两个链串s和t的数据结点连接在一起形成结果串。
LinkStrNode *Concat(LinkStrNode *s,LinkStrNode *t)
{ LinkStrNode *str,*p=s->next,*q,*r;
str=(LinkStrNode *)malloc(sizeof(LinkStrNode));
r=str; //r指向结果串的尾结点
while (p!=NULL) //用p扫描s的所有数据结点
{ q=(LinkStrNode *)malloc(sizeof(LinkStrNode));
q->data=p->data; //将p结点复制到q结点中
r->next=q;r=q; //将q结点链接到str的末尾
p=p->next;
}考点四: 字符串和字符串匹配
2、串连接Concat(s,t)
求由两个链串s和t的数据结点连接在一起形成结果串。
LinkStrNode *Concat(LinkStrNode *s,LinkStrNode *t) {
p=t->next;
while (p!=NULL) //用p扫描t的所有数据结点
{ q=(LinkStrNode *)malloc(sizeof(LinkStrNode));
q->data=p->data; //将p结点复制到q结点中
r->next=q;r=q; //将q结点链接到str的末尾
p=p->next;
}
r->next=NULL; //尾结点的next域置为空
return str;
}考点四: 字符串和字符串匹配
3、判断串相等 StrEqual(s,t)
若两个链串s与t的长度相等且对应位置的字符均相同,则返回真;否则返回假。
bool StrEqual(LinkStrNode xs,LinkStrNode * t){
LinkStrNode *p-s->next,*q=t->next; //p、q分别扫描链串s和t的数据结点
while(p!=NULL&& q!=NULL&& p->data==q-> data){
p=p-> next;
q=q-> next;
}
if(p==NULL &&q==NULL) //s和t的长度相等且对应位置的字符均相同
return true;
else
return false;
}【字符串匹配】考点四: 字符串和字符串匹配
字符串匹配
设有两个串s和t,串t的定位就是要在串s
中找到一个与t相等的子串。通常把s称
为目标串(target string),把t称为模式串
(pattern string),因此串定位查找也称为
模式匹配(pattern matching)。
模式匹配成功是指在目标串s中找到了一
个模式串t;
不成功则指目标串s中不存在模式串t。
标串s中不存在模式串。考点四: 字符串和字符串匹配
暴力匹配算法
字符串BF算法(Brute Force算法)是一种基本的字符串匹配算法,也称为暴
力匹配算法或朴素匹配算法。其基本思想是将目标串(主串)的第一个字符与
模式串(子串)的第一个字符进行匹配,若相等,则继续比较下一个字符;若
不相等,则将模式串向右滑动一个字符,再次进行比较,直到找到匹配或遍历
完整个主串为止考点四: 字符串和字符串匹配
暴力匹配算法步骤
①将模式串(子串)与目标串(主串)的第一个字符进行比较。
②如果第一个字符相等,则继续比较下一个字符;如果不相等,则将模式
串向右滑动一个字符,重新开始比较。
③重复步骤②,直到模式串的最后一个字符与目标串的对应字符比较完毕。
④如果模式串的所有字符都与目标串的对应字符相等,则匹配成功;否则,
匹配失败。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第一趟比较中,当i=0,1与j=0,1处的元素相等,当i=2,j=2时,元素不相等,
此时i回溯到1,j回溯到0,如图所示。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第2趟比较中,当i=1, j=0处的元素不相等,此时i回溯到2,j回溯到0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第3趟比较中,当i=2, j=0处的元素相等,i=3, j=1处的元素相等,i=4, j=2处
的元素相等,i=4, j=3处的元素不相等,此时i回溯到3,j回溯到0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第4趟比较中,i=3,j=0的元素不相等,此时i回溯到4,j回溯到0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第五趟比较中,i=4,j=0处的元素不相等,此时i回溯到i=5,j=0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第六趟比较中,i=5,j=0处的元素相等,i=6,j=1处的元素相等,i=7,j=2
处的元素相等,i=8,j=3处的元素相等,i=9,j=4处的元素相等,全部字符
匹配成功。考点四: 字符串和字符串匹配
BF算法代码实现
int index(SqString s,SqString t)
{
int i,j,k;
for (i=0;i<=s.length-t.length;i++)
{ for (k=i,j=0; k<s.length && j<t.length && s.data[k]==t.data[j]; k++,j++);
if (j==t.length)
return(i);
}
return(-1);
}考点四: 字符串和字符串匹配
BF算法分析
• 算法在字符比较不相等,需要回溯(即i=i-j+1):即退到s中的下一个字符
开始进行继续匹配。
• 最好情况下的时间复杂度为O(m)。
• 最坏情况下的时间复杂度为O(n×m)。
• 平均的时间复杂度为O(n×m)。【KMP算法】考点四: 字符串和字符串匹配
KMP算法思想
KMP算法是D.E.Knuth、J.H.Morris和V.R.Pratt共同提出的,简称KMP
算法。
该算法较BF算法有较大改进,主要是消除了主串指针的回溯,从而使算
法效率有了某种程度的提高。考点四: 字符串和字符串匹配
KMP算法思想
基于BF算法,采用空间换时间的方式,提取保存有利于匹配的信息。
提取s还是t中的信息?每次从s不同字符开始匹配,而t总是从t0开始
匹配 提取t中的信息
t中的什么信息? 部分匹配信息。考点四: 字符串和字符串匹配
两个概念
• 前缀的概念:字符串起始部分(不能是整个字符串),对于字符串
"abcab",它有"a" "ab" "abc" "abca" 这样四个前缀。
• 最长前缀概念: 最长前缀是说以第一个字符开始,但是不包含最
后一个字符。前缀的最大长度不能等于整个字符串的长度,比如示
例中"abcab"的最长前缀是abca,而不能是整个字符串"abcab"。考点四: 字符串和字符串匹配
两个概念
• 后缀的概念:字符串末尾部分(不能是整个字符串),对于字符串
"abcab",它有"b" "ab" "cab" "bcab" 这样四个后缀。
• 最长后缀概念: 最长后缀是说以最后一个字符开始,但是不包含
第一个字符。示例中"abcab"的最长后缀是bcab,而不能是整个字
符串"abcab"考点四: 字符串和字符串匹配
两个概念
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-kj-k+1 j-1
开头的k个字符 t 前面的k个字符
j考点四: 字符串和字符串匹配
两个概念
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。
0 1 2 3 4
例如,t= “ababc” 考虑t[4]='c'
t= “a b a b c”
k=2,所以next[4] = k= 2。考点四: 字符串和字符串匹配
两个概念
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。考点四: 字符串和字符串匹配
两个概念
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-kj-k+1 j-1
开头的k个字符 t 前面的k个字符
j
求最大的k
0 1 2 3 4
例如,t= “aaaac” 考虑t[4]='c'
t= “a a a a c”
k=3,所以next[4] = k= 3。考点四: 字符串和字符串匹配
两个概念
t 字符前面的子串最多从t 开始的,不含t
j 1 0
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-kj-k+1 j-1
t 前面的k个字符
开头的k个字符
j
这个字符不能是t
0考点四: 字符串和字符串匹配
求解next数组的实例,求模式串t="aaaab"的next数组。
• 定义next[0]=-1,next[1]=0。
• 当j=2时,1~j-1的位置上只有一个字符'a'与t的开头字符相同,所以 next[2]=1.
• 当j=3时,1~j-1的位置上,的前面有字符串"a"和"aa"均与t的开头字符串相同,
所以 next[3 =2。
• 当j=4时,1~j-1的位置上t的前面有字符串"a"、"aa"和"aaa"均与t的开头字符
串相同,所以 next[4]=3。
归纳起来,模式串t对应的next数组如表所示,
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3考点四: 字符串和字符串匹配
模式串t求next值的算法
void GetNext(SqString t,int next[]) {
int j,k;
j=0; k=-1; next[0]=-1;
while (j<t.length-1) {
if (k==-1 || t.data[j]==t.data[k]){
j++; k++;
next[j]=k;
}
}考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。
• 在KMP算法中,该值一方面表示模式串中1~i位置子串中的最长相
同前后缀长度,另一方面表示在该位置匹配失败时模式串回溯比较
的下一个字符位置考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
目标串s="aaaaab",模式串t="aaab"
第1趟匹配是从i=0、j=0开始的,失配处为i=3,j=3。尽管本趟匹配失败
了,但得到这样的“部分匹配”信息:s s 与t t 相同,如图所示。
1 2 1 2考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
目标串s="aaaaab",模式串t="aaab"
模式串t中有next[3]=2,表明t t =t t ,所以有s s =t t ,如图所示
1 2 0 1 1 2 0 1考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
目标串s="aaaaab",模式串t="aaab"
原来第2趟匹配是从i=1、j=0开始的,即需要回溯。现在既然有
s s =t t 成立,第2趟匹配可以从i=3、j=2(=next[3])开始,如图所示,即保
1 2 0 1
持主串指针i不变,模式串t右滑(j=next[j])个位置,让s 和t 对齐进行比
i next[j]=2
较。考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
i=0; j=0;
while (s和t都没有扫描完) {
if (j=-1或者它们所指字符相同)
i和j分别增1;
else
i不变,j回退到j=next[j](即模式串右滑);
}
if (j超界)
返回i; //模式匹配成功
else
返回-1; //模式匹配失败考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
int KMPIndex(SqString s,SqString t) {
int next[MaxSize],i=0,j=0;
GetNext(t,next);
while (i<s.length && j<t.length) {
if (j==-1 || s.data[i]==t.data[j]) {
i++;
j++; //i、j各增1
}
else j=next[j]; //i不变,j后退
}
if (j>=t.length)
return(i-t.length); //返回匹配模式串的首字符
else
return -1; //返回不匹配标志
}考点四: 字符串和字符串匹配
KMP算法分析
⚫ 设串s的长度为n,串t长度为m。
⚫ KMP算法中求next数组的时间复杂度为O(m),在后面的匹配中因
主串s的下标不减即不回溯,比较次数可记为n,所以KMP算法平均
时间复杂度为O(n+m)。
⚫ 最坏的时间复杂度为O(n×m)。考点四: 字符串和字符串匹配
KMP算法的改进
设目标串s=“aaabaaaab”,模式串t=“aaaab”。KMP模式匹配过程。
(1)求t的next
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
失败:
t: a a a a b
i=3
0 1 2 3 4
j=3,j=next[3]=2考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=2
失败:
t: a a a a b
0 1 2 3 4 i=3
j=2,j=next[2]=1考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=1
t: a a a a b 失败:
0 1 2 3 4 i=3
j=1,j=next[1]=0考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=0 失败:
t: a a a a b
i=3
0 1 2 3 4
j=0,j=next[0]=-1考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
因为j=-1:
0 1 2 3 4 5 6 7 8
i++;
s: a a a b a a a a b
j++;
即:
i=4 t: a a a a b
成功匹配:
j=0
0 1 2 3 4
返回i-t.length
=9-5=4考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
前面的匹配过程:
i=3 i=3 i=3 i=3 i=3
j=3 j=2 j=1 j=0 j=-1
将s[i] 将s[i] 将s[i] 将s[i] 将s[i+1]
与t[3] 与t[2] 与t[1] 与t[0] 与t[0]
匹配 匹配 匹配 匹配 匹配
因为t[3]=t[2]=t[1]=t[0]='a' 是不必要的
i=3 i=3
j=3 j=-1考点四: 字符串和字符串匹配
KMP算法的改进 将next改为nextval:
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
nextval[j] -1 -1 -1 -1 3
t[4]='b' ≠ t[next[4]]='a'
next[1]=0
t[1]=t[next[1]]=t[0]='a'
∴ nextval[4]=next[4]
∴ nextval[1]=nextval[0]=-1
⚫ nextval[0]=-1
⚫ 当t[j]=t[next[j]]时:nextval[j]=nextval[next[j]]
⚫ 否则: nextval[j]=next[j]
用nextval取代next,得到改进的KMP算法。考点四: 字符串和字符串匹配
KMP算法的改进
使用改进后的KMP算法示例:
j 0 1 2 3 4
t[j] a a a a b
nextval[j] -1 -1 -1 -1 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
失败:
t: a a a a b
i=3
0 1 2 3 4
j=3,j=nextval[3]=-1考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
nextval[j] -1 -1 -1 -1 3
因为j=-1:
0 1 2 3 4 5 6 7 8
i++;
s: a a a b a a a a b
j++;
即
t: a a a a b
i=4
成功匹配:
0 1 2 3 4
j=0
返回i-t.length
=9-5=4
改进后的KMP算法进一步提高模式匹配的效率。考点四: 字符串和字符串匹配
KMP算法的改进
设目标串 s="abcaabbabcabaacbacba",模式串 t="abcabaa",计算模式
串t的nextval函数值,并给出利用改进KMP算法进行模式匹配的过程。
模式串t的nextval值如下表所示。考点四: 字符串和字符串匹配
KMP算法的改进考点四: 字符串和字符串匹配
KMP算法的改进考点四: 字符串和字符串匹配
KMP算法的改进考点四: 字符串和字符串匹配
KMP算法的改进THANKS