第八讲:排序
主讲人:刘财政
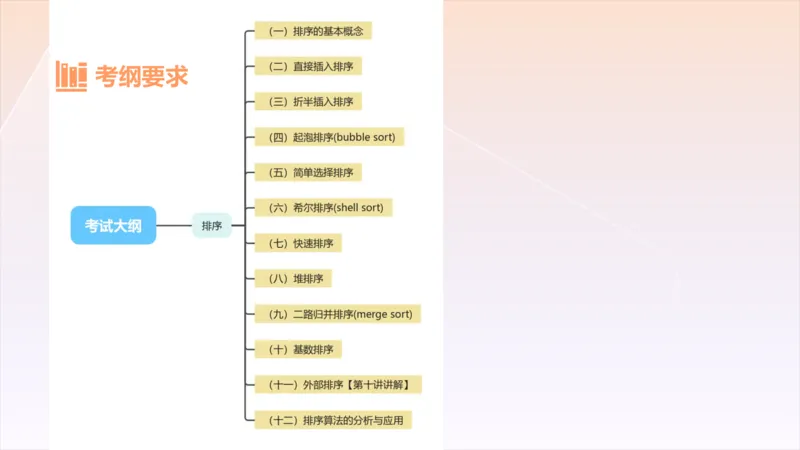
B站:@计算机考研刘财政考纲要求CON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点框架CON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
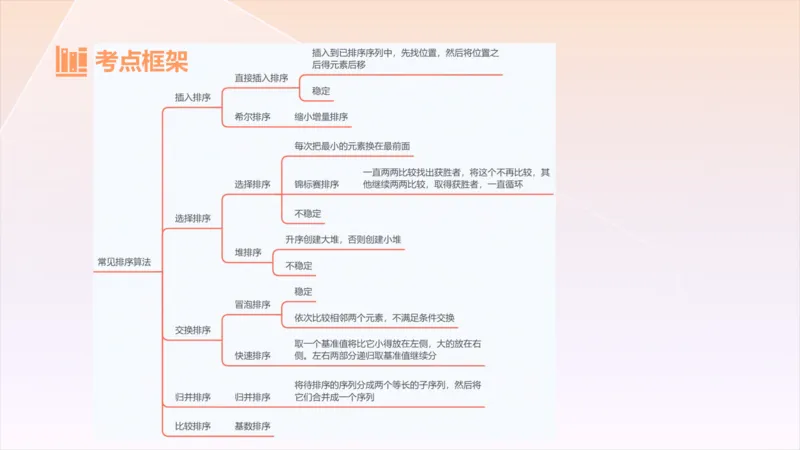
考点七 各种排序的比较分析 ★★★★★考点框架
排序的定义
排序的基本概念
排序算法的性能【排序的定义】考点一: 排序的概念和性能分析
数据元素、结点、顶点
排序:给定一组记录的集合{r, r, …, r },其相应的关键码分别为
1 2 n
{k, k, …, k },将这些记录排列为{r , r , …, r }的序列,使得相
1 2 n s1 s2 sn
应的关键码满足k ≤k ≤…≤k (或k ≥k ≥…≥k )。
s1 s2 sn s1 s2 sn
升序(非降序) 降序(非升序)考点一: 排序的概念和性能分析
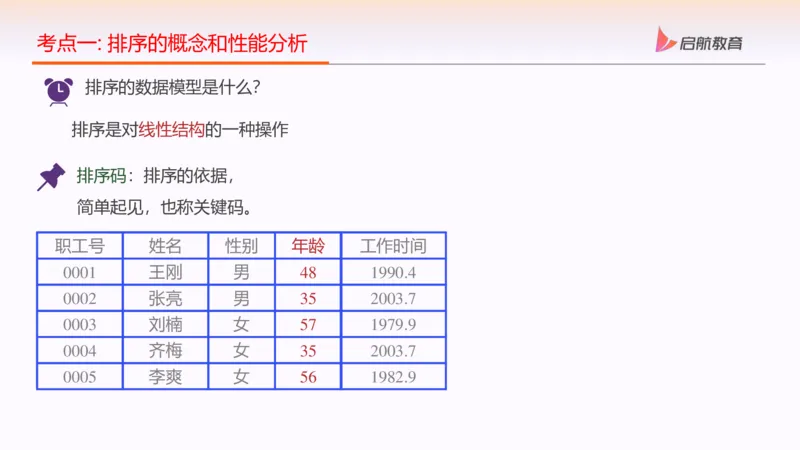
排序的数据模型是什么?
排序是对线性结构的一种操作
排序码:排序的依据,
简单起见,也称关键码。
职工号 姓名 性别 年龄 工作时间
0001 王刚 男 48 1990.4
0002 张亮 男 35 2003.7
0003 刘楠 女 57 1979.9
0004 齐梅 女 35 2003.7
0005 李爽 女 56 1982.9考点一: 排序的概念和性能分析
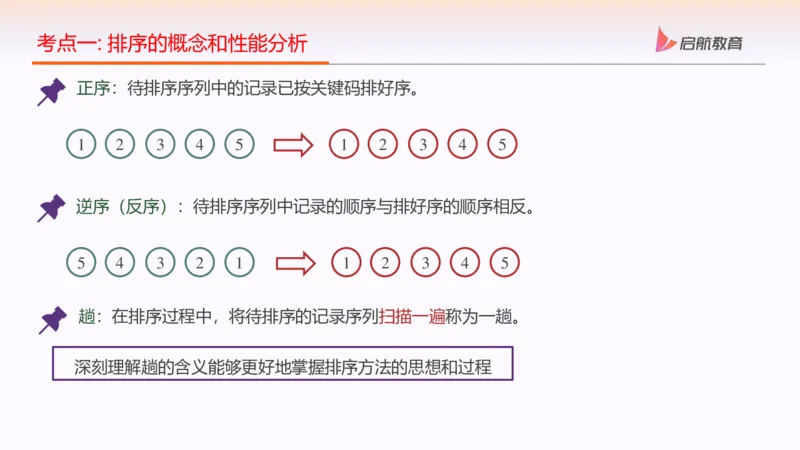
正序:待排序序列中的记录已按关键码排好序。
1 2 3 4 5 1 2 3 4 5
逆序(反序):待排序序列中记录的顺序与排好序的顺序相反。
5 4 3 2 1 1 2 3 4 5
趟:在排序过程中,将待排序的记录序列扫描一遍称为一趟。
深刻理解趟的含义能够更好地掌握排序方法的思想和过程【排序的基本概念】考点一: 排序的概念和性能分析
根据排序过程中所有记录是否全部放在内存中,排序方法分为:
◆ 比较两个关键字的大小;
◆ 存储位置的移动:从一个位置移到另一个位置。
第一种操作是必不可少的;而第二种操作却不是必须的,取决于记录
的存储方式,具体情况是:
① 记录存储在一组连续地址的存储空间:记录之间的逻辑顺序关系是
通过其物理存储位置的相邻来体现,记录的移动是必不可少的;
② 记录采用链式存储方式:记录之间的逻辑顺序关系是通过结点中的
指针来体现,排序过程仅需修改结点的指针,而不需要移动记录;考点一: 排序的概念和性能分析
排序的稳定性
若记录序列中有两个或两个以上关键字相等的记录: K =K (i≠j,i,
i j
j=1, 2, … n),且在排序前R 先于R (i<j),排序后的记录序列仍然是R
i j i
先于R ,称排序方法是稳定的,否则是不稳定的。
j
23 12 30 18 9 40 36 39 9
9 9 12 18 23 30 36 39 40
稳定性排序考点一: 排序的概念和性能分析
排序的稳定性
若记录序列中有两个或两个以上关键字相等的记录: K =K (i≠j,i,
i j
j=1, 2, … n),且在排序前R 先于R (i<j),排序后的记录序列仍然是R
i j i
先于R ,称排序方法是稳定的,否则是不稳定的。
j
23 12 30 18 9 40 36 39 9
9 9 12 18 23 30 36 39 40
不稳定性排序考点一: 排序的概念和性能分析
根据排序过程中所有记录是否全部放在内存中,排序方法分为:
(1)内排序:在排序的整个过程中,待排序的所有记录全部放在内存中
(2)外排序:由于待排序的记录个数太多,不能同时放置在内存,而
需要将一部分记录放置在内存,另一部分记录放置在外存上,整个排序
过程需要在内外存之间多次交换数据才能得到排序的结果。考点一: 排序的概念和性能分析
根据排序方法是否建立在关键码比较的基础上,排序方法分为:
(1)基于比较:主要通过关键码之间的比较和记录的移动实现
① 插入排序;② 交换排序;③ 选择排序;④ 归并排序
(2)不基于比较:根据待排序数据的特点所采取的其他方法【排序算法的性能】考点一: 排序的概念和性能分析
根据排序过程中所有记录是否全部放在内存中,排序方法分为:
◆ 比较两个关键字的大小;
◆ 存储位置的移动:从一个位置移到另一个位置。
第一种操作是必不可少的;而第二种操作却不是必须的,取决于记录的存
储方式,具体情况是:
① 记录存储在一组连续地址的存储空间:记录之间的逻辑顺序关系是通过其物
理存储位置的相邻来体现,记录的移动是必不可少的;
② 记录采用链式存储方式:记录之间的逻辑顺序关系是通过结点中的指针来体
现,排序过程仅需修改结点的指针,而不需要移动记录;THANKSCON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点框架考点框架
直接插入排序
折半插入排序
希尔排序【直接插入排序】考点二: 插入类排序
直接插入排序的基本思想:依次将待排序序列中的每一个记录插
入到已排好序的序列中,直到全部记录都排好序。
有序区 无序区
R[0] …… R[i-1] R[i] …… R[n-1]
一趟排序
R[0] …… R[i-1] R[i] R[i+1] …… R[n-1]
有序区 无序区
初始时,有序区只有一个元素R[0]
i=1~n-1,共经过n-1趟排序考点二: 插入类排序
一趟直接插入排序:在有序区中插入R[i ]的过程
有序区R[0..i-1]
R[i] 当R[i].key<R[i-1].key时
j=i-1
j
无序区R[i..n-1]
插入位置
R[j]大时便后移
R[j+1]=tmp
tmp
使R[0..i]有序 扩大有序区考点二: 插入类排序
直接插入排序过程
设待排序的表有10个元素,其关键字分别为(9,8,7,6,5,4,3,
2,1,0)。说明采用直接插入排序方法进行排序的过程。考点二: 插入类排序
0 1 2 3 4 5 6 7 8 9
初始:
9 8 7 6 5 4 3 2 1 0
i=1:
8 9 7 6 5 4 3 2 1 0
i=2:
7 8 9 6 5 4 3 2 1 0
i=3: 6 7 8 9 5 4 3 2 1 0考点二: 插入类排序
0 1 2 3 4 5 6 7 8 9
i=3:
6 7 8 9 5
4 3 2 1 0
i=4:
5 6 7 8 9 4 3 2 1 0
i=5: 4 5 6 7 8 9 3 2 1 0
i=6: 3 4 5 6 7 8 9 2 1 0考点二: 插入类排序
1 2 3 4 5 6 7 8 9
0
i=6:
3 4 5 6
7 8 9
2 1 0
i=7: 2 3 4 5 6 7 8 9 1 0
i=8: 1 2 3 4 5 6 7 8 9 0
i=9: 0 1 2 3 4 5 6 7 8 9考点二: 插入类排序
void insertionSort(int R[], int n) {
int i, j, key;
for (i = 1; i < n; i++) {
key = R [i];
j = i - 1;
while (j >= 0 && R [j] > key) {
R [j + 1] = R [j];
j = j - 1;
}
R [j + 1] = key;
}
}考点二: 插入类排序
算法分析
⑴ 最好情况:若待排序记录按关键字从小到大排列(正序),算法中的
内循环无须执行,则一趟排序时:关键字比较次数1次,记录移动次数
2次。则整个排序的关键字比较次数和记录移动次数分别是:
n-1 n-1
比较次数:∑ 1=n-1 移动次数:∑ 2=2(n-1)
i=1 i=1考点二: 插入类排序
⑵ 最坏情况:若待排序记录按关键字从大到小排列(逆序),则一趟排
序时:算法中的内循环体执行i次,关键字比较次数i次,记录移动次
数i+2。
n-1
n(n-1)
则就整个排序而言:
比较次数:
∑ i=
2
i=1
n-1
(n-1)(n+4)
移动次数:
∑(i+2)=
2
i=1考点二: 插入类排序
一般地,认为待排序的记录可能出现的各种排列的概率相同,则
取以上两种情况的平均值,作为排序的关键字比较次数和记录移动次
数,约为n2/4,则复杂度为O(n2) 。【折半插入排序】考点二: 插入类排序
1 折半插入排序基本思路
查找采用折半查找方法,称为二分插入排序或折半插入排序。
有序区 无序区
R[0] …… R[i-1] R[i] …… R[n-1]
采用折半查找在有序区
找到插入的位置考点二: 插入类排序
2 如何在R[low..high]中查找插入R[i]的位置?
在R[low..high]中查找≥R[i].key(k=R[i].key)的最后的位置high
如果R[low..high]不空:
mid=(low+high)/2
k<R[mid].key k≥R[mid].key
R[low..mid-1] R[mid+1..high]
< k ≥ k
如果R[low..high]空:
R[low..high] R[high+1..*]
R[i]考点二: 插入类排序
排序示例
设有一组关键字30, 13, 70, 85, 39, 42, 6, 20,采用折半插入排序方法排序的过
程如图所示:考点二: 插入类排序
折半插入排序采用折半查找,查找效率提高,即关键字比较次数减
少了。
但元素移动次数不变,仅仅将分散移动改为集合移动。【希尔排序】考点二: 插入类排序
希尔排序的基本思想:将待排序序列分割成若干个子序列,在子序
列内分别进行直接插入排序,待序列基本有序时,对全体记录进行
直接插入排序。
基本有序:接近正序,例如{1, 2, 8, 4, 5, 6, 7, 3, 9}。
{6, 7, 8, 9, 1, 2, 3, 4, 5}是基本有序吗?
局部有序(部分有序)不能提高直接插入排序算法的时间性能。
如何分割待排序序列,才能使整个序列逐步向基本有序发展?考点二: 插入类排序
32 30
24 24* 20 28
10 16 08 12
24 24* 32 20 28 30
10 16 08 12
不能是逐段分割,而是将相距某个增量的记录组成一个子序列
如何分割待排序序列,才能使整个序列逐步向基本有序发展?考点二: 插入类排序
注意:
(1)子序列的构成不是简单的“逐段分割”,而是将相隔某个增量的记录组成
一个子序列。
(2)增量序列的初值的计算公式一般是2 * d = n ; n表示元素个数,d 是第一
1 1
个增量
(3)增量序列之间没有除1以外的公因子(也就是他们之间没有约数);最后
一个增量值必须为1。
(4)每一个序列内部采用的是直接插入排序。考点二: 插入类排序
32 28 30
24 24* 20
10 16 08 12
待排序序列
28 32 30
20 24* 16 24
12 08 10
增量 d = 4
28 32 30
20 24* 16 24
12 08 10
增量 d = 2
28 32 30
20 24* 24
08 10 16 12
增量 d = 1
28 30 32
16 20 24* 24
08 10 12考点二: 插入类排序
设有10个待排序的记录,关键字分别为9, 13, 8, 2, 5, 13, 7, 1, 15, 11,增量序
列是5, 3, 1,希尔排序的过程如图所示。考点二: 插入类排序
时间性能:O(n2) ~ O(nlog n)
2
(1)希尔排序算法的时间性能是所取增量的函数;
(2)研究表明,希尔排序的时间性能在O(n2)和O(nlog n)之间;
2
(3)如果选定合适的增量序列,希尔排序的时间性能可以达到O(n1.3) 。
空间性能:O(1)——暂存单元
稳定性:不稳定THANKSCON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点框架考点框架
冒泡排序
快速排序考点三: 交换类排序
两个元素反序时进行交换
常见的交换排序方法:
(1)冒泡排序(或起泡排序)
(2)快速排序【冒泡排序】考点三: 交换类排序
起泡排序的基本思想:两两比较相邻记录,如果反序则交换,直到
没有反序的记录为止。
反序则交换
r r … r r r … r
1 2 i-1 i i+1 n
无序区 有序区
类似水中的气泡,体积大的浮到上面,起泡排序因而得名考点三: 交换类排序
其过程是:
① 首先将R[0]与L->R[1]的关键字进行比较,若为反序(L->R[0]的关键字大于L-
>R[1]的关键字),则交换两个记录;然后比较L->R[1]与L->R[2]的关键字,依
此类推,直到R[n-2]与R[n-1]的关键字比较后为止,称为一趟冒泡排序,R[n-1]
为关键字最大的记录,如图8-13所示。
② 然后进行第二趟冒泡排序,对前n-1个记录进行同样的操作。考点三: 交换类排序
一般地,第i趟冒泡排序是对R[0 … n-i+1]中的记录进行的,因此,若待排序
的记录有n个,则要经过n-1趟冒泡排序才能使所有的记录有序。考点三: 交换类排序
算法实例
设有9个待排序的记录,关键字分别为23, 38, 22, 45, 23, 67, 31, 15, 41,冒泡
排序第一趟排序的过程如下所示(两两挨着的元素进行比较和交换)
数据初始状态:23, 38, 22, 45, 23, 67, 31, 15, 41
冒泡排序第一趟排序的过程如下所示:
如①是23和38比较,23小于38,不需要交换
如②是38和22比较,38大于22,22和38交换
如③是38和45比较,38小于45,不需要交换
如④是45和23比较,45大于23,45和23交换
如⑤是45和67比较,45小于67,不需要交换
如⑥是67和31比较,67大于31,67和31交换
如⑦是67和15比较,67大于15,67和15交换
如⑧是67和41比较,67大于41,67和41交换
经过8次比较,最终67被排到了最后。考点三: 交换类排序
冒泡排序第二趟排序的过程如下所示:第二趟排序需要在第一趟的基础上进行,
因为67已经排好,只需要排剩余的元素就可以。
如①是22和23比较,22小于23,不需要交换
如②是23和38比较,23小于38,不需要交换
如③是38和23比较,38大于23,38和23交换
如④是38和45比较,38小于45,不需要交换
如⑤是45和31比较,45大于67,45和31交换
如⑥是45和15比较,45大于15,45和15交换
如⑦是45和41比较,45大于41,45和41交换
经过7次比较,最终45被排到了最后。考点三: 交换类排序
冒泡的完整过程如下所示:考点三: 交换类排序
算法代码
void bubblesort(int R[],int n) {
int i, j,flag=0;
int temp;
for (i = 0; i < n; i++) {
for (j = 0; j < n-i; j++) {
if (R [j] > R [j + 1]) {
temp = R [j];
R [j] = R [j + 1];
R [j + 1] = temp
flag = 1; // 如果交换了那flag=1
}
}
if (flag == 0) { // 没交换的话flag=0,break
break;
}
}
}考点三: 交换类排序
O(n)
最好情况:正序
比较次数:n-1次
移动次数:0次
1 2 3 4 5
1 2 3 4 5考点三: 交换类排序
最坏情况:逆序 O(n2)
比较次数: 次
n
i
−
=
1
1
n − i =
n ( n
2
− 1 )
移动次数: 次
平均情况:随机排列,O(n2)
n
i
−
=
1
1
3 ( n − i ) =
3 n ( n
2
− 1 )
5 4 3 2 1
4 3 2 1 5
3 2 4 5
1
2 1 3 4 5
1 2 3 4 5【快速排序】考点三: 交换类排序
快速排序的基本思想:选一个轴值,将待排序记录划分成两部分,
左侧记录均小于或等于轴值,右侧记录均大于或等于轴值,然后分
别对这两部分重复上述过程,直到整个序列有序。
… …
r r r r r
1 i-1 i i+1 n
… …
r ' r ' r ' r ' r '
1 i-1 i i+1 n
均 ≤ r ' 均 ≥ r '
i i考点三: 交换类排序
无基 准序 的 序 列
一次划分
无序子序列 基准 无序子序列
分别进行快速排序
每趟使表的第1个元素(基准)放入适当位置(归位),将表一分
为二,对子表按递归方式继续这种划分.
直至划分的子表长为0或1(递归出口)。考点三: 交换类排序
24 20 30 16 32 28
10
待排序序列
一次划分结果 16 20 24 30 32 28
10
减少了总的比较次数和移动次数
较小的记录一次就能从后面移到前面(较大的记录?)
记录的比较和移动从两端向中间进行
如何实现一次划分——较大的记录移到后面,较小记录移到前面?考点三: 交换类排序
int quick_one_pass(int L[ ], int low, int high){
时间复杂度是多少?
int i = low, j = high, temp;
int pivotkey = L[i]; 下标 i 和 j 共同将数组扫描一遍,O(n)
while (i < j){
while (i < j && pivotkey<= L[j]) j--; /*右侧扫描*/
if (i < j) { L[i]=L[j]; i++; }
while (i < j && pivotkey >= L[i]) i++; /*左侧扫描*/
if (i < j) { L[j]=L[i]; ; j--; }
}
L[i] = pivotkey;
retutn i; /*i为轴值记录的最终位置*/
}考点三: 交换类排序
⑴ 一趟快速排序算法的实现
1 int quick_one_pass(Sqlist *L , int low, int high){
2 int i = low, j = high ;
3 int pivotkey = L [i];
4 while(i < j){ // i = j时退出扫描
5 while(pivotkey < L [j])&&(j>i))
6 j-- ;
7 if (j>i) { L [i]=L[j] ; i++; }
8 while(L [i]< pivotkey) && (j > i))
9 i++ ;
10 if (j>i){L[j]=L[i] ; j--;}
11 }
12 L[i] = pivotkey ;
13 return(i) ;
14 }考点三: 交换类排序
⑴ 一趟快速排序算法的实现
有7个待排序的记录,关键字分别为
1 int quick_one_pass(Sqlist *L , int low, int high){
29, 38, 22, 45, 23, 67,31一趟快速排序
2 int i = low, j = high ;
3 int pivotkey = L [i];
的过程如图所示,待排元素的数组是L,
4 while(i < j){ // i = j时退出扫描
①对应代码的第1行,low = 0,
5 while(pivotkey < L [j])&&(j>i))
6 j-- ;
high = 6;对应代码的第2行,i =0,j
7 if (j>i) { L [i]=L[j] ; i++; }
= 6;对应代码的第3行,pivotkey =
8 while(L [i]< pivotkey) && (j > i))
9 i++ ;
L[i] = 29;
10 if (j>i){L[j]=L[i] ; j--;}
②对应代码的第4行, i < j 满足条件,
11 }
12 L[i] = pivotkey ;
进入循环。
13 return(i) ;
14 }考点三: 交换类排序
⑴ 一趟快速排序算法的实现
有7个待排序的记录,关键字分别为29, 38,
1 int quick_one_pass(Sqlist *L , int low, int high){
22, 45, 23, 67,31一趟快速排序的过程如图所示,
2 int i = low, j = high ;
3 int pivotkey = L [i];
待排元素的数组是L,
4 while(i < j){ // i = j时退出扫描
③首先是从右往左比较,对应代码的第5行,
5 while(pivotkey < L [j])&&(j>i))
6 j-- ;
(pivotkey = 29) 小于 (L[6] = 31) 且(i < j)
7 if (j>i) { L [i]=L[j] ; i++; }
满足条件,对应代码第6行:j --, 此时j = 5;
8 while(L [i]< pivotkey) && (j > i))
9 i++ ;
回到第5行,(pivotkey = 29) 小于 (L[4] =
10 if (j>i){L[j]=L[i] ; j--;}
67) 且(i < j)满足条件,对应代码第6行:j --
11 }
12 L[i] = pivotkey ;
,此时j = 4;
13 return(i) ;
回到第5行,(pivotkey = 29) 大于 (L[4] =
14 }
23) 且(i < j);考点三: 交换类排序
有7个待排序的记录,关键字分别为29, 38, 22, 45, 23, 67,31一趟快速排序的过程如
图所示,待排元素的数组是L,
③首先是从右往左比较,对应代码的第5行, (pivotkey = 29) 小于 (L[6] = 31) 且(i
< j)满足条件,对应代码第6行:j --, 此时j = 5;
回 到 第 5 行 , (pivotkey
=29) 小于 (L[4] = 67) 且(i
< j)满足条件,对应代码第6
行:j --,此时j = 4;
回到第5行,(pivotkey =
29) 大于 (L[4] = 23) 且(i <
j);考点三: 交换类排序
⑴ 一趟快速排序算法的实现
有7个待排序的记录,关键字分别为29, 38, 22, 45, 23,
1 int quick_one_pass(Sqlist *L , int low, int high){
67,31一趟快速排序的过程如图所示,待排元素的数组是L,
2 int i = low, j = high ;
3 int pivotkey = L [i];
④执行代码第7行,(i < j)成立,将L[4](j = 4)放
4 while(i < j){ // i = j时退出扫描
到L[0](i = 0)的位置上,且i++,此时i = 1;如图①步
5 while(pivotkey < L [j])&&(j>i))
6 j-- ;
骤所示。
7 if (j>i) { L [i]=L[j] ; i++; }
8 while(L [i]< pivotkey) && (j > i))
9 i++ ;
10 if (j>i){L[j]=L[i] ; j--;}
11 }
12 L[i] = pivotkey ;
13 return(i) ;
14 }考点三: 交换类排序
⑴ 一趟快速排序算法的实现
有7个待排序的记录,关键字分别为29, 38, 22, 45, 23, 67,31
1 int quick_one_pass(Sqlist *L , int low, int high){
2 int i = low, j = high ;
一趟快速排序的过程如图所示,待排元素的数组是L,
3 int pivotkey = L [i];
⑤继续执行,对应代码第8行,(pivotkey = 29) 小于 (L[i] =
4 while(i < j){ // i = j时退出扫描
5 while(pivotkey < L [j])&&(j>i))
38) 且(i < j);
6 j-- ;
执行代码第10行,(i < j)成立,将L[1](i = 1)放到L[4](j =
7 if (j>i) { L [i]=L[j] ; i++; }
8 while(L [i]< pivotkey) && (j > i))
4)的位置上,且j--,此时j = 3;
9 i++ ;
回到代码第4行,i < j 满足条件,进入循环。
10 if (j>i){L[j]=L[i] ; j--;}
11 }
执行代码第5行,(pivotkey = 29) 小于 (L[3] = 45) 且(i < j)
12 L[i] = pivotkey ;
满足条件,对应代码第6行:j --, 此时j = 2;
13 return(i) ;
14 }
回到代码第5行,(pivotkey = 29) 大于 (L[2] = 22) 且(i <
j);
执行代码第7行,(i < j)成立,将L[j](j = 2)放到L[1](i
= 1)的位置上,且i++,此时i = 2;如图②所示。考点三: 交换类排序
有7个待排序的记录,关键字分别为29, 38, 22, 45, 23, 67,31一趟快速排序的过程如
图所示,待排元素的数组是L,
⑤继续执行,对应代码第8行,(pivotkey = 29) 小于 (L[i] = 38) 且(i < j);
执行代码第10行,(i < j)成立,将L[1](i = 1)放到L[4](j = 4)的位置上,且j--,
此时j = 3;
回到代码第4行,i < j 满足条件,进
入循环。
执行代码第5行,(pivotkey = 29) 小
于 (L[3] = 45) 且(i < j)满足条件,
对应代码第6行:j --, 此时j = 2;
回到代码第5行,(pivotkey = 29) 大
于 (L[2] = 22) 且(i < j);
执行代码第7行,(i < j)成立,将
L[j](j = 2)放到L[1](i = 1)的位置
上,且i++,此时i = 2;如图②所示。考点三: 交换类排序
⑴ 一趟快速排序算法的实现
有7个待排序的记录,关键字分别为29, 38,
1 int quick_one_pass(Sqlist *L , int low, int high){
22, 45, 23, 67,31一趟快速排序的过程如图所示,
2 int i = low, j = high ;
3 int pivotkey = L [i];
待排元素的数组是L,
4 while(i < j){ // i = j时退出扫描
⑥ 执行第8行代码,(i < j)不满足,执行第
5 while(pivotkey < L [j])&&(j>i))
6 j-- ;
9行,(i < j)不满足;回到代码第4行;如图
7 if (j>i) { L [i]=L[j] ; i++; }
③所示。
8 while(L [i]< pivotkey) && (j > i))
9 i++ ;
⑦ 执行代码第4行,(i < j)不满足,跳转到
10 if (j>i){L[j]=L[i] ; j--;}
第12行,pivotkey赋值给L[i]。
11 }
12 L[i] = pivotkey ;
⑧ 执行代码第13行,返回i(i=2)。算法结
13 return(i) ;
束。如图④所示。
14 }考点三: 交换类排序
有7个待排序的记录,关键字分别为29, 38, 22, 45, 23, 67,31一趟快速排序
的过程如图所示,待排元素的数组是L,
⑥ 执行第8行代码,(i < j)不满足,执行第9行,(i < j)不满足;回到代
码第4行;如图③所示。
⑦ 执行代码第4行,(i < j)不
满足,跳转到第12行,pivotkey赋
值给L[i]。
⑧ 执 行 代 码 第 13 行 , 返 回 i
(i=2)。算法结束。如图④所示。考点三: 交换类排序
⑵ 快速排序算法实现
当进行一趟快速排序后,采用同样方法分别对两个子序列快速排序,直
到子序列记录个为1为止。递归算法实现:
1 void quick_Sort(Sqlist *L , int low, int high) {
2 int k ;
3 if(low < high) {
4 k=quick_one_pass(L, low, high);
5 quick_Sort(L, low, k-1);
6 quick_Sort(L, k+1, high);
7 } /* 序列分为两部分后分别对每个子序列排序 */
8 }考点三: 交换类排序
在代码(2)中,待排元素的数组是L,
① 对应代码的第1行,low = 0,high = 6;
② 对应代码的第2行,定义k;
③ 对应代码的第3行,(low < high)满足;
④ 对应代码第4行,k = 2; 这是
因为代码(1)执行完成,i是2,
返回的值是2,赋值给k;
⑤ 对应代码第5行,在L[0,1]调
用代码(1);进入递归循环结构;
⑥ 对应代码第6行,在L[3,6]调
用代码(1);进入递归循环结构;考点三: 交换类排序
完整的排序过程
通过上述的讲解,我们知道每次都是选择每一段的第一个元素为基准,将比基
准元素的元素的大的元素放到基准元素右边,将比基准元素小的元素放到基准元
素左边。我们继续看上面的例子,继续我们的排序过程,
(1)29左边的元素的一趟排序过程如图所示,如①②所示,这趟排序以23为基
准,将22放到了23的左边。考点三: 交换类排序
(2)29右边的元素的一趟排序过程如图所示,以45元素为基准元素,排序
过程如图①②③④⑤所示;考点三: 交换类排序
(3)将23的左边,以22为基准元素,进行一趟排序过程如下,考点三: 交换类排序
(4)将45的左边,以31为基准元素,进行一趟排序过程如下,考点三: 交换类排序
(5)将45的右边,以67为基准元素,进行一趟排序过程如下,考点三: 交换类排序
(6)将31的右边,以38为基准元素,进行一趟排序过程如下,考点三: 交换类排序
如果,我们以每次的基准元素为根,可以构建一棵二叉树,如图所示:
定义一个非常重要的概念,快排的“趟”,根据上图的树形结构,每一层的
元素均调整完毕称为“趟”,例如第一趟需要把29排好,第二趟需要23和45排
好,第三趟需要讲22、31和67排好,第四趟需要将38排好。因此快排排序的趟
树等于所构建的二叉树的高度。考点三: 交换类排序
快排的算法分析
元素越无序,快排的性能越好;元素越有序,快排的性能越差。
元素越无序,快排的性能越好。如果我们以每次的基准元素为根,可以构建
一棵二叉树,那么排序的趟树等价于二叉树的高度,而如果元素均匀的话(二叉
树的左右子树高度接近),树高是log n,而每一趟的排序是元素和基准元素比
2
较,时间复杂度是O(n)。所以最好情况下,快速排序的时间复杂度是:
T(n)=O(nlog n)
2考点三: 交换类排序
快排的算法分析
22
元素越无序,快排的性能越好;元素越有
序,快排的性能越差。如果我们以每次的基
23
准元素为根,可以构建一棵二叉树,那么排
序的趟树等价于二叉树的高度,如果给定的
29
元素序列是22,23,29,31,38,45,67。
第一趟以22为基准,第二趟以23为基准,依
31
次类推,最后一趟以67为基准,得到的二叉
树的高度是n,每一趟的排序是元素和基准元
45
素比较,时间复杂度是O(n)。所以最坏情况
下,快速排序的时间复杂度是:T(n)=O(n2) 。
67考点三: 交换类排序
快排的算法分析
从所需要的附加空间来看,快速排序算法是递归调用,系统内用堆栈保存
递归参数,当每次划分比较均匀时,栈的最大深度为log n+1。快速排序最好的
2
空间复杂度是:S(n)=O(log n)
2
从所需要的附加空间来看,快速排序算法是递归调用,系统内用堆栈保存
递归参数,当元素有序时,栈的最大深度为n,快速排序最坏的空间复杂度是
S(n) = O(n)。【政哥题型总结】考点三: 交换类排序
1.一组记录的关键字为{46,79,56,38,40,84},利用快速排序的方法,以第一
个记录为基准划分结果为( )。
A.{38,40,46,56,79,84} B.{40,38,46,79,56,84}
C.{40,38,46,56,79,84} D.{40,38,46,84,56,79}考点三: 交换类排序
1.一组记录的关键字为{46,79,56,38,40,84},利用快速排序的方法,以第一
个记录为基准划分结果为( )。
A.{38,40,46,56,79,84} B.{40,38,46,79,56,84}
C.{40,38,46,56,79,84} D.{40,38,46,84,56,79}
C【解析】采用第一个元素作为基
准,设置i和j指针,进行一趟排序,
如图所示。考点三: 交换类排序
2.下列选项中,不可能是快速排序第二趟排序结果的是( )。
A.2,3,5,4,6,7,9 B.2,7,5,6,4,3,9
C.3,2,5,4,7,6,9 D.4,2,3,5,7,6,9考点三: 交换类排序
2.下列选项中,不可能是快速排序第二趟排序结果的是( )。
A.2,3,5,4,6,7,9 B.2,7,5,6,4,3,9
C.3,2,5,4,7,6,9 D.4,2,3,5,7,6,9
C【解析】快速排序的阶段性排序结果的特点是,在第i趟完成时,会有i个及以
上的数出现在它最终将要出现的位置,即它左边的数都比它小,它右边的数都
比它大。题目问第二趟排序的结果,即要找不存在两个这样的数的选项。A选
项中2、3、6、7、9均符合,所以A排除;
B选项中2、9均符合,所以B排除;
D选项中5、9均符合,所以D选项排除;最后看C选项,只有9符合,所以C不
可能是快速排序第二趟的结果。考点三: 交换类排序
3.在排序过程中,对尚未确定最终位置的所有元素进行一遍处理称为一
“趟”。在下列序列中,不可能是快速排序第二趟结果的是( )。
A.5,2,16,12,28,60,32,72 B.2,16,5,28,12,60,32,72
C.2,12,16,5,28,32,72,60 D.5,2,12,28,16,32,72,60考点三: 交换类排序
3.在排序过程中,对尚未确定最终位置的所有元素进行一遍处理称为一
“趟”。在下列序列中,不可能是快速排序第二趟结果的是( )。
A.5,2,16,12,28,60,32,72 B.2,16,5,28,12,60,32,72
C.2,12,16,5,28,32,72,60 D.5,2,12,28,16,32,72,60
D 【解析】要理解清楚排序过程中一“趟”的含义,题干也进行了解释。一个
初始无序序列,所有元素都没有确定最终位置,对所有元素做一次(称为趟)快
速排序后确定一个元素的最终位置,并且将原序列划分成了前后两块,此时前
后两块子表是无序的。按“趟”的解释——对尚未确定最终位置的所有元素都
处理一遍才是一趟,所以此时要对前后两块子表各做一次快速排序才是一“趟”
快速排序,如果只对一块子表进行排序,而未处理另一块子表,就不能算是完
整的一趟。考点三: 交换类排序
3.在排序过程中,对尚未确定最终位置的所有元素进行一遍处理称为一
“趟”。在下列序列中,不可能是快速排序第二趟结果的是( )。
A.5,2,16,12,28,60,32,72 B.2,16,5,28,12,60,32,72
C.2,12,16,5,28,32,72,60 D.5,2,12,28,16,32,72,60
D【解析】选项A,第一趟匹配72,只余一块无序序列,第二趟匹配28,选项
A可能。选项B,第一趟匹配2,第二趟匹配72,选项B可能。选项C,第一趟匹
配2,第二趟匹配28或32,选项C可能。选项D,无论先匹配12还是先匹配32,
都会将序列分成两块,那么第二趟必须有两个元素匹配,所以选项D不可能。
故选D。THANKSCON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点框架
简单选择排序
堆排序【简单选择排序】考点四: 选择类排序
简单选择排序的基本思想:第 i 趟(1≤i≤n-1)排序在待排序序列
r[i]~r[n] 中选取最小记录,并和第 i 个记录交换。
… … …
r r r min r
1 i-1 i n
有序区 无序区
r … r r ' r … r
1 i-1 i i+1 n考点四: 选择类排序
24
20 18
12 10
待排序序列
24
20 18
10 12
第一趟排序结果
24
20 18
第二趟排序结果 10 12
24
18 20
第三趟排序结果
10 12
24
18 20
第四趟排序结果
10 12考点四: 选择类排序
从i个元素中挑选最小元素需要比较i-1次。
第i(i=0~n-2)趟从n-i元素中挑选最小元素需要比较n-i-1次。
对n个元素进行简单选择排序,所需进行的关键字的比较次数总
计为:
移动元素的次数,正序为最小值 0,反序为最大值3(n-1) 。
简单选择排序的最好、最坏和平均时间复杂度为O(n2)。【堆排序】考点四: 选择类排序
堆 的 定 义
一个序列R[1..n],关键字分别为k、k、、k 。
1 2 n
该序列满足如下性质(简称为堆性质):
k≤k 且k≤k
i 2i i 2i+1
或 k≥k 且k≥k (1≤i≤n/2)
i 2i i 2i+1
满足第种情况的堆称为小根堆,满足第种情况的堆称为大根
堆。考点四: 选择类排序
将序列a a … a 看成是一颗完全二叉树
1 2 n
层序编号方式:
a
1
i
a a
a a … a
2 3
1 2 n
…
a 2i 2i+1
n
完全二叉树 左孩子 右孩子
大根堆:对应的完全二叉树中,任意一个结点的关键字都大于或等于它的
孩子结点的关键字。
最小关键字的元素一定是某个叶子结点!!!考点四: 选择类排序
大根堆有什么特点呢?
(1)根结点(称为堆顶)的值是所有结点的最大值;
(2)较大值的结点靠近根结点,但不绝对。
将堆按层序编号,有什么特点?
k
k
i
i
k
k
2
2
i
i + 1
( 1 i
i
2
)考点四: 选择类排序
如何判断一颗完全二叉树是否为大根堆
n=6
1
从编号为n/2=3的结点开始,逐 12
一判断所有分支结点
3
2
9 5
4 5
6
4 1 3
所有分支结点满足定义
大根堆考点四: 选择类排序
堆采用顺序存储,则对应一个(无序)序列
1 2 3 4 5 6 7 8 9 10
50 38 45 32 36 40 28 20 18 28
1
顺序存储, 50
以编号作为下标
2 3
38 45
4 5 6 7
32 36 40 28
8 9 10
20 18 28考点四: 选择类排序
堆的性质
① 堆是一棵采用顺序存储结构的完全二叉树, k1是根结点;
② 堆的根结点是关键字序列中的最小(或最大)值,分别称为小(或大)根堆;
③ 从根结点到每一叶子结点路径上的元素组成的序列都是按元素值(或关键字
值)非递减(或非递增)的;
④堆中的任一子树也是堆。考点四: 选择类排序
堆排序的基本思想:首先将待排序序列构造成一个大根堆,即选出了堆
中所有记录的最大者,将它从堆中移走,并将剩余的记录再调整成堆,
这样又找出了次小的记录,以此类推,直到堆中只有一个记录。
r … r r … r
1 i n-i+1 n
无序区,调整为大根堆 有序区
第 i 趟堆排序将r[1]~r[i]调整成大根堆,再将堆顶与r[i]交换考点四: 选择类排序
① 对一组待排序的记录,按堆的定义建立堆;
② 将堆顶记录和最后一个记录交换位置,则前n-1个记录是无序的,
而最后一个记录是有序的;
③ 堆顶记录被交换后,前n-1个记录不再是堆,需将前n-1个待排序记
录重新组织成为一个堆,然后将堆顶记录和倒数第二个记录交换位置,
即将整个序列中次小关键字值的记录调整(排除)出无序区;
④ 重复上述步骤,直到全部记录排好序为止。考点四: 选择类排序
结论:排序过程中,若采用小根堆,排序后得到的是非递增序列;若采
用大根堆,排序后得到的是非递减序列。
➢ 堆排序的关键
① 如何由一个无序序列建成一个堆?
② 如何在输出堆顶元素之后,调整剩余元素,使之成为一个新的堆?考点四: 选择类排序
① 如何由一个无序序列建成一个堆?
堆排序的关键是构造堆,这里采用筛选算法建堆。
所谓“筛选”指的是,对一棵左/右子树均为堆的完全二叉树,“调整”根结
点使整个二叉树也成为一个堆。
筛
筛选
选
堆
堆
堆考点四: 选择类排序
我们通过一个例子来讲解,假定我们给定的序列是:49,38,65,97,76,13,27,
49,28,73。(这里我们使用小根堆)。
①只要是给定一个序列,那么我们就按照完全二叉树的层次遍历进行处理。
那么只要给定一个序列,我们就按照层次遍历,构造一棵完全二叉树,如图所
示。考点四: 选择类排序
③调整顺序是从最后一个元素开始。大家如果看别的资料,会发现,从第n/2
个元素开始调整,这个怎么解释呢?我们已经知道,堆是完全二叉树,所以对完
全二叉树依次使用1,2,…,n进行编号,那么最后一个元素的编号是n,这个元素
的双亲结点的编号是n/2,(这里使用的是完全二叉树的性质)。考点四: 选择类排序
从最后一个元素开始,根据小根堆的定义进行调整,按照从下到上,从右到
左的顺序进行调整(这里讲的方法,是考研实战中的经验,按照这个规则进行
调整,不容易出现错误)所谓“从下到上”就是先调节最底层的,逐层向上调
整,如图(a)所示,先从73开始,73比76小,所以73和76交换,如图(b)
所示。考点四: 选择类排序
所谓“从右往左”就是先右子树,后调节左子树,例如38,先调节右子树,
再调节左子树,38的右子树已经调整好了;接下来要调整38的左子树。此时。
97具有左右子树,先让97的左右子树进行对比,找到较小者和97比较,如图(a)
所示,28比49小,将28和97比较,并调整。
继续调整,65的左右子树是13和27,13和65交换,得到如图(b)所示,考点四: 选择类排序
继续调整,38的左右子树是28和73,28和38交换,得到如图(a)所示
继续调整,49的左右子树是28和13,13和28交换,得到如图(b)所示;
这里大家需要注意,在图(c)中,49向下调整,可能会影响以49为根的这
科树,所以当遇到向下调整的情况,需要调整都影响的部分。考点四: 选择类排序
所以需要调整图(b)中以49为根的这棵树,让27和49交换,如图(c)所示,
调整到这里,这棵树满足小根堆的定义啦,我们就完成初始堆啦。考点四: 选择类排序
(2)如何排序?
将堆顶元素和最后一个记录交换位置,堆顶元素输入,进行排序,如图(a)
中,将13输出,并用76代替13的位置。那么13就实现了排序。如图(b)所示,考点四: 选择类排序
(3)输出堆顶元素后,如何重新调整成一个堆?
输出堆顶元素之后,以堆中最后一个元素替代之,如图(a),这棵树不满足
堆的定义了,我们需要继续调整这棵树,以使之满足堆的定义,调整方法和(1)
中调整初始堆的思路是一样的。首先调整76的左右子树,27和76交换,如图
(a)所示; 继续调整图(a)中76的左右子树,49和76交换,得到图(b)所示,
调整完毕。考点四: 选择类排序
设待排序的表有10个元素,其关键字分别为{6,8,7,9,0,1,3,2,
4,5}。说明采用堆排序方法进行排序的过程。
排序序列:6,8,7,9,0,1,3,2,4,5
看成是一棵完全二叉树
6
8 7
9 0 1 3
2 4 5考点四: 选择类排序
调整成初始大根堆: 6
8 7
9 0 1 3
2 4 5
调整完毕,成为一个大根堆
9 8 7 6 5 1 3 2 4 0考点四: 选择类排序
第1趟排序
9
8 7
6 5 1 3
2 4 0
8
0 8 7 6 5 1 3 2 4 9
6 7
输出9(归位)
4 5 1 3
2 0考点四: 选择类排序
第2趟排序 8
6 7
4 5 1 3
2 0
7
0 6 7 4 5 1 3 2 8 9
6 3
输出8(归位)
4 5 1 0
其他各趟排序依此进行
2
最终结果:
0 1 2 3 4 5 6 7 8 9考点四: 选择类排序
void sift(int []R,int low, int high){
int i=low,j=2 *i; //R]是R]的左孩子
int tmp=R[i];
while (j<=high)
if(j<high &&.R].key<R+1].key) //若右孩子较大,把j指向右孩子
j++;
if (tmp.key< R[j].key){ //若根结点小于最大孩子的关键字
R[i]=R[j]; //将R]调整到双亲结点位置上
i=j; //修改i和i值,以便继续向下筛选
j=2*i:
}
else break ; //若根结点大于等于最大孩子关键字,筛选结束
R[i]=tmp; //被筛选结点放入最终位置上
}考点四: 选择类排序
void HeapSort(int []R,int n){
int i;
for(i = n/2 ;i >= 1; i--) //循环建立初始堆,调用sift算法⌊n/2⌋次
sift(R,i,n);
for( i = n; i >= 2; i--){ //进行 n-1趟完成推排序,每一趟堆中元素个数减1
swap(R[1], R[i); //将最后一个元素与根 R[1]交换
sift(R, 1, i-1); //对 R[1..i-1]进行筛选,得到i-1个结点的堆
}考点四: 选择类排序
对高度为h的堆,一次“筛选”所需进行的关键字比较的次数至多为
2(h-1)。
对n个关键字,建成高度为h(=log n+1)的堆,所需进行的关键
2
字比较的次数不超过4n。
调整“堆顶” n-1 次,总共进行的关键字比较的次数不超过:
2 (log (n-1)+ log (n-2)+ … +log 2) < 2n(log n)
2 2 2 2
因此,堆排序的时间复杂度为O(nlogn)。
空间复杂度为O(1),不稳定。【政哥题型总结】考点四: 选择类排序
1.判断下列序列是否是堆。
(1)100,85,98,77,80,60,82,40,20,10,66。
(2)100,98,85,82,80,77,66,60,40,20,10。
(3)100,85,40,77,80,60,66,98,82,10,20。
(4)10,20,40,60,66,77,80,82,85,98,100。考点四: 选择类排序
1.判断下列序列是否是堆。
(1)100,85,98,77,80,60,82,40,20,10,66。
(2)100,98,85,82,80,77,66,60,40,20,10。
(3)100,85,40,77,80,60,66,98,82,10,20。
(4)10,20,40,60,66,77,80,82,85,98,100。
在考研中,给定的序列都是堆的层次遍历,直接进行构造。考点四: 选择类排序
1.判断下列序列是否是堆。
(1)100,85,98,77,80,60,82,40,20,10,66。
(2)100,98,85,82,80,77,66,60,40,20,10。
(3)100,85,40,77,80,60,66,98,82,10,20。
(4)10,20,40,60,66,77,80,82,85,98,100。
在考研中,给定的序列都是堆的层次遍历,直接进行构造。考点四: 选择类排序
2.如果只想得到1000个元素组成的序列中第5个最小元素之前的部分排序的
序列,用( )方法最快。
A.冒泡排序 B.快速排列 C.Shell排序 D.堆排序考点四: 选择类排序
2.如果只想得到1000个元素组成的序列中第5个最小元素之前的部分排序的
序列,用( )方法最快。
A.冒泡排序 B.快速排列 C.Shell排序 D.堆排序
D【解析】此题是堆排序的典型应用,从n个元素取前k个,此时时间复杂度是
O(klogn)。THANKSCON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点框架
二路归并排序的基本思想
二路归并排序的运行实例
一次合并算法
一趟合并算法
二路归并的性能分析【基本思想】考点五: 归并排序
⚫ 归并排序
是多次将相邻两个或两个以上的有序表合并成一个新有序表的排序方法。
⚫ 二路归并排序
是多次将相邻两个的有序表合并成一个新有序表的排序方法,是最
简单的归并排序。考点五: 归并排序
二路归并排序的基本思想:将待排序序列划分为两个长度相等的子
序列,分别对这两个子序列进行排序,得到两个有序子序列,再将
这两个有序子序列合并成一个有序序列。
划分
r … r r … r
1 n/2 n/2+1 n
r ' ≤ … ≤ r ' r ' ≤ … ≤ r '
1 n/2 n/2+1 n
r '' ≤ … ≤ r '' ≤ r '' ≤ … ≤ r ''
1 n/2 n/2+1 n【运行实例】考点五: 归并排序
待排序序列 25 20 40 15 30 10 18
25 20 40 15 30 10 18
构造初始有序子序列
20 25 15 40 10 30 18
第一趟归并结果
15 20 25 40 10 18 30
第二趟归并结果
第三归并结果 10 15 18 20 25 30 40【一次合并算法】考点五: 归并排序
一次合并:合并两个相邻的有序子序列的过程。
s m m+1 t
r[ ]考点五: 归并排序
一次合并:合并两个相邻的有序子序列的过程。
s m m+1 t
r[ ]
20 25 40 50 15 21 30
i j
r1[ ] 15
k考点五: 归并排序
一次合并:合并两个相邻的有序子序列的过程。
s m m+1 t
r[ ]
20 25 40 50 15 21 30
j
i
r1[ ] 15 20 21 30 40 50
k【一趟合并算法】考点五: 归并排序
待排序序列 25 20 40 15 30 10 18
25 20 40 15 30 10 18
构造初始有序子序列
20 25 15 40 10 30 18
第一趟归并结果
15 20 25 40 10 18 30
第二趟归并结果
第三归并结果 10 15 18 20 25 30 40考点五: 归并排序
设待排序的表有10个元素,其关键字分别为(6,8,7,9,0,1,3,2,
4,5)。说明采用二路归并排序方法进行排序的过程。
初始:
6 8 7 9 0 1 3 2 4 5
6 8 7 9 0 1 2 3 4 5
第1趟
第2趟 6 7 8 9 0 1 2 3 4 5
第3趟 0 1 2 3 6 7 8 9 4 5
第4趟 0 1 2 3 4 5 6 7 8 9
需要log 10取上界即4趟
2考点五: 归并排序
6 8 7 9 0 1 3 2 4 5
6 8 7 9 0 1 2 3 4 5
6 7 8 9 0 1 2 3
0 1 2 3 6 7 8 9
0 1 2 3 4 5 6 7 8 9
一颗归并树【性能分析】考点五: 归并排序
执行趟数:log n
2
每一趟:将记录扫描一遍,O(n)
最好、最坏、平均情况:O(nlog n)
2
第一趟归并结果 20 25 15 40 10 30 18
第二趟归并结果 15 20 25 40 10 18 30考点五: 归并排序
每一次二路归并后临时空间都会释放。而最后的一次二路归需要全部
元素参加归并:
0 1 2 3 6 7 8 9 4 5
0 1 2 3 4 5 6 7 8 9
占用临时空间为全部元素个数n
所以空间复杂度为Ο(n)。【政哥题型总结】考点五: 归并排序
1.将[22 23 38 45和[15 23 31 67]合并成一个归并段。考点五: 归并排序
1.将[22 23 38 45和[15 23 31 67]合并成一个归并段。
【解析】将两个有序的数据段,归并成一个有序的归并段,其实是两个有序表的合并,
设置两个指针,如图所示,设置p和q指针。考点五: 归并排序
2.设有6个有序表A、B、C、D、E、F,分别含有10、35、40、50、60和200个
数据元素,各表中元素按升序排列。要求通过5次两两合并,将6个表最终合并成1
个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
(1)给出完整的合并过程,并求出最坏情况下比较的总次数。考点五: 归并排序
2.设有6个有序表A、B、C、D、E、F,分别含有10、35、40、50、60和200个
数据元素,各表中元素按升序排列。要求通过5次两两合并,将6个表最终合并成1
个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
(1)给出完整的合并过程,并求出最坏情况下比较的总次数。考点五: 归并排序
2.设有6个有序表A、B、C、D、E、F,分别含有10、35、40、50、60和200个
数据元素,各表中元素按升序排列。要求通过5次两两合并,将6个表最终合并成1
个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
(1)给出完整的合并过程,并求出最坏情况下比较的总次数。考点五: 归并排序
2.设有6个有序表A、B、C、D、E、F,分别含有10、35、40、50、60和200个
数据元素,各表中元素按升序排列。要求通过5次两两合并,将6个表最终合并成1
个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
(1)给出完整的合并过程,并求出最坏情况下比较的总次数。
(1)对于长度分别为m、n的两个有序表的合并过程,
最坏情况下需要一直比较到两个表尾元素,比较次
数为m+n-1次。已知,需要5次两两合并,故可设
总比较次数为X-5,X就是以n个叶子结点表示升序
表,以升序表的表长表示结点权重,构造的二叉树
的带权路径长度。因此,只需设计方案使得X最小。
这样受哈夫曼树和最佳归并树思想的启发,设计哈
夫曼树如图所示。
这样,最坏情况下比较的总次数为N=(10+35)×4+(40+50+60)×3+200-5=825考点五: 归并排序
2.设有6个有序表A、B、C、D、E、F,分别含有10、35、40、50、60和200
个数据元素,各表中元素按升序排列。要求通过5次两两合并,将6个表最终合
并成1个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
(2)根据你的合并过程,描述n(n≥2)个不等长升序表的合并策略,并说明理由。考点五: 归并排序
2.设有6个有序表A、B、C、D、E、F,分别含有10、35、40、50、60和200
个数据元素,各表中元素按升序排列。要求通过5次两两合并,将6个表最终合
并成1个升序表,并在最坏情况下比较的总次数达到最小。请回答下列问题。
(2)根据你的合并过程,描述n(n≥2)个不等长升序表的合并策略,并说明理由。
(2)n(n≥2)个不等长升序表的合并策略:以n个叶子结点表示升序表,以升序表的
表长表示结点权重,构造哈夫曼树。在合并时,从深度最大的结点所代表的升序
表开始合并,依深度次序一直进行到根结点。理由:n个有序表合并需要进行n-1
次两两合并,可设最坏情况下的比较总次数为X-n+1,X就是以n个叶子结点表
示升序表,以升序表的表长表示结点权重,构造的二叉树的带权路径长度。根据
哈夫曼树的特点,上述设计的比较次数是最小的。THANKSCON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点六: 基数排序
1、基数排序概述
基数排序(Radix Sorting) 又称为桶排序或数字排序:按待排序记录
的关键字的组成成分(或“位”)进行排序。
基数排序和前面的各种内部排序方法完全不同,不需要进行关键字的
比较和记录的移动。借助于多关键字排序思想实现单逻辑关键字的排序。考点六: 基数排序
基数r:对于二进制数r为2,对于十进制数r为10。
2 3 9
r=10
百位 十位 个位
一般地
元素R[j]的关键字R[j].key kd-1 kd-2 … k1 k0
j j j j
d位数字或字符组成
最 每一位的值都在0~r-1范围内, 最
高 其中r称为基数 低
位 位考点六: 基数排序
2、多关键字排序思想
先按第一个关键字K1进行排序,将记录序列分成若干个子序列,每
个子序列有相同的K1值;然后分别对每个子序列按第二个关键字K2进
行排序,每个子序列又被分成若干个更小的子序列;如此重复,直到
按最后一个关键字Kd进行排序。
最后,将所有的子序列依次联接成一个有序的记录序列,该方法
称为最高位优先(Most Significant Digit first)。
另一种方法正好相反,排序的顺序是从最低位开始,称为最低位
优先(Least Significant Digit first)。考点六: 基数排序
最低位优先排序过程如下:
对i = 0,1,…,d-1,依次做一次“分配”和“收集”(使用r个队列Q ,
0
Q ,…,Q 。 ) 。
1 r-1
◆ 分配:开始时,把Q ,Q ,…,Q 各个队列置成空队列,然后依次
0 1 r-1
考察线性表中的每一个结点a(j=0,1,…,n-1),如果a的关键字
j j
ki=k,就把a放进Q 队列中。
j j k
◆ 收集:按Q ,Q ,…,Q 顺序把各个队列中的结点首尾相接,得到
0 1 r-1
新的结点序列,从而组成新的线性表。
由于数据需要放入队列,又要从队列取出来,需要大量元素移动。所以排
序数据和队列均采用链表存储更好。考点六: 基数排序
3、排序示例
设有关键字序列为1039, 2121, 3355, 4382, 66, 118的一组记录,
采用链式基数排序的过程如下图所示。
初始链表
head 1039 2121 3355 4382 0066 0118 ∧
分配:
f[0] f[1] f[2] f[3] f[4] f[5] f[6] f[7] f[8] f[9]
2121 4382 3355 0066 0118 1039
e[0] e[1] e[2] e[3] e[4] e[5] e[6] e[7] e[8] e[9]
第一趟收集结果:
head 2121 4382 3355 0066 0118 1039 ∧考点六: 基数排序
head 2121 4382 3355 0066 0118 1039 ∧
分配:
f[0] f[1] f[2] f[3] f[4] f[5] f[6] f[7] f[8] f[9]
0118 2121 1039 3355 0066 4382
e[0] e[1] e[2] e[3] e[4] e[5] e[6] e[7] e[8] e[9]
第二趟收集结果:
head 0118 2121 1039 3355 0066 4382 ∧考点六: 基数排序
head 0118 2121 1039 3355 0066 4382 ∧
分配:
f[0] f[1] f[2] f[3] f[4] f[5] f[6] f[7] f[8] f[9]
1039 0118 3355
0066 2121 4382
e[0] e[1] e[2] e[3] e[4] e[5] e[6] e[7] e[8] e[9]
第三趟收集结果:
head 1039 0066 0118 2121 3355 4382∧考点六: 基数排序
第三趟收集结果:
head 1039 0066 0118 2121 3355 4382∧
分配:
f[0] f[1] f[2] f[3] f[4] f[5] f[6] f[7] f[8] f[9]
0066
1039 2121 3355 4382
0118
e[0] e[1] e[2] e[3] e[4] e[5] e[6] e[7] e[8] e[9]
第四趟收集结果:
head 0066 0118 1039 2121 3355 4382∧考点六: 基数排序
基数排序是通过“分配”和“收集”过程来实现排序,不需要关键字的
比较。
已知的信息:基数,每个位的取值,这些值的大小!
◆ 适合字符串排序
◆ 适合多关键字排序:如有数学、语文成绩,排序方式:按数学
成绩递减排序,数学成绩相同按语文成绩递减排序。考点六: 基数排序
4、算法分析
设有n个待排序记录,关键字位数为d,每位有r种取值。则排序的
趟数是d;在每一趟中:
◆ 链表初始化的时间复杂度:O(r) ;
◆ 分配的时间复杂度:O(n) ;
◆ 分配后收集的时间复杂度:O(r) ;
则链式基数排序的时间复杂度为: O(d(n+r))
在排序过程中使用的辅助空间是:2r个链表指针, n个指针域空间,
则空间复杂度为:O(r)THANKSCON T EN T S
目录
考点一 排序的概念和性能分析
考点二 插入类排序 ★★★
考点三 交换类排序 ★★★★
考点四 选择类排序 ★★★★★
考点五 归并排序 ★★★
考点六 基数排序 ★★★★★
考点七 各种排序的比较分析 ★★★★★考点七: 各种排序的比较分析
1、主要内部排序方法的性能
方法 平均时间 最坏所需时间 附加空间 稳定性
直接插入 O(n2) O(n2) O(1) 稳定的
Shell排序 O(n1.3) O(1) 不稳定的
直接选择 O(n2) O(n2) O(1) 不稳定的
堆排序 O(n㏒ n) O(n㏒ n) O(1) 不稳定的
2 2
冒泡排序 O(n2) O(n2) O(1) 稳定的
快速排序 O(n㏒ n) O(n2) O(㏒ n) 不稳定的
2 2
归并排序 O(n㏒ n) O(n㏒ n) O(n) 稳定的
2 2
基数排序 O(d(n+r)) O(d(n+r)) O(n+r) 稳定的考点七: 各种排序的比较分析
①按算法平均时间复杂度分类
⚫ 平方阶O(n2):即简单排序方法,例如直接插入、简单选择和冒泡排序。
⚫ 线性对数阶O(nlog n):例如快速、堆和归并排序。
2
⚫ 线性阶O(n):例如基数排序(假设r、d为常量)。考点七: 各种排序的比较分析
②按算法空间复杂度分类
⚫ O(n):归并排序,基数排序为O(r)。
⚫ O(log n):快速排序。
2
⚫ O(1) :其他排序方法。考点七: 各种排序的比较分析
③按算法稳定性分类
⚫ 不稳定的:希尔排序、快速排序、堆排序、简单选择排序。
⚫ 稳定的:其他排序方法。考点七: 各种排序的比较分析
2、排序算法中的特殊情形总结
(1)每一趟排序无法确定元素最终位置的是:插入类排序,归并类排序,基数
类排序;每一趟排序均确定一个元素最终位置的是:交换类,选择类;
(2)一般需要采用顺序结构存储的算法是:归并排序,堆排序,快速排序,折
半插入排序;其他算法可以采用顺序结构和链式结构。
(3)算法的时间复杂度和元素的初始状态无关的是:基数排序,简单选择排序,
归并排序
(4)算法的比较次数和和元素的初始状态无关的是:基数排序和简单选择排序,
折半插入排序
(5)排序趟数和元素的初始状态有关的是:快速排序,冒泡排序,
无关的是:直接插入排序,折半插入排序,简单选择排序,堆排序,归并排序;
基数排序,希尔排序,考点七: 各种排序的比较分析
2、排序算法中的特殊情形总结
(6)元素基本有序时,直接插入排序最快O(n),此时快速排序的时间复杂度是
O(n2)。
(7)从n个元素中,取前k个(n >>k),此时可以用冒泡排序,简单选择排序和
堆排序,其中堆排序的性能最好。
n∗(𝑛−1)
(8)简单选择排序的比较次数是 次,基数排序不依赖于比较
2THANKS第九讲:数组和字符串
主讲人:刘财政
B站:@计算机考研刘财政考纲要求CON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★CON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考点一: 数组定义
从逻辑结构上看,一维数组A是n(n>1)个相同类型数据元素a a、…、a
1、 2 n
构成的有限序列,其逻辑表示为:
A=(a,a,…,a)
1 2 n
其中,a(1≤i≤n)表示数组A的第i个元素。
i考点一: 数组定义
一个m行n列的二维数组A可以看作是每个数据元素都是相同类型的一维
数组的一维数组。
a a a
1,1 1,2 1,n A=[ A,A,,A ]
1 2 m
a a a
A = 2,1 2,2 2,n
A=[ a ,a ,,a ]
1 1,1 1,2 1,n
a a a
m,1 m,2 m,n
A=[ a ,a ,,a ]
2 1,1 2,2 2,n
➢ 由此看出,多维数组是线性表的推广。 A =[ a ,a ,,a ]
m m,1 m,2 m,n考点一: 数组定义
数组有什么特点呢?
(1)元素本身可以具有某种结构,属于同一数据类型;
A=(A ,A ,…,A )
1 2 n
其中:
a a … a
11 12 1n
A =(a ,a ,…,a ) (1≤j≤n)
j 1j 2i mj
a a … a
21 22 2n
A=
… … … …
a a … a
m1 m2 mn A=(A ,A ,…,A )
1 2 m
其中:
A =(a ,a ,…,a ) (1≤i≤m)
i i1 i2 in考点一: 数组定义
数组有什么特点呢?
(1)元素本身可以具有某种结构,属于同一数据类型;
(2)数组是一个具有固定格式和数量的数据集合。
x
a a … a
11 12 1n
a a … a
21 22 2n
A=
… … … …
a a … a
m1 m2 mn
在数组上一般不能执行插入或删除某个数组元素的操作THANKSCON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考点二: 数组的地址计算
数组特别适合采用顺序存储结构 将数组所有元素存储在一块地址
连续的内存单元中。
➢ 数组不能采用链式存储结构吗?
➢ 为什么数组一般采用顺序存储结构?
数组没有插入和删除操作,所以,不用预留空间,适合采用顺序存储
二维数组 内 存
二维结构 一维结构考点二: 数组的地址计算
一维数组的存储
一维数组(a ,a ,…,a ),按元素顺序存储到一块地址连续的内存单元中。
1 2 n
假设第一个元素a 的存储地址用LOC(a )表示,每个元素占用k个存储单元,则任
1 1
一数组元素a 的存储地址LOC(a )即可由以下公式求出:
i k
LOC(a )= LOC(a )+(i-1) * k (2<i≤n)
i 1考点二: 数组的地址计算
二维数组的存储
按行优先:先存储行号较小的元素,行号相同者先存储列号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“行优先顺序”存储时
①第1行中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+(j-1)L j=1,2, …,n
1j 11考点二: 数组的地址计算
二维数组的存储
按行优先:先存储行号较小的元素,行号相同者先存储列号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“行优先顺序”存储时
②第2行中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+nL+(j-1)L j=1,2, …,n
2j 11考点二: 数组的地址计算
二维数组的存储
按行优先:先存储行号较小的元素,行号相同者先存储列号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“行优先顺序”存储时
③第m行中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+(m-1)nL+(j-1)L j=1,2, …,n
mj 11考点二: 数组的地址计算
二维数组的存储
按列优先:先存储列号较小的元素,列号相同者先存储行号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“列优先顺序”存储时
①第1列中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+(j-1)L j=1,2, …,m
j1 11考点二: 数组的地址计算
二维数组的存储
按列优先:先存储列号较小的元素,列号相同者先存储行号较小的元素
l h
2 2
l
设有二维数组A=(a ) ,若每个元素占
1 ij mn
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“列优先顺序”存储时
②第2列中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+mL+(j-1)L j=1,2, …,m
j2 11考点二: 数组的地址计算
二维数组的存储
按列优先:先存储列号较小的元素,列号相同者先存储行号较小的元素
l h
2 2
l 设有二维数组A=(a ) ,若每个元素占
ij mn
1
用的存储单元数为L(个),LOC[a ]表示
11
元素a 的首地址,即数组的首地址。
a 11
ij
h
1
以“列优先顺序”存储时
③第n列中的每个元素对应的(首)地址是:
LOC[a ]=LOC[a ]+ (n-1)mL+(j-1)L j=1,2, …,m
jn 11THANKSCON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考点三: 特殊矩阵的压缩存储
什么是特殊矩阵?
特殊矩阵:矩阵中很多值相同的元素并且它们的分布有一定的规律
特殊矩阵如何压缩存储?
为值相同的元素分配一个存储空间
特殊矩阵压缩存储后有什么要求吗?
保证随机存取,即在O(1)时间内寻址考点三: 特殊矩阵的压缩存储
对称矩阵
3 6 4 7 8
6 2 8 4 2
A=
4 8 1 6 9 对称矩阵特点:a =a
ij ji
7 4 6 0 5
8 2 9 5 7
如何压缩存储对称矩阵呢? 只存储下三角部分的元素考点三: 特殊矩阵的压缩存储
1 … j … n
1
a 在一维数组中的序号
ij
= i×(i-1)/2+ j
…
∵一维数组下标从 0 开始
∴a 在一维数组中的下标
ij
k = i×(i-1)/2+ j-1
i a
ij
n
0 1 2 3 4 5 k n(n+1)/2-1
a a a a a a … a … a a … a
11 21 22 31 32 33 ij n1 n2 nn
第1行 第2行 第3行 第n行考点三: 特殊矩阵的压缩存储
对称矩阵压缩存储后的寻址方法
对于下三角中的元素a(i≥ j):k=i×(i-1)/2+j -1
ij
对于上三角中的元素a(i<j),因为a=a,则 k=j×(j-1)/2+i-1
ij ij ji
0 1 2 3 4 5 k n(n+1)/2-1
a a a a a a … a … a a … a
11 21 22 31 32 33 ij n1 n2 nn
第1行 第2行 第3行 第n行考点三: 特殊矩阵的压缩存储
三角矩阵
3 4 8 1 0
3 c c c c
c 2 9 4 6
6 2 c c c
c c 1 5 7
4 8 1 c c
c c c 0 8
7 4 6 0 c
c c c c 7
8 2 9 5 7
(a) 下三角矩阵 (b) 上三角矩阵
下(上)三角部分的元素
如何压缩存储三角矩阵呢?
相同的常数只存储一个考点三: 特殊矩阵的压缩存储
下三角矩阵的压缩存储
0 1 2 3 4 5 k n(n+1)/2
a a a a a a … a … a a … a c
11 21 22 31 32 33 ij n1 n2 nn
第1行 第2行 第3行 第n行
3 c c c c
下三角矩阵压缩存储后的寻址方法
6 2 c c c
对于下三角中的元素a (i ≥ j):k=i×(i - 1)/2 + j -1 4 8 1 c c
ij
7 4 6 0 c
对于上三角中的元素a (i<j):k=n×(n + 1)/2
ij
8 2 9 5 7
(a) 下三角矩阵考点三: 特殊矩阵的压缩存储
3 4 8 1 0
c 2 9 4 6
c c 1 5 7
(b) 上三角矩阵
c c c 0 8
c c c c 7
在数组a中,位于元素a (i<=j)前面的元素个数为
i,j
①第1行:n个元素(a ,a ,……,a )
1,1 1,2 1,n
②第2行:n-1个元素(a ,……,a )
2,2 2,n
③……
④第i-1行:n-i+2个元素(a ,……,a ),前面i-1行满足i<=j的元
i-1,i-1 i-1,n
素都要存储在B中考点三: 特殊矩阵的压缩存储
3 4 8 1 0
c 2 9 4 6
c c 1 5 7
(b) 上三角矩阵
c c c 0 8
c c c c 7
在数组a中,位于元素a (i<=j)前面的元素个数为
i,j
⑤第i行:j-1个元素(a ,……,a )
i,i i,j-1
因此,元素a (i<=j)在数组B中的下标
i,j
k = [n+(n-1)+……+(n-i+2)]+(j-i) = (i-1)(2n-i+2)/2+(j-i)。考点三: 特殊矩阵的压缩存储
3 4 8 1 0
c 2 9 4 6
c c 1 5 7
(b) 上三角矩阵
c c c 0 8
c c c c 7
下三角矩阵元素a 保存在向量sa中时的下标值k与(i,j)之间的对应关系是:
i j考点三: 特殊矩阵的压缩存储
对角矩阵
对角矩阵:所有非零元素都集中在以主对角线为中心的带状区域
中,所有其他元素都为零
a a 0 0 0 如何压缩存储对角矩阵呢?
11 12
a a a 0 0
21 22 23
A =
只存储非零元素
0 a a a 0
32 33 34
0 0 a a a
43 44 45
0 0 0 a a
54 55考点三: 特殊矩阵的压缩存储
a a 0 0 0
元素 a 在一维数组中的序号
11 12 ij
=2 + 3(i-2)+( j-i + 2)
a a a 0 0
21 22 23 =2i + j-2
A =
0 a a a 0 ∵一维数组下标从 0 开始
32 33 34
∴元素 a 在一维数组中的下标
ij
0 0 a a a
= 2i + j-3
43 44 45
0 0 0 a a
54 55
0 1 2 3 4 5 6 7 8 9 10 11 12
a a a a a a a a a a a a
11 12 21 22 23 32 33 34 43 44 45 54
a
55
第1行 第2行 第3行考点三: 特殊矩阵的压缩存储
3 0 0 7
稀疏矩阵
0 0 1 0
什么是稀疏矩阵?
A = 2 0 0 0
0 0 0 0
稀疏矩阵:矩阵中有很多零元素
0 0 0 8
稀疏矩阵如何压缩存储?
只存储非零元素,零元素不分配存储空间
如何只存储非零元素?
三元组:(行号,列号,非零元素值)考点三: 特殊矩阵的压缩存储
三元组表:将稀疏矩阵的非零元素对应的三元组所构成的集合,
按行优先的顺序排列成一个线性表
如何存储三元组表?
typedef int DataType; ((1, 1, 3), (1, 4, 7), (2, 3, 1), (3, 1, 2), (5, 4, 8))
typedef struct
{
int row, col;
3 0 0 7
DataType item;
} Element; 0 0 1 0
A = 2 0 0 0
0 0 0 0
三元组:(行号,列号,非零元素值)
0 0 0 8考点三: 特殊矩阵的压缩存储
三元组顺序表需要预留存储单元吗?
((1, 1, 3), (1, 4, 7), (2, 3, 1), (3, 1, 2), (5, 4, 8))
3 0 0 7
稀疏矩阵的修改操作
0 0 1 0
A = 2 0 0 0
0 0 0 0
三元组表的插入/删除操作
0 0 0 8考点三: 特殊矩阵的压缩存储
row col item
1 1 3
0 是否对应惟一的稀疏矩阵?
1 4 7
1
2 3 1
2 3 0 0 7
3 1 2
3
0 0 1 0
5 4 8
4
A = 2 0 0 0
空 空 空
0 0 0 0
0 0 0 8
闲 闲 闲
MaxTerm-1
5(非零元个数)
5(矩阵的行数)
6(矩阵的列数)考点三: 特殊矩阵的压缩存储
三元组顺序表不适合什么情况?
稀疏矩阵的加法、乘法等操作,非零元素的个数及位置都会发生变化,
则在三元组顺序表中就要进行插入和删除操作,顺序存储就十分不便
row col item typedef struct OrthNode
{
down right
Element data;
struct OrthNode *right, *down;
} OrthNode;考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(1)对于稀疏矩阵中每个非零元素创建一个结点存放它,包含元素的行号、列号和
元素值。这里有4个非零元素,创建4个数据结点。考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(2)将同一行的所有结点构成一个带头结点的循环单链表,行号为i的单链表的头
结点为hr[i]。这里有3行,对应有3个循环单链表,头结点分别为 hr[0]~hr[2]。
hr[i](0<i<2)头结点的行指针指向行号为i的单链表的首结点。考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(3)将同一列的所有结点构成一个带头结点的循环单链表,列号为i的单链表的头
结点为hd门。这里有4列,对应有4个循环单链表,头结点分别为 hd[0]~hd[3]。
hd[j](0<j<3)头结点的列指针指向列号为j的单链表的首结点。考点三: 特殊矩阵的压缩存储
十字链表(orthogonal list)
十字链表(orthogonal list)是稀疏矩阵的一种链式存储结构。
创建稀疏矩阵B的十字链表的步骤如下:
(4)再将所有头结点h[i](0<i<3)连起来构成一个带头结点的循环单链表,这样需
要增加一个总头结点hm,总头结点中存放稀疏矩阵的行数和列数等信息。考点三: 特殊矩阵的压缩存储THANKSCON T EN T S
目录
考点一 数组定义
考点二 数组的地址计算 ★★★
考点三 特殊矩阵的压缩存储 ★★★★
考点四 字符串和字符串匹配 ★★★★考纲框架
字符串的基本概念
字符串的顺序存储结构
字符串的链式存储结构
字符串匹配【字符串的基本概念】考点四: 字符串和字符串匹配
串(或字符串)是由零个或多个字符组成的有限序列。
串 线性表
⚫ 串中所含字符的个数称为该串的长度(或串长)。
⚫ 含零个字符的串称为空串,用Ф表示。考点四: 字符串和字符串匹配
串的逻辑表示:
“a a … a ”
1 2 n
双引号不是串的内容,起标识作用
串的逻辑表示, a(1≤i≤n)代表一个字符。
i考点四: 字符串和字符串匹配
串相等:两个串的长度相等并且各个对应位置上的字符都相同时。
如:
“abcd” ≠ “abc”
“abcd” ≠ “abcde”
所有空串是相等的。考点四: 字符串和字符串匹配
子串:
一个串中任意个连续字符组成的子序列(含空串)称为该串的子串。
例如, “abcde”的子串有:“”、“a”、“ab” 、“abc”、
“abcd”和“abcde”等
真子串是指不包含自身的所有子串。考点四: 字符串和字符串匹配
串抽象数据类型=逻辑结构+基本运算(运算描述)
串的基本运算如下:
StrAssign(&s,cstr):将字符串常量cstr赋给串s,即生成其值等于
cstr的串s。
StrCopy(&s,t):串复制。将串t赋给串s。
StrEqual(s,t):判串相等。若两个串s与t相等则返回真;否则返回
假。
StrLength(s):求串长。返回串s中字符个数。
Concat(s,t):串连接:返回由两个串s和t连接在一起形成的新串。
SubStr(s,i,j):求子串。返回串s中从第i(1≤i≤n)个字符开始的、
由连续j个字符组成的子串。考点四: 字符串和字符串匹配
InsStr(s1,i,s2):插入。将串s2插入到串s1的第i(1≤i≤n+1)个
字符中,即将s2的第一个字符作为s1的第i个字符,并返回产生的新
串。
DelStr(s,i,j):删除。从串s中删去从第i(1≤i≤n)个字符开始的
长度为j的子串,并返回产生的新串。
RepStr(s,i,j,t):替换。在串s中,将第i(1≤i≤n)个字符开始
的j个字符构成的子串用串t替换,并返回产生的新串。
DispStr(s):串输出。输出串s的所有元素值。【字符串的顺序存储结构】考点四: 字符串和字符串匹配
串中元素逻辑关系与线性表的相同,串可以采用与线性表相同的存储结构。
逻辑结构
线性表
顺序表 链 表
顺序串 链串 存储结构考点四: 字符串和字符串匹配
顺序串中的字符被依次存放在一组连续的存储单元里。
#define MaxSize 100
typedef struct
{ char data[MaxSize];
用来存储字符串
int length;
} SqString;
用来存储字符串长度考点四: 字符串和字符串匹配
1、生成串StrAssign(&s,cstr)
将一个C/C++字符串常量cstr(以'\0'字符标识结尾)赋给顺序串s,即生成
一个其值等于cstr的串s。
void StrAssign(SqString &s, char cstr[]) //s为引用型参数
{
int i;
for (i=0;cstr[i]!='\0';i++)
s.data[i]=cstr[i];
s.length=i; //设置串s的长度
}考点四: 字符串和字符串匹配
2、 串比较运算Strcmp(s,t)
1)比较s和t两个串共同长度范围内的对应字符:
① 若s的字符>t的字符,返回1;
② 若s的字符<t的字符,返回-1;
③ 若s的字符=t的字符,按上述规则继续比较。
2)当1)中对应字符均相同时,比较s和t的长度:
① 两者相等时,返回0;
② s的长度>t的长度,返回1;
③ s的长度<t的长度,返回-1。考点四: 字符串和字符串匹配
int Strcmp(SqString s,SqString t)
{
int i,comlen;
if (s.length<t.length)
comlen=s.length; //求s和t的共同长度
else
comlen=t.length;
for (i=0;i<comlen;i++) //在共同长度内逐个字符比较
if (s.data[i]>t.data[i])
return 1;
else if (s.data[i]<t.data[i])
return -1;
if (s.length==t.length) //s==t
return 0;
else if (s.length>t.length) //s>t
return 1;
else return -1; //s<t
}考点四: 字符串和字符串匹配
3、串连接Concat(s,t)
"abcd"
Concat "abcd123"
返回由两个顺序串s和t连接在一起形成的结果串。
"123"
SqString Concat(SqString s,SqString t)
{ SqString str; //定义结果串
int i;
str.length=s.length+t.length;
for (i=0;i<s.length;i++) //将s.data[0..s.length-1]复制到str
str.data[i]=s.data[i];
for (i=0;i<t.length;i++) //将t.data[0..t.length-1]复制到str
str.data[s.length+i]=t.data[i];
return str;
}考点四: 字符串和字符串匹配
4、求子串操作
返回pos到len之间的字符子串。
int SubString (SqString s, int pos, int len, SqString &sub){
int k, j ;
if (pos<1||pos>s.length||len<0||len>(s.length-pos+1))
return 0 ; /* 参数非法 */
sub->length=len-pos+1 ; /* 求得子串长度 */
for (j=0, k=pos ; k<=leng ; k++, j++)
sub->str[j]=s.str[i] ; /* 逐个字符复制求得子串 */
return 1 ;
}考点四: 字符串和字符串匹配
5、串的复制 StrCopy(&s,t)
将顺序串复制给顺序串s。
void StrCopy(SqString &s, SqString t){ //s为引用型参数
int i;
for(i=0;i<t.length;i++) //复制t的所有字符
s. data[i]=t.data[i];
s.length=t.length; //设置串s的长度
}【字符串的链式存储结构】考点四: 字符串和字符串匹配
⚫ 链串的组织形式与一般的链表类似。
⚫ 链串中的一个结点可以存储多个字符。通常将链串中每个结点所存
储的字符个数称为结点大小。考点四: 字符串和字符串匹配
s
…
ABCD EFGH MN## ∧
结点大小为4的链串
s
…
A B N ∧
结点大小为1的链串考点四: 字符串和字符串匹配
链串结点大小1时,链串的结点类型声明如下:
typedef struct snode
{ char data;
struct snode *next;
} LinkStrNode;
s
…
A B N ∧考点四: 字符串和字符串匹配
1、生成串StrAssign(&s,cstr)
将一个C/C++字符串常量cstr(以'\0'字符标识结尾)赋给链串s,即生成一个
其值等于cstr的链串s。
void StrAssign(LinkStrNode *&s,char cstr[])
{
int i;
LinkStrNode *r,*p;
s=(LinkStrNode *)malloc(sizeof(LinkStrNode));
r=s; //r始终指向尾结点
for (i=0;cstr[i]!='\0';i++)
{
p=(LinkStrNode *)malloc(sizeof(LinkStrNode));
p->data=cstr[i];
r->next=p; r=p;
}
r->next=NULL; //尾结点next域置为空
}考点四: 字符串和字符串匹配
2、串连接Concat(s,t)
求由两个链串s和t的数据结点连接在一起形成结果串。
LinkStrNode *Concat(LinkStrNode *s,LinkStrNode *t)
{ LinkStrNode *str,*p=s->next,*q,*r;
str=(LinkStrNode *)malloc(sizeof(LinkStrNode));
r=str; //r指向结果串的尾结点
while (p!=NULL) //用p扫描s的所有数据结点
{ q=(LinkStrNode *)malloc(sizeof(LinkStrNode));
q->data=p->data; //将p结点复制到q结点中
r->next=q;r=q; //将q结点链接到str的末尾
p=p->next;
}考点四: 字符串和字符串匹配
2、串连接Concat(s,t)
求由两个链串s和t的数据结点连接在一起形成结果串。
LinkStrNode *Concat(LinkStrNode *s,LinkStrNode *t) {
p=t->next;
while (p!=NULL) //用p扫描t的所有数据结点
{ q=(LinkStrNode *)malloc(sizeof(LinkStrNode));
q->data=p->data; //将p结点复制到q结点中
r->next=q;r=q; //将q结点链接到str的末尾
p=p->next;
}
r->next=NULL; //尾结点的next域置为空
return str;
}考点四: 字符串和字符串匹配
3、判断串相等 StrEqual(s,t)
若两个链串s与t的长度相等且对应位置的字符均相同,则返回真;否则返回假。
bool StrEqual(LinkStrNode xs,LinkStrNode * t){
LinkStrNode *p-s->next,*q=t->next; //p、q分别扫描链串s和t的数据结点
while(p!=NULL&& q!=NULL&& p->data==q-> data){
p=p-> next;
q=q-> next;
}
if(p==NULL &&q==NULL) //s和t的长度相等且对应位置的字符均相同
return true;
else
return false;
}【字符串匹配】考点四: 字符串和字符串匹配
字符串匹配
设有两个串s和t,串t的定位就是要在串s
中找到一个与t相等的子串。通常把s称
为目标串(target string),把t称为模式串
(pattern string),因此串定位查找也称为
模式匹配(pattern matching)。
模式匹配成功是指在目标串s中找到了一
个模式串t;
不成功则指目标串s中不存在模式串t。
标串s中不存在模式串。考点四: 字符串和字符串匹配
暴力匹配算法
字符串BF算法(Brute Force算法)是一种基本的字符串匹配算法,也称为暴
力匹配算法或朴素匹配算法。其基本思想是将目标串(主串)的第一个字符与
模式串(子串)的第一个字符进行匹配,若相等,则继续比较下一个字符;若
不相等,则将模式串向右滑动一个字符,再次进行比较,直到找到匹配或遍历
完整个主串为止考点四: 字符串和字符串匹配
暴力匹配算法步骤
①将模式串(子串)与目标串(主串)的第一个字符进行比较。
②如果第一个字符相等,则继续比较下一个字符;如果不相等,则将模式
串向右滑动一个字符,重新开始比较。
③重复步骤②,直到模式串的最后一个字符与目标串的对应字符比较完毕。
④如果模式串的所有字符都与目标串的对应字符相等,则匹配成功;否则,
匹配失败。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第一趟比较中,当i=0,1与j=0,1处的元素相等,当i=2,j=2时,元素不相等,
此时i回溯到1,j回溯到0,如图所示。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第2趟比较中,当i=1, j=0处的元素不相等,此时i回溯到2,j回溯到0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第3趟比较中,当i=2, j=0处的元素相等,i=3, j=1处的元素相等,i=4, j=2处
的元素相等,i=4, j=3处的元素不相等,此时i回溯到3,j回溯到0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第4趟比较中,i=3,j=0的元素不相等,此时i回溯到4,j回溯到0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第五趟比较中,i=4,j=0处的元素不相等,此时i回溯到i=5,j=0。考点四: 字符串和字符串匹配
BF算法实例
设主串 S= "ababcabcacbab",模式 T="abcac"。
第六趟比较中,i=5,j=0处的元素相等,i=6,j=1处的元素相等,i=7,j=2
处的元素相等,i=8,j=3处的元素相等,i=9,j=4处的元素相等,全部字符
匹配成功。考点四: 字符串和字符串匹配
BF算法代码实现
int index(SqString s,SqString t)
{
int i,j,k;
for (i=0;i<=s.length-t.length;i++)
{ for (k=i,j=0; k<s.length && j<t.length && s.data[k]==t.data[j]; k++,j++);
if (j==t.length)
return(i);
}
return(-1);
}考点四: 字符串和字符串匹配
BF算法分析
• 算法在字符比较不相等,需要回溯(即i=i-j+1):即退到s中的下一个字符
开始进行继续匹配。
• 最好情况下的时间复杂度为O(m)。
• 最坏情况下的时间复杂度为O(n×m)。
• 平均的时间复杂度为O(n×m)。【KMP算法】考点四: 字符串和字符串匹配
KMP算法思想
KMP算法是D.E.Knuth、J.H.Morris和V.R.Pratt共同提出的,简称KMP
算法。
该算法较BF算法有较大改进,主要是消除了主串指针的回溯,从而使算
法效率有了某种程度的提高。考点四: 字符串和字符串匹配
KMP算法思想
基于BF算法,采用空间换时间的方式,提取保存有利于匹配的信息。
提取s还是t中的信息?每次从s不同字符开始匹配,而t总是从t0开始
匹配 提取t中的信息
t中的什么信息? 部分匹配信息。考点四: 字符串和字符串匹配
两个概念
• 前缀的概念:字符串起始部分(不能是整个字符串),对于字符串
"abcab",它有"a" "ab" "abc" "abca" 这样四个前缀。
• 最长前缀概念: 最长前缀是说以第一个字符开始,但是不包含最
后一个字符。前缀的最大长度不能等于整个字符串的长度,比如示
例中"abcab"的最长前缀是abca,而不能是整个字符串"abcab"。考点四: 字符串和字符串匹配
两个概念
• 后缀的概念:字符串末尾部分(不能是整个字符串),对于字符串
"abcab",它有"b" "ab" "cab" "bcab" 这样四个后缀。
• 最长后缀概念: 最长后缀是说以最后一个字符开始,但是不包含
第一个字符。示例中"abcab"的最长后缀是bcab,而不能是整个字
符串"abcab"考点四: 字符串和字符串匹配
两个概念
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-kj-k+1 j-1
开头的k个字符 t 前面的k个字符
j考点四: 字符串和字符串匹配
两个概念
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。
0 1 2 3 4
例如,t= “ababc” 考虑t[4]='c'
t= “a b a b c”
k=2,所以next[4] = k= 2。考点四: 字符串和字符串匹配
两个概念
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。考点四: 字符串和字符串匹配
两个概念
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-kj-k+1 j-1
开头的k个字符 t 前面的k个字符
j
求最大的k
0 1 2 3 4
例如,t= “aaaac” 考虑t[4]='c'
t= “a a a a c”
k=3,所以next[4] = k= 3。考点四: 字符串和字符串匹配
两个概念
t 字符前面的子串最多从t 开始的,不含t
j 1 0
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-kj-k+1 j-1
t 前面的k个字符
开头的k个字符
j
这个字符不能是t
0考点四: 字符串和字符串匹配
求解next数组的实例,求模式串t="aaaab"的next数组。
• 定义next[0]=-1,next[1]=0。
• 当j=2时,1~j-1的位置上只有一个字符'a'与t的开头字符相同,所以 next[2]=1.
• 当j=3时,1~j-1的位置上,的前面有字符串"a"和"aa"均与t的开头字符串相同,
所以 next[3 =2。
• 当j=4时,1~j-1的位置上t的前面有字符串"a"、"aa"和"aaa"均与t的开头字符
串相同,所以 next[4]=3。
归纳起来,模式串t对应的next数组如表所示,
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3考点四: 字符串和字符串匹配
模式串t求next值的算法
void GetNext(SqString t,int next[]) {
int j,k;
j=0; k=-1; next[0]=-1;
while (j<t.length-1) {
if (k==-1 || t.data[j]==t.data[k]){
j++; k++;
next[j]=k;
}
}考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
• next 数组定义:在模式串中(下标从0开始),next[i] 表示模式串
中以下标 i 处字符结尾的子串的最大相同前后缀的长度。
• 在KMP算法中,该值一方面表示模式串中1~i位置子串中的最长相
同前后缀长度,另一方面表示在该位置匹配失败时模式串回溯比较
的下一个字符位置考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
目标串s="aaaaab",模式串t="aaab"
第1趟匹配是从i=0、j=0开始的,失配处为i=3,j=3。尽管本趟匹配失败
了,但得到这样的“部分匹配”信息:s s 与t t 相同,如图所示。
1 2 1 2考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
目标串s="aaaaab",模式串t="aaab"
模式串t中有next[3]=2,表明t t =t t ,所以有s s =t t ,如图所示
1 2 0 1 1 2 0 1考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
目标串s="aaaaab",模式串t="aaab"
原来第2趟匹配是从i=1、j=0开始的,即需要回溯。现在既然有
s s =t t 成立,第2趟匹配可以从i=3、j=2(=next[3])开始,如图所示,即保
1 2 0 1
持主串指针i不变,模式串t右滑(j=next[j])个位置,让s 和t 对齐进行比
i next[j]=2
较。考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
i=0; j=0;
while (s和t都没有扫描完) {
if (j=-1或者它们所指字符相同)
i和j分别增1;
else
i不变,j回退到j=next[j](即模式串右滑);
}
if (j超界)
返回i; //模式匹配成功
else
返回-1; //模式匹配失败考点四: 字符串和字符串匹配
基于next数组的KMP算法的模式匹配过程
int KMPIndex(SqString s,SqString t) {
int next[MaxSize],i=0,j=0;
GetNext(t,next);
while (i<s.length && j<t.length) {
if (j==-1 || s.data[i]==t.data[j]) {
i++;
j++; //i、j各增1
}
else j=next[j]; //i不变,j后退
}
if (j>=t.length)
return(i-t.length); //返回匹配模式串的首字符
else
return -1; //返回不匹配标志
}考点四: 字符串和字符串匹配
KMP算法分析
⚫ 设串s的长度为n,串t长度为m。
⚫ KMP算法中求next数组的时间复杂度为O(m),在后面的匹配中因
主串s的下标不减即不回溯,比较次数可记为n,所以KMP算法平均
时间复杂度为O(n+m)。
⚫ 最坏的时间复杂度为O(n×m)。考点四: 字符串和字符串匹配
KMP算法的改进
设目标串s=“aaabaaaab”,模式串t=“aaaab”。KMP模式匹配过程。
(1)求t的next
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
失败:
t: a a a a b
i=3
0 1 2 3 4
j=3,j=next[3]=2考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=2
失败:
t: a a a a b
0 1 2 3 4 i=3
j=2,j=next[2]=1考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=1
t: a a a a b 失败:
0 1 2 3 4 i=3
j=1,j=next[1]=0考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=0 失败:
t: a a a a b
i=3
0 1 2 3 4
j=0,j=next[0]=-1考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
因为j=-1:
0 1 2 3 4 5 6 7 8
i++;
s: a a a b a a a a b
j++;
即:
i=4 t: a a a a b
成功匹配:
j=0
0 1 2 3 4
返回i-t.length
=9-5=4考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
前面的匹配过程:
i=3 i=3 i=3 i=3 i=3
j=3 j=2 j=1 j=0 j=-1
将s[i] 将s[i] 将s[i] 将s[i] 将s[i+1]
与t[3] 与t[2] 与t[1] 与t[0] 与t[0]
匹配 匹配 匹配 匹配 匹配
因为t[3]=t[2]=t[1]=t[0]='a' 是不必要的
i=3 i=3
j=3 j=-1考点四: 字符串和字符串匹配
KMP算法的改进 将next改为nextval:
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
nextval[j] -1 -1 -1 -1 3
t[4]='b' ≠ t[next[4]]='a'
next[1]=0
t[1]=t[next[1]]=t[0]='a'
∴ nextval[4]=next[4]
∴ nextval[1]=nextval[0]=-1
⚫ nextval[0]=-1
⚫ 当t[j]=t[next[j]]时:nextval[j]=nextval[next[j]]
⚫ 否则: nextval[j]=next[j]
用nextval取代next,得到改进的KMP算法。考点四: 字符串和字符串匹配
KMP算法的改进
使用改进后的KMP算法示例:
j 0 1 2 3 4
t[j] a a a a b
nextval[j] -1 -1 -1 -1 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
失败:
t: a a a a b
i=3
0 1 2 3 4
j=3,j=nextval[3]=-1考点四: 字符串和字符串匹配
KMP算法的改进
j 0 1 2 3 4
t[j] a a a a b
nextval[j] -1 -1 -1 -1 3
因为j=-1:
0 1 2 3 4 5 6 7 8
i++;
s: a a a b a a a a b
j++;
即
t: a a a a b
i=4
成功匹配:
0 1 2 3 4
j=0
返回i-t.length
=9-5=4
改进后的KMP算法进一步提高模式匹配的效率。考点四: 字符串和字符串匹配
KMP算法的改进
设目标串 s="abcaabbabcabaacbacba",模式串 t="abcabaa",计算模式
串t的nextval函数值,并给出利用改进KMP算法进行模式匹配的过程。
模式串t的nextval值如下表所示。考点四: 字符串和字符串匹配
KMP算法的改进考点四: 字符串和字符串匹配
KMP算法的改进考点四: 字符串和字符串匹配
KMP算法的改进考点四: 字符串和字符串匹配
KMP算法的改进THANKS