第十讲:字符串串的基本概念
串(或字符串)是由零个或多个字符组成的有限序列。
串 线性表
⚫ 串中所含字符的个数称为该串的长度(或串长)。
⚫ 含零个字符的串称为空串,用Ф表示。串的基本概念
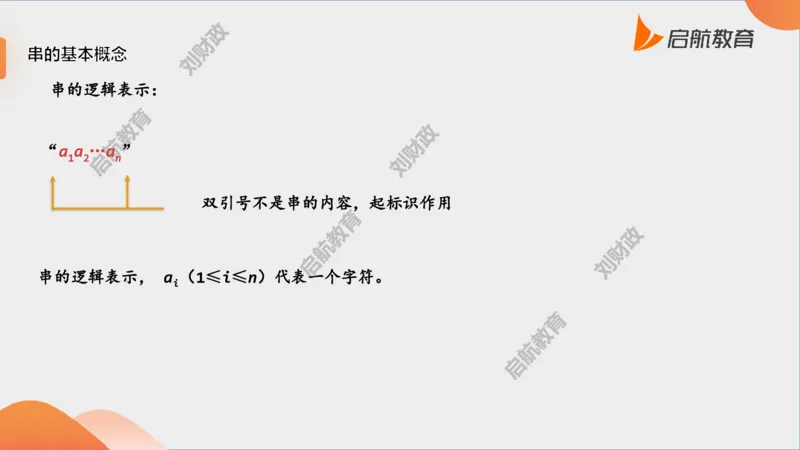
串的逻辑表示:
“a a …a ”
1 2 n
双引号不是串的内容,起标识作用
串的逻辑表示, a (1≤i≤n)代表一个字符。
i串的基本概念
串相等:两个串的长度相等并且各个对应位置上的字符都相同时。
如:
“abcd” ≠ “abc”
“abcd” ≠ “abcde”
所有空串是相等的。串的基本概念
子串:
一个串中任意个连续字符组成的子序列(含空串)称为该串的子串。
例如, “abcde”的子串有:“”、“a”、“ab” 、“abc”、“abcd”和“abcde”等
真子串是指不包含自身的所有子串。串抽象数据类型=逻辑结构+基本运算(运算描述)
串的基本运算如下:
StrAssign(&s,cstr):将字符串常量cstr赋给串s,即生成其值等于cstr的串s。
StrCopy(&s,t):串复制。将串t赋给串s。
StrEqual(s,t):判串相等。若两个串s与t相等则返回真;否则返回假。
StrLength(s):求串长。返回串s中字符个数。
Concat(s,t):串连接:返回由两个串s和t连接在一起形成的新串。
SubStr(s,i,j):求子串。返回串s中从第i(1≤i≤n)个字符开始的、由连
续j个字符组成的子串。 InsStr(s1,i,s2):插入。将串s2插入到串s1的第i(1≤i≤n+1)个字符中,即
将s2的第一个字符作为s1的第i个字符,并返回产生的新串。
DelStr(s,i,j):删除。从串s中删去从第i(1≤i≤n)个字符开始的长度为j的
子串,并返回产生的新串。
RepStr(s,i,j,t):替换。在串s中,将第i(1≤i≤n)个字符开始的j个字符构
成的子串用串t替换,并返回产生的新串。
DispStr(s):串输出。输出串s的所有元素值。谢谢大家串的顺序存储及其基本操作实现
串中元素逻辑关系与线性表的相同,串可以采用与线性表相同的存储结构。
逻辑结构
线性表
顺序表 链 表
顺序串 链串 存储结构串的顺序存储及其基本操作实现
对于非紧缩格式(一个char存放一个字符)的顺序串,其类型声明如下:
#define MaxSize 100
typedef struct
用来存储字符串
{ char data[MaxSize];
int length;
} SqString;
用来存储字符串长度串的顺序存储及其基本操作实现
1)生成串StrAssign(&s,cstr)
将一个C/C++字符串常量cstr(以'\0'字符标识结尾)赋给
顺序串s,即生成一个其值等于cstr的串s。
void StrAssign(SqString &s,char cstr[]) //s为引用型参数
{ int i;
for (i=0;cstr[i]!='\0';i++)
s.data[i]=cstr[i];
s.length=i; //设置串s的长度
}
2)销毁串DestroyStr(&s)
void DestroyStr(SqString &s)
{ }串的顺序存储及其基本操作实现
6)串连接Concat(s,t)
返回由两个顺序串s和t连接在一起形成的结果串。
"abcd"
Concat "abcd123"
"123"
SqString Concat(SqString s,SqString t)
{ SqString str; //定义结果串
int i;
str.length=s.length+t.length;
for (i=0;i<s.length;i++) //将s.data[0..s.length-1]复制到str
str.data[i]=s.data[i];
for (i=0;i<t.length;i++) //将t.data[0..t.length-1]复制到str
str.data[s.length+i]=t.data[i];
return str;
}串的顺序存储及其基本操作实现
【例】设计顺序串上实现串比较运算Strcmp(s,t)的算法。例如:
"ab" < "abcd" "abcd" < "abd"
(1)比较s和t两个串共同长度范围内的对应字符:
"ba">"abc"
① 若s的字符>t的字符,返回1;
② 若s的字符<t的字符,返回-1; "aba"<"bc"
③ 若s的字符=t的字符,按上述规则继续比较。
(2)当(1)中对应字符均相同时,比较s和t的长度:
"abc"="abc"
① 两者相等时,返回0;
"abc">"ab"
② s的长度>t的长度,返回1;
③ s的长度<t的长度,返回-1。 "ab"<"abd"串的顺序存储及其基本操作实现
int Strcmp(SqString s,SqString t)
{ int i,comlen;
if (s.length<t.length)
comlen=s.length; //求s和t的共同长度
else
comlen=t.length;
for (i=0;i<comlen;i++) //在共同长度内逐个字符比较
if (s.data[i]>t.data[i])
return 1;
else if (s.data[i]<t.data[i])
return -1;
if (s.length==t.length) //s==t
return 0;
else if (s.length>t.length) //s>t
return 1;
else return -1; //s<t
}串的链式存储及其基本操作实现
⚫ 链串的组织形式与一般的链表类似。
⚫ 链串中的一个结点可以存储多个字符。
通常将链串中每个结点所存储的字符个
数称为结点大小。串的链式存储及其基本操作实现
s
…
ABCD EFGH MN## ∧
结点大小为4的链串
s
…
A B N ∧
结点大小为1的链串串的链式存储及其基本操作实现
链串结点大小1时,链串的结点类型声明如下:
typedef struct snode
{ char data;
struct snode *next;
} LinkStrNode;
s
…
A B N ∧串的链式存储及其基本操作实现
1)生成串StrAssign(&s,cstr)
将一个C/C++字符串常量cstr(以'\0'字符标识结尾)赋给链串s,
即生成一个其值等于cstr的链串s。
void StrAssign(LinkStrNode *&s,char cstr[])
{ int i;
LinkStrNode *r,*p;
s=(LinkStrNode *)malloc(sizeof(LinkStrNode));
r=s; //r始终指向尾结点
for (i=0;cstr[i]!='\0';i++)
{ p=(LinkStrNode *)malloc(sizeof(LinkStrNode));
p->data=cstr[i];
r->next=p; r=p;
}
r->next=NULL; //尾结点next域置为空
}串的链式存储及其基本操作实现
2)销毁串DestroyStr(&s)
该运算和销毁带头结点单链表运算的实现过程相同。
void DestroyStr(LinkStrNode *&s)
{ LinkStrNode *pre=s,*p=s->next; //pre指向结点p的前驱结点
while (p!=NULL) //扫描链串s
{ free(pre); //释放pre结点
pre=p; //pre、p同步后移一个结点
p=pre->next;
}
free(pre);
}串的链式存储及其基本操作实现
LinkStrNode *Concat(LinkStrNode *s,LinkStrNode *t)
6)串连接Concat(s,t) { LinkStrNode *str,*p=s->next,*q,*r;
str=(LinkStrNode *)malloc(sizeof(LinkStrNode));
r=str; //r指向结果串的尾结点
while (p!=NULL) //用p扫描s的所有数据结点
求由两个链串s和t
{ q=(LinkStrNode *)malloc(sizeof(LinkStrNode));
q->data=p->data; //将p结点复制到q结点中
r->next=q;r=q; //将q结点链接到str的末尾
的数据结点连接在一起
p=p->next;
}
p=t->next;
形成结果串。
while (p!=NULL) //用p扫描t的所有数据结点
{ q=(LinkStrNode *)malloc(sizeof(LinkStrNode));
q->data=p->data; //将p结点复制到q结点中
r->next=q;r=q; //将q结点链接到str的末尾
p=p->next;
}
r->next=NULL; //尾结点的next域置为空
return str;
}谢谢大家0.串的模式匹配1 Brute-Force算法
BF算法思路:从s的每一个字符开始依次与t的字符进行匹配。
从s开从s始从开匹s始配从开匹:s始配第开匹:1始趟配第匹:2趟配第:3趟第4趟
0 1 2 3
s:
a a a a b c d
t:
a ba cba cba cb c
过程
⚫ i,j分别扫描字符串s和t
⚫ i从0到s.length-t.length循环。
⚫ 对于每个s[i],k=i,j=0开始比较
⚫ 如果t扫描完毕,则返回i
⚫ 若s全部比较完毕都没有返回,则返回-11 Brute-Force算法
int index(SqString s,SqString t)
{ int i,j,k;
for (i=0;i<=s.length-t.length;i++)
{ for (k=i,j=0; k<s.length && j<t.length &&
s.data[k]==t.data[j]; k++,j++);
if (j==t.length)
return(i);
}
return(-1);
}1 Brute-Force算法
实际上,可以只采用两个变量i、j,通过i回退实现:
i=i-j回到s本趟匹配的开始位置
i
i=i-j+1为下一趟匹配的开始位置
s: s … s s … s s … s
0 i i+1 i+j-1 i+j n-1
t: t t … t t … t
0 1 j-1 j m-1
j
从s 开始匹配:
i
⚫ 若s =t i++, j++
i j
⚫ 若s ≠ t i=i-j+1, j=0
i j1 Brute-Force算法
对应的BF算法如下:
int BF(SqString s,SqString t)
{ int i=0,j=0;
while (i<s.length && j<t.length)
{ if (s.data[i]==t.data[j])
{ i++; //主串和子串依次匹配下一个字符
j++;
}
else //主串、子串指针回溯重新开始下一次匹配
{ i=i-j+1; //主串从下一个位置开始匹配
j=0; //子串从头开始匹配
}
}
if (j>=t.length) //或者if (j==t.length)
return(i-t.length); //返回匹配的第一个字符的下标
else
return(-1); //模式匹配不成功
}1 Brute-Force算法
BF算法分析
⚫ 算法在字符比较不相等,需要回溯(即i=i-j+1):即
退到s中的下一个字符开始进行继续匹配。
⚫ 最好情况下的时间复杂度为O(m)。
⚫ 最坏情况下的时间复杂度为O(n×m)。
⚫ 平均的时间复杂度为O(n×m)。2 KMP算法
KMP算法是D.E.Knuth、J.H.Morris和V.R.Pratt
共同提出的,简称KMP算法。
该算法较BF算法有较大改进,主要是消除了主串指
针的回溯,从而使算法效率有了某种程度的提高。2 KMP算法
◼ 基于BF算法,采用空间换时间的方式,提取保存有利
于匹配的信息。
◼ 提取s还是t中的信息?每次从s不同字符开始匹配,
而t总是从t0开始匹配 提取t中的信息
◼ t中的什么信息? 部分匹配信息。2 KMP算法
KMP算法用next数组保存部分匹配信息
目标串s=“aaaaab”,模式串t=“aaab”。
开始匹配的字符 下次开始匹配的字符
0 1 2 3 4 5
s: a a a a a b
下次匹配的两个字符
t: a a a b
从t中发现:b前面有2个字符和开头的2个字符相同
t中每个位置都有这种信息
用一个数组next保存,如next[3]=22 KMP算法
next[j]是指tj字符前有多少个字符与t开头的字符相同
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-k j-k+1 j-1
开头的k个字符 t 前面的k个字符
j
0 1 2 3 4
例如,t= “a b a b c” 考虑t[4]='c'
t= “a b a b c”
k=2,所以next[4] = k = 2。2 KMP算法
next[j]是指tj字符前最多有多少个字符与t开头的字符相同
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-k j-k+1 j-1
开头的k个字符 t 前面的k个字符
j
求最大的k
0 1 2 3 4
例如,t= “a a a a c” 考虑t[4]='c'
t= “a a a a c”
k=3,所以next[4] = k = 3。2 KMP算法
tj字符前面的子串最多从t1开始的,不含t0
模式串t中字符t ,存在某个k(0<k<j),使得以下成立:
j
“t t … t ” = “t t …t ”
0 1 k-1 j-k j-k+1 j-1
t 前面的k个字符
开头的k个字符
j
这个字符不能是t
0
0 1 2
例如,t= “a a c” 考虑t[2]='c'
t= “a a c”
k=1,所以next[2] = k = 1。2 KMP算法
next[0]的特殊含义
next[0]设置为-1
因为s的字符s 与t 不相同,没有任何有用
i 0
的部分匹配信息,直接从下一趟(s /t )
i+1 0
开始匹配。2 KMP算法
对于模式串t=“t t …t …t ”
0 1 j m-1
归纳起来,定义next[j]数组如下:
开头的k个字符 t 前面的k个字符
j
MAX{ k | 0<k<j,且“t t …t ” = “t t …t ”}
0 1 k-1 j-k j-k+1 j-1
当此集合非空时
next[j]=
-1 当j=0时
0 其他情况2 KMP算法
t=“aaab”对应的next数组如下:
j 0 1 2 3
t[j] a a a b
next[j] -1 0 1 2
t =t ="a" t t =t t ="aa"
0 1 0 1 1 22 KMP算法
由模式串t求next值的算法:
void GetNext(SqString t,int next[]) 求出next[3]=2,k=2
{ int j,k;
j=0; k=-1; next[0]=-1; 0 1 2 3 4
while (j<t.length-1) t=“a a a a c”
{ if (k==-1 || t.data[j]==t.data[k])
{ j++; k++; j=3,k=2,所指字符相同
next[j]=k;
}
j++,k++
next[4]=3
}
由next[j]求next[j+1],所以j取值0~m-22 KMP算法
由模式串t求next值的算法:
求出next[2]=1,k=1
void GetNext(SqString t,int next[])
0 1 2 3
{ int j,k;
t=“a a b c”
j=0; k=-1; next[0]=-1;
while (j<t.length-1)
j=2,k=1,所指字符不同
{ if (k==-1 || t.data[j]==t.data[k])
{ j++; k++;
next[j]=k;
k=next[1]=0
}
j=2,k=0,所指字符不同
else
k=next[k];
k=next[0]=-1
}
j++,k++ j=3,k=0
}
next[3]=02 KMP算法
KMP过程
i=0; j=0;
while (s和t都没有扫描完)
{ if (j=-1或者它们所指字符相同)
i和j分别增1;
else
i不变,j回退到j=next[j](即模式串右滑);
}
if (j超界)
返回i; //模式匹配成功
else
返回-1; //模式匹配失败2 KMP算法
KMP算法实现:
int KMPIndex(SqString s,SqString t)
{ int next[MaxSize],i=0,j=0;
GetNext(t,next);
while (i<s.length && j<t.length)
{
if (j==-1 || s.data[i]==t.data[j])
{ i++;
j++; //i、j各增1
}
else j=next[j]; //i不变,j后退
}
if (j>=t.length)
return(i-t.length); //返回匹配模式串的首字符
else
return -1; //返回不匹配标志
}2 KMP算法
KMP算法分析
⚫ 设串s的长度为n,串t长度为m。
⚫ KMP算法中求next数组的时间复杂度为O(m),在后面的匹
配中因主串s的下标不减即不回溯,比较次数可记为n,
所以KMP算法平均时间复杂度为O(n+m)。
⚫ 最坏的时间复杂度为O(n×m)。2 KMP算法
已示例知字符串S为“abaabaabacacaabaabcc”,模式串t为“abaabc”,采用
KMP算法进行匹配,第一次出现“失配”(s[i]!=t[j])时,i=j=5,则下次
开始匹配时,i和j的值分别是( )。
A.i=1,j=0 B.i=5,j=0 C.i=5,j=2 D.i=6,j=2
j 0 1 2 3 4 5
选C
t[j] a b a a b c
next[j] -1 0 0 1 1 22 KMP算法
假设串采用顺序串存储结构。设计一个算法求串t在串s中出现
的次数,如果不是子串返回0。采用KMP算法求解。
例如"aa"在"aaaab"中出现2次。
◼ 用count累计t在串s中出现的次数(初始值为0)。
◼ 采用KMP方法,当匹配成功时,count增加1,并且置j为0重新开始比
较。2 KMP算法
int StrCount2(SqString s,SqString t)
//利用KMP算法求t在s中出现的次数
{ int i=0,j=0,count=0;
int next[MaxSize];
GetNext(t,next);
while (i<s.length && j<t.length)
{ if (j==-1 || s.data[i]==t.data[j])
{ i++; //i,j各增1
j++;
}
else
j=next[j]; //i不变,j后退
if (j>=t.length) //成功匹配1次
{ count++;
j=0; //j设置为0,继续匹配
}
}
return count;
}2 KMP算法
KMP算法的正确性说明
s: s s s s s s s …
0 1 2 3 4 5 6
设目标串
s=“s s s s s s s …”,模 t: t t t t t t t next[5]=2
0 1 2 3 4 5 6 0 1 2 3 4 5 6
式串t=“t t t t t t ”,
0 1 2 3 4 5 KMP算法
相当于从s 开
next[5]=2。从s 开始匹配
始匹配!
4
1 s: s s s s s s s …
0 1 2 3 4 5 6
而没有s ,s 开
(第2趟),失配处为s ≠t , 2 3
始的匹配趟,
6 5
正确吗?
这里i=6,j=5,k=2。 t: t t t t t t t
0 1 2 3 4 5 62 KMP算法
考虑s 开始的匹配趟 next[5]=2
2
s: s s s s s s s …
0 1 2 3 4 5 6
t: t t t t t t t
0 1 2 3 4 5 6
"s s s s " = "t t t t "
2 3 4 5 1 2 3 4
next[5]=2 "t t "="t t ",而 "t t t t " ≠ "t t t t "
3 4 0 1 1 2 3 4 0 1 2 3
"s s s s " ≠ "t t t t "
2 3 4 5 0 1 2 3
s: s s s s s s s …
0 1 2 3 4 5 6
从s 开始的匹配趟
2
是不必要的
t: t t t t t t t
0 1 2 3 4 5 62 KMP算法
next[5]=2
考虑s 开始的匹配趟
3
s: s s s s s s s …
0 1 2 3 4 5 6
t: t t t t t t t
0 1 2 3 4 5 6
"s s s " = "t t t "
3 4 5 2 3 4
next[5]=2 "t t "="t t ",而 "t t t " ≠ "t t t "
3 4 0 1 2 3 4 0 1 2
"s s s " ≠ "t t t "
3 4 5 0 1 2
s: s s s s s s s …
0 1 2 3 4 5 6
从s 开始的匹配趟
t: t t t t t t t 3
是不必要的
0 1 2 3 4 5 62 KMP算法
KMP算法的改进
设目标串s=“aaabaaaab”,模式串t=“aaaab”。KMP模式匹配过程。
(1)求t的next
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 32 KMP算法
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
t: a a a a b 失败:
0 1 2 3 4
i=3
j=3,j=next[3]=22 KMP算法
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
j=2
t: a a a a b
失败:
0 1 2 3 4
i=3
j=2,j=next[2]=12 KMP算法
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
t: a a a a b
j=1 失败:
0 1 2 3 4
i=3
j=1,j=next[1]=02 KMP算法
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i=3
t: a a a a b 失败:
j=0
0 1 2 3 4
i=3
j=0,j=next[0]=-12 KMP算法
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
因为j=-1:
0 1 2 3 4 5 6 7 8
i++; s: a a a b a a a a b
j++;
t: a a a a b
即:
成功匹配:
0 1 2 3 4
i=4
返回i-t.length
j=0
=9-5=42 KMP算法
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
前面的匹配过程:
i=3 i=3 i=3 i=3 i=3
j=3 j=2 j=1 j=0 j=-1
将s[i] 将s[i] 将s[i] 将s[i] 将s[i+1]
与t[3] 与t[2] 与t[1] 与t[0] 与t[0]
匹配 匹配 匹配 匹配 匹配
是不必要的
因为t[3]=t[2]=t[1]=t[0]='a'
i=3 i=3
j=3 j=-12 KMP算法
将next改为nextval:
j 0 1 2 3 4
t[j] a a a a b
next[j] -1 0 1 2 3
nextval[j] -1 -1 -1 -1 3
t[4]='b' ≠ t[next[4]]='a'
next[1]=0
t[1]=t[next[1]]=t[0]='a'
∴ nextval[4]=next[4]
∴ nextval[1]=nextval[0]=-1
⚫ nextval[0]=-1
⚫ 当t[j]=t[next[j]]时:nextval[j]=nextval[next[j]]
⚫ 否则: nextval[j]=next[j]
用nextval取代next,得到改进的KMP算法。2 KMP算法
使用改进后的KMP算法示例:
j 0 1 2 3 4
t[j] a a a a b
nextval[j] -1 -1 -1 -1 3
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
失败:
t: a a a a b
0 1 2 3 4
i=3
j=3,j=nextval[3]=-12 KMP算法
j 0 1 2 3 4
t[j] a a a a b
nextval[j] -1 -1 -1 -1 3
因为j=-1:
0 1 2 3 4 5 6 7 8
s: a a a b a a a a b
i++;
j++;
t: a a a a b
成功匹配:
即
0 1 2 3 4
i=4 返回i-t.length
j=0 =9-5=4
改进后的KMP算法进一步提高模式匹配的效率。谢谢大家第十一讲:外排序CONTENTS外排序概述1、什么是外排序
外排序是指数据存放在外存中,数据排序时涉及内、外存数据交
换的排序方法。
内存
数据交换
文件
存储在外存上的数据以文件为基本单位。2、外排序的基本方法
外排序的基本方法是归并排序法。它分为以下两个步骤:
(1)生成若干初始归并段(顺串):这一过程也称为文件预处理。一
种常规的方法如下:
把含有n个记录的文件,按内存大小w分成若干长度为w的子文件
(归并段);
分别将各子文件(归并段)调入内存,采用有效的内排序方法排序
后送回外存。 产生m=n/w个初始归并段。
某内排序算法
abc .dat
1
abc .dat
abc.dat 内存 2 均有序
…
abc .dat
m2、外排序的基本方法
(2)多路归并:对这些初始归并段进行多遍归并,使得有序的归并段
逐渐扩大,最后在外存上形成整个文件的单一归并段,也就完成了这个文
件的外排序。
采用归并算法
abc .dat
1
abc .dat 有序
内存
2 abc.dat
…
abc .dat
m2、外排序的基本方法
示例 文件abc.dat:
5,6,3,4,9,8,1,7,2,10 进行递增排序
应用程序可用的内存空间大小w=2。
① abc1.dat:5,6
② abc2.dat:3,4
③ abc3.dat:8,9
④ abc4.dat:1,7
⑤ abc5.dat:2,102、外排序的基本方法
外排序过程:
(1)生成5个初始归并段
w=2
① abc1.dat:5,6
内存 ② abc2.dat:3,4
③ abc3.dat:8,9
④ abc4.dat:1,7
abc.dat
⑤ abc5.dat:2,10
5,6,3,4,9,8,1,7,2,102、外排序的基本方法
(2)多路归并:w=2 2路归并(k=2)
abc1.dat:5,6
abc2.dat:3,4
内存
abc12.dat:3,4,5,6
abc1.dat k=2
abc2.dat
① abc1.dat:5,6
② abc2.dat:3,4
③ abc3.dat:8,9
④ abc4.dat:1,7
⑤ abc5.dat:2,102、外排序的基本方法
过 程: 段1记录 段2记录
abc1.dat: 5 6 ∞ 比较
结果段
3 4 ∞
abc2.dat: abc12.dat:
内存
大致分析
总的关键字比较次数:
u(u=4)个记录需要进行u-1次操作(不考虑∞ )
(u-1)(k-1)
k(k=2)路归并每次需要k-1次关键字比较
abc1.dat和abc2.dat中每个记录读一次写一次(写入abc12.dat)2、外排序的基本方法
abc3.dat:8,9
abc4.dat:1,7
内存
abc34.dat:1,7,8,9
abc3.dat w=2
abc4.dat
abc3.dat和abc4.dat中每个记录读一次写一次(写入abc34.dat)
abc12.dat:3,4,5,6
abc34.dat:1,7,8,92、外排序的基本方法
abc12.dat:3,4,5,6
abc34.dat:1,7,8,9
内存
abc1234.dat:1,3,4,
5,6,7,8,9
abc12.dat k=2
abc34.dat
abc1234.dat:1,3,4,5,6,7,8,9
abc5.dat:2,10
abc12.dat和abc34.dat中每个记录读一次写一次(写入abc1234.dat)2、外排序的基本方法
abc1234.dat:1,3,4,5,6,7,8,9
abc5.dat:2,10
内存
abc.dat:1,2,3,4,
5,6,7,8,9,10
abc1234.dat
k=2
abc5.dat
abc1234.dat和abc5.dat中每个记录读一次写一次(写入abc.dat)
归并过程的性能:
记录读写次数。
内存中归并时需要关键字比较次数。归并过程对应的归并树
abc1.dat abc2.dat abc3.dat abc4.dat abc5.dat
5,6 3,4 8,9 1,7 2,10
abc12.dat abc34.dat
abc1.dat中每
个记录读一次写 3,4,5,6 1,7,8,9
一次(写入
abc12.dat)
abc1234.dat
1,3,4,5,6,7,8,9
abc.dat
归并过程的性能:
1,2,3,4,5,6,7,8,9,10
记录读写次数。
内存中归并时需要关键字比较次数。2、外排序的基本方法
外排序方法与各种外存设备的特征有关。
外存设备大体上可分为两类:
顺序存取设备,例如磁带。
直接存取设备,例如磁盘。谢谢大家磁盘排序
(外部排序方法)简单的排序过程磁盘排序过程
F 文件
1 读
写
读 写 读 写
F 文件
F 文件 内存 2 内存
F 文件
in
out
写 …
读
F 文件
m
生成若干初始归并段 归并成一个有序文件示例
设有一个文件Fin.dat,内含4500个记录:A ,A ,…,A ,现在
1 2 4500
要对该文件进行排序,结果放在Fout.dat文件中。可占用的内存空间至多只
能对750个记录进行排序。
Fin.dat文件放在磁盘上。假设每个记录占用一个物理块。
内存
Fin.dat文件 Fout.dat文件
(750)某种内排序方法
产生6个长度为750
文件Fin.dat
个记录的有序文件
容量为750个记录
(含4500个记录) F ~F 。
1 6可用内存空间大小为750个记录
可以使用多种归并方案来完成归并方案1:二路归并1
F F F F F F
1 2 3 4 5 6
F F F
7 8 9
F
10
F
out
注意:
① 内存大小为750个记录,但任意大小的两个归并段都可以进行归并。
② 每归并一次,参与归并的每个记录都要读一次和写一次。方案1的读写记录数计算
F F F F F F
1 2 3 4 5 6
F F F
7 8 9
F 和F 中
1 2
每个记录
读3次、
F
写3次 10
F
out
总的读记录数(写记录数与之相同):
[(F +F +F +F 的记录数)×3+(F +F 的记录数)×2]=12000=8/3遍
1 2 3 4 5 6
该数越大,效率越差 等于哈夫曼树的WPL归并方案2:二路归并2
F F F F F F
1 2 3 4 5 6
F
7
F
8
F
9
F
10
F
out
方案2:总的读记录数WPL=15000。
方案1更好
方案1:总的读记录数WPL=12000。归并方案3:三路归并
F F
7 8
F
out
总的读记录数(写记录数与之相同):
方案3 :WPL=(750+750+750)×2+(750+750+750)×2=9000
不同的归并方案所需要的读写记录数是不同的!谢谢大家置换-选择排序方法生成初始归并段
生成前面的初始归并段的方法
某内排序算法
abc .dat
1
abc.dat 内存 abc 2 .dat 均有序
…
abc .dat
m
另一种方法:采用一种称为置换-选择排序方法用于生成初始归并段。
可以减少生成的初始归并段个数置换-选择排序方法
(1)从待排文件F 中按内存工作区WA的容量w读入w个记录。设归并
in
段编号i=1。
(2)从WA中选出关键字最小的记录R 。
min
(3)将R 记录输出到当前归并段F 。
min i
(4)若F 不空,则从F 中读入下一个记录x放在R 所在的工作区位置
in in min
代替R 。
min
(5)在工作区中所有≥R 的记录中选择出最小记录作为新的R ,转
min min
(3),直到选不出这样的R 。
min
(6)设i=i+1,开始一个新的归并段。
(7)若工作区已空,则初始归并段已全部产生;否则转(2)。【例】设磁盘文件中共有18个记录,记录的关键字分别为:
{15,4,97,64,17,32,108,44,76,9,39,82,56,31,
80,73,255,68}
若内存工作区可容纳5个记录,用置换-选择排序可产生几个初始归并
段,每个初始归并段包含哪些记录?置换-选择排序示例演示
18个记录(w=5):
15 4 97 64 17 32 108 44 76 9 39 82 56 31 80 73 255 68 ∞
内存工 作区w=5
归并段1:
归并段2:
依次类推,产生归并段2:9,31,39,56,68,73,80,255置换-选择排序示例演示
1)文件中的记录是:15、19、
04、83、12、27、11、25、16、
34、26、07、10、90、06
2)假设缓冲区大小只有4个int置换-选择排序中关键字比较次数分析
共有n个记录,内存工作区WA的容量为w:
若在w个记录中选取最小关键字的采用简单比较方法,每次需要w-
1次比较。
总的时间复杂度为O(nw)。谢谢大家多路平衡归并多路平衡归并
1、k路平衡归并概述
什么是k路平衡归并
2路平衡归并:每一趟从m个归并段得到m/2个归并段。
例如:
m=8,k=2
log m=3
2
遍2路平衡归并:每一趟从m个归并段得到m/2个归并段。
m=6,k=2,增加两个长度为0的虚
段
log m=3
2
遍
可以推广到k路平衡归并 影响k路平衡归并的因素
影响k路平衡归并的效率的因素:
归并时需要读写磁盘的次数
归并时需要关键字比较的次数。 k路平衡归并时读写磁盘次数的计算
例如 m=8,假设每个归并段4个记录:k=2
读记录次数 = WPL= 8×4×3 = 96
(如果每个记录占用一个物理块,读写磁盘次数=96×2=192次)
采用k路平衡归并时,通常k越大,读写磁盘次数会减少。 k路平衡归并时关键字比较次数的计算
采用k路平衡归并时,则相应的归并树有log m+1层,要对数据进
k
行log m趟扫描。
k
m=8
k=2
log m趟
k每一趟需(u-1)×(k-1)
u个记录 次关键字比较
log m趟
k
总共需要的关键字比较次数为:
log m×(u-1)×(k-1)
k
= log m/ log k×(u-1)×(k-1)
2 2
= log m×(u-1)×(k-1)/log k
2 2总共需要的关键字比较次数:
(k-1)/log k在k增大时会增大
2
log m × (u-1) × (k-1)/log k
2 2
在初始归并段个数m与记录个数u确定时是常量
结论:增大归并路数k,读写磁盘次数减少,而关键字比较次数会增
大。若k增大到一定的程度,就会抵消掉由于减少读写磁盘次数而赢得的
时间。2、利用败者树实现k路平衡归并过程
败者树用于在k个记录中选取最小关键字的记录。败者树类似于堆排序
中的堆。
利用败者树实现k路平衡归并的过程是:
先建立败者树。
然后对k个输入有序段进行k路平衡归并。【例】 设有5个初始归并段,它们中各记录的关键字分别是:
F :{17,21,∞}
0
F :{5,44,∞}
1
F :{10,12,∞}
2
F :{29,32,∞}
3
F :{15,56,∞}
4
其中,∞是段结束标志。说明利用败者树进行k=5路平衡归并排序的过程。 构建败者树
k=5:创建含有k个叶子结点的完全二叉树(结点个数最少)。
n =n -1=k-1,n=n +n +n =2k-1+n ,让n =0,总共2k-
2 0 0 1 2 1 1
1=9个结点,另外添加一个冠军结点。
冠军(最小者)
17 5 10
F F F
0 1 2
F 29 F 15
3 4冠军(最小者)
5(-∞)
5(-∞) 5(-∞)
5(-∞)
17 5 10
F F F
0 1 2
F 29 F 15
3 4
每个叶子结点对应一个归并段,段号为0~4。
初始时每个分支结点取值“5(-∞)”,5表示段号(此时为虚拟段号),
- ∞表示最小关键字。例如,某结点取值为“4(15)”,表示结点值来自
4号段的关键字15对应的记录。调整产生冠军(最小者)的过程
从F F 操作:将当前结点的关键字与父结点比较,将大的(败者)放
4 0
在父结点中,小者(胜者)继续进行,直到根结点。最后将胜者放在冠
军结点中。
冠军(最小者)
51((-5∞))
541(((-15∞5)))
045(((11-∞75))) 25((1-∞0))
543(((-21∞95)))
17 5 10
F F F
0 1 2
F F
29 15
3 4
败者树构建完毕 用败者树进行归并
过程:取出的冠军为1(5),从1号段中取下一个记录,沿着个分支向上操作,产生次小的记录。…
冠军(最小者) 521(((-15∞0)))
归并文件: 5 10
541(((-15∞5)))
450(((1-1∞57))) 125(((41-∞40)))
543(((-12∞59))) F F F
17 5 10
0 1 2
21 44 12
∞ ∞ ∞
F F
29 15
3 4
依此进行,直到冠军为∞才结束。
32 15
∞ ∞ 每次产生一个冠军,比较次数约为log k。
2利用败者树实现k路平衡归并时,总共需要的关键字比较次数为:
log m×(u-1)×log k
k 2
= log m×(u-1)×log k/log k
2 2 2
= log m×(u-1)
2
结论:关键字比较次数与k无关 总的内部归并时间不会随k的增大而
增大。
利用败者树实现k路平衡归并
只要内存空间允许,尽可能增大归并路数k。采用败者树,置换-选择排序中关键字比较次数分析
共有n个记录,内存工作区WA的容量为w:
若在w个记录中选取最小关键字的采用败者树方法,每次需要
log w次比较。
2
总的时间复杂度为O(nlog w)。
2最佳归并树
k路平衡归并适合初始归并段中的记录个数相同的情况,当初始归并
段中的记录个数不同时,怎么办 ?
当初始归并段和k已确定的情况时
归并方案转化为
哪些初始归并段先归并,哪些后归并的问题。例如:k=2,4个初始归并段含记录个数分别是4、6、3、8。
4 6 3 8
归并方式1
10 11
WPL=(4+6+3+8)*2
=42
21
3 4 6 8
归并方式2
7
WPL=(3+4)*3+6*2+8
=41
13
21
显然采用k叉哈夫曼树的归并方案。采用k叉哈夫曼树的归并方案 最佳归并树。
WPL最小
在内存中归并时,利用败者树减少关键字比较次数
存在的问题(假设k=3):
剩下只有2个归并
段了,怎么办?解决的方法是加虚段(长度为0的段),每次恰好k个段进行归并!
加多少个虚段呢?
应加(k-1)-(m-1) Mod (k-1)个虚段
前面问题的解决方法:加上1个虚段:最佳归并树(m个初始归并段)是带权路径长度最短的k叉(阶)哈夫
曼树,构造步骤如下:
若x=(m-1) Mod (k-1)≠0,则需附加(k-1)-x个虚段,以
使每次归并都可以对应k个段。
按照哈夫曼树的构造原则(权值越小的结点离根结点越远)
构造最佳归并树。
k=2时,x=(m-1) Mod 1=0,所以二路归并(哈夫曼树构造中)不需
要增加虚段【例】 设文件经预处理后,得到长度为
(49,9,35,18,4,12,23,7,21,14,26)
的11个初始归并段,试为4路归并设计一个读写文件次数最少的归并方案
(假如每个记录占用一个物理块)。
各个初始归并段中的记录个数,而非关键字序列初始归并段个数m=11,k=4。x=(m-1) Mod (k-1)=1≠0,因此
需附加:
(k-1)-x=2
个长度为0的虚段。根据集合:
(49,9,35,18,4,12,23, 7,21,14,26,0,0)
构造4阶哈夫曼树。按记录个数递增排序:
(0,0,4,7,9,12,14,18,21,23,26,35,49)
4路最佳归并树的构造过程:
0 0 4 7
9 11 12 14 18 21 23 26
35 46 49 88
218
WPL=(4+7)×3+(9+12+14+18+21+23+26)×2+(35+49)×1=363
最少的读写次数=2×WPL=726次。有4个初始归并段,记录个数分别为2、3、5、8,采用3路归并,最少的读写次数
是多少(假设每个记录读写一次)?
3路最佳归并树如下:
0 2 3 5 8
5
18
WPL=(2+3)×2+(5+8)×1=23
最少的读写次数=2×读次数=46平衡归并树 ≡ 最佳归并树
满足k路平衡归并的前提
例如:
初始归并段个数m=8,每个段的记录数=10,k=2
对应的平衡归并树:
10个记录 10个记录 10个记录 10个记录 10个记录 10个记录 10个记录 10个记录
20个记录 20个记录 20个记录 20个记录
40个记录 40个记录
80个记录
与2路最佳归并树相同。 WPL=8×10×3=240
归并方案设计:
满足k路平衡归并的前提 采用平衡归并树;
否则 采用最佳归并树设有6个有序文件A、B、C、D、E、F,分别含有10、35、40、50、
60和200个数据元素,各文件中元素按升序排序。
要求通过5次两两合并,将6个文件最终合并成一个升序文件。给出文件
读写次数最少的合并过程(假设每个记录读写一次) 。
两两合并 二路归并
最少的合并过程 2路最佳归并树构造2路最佳归并树,归并过程如下:
395
195 200
F
85 110
45 40 50 60
C D E
10 35
WPL=(10+35)×4+(40+50+60)×3+200×1=830。
A B
最少读写次数 = 2×WPL = 1660设有11个初始归并段,它们所包含的记录个数为{25,40,16,38,
77,64,53,88,9,48,98}。试根据它们做4路归并,要求:
(1)指出采用4路平衡归并时总的归并趟数。
(2)给出采用4路平衡归并时的归并过程。
(3)构造最佳归并树。
(4)根据最佳归并树计算每一趟及总的读记录数。(1)采用4路平衡归并时,m=11,k=4,总的归并趟数= log m= log 11=2。
k 4
(2)采用4路平衡归并时的归并过程如下(归并段编号1~11):
1 2 3 4 5 6 7 8 9 10 11
按层的归并顺序 多路平衡归并适合长度相同的归并段(3)构造最佳归并树。
m=11,k=4,(m-1) % (k-1)=1≠0,需要附加k-1-(m-1) % (k-1)=2个
长度为0 的虚归并段,最佳归并树如下。
0 0 9 16
48 53 64 77
25 25 38 40
242
128
88 98
5560 0 9 16
第3趟
第1趟
25 38 40 48 53 64 77
25
128 88 242 98
第2趟
556
第4趟
(4)根据最佳归并树计算每一趟及总的读记录数:
第1趟的读记录数=9+16=25
第2趟的读记录数
=25+25+38+40+48+53+64+77=370
WPL最小
第3趟的读记录数=128+88+242+98=556
总的读记录数=25+370+556=951。谢谢大家