ARTICLE · 1003117
JVM 虚拟线程:从挂载、卸载到后端落地
虚拟线程最容易被误解成一种“更快的线程”。它真正改变的不是 CPU 执行一段 Java 代码的速度,而是等待期间是否必须占住一个操作系统线程。
传统 Java 平台线程通常与操作系统线程一一对应。一个请求在 JDBC、HTTP 或消息队列调用上等待 100 ms,这 100 ms 内平台线程也被占用。线程池可以复用线程,却不能让正在等待的线程同时处理另一个请求。并发继续升高后,线程数量、栈内存和上下文切换会先成为约束。
虚拟线程把这个关系改成 M:N:大量 VirtualThread 由 JVM 调度到少量平台线程上。后者称为载体线程(carrier thread)。虚拟线程执行 Java 代码时挂载到 carrier;遇到 JVM 能识别的阻塞点时卸载,保存执行状态并归还 carrier;条件满足后重新进入调度队列,甚至可以在另一个 carrier 上继续执行。
这让后端服务重新获得 thread-per-request 的顺序代码、完整栈和调试上下文,同时把线程等待的成本降下来。它解决的是高并发 I/O 负载的吞吐扩展问题,不是 CPU 密集计算,也不是单请求延迟优化。JEP 444 对目标的表述很明确:虚拟线程提供 scale,而不是 speed。
线程池为什么会限制 I/O 型服务
对稳定系统,可以用 Little's Law 建立一个粗略模型:
并发中的请求数 ≈ 吞吐率 × 平均响应时间如果一个服务平均响应时间为 100 ms,希望处理 10,000 次请求/秒,就需要大约 1,000 个请求同时在途。假设每个请求从入口到返回始终绑定一个平台线程,系统也需要相近数量的线程。线程池只有 200 个工作线程时,其余请求只能排队;把池扩大到 1,000 又会带来更多 native stack、调度和上下文切换成本。
异步和响应式编程过去通过“等待时归还线程”绕过这个约束,但代价是把连续业务流程拆成回调或阶段。虚拟线程采取另一条路径:仍然保留一个请求对应一条顺序执行路径,只让这条路径与 OS 线程解耦。
因此,虚拟线程最适合同时满足两个条件的负载:
在途任务很多,数量明显高于 CPU 核数; 大部分时间花在网络、数据库、队列、锁等待或 sleep,而不是持续计算。
如果任务一直在压缩、加密、编译或执行复杂规则,增加虚拟线程不会增加 CPU。此时仍应按核数控制并行度,必要时使用专门的平台线程池或并行计算框架。
JVM 内部只需要四个角色
理解实现时,不必先记完整状态机。先抓住四个角色:
VirtualThread 是 Java 语义上的线程,保留线程身份、任务、状态、ThreadLocal 和中断语义。调用 Thread.currentThread() 得到的是它,不是当前 carrier。
Continuation 是可暂停、可恢复的执行体。虚拟线程把业务任务包装在一个定界 continuation 中。暂停成功后,活动栈帧不再要求留在 carrier 的 native stack 上。
调度器 决定哪个 continuation 接下来运行。JDK 21 默认使用一个独立于 ForkJoinPool.commonPool() 的 work-stealing ForkJoinPool,本地队列工作在 FIFO 模式;默认并行度等于 JVM 看到的可用处理器数。这个实现细节可在 JDK 21 的 VirtualThread.createDefaultScheduler() 中核对。
carrier 是普通平台线程,也是 OS 实际调度的线程。虚拟线程只有在运行 Java 代码时才临时占用 carrier,生命周期内没有固定亲和性。
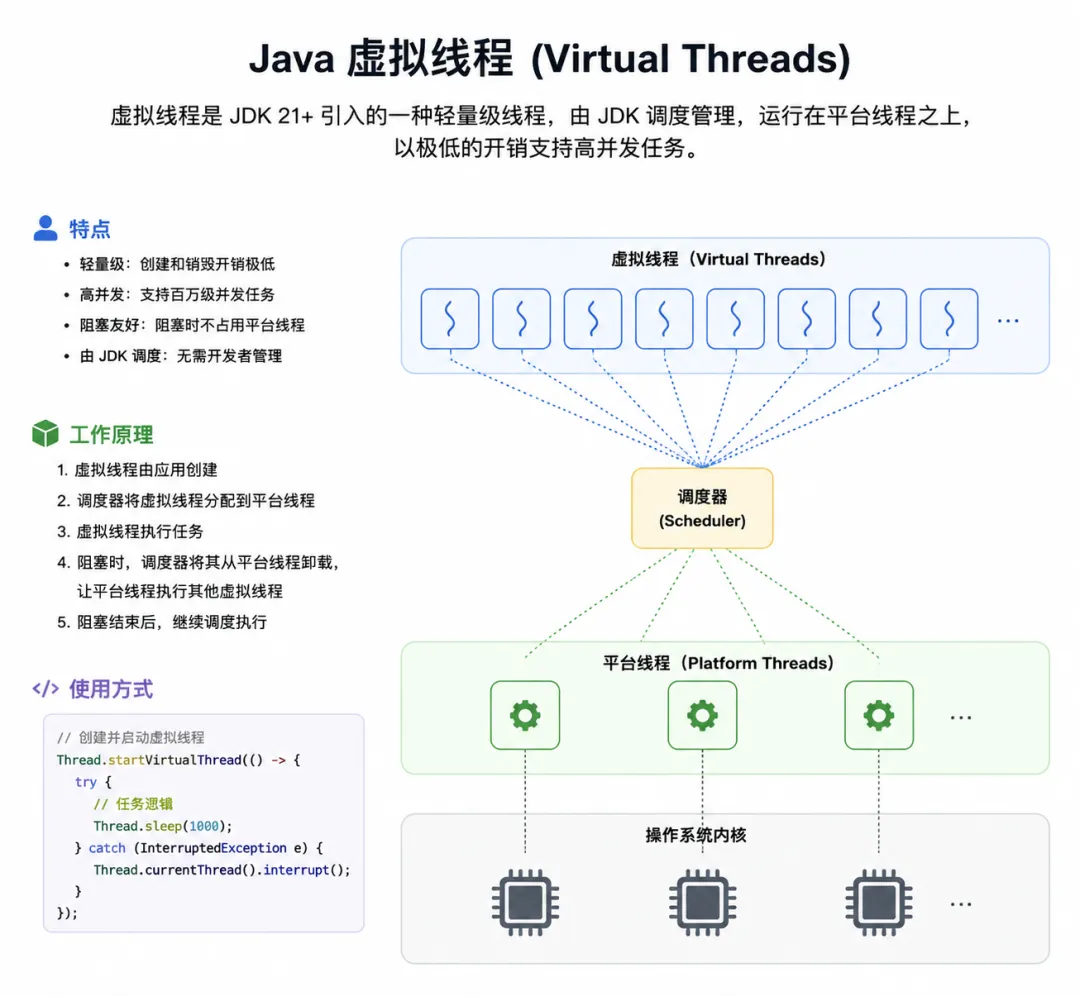
这张图只表达一个结论:虚拟线程的数量可以远大于 carrier;只有正在运行的虚拟线程需要挂载,等待中的虚拟线程不占 carrier。
从源码看一次挂载、卸载和恢复
JDK 21 的 VirtualThread 同时持有 scheduler、Continuation cont、runContinuation 和一个显式 state。源码注释列出了完整状态机。对后端工程师而言,阻塞路径可以压缩成下面四步:运行、卸载等待、重新入队、恢复运行。
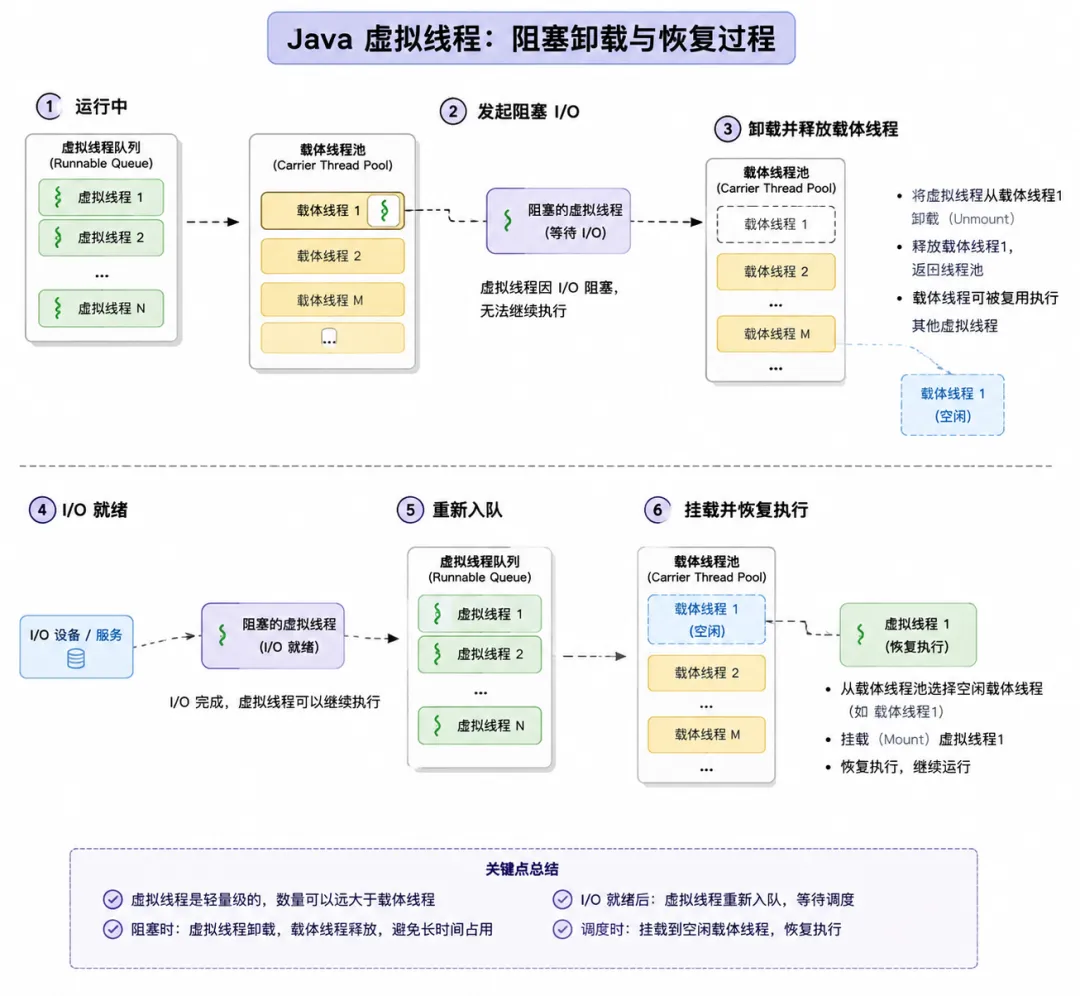
图中最重要的状态是 PARKED:Continuation 的执行栈已经保存在堆中,carrier 此时可以执行其他虚拟线程。恢复时没有 carrier 亲和性,因此前后两次运行可能位于不同的平台线程。
一条虚拟线程大致经历下面的过程:
start()把 runContinuation提交给 scheduler。它没有为任务新建一个长期独占的 OS 线程。carrier 从调度队列取得任务并调用 runContinuation()。mount()建立虚拟线程与当前 carrier 的临时关联,并把 carrier 视角中的 current thread 切换为虚拟线程。业务代码运行。遇到 LockSupport.park()、支持虚拟线程的阻塞队列或网络 I/O 时,JDK 最终尝试执行 Continuation.yield(VTHREAD_SCOPE)。yield 成功后,虚拟线程卸载,状态进入 PARKED。carrier 返回调度器,可以立即挂载其他虚拟线程。I/O 完成、超时、中断或 unpark()使等待条件成立。虚拟线程变为可运行并重新提交给 scheduler。任意可用 carrier 再次执行 runContinuation(),恢复 continuation,业务代码从原阻塞调用之后继续。
park/unpark 仍遵守 LockSupport 的单许可语义:许可最多一个,unpark 可以先于 park 发生,调用方仍必须在循环中重新检查业务条件。虚拟线程没有改变并发原语的正确用法,只改变了等待时的资源占用方式。
栈没有消失,只是换了存放位置
异步流水线通常把跨等待点的数据放进一系列堆对象。虚拟线程仍让开发者使用局部变量和普通调用栈,但未挂载时,栈帧以 StackChunk 链的形式位于 GC 管理的 Java 堆中。JDK 21 的 Continuation 通过 tail 引用这条链,并由 JVM intrinsic 完成 yield 和恢复。
这带来三个实际结论:
虚拟线程不是“没有栈”,而是栈按需增长和收缩,不再为每条线程长期绑定固定大小的 native stack; 创建大量虚拟线程仍会消耗 Thread对象、栈块、任务对象和业务上下文,不能把它们视为零成本;每条虚拟线程都支持 ThreadLocal,但线程数量上升后,每线程缓存的总内存会被放大。不要再用 ThreadLocal 给线程池工作线程缓存数据库连接、大缓冲区等昂贵资源。
载体线程的 ThreadLocal 与虚拟线程隔离。即使同一个虚拟线程恢复到了另一个 carrier,业务代码看到的线程身份和 ThreadLocal 语义仍属于虚拟线程。
阻塞不等于任何调用都能自动卸载
“可以继续写阻塞代码”有一个前提:阻塞点必须能与 JVM 的 park/unpark 或可中断 I/O 机制协作。JDK 的 socket、NIO channel、BlockingQueue、Semaphore、ReentrantLock 等常用 API 已经适配。它们等待时通常可以卸载虚拟线程。
但如果代码进入 native 方法后直接阻塞,JVM 未必能把执行状态安全地从 carrier 上移走。文件系统操作、第三方 JNI 库、FFM 调用和旧驱动都需要按实际版本和实现验证。迁移测试不能只看功能正确,还要看 carrier 是否持续被占用。
另一个容易遗漏的事实是:默认虚拟线程调度器当前不对虚拟线程做时间片抢占。一个长时间占用 CPU、没有阻塞点的虚拟线程会一直占用 carrier,直到它结束或主动让出。因此,CPU 密集任务混入同一执行路径时,延迟尾部仍可能恶化。
synchronized 固定问题必须按 JDK 版本讨论
固定(pinning)是指虚拟线程阻塞时无法从 carrier 卸载,结果连同底层 OS 线程一起等待。固定不会改变程序正确性,但高频、长时间固定会抵消虚拟线程的扩展收益。
synchronized/monitor | |||
|---|---|---|---|
ReentrantLock,不要机械替换所有 synchronized | |||
Object.wait() 可以卸载 |
JDK 24 的 VirtualThread 已出现 BLOCKED、WAIT、UNBLOCKED 等可卸载状态和重新提交逻辑。与此同时,-Djdk.tracePinnedThreads 在 JDK 24 被移除,设置后不再产生旧版诊断输出。跨版本运维脚本必须同步调整。
正确的使用单位是任务,不是虚拟线程池
Java 21 最直接的入口是 Executors.newVirtualThreadPerTaskExecutor()。它为每个提交任务创建一条新虚拟线程,而不是复用固定数量的虚拟线程。
下面的例子并行调用两个下游,同时用 Semaphore 限制对库存服务的并发。示例中的 executor 表示一个明确的任务作用域;在 Web 应用中,也可以由容器或应用生命周期统一管理。
final class ProductFacade { private final HttpClient http = HttpClient.newHttpClient(); private final Semaphore inventorySlots = new Semaphore(100); ProductView load(String productId) throws Exception { try (var executor = Executors.newVirtualThreadPerTaskExecutor()) { Future<Product> product = executor.submit( () -> fetchProduct(productId)); Future<Inventory> inventory = executor.submit(() -> { inventorySlots.acquire(); try { return fetchInventory(productId); } finally { inventorySlots.release(); } }); return new ProductView(product.get(), inventory.get()); } } // fetchProduct/fetchInventory 使用阻塞 HttpClient.send(...)。}虚拟线程很便宜,不代表下游容量也变得无限。数据库连接池可能只有 50 个连接,库存服务可能只允许 100 个并发请求,进程仍受文件描述符、堆内存和 socket 数限制。过去固定线程池同时承担“复用昂贵线程”和“限制并发”两个职责;迁移后应把这两个问题拆开:
任务执行使用每任务一条虚拟线程; 数据库连接继续由连接池限制; 下游并发用 Semaphore、bulkhead 或客户端连接上限控制;入口用队列上限、超时和拒绝策略建立背压; CPU 密集阶段使用有界并行度。
如果只是把 newFixedThreadPool(200) 改成无界提交虚拟线程,却没有这些容量边界,原来的线程池队列会消失,压力可能更快地传递到数据库和下游服务。
生产诊断要从“线程数量”转向“等待原因”
传统 jstack 的平铺输出不适合展示几十万条虚拟线程。JDK 21 提供了新的线程转储命令,可输出文本或 JSON:
jcmd <pid> Thread.dump_to_file -format=json /tmp/threads.jsonJFR 可以把事件关联到虚拟线程。Java 21-23 迁移时重点关注 jdk.VirtualThreadPinned;jdk.VirtualThreadSubmitFailed 用于发现调度提交失败;线程 start/end 事件默认关闭,避免在高创建率下产生不必要数据。JDK 24 仍保留 pinned 事件,用于报告剩余固定原因和 carrier 信息。
监控面板也需要调整。OS 看到的是平台线程,不会看到全部虚拟线程;仅观察 native thread 数量无法判断请求并发。更有价值的指标包括:
在途请求数、虚拟线程状态和等待原因; carrier CPU 使用率与 runnable queue; 下游连接池等待、Semaphore 等待和超时; 固定事件的次数、持续时间、栈和 JDK 版本; 堆占用、分配速率和 ThreadLocal 使用; P50/P95/P99 延迟以及拒绝、取消和中断是否有效。
迁移应是一项负载实验
虚拟线程与现有 Thread API 兼容度很高,但生产迁移仍应按负载实验推进:
选择 I/O 等待占比高、请求相互独立的接口作为试点,不先碰 CPU 密集批处理。 盘点线程池的真实职责:执行任务、保护下游、隔离故障还是缓存每线程资源。 替换执行模型,同时把容量限制迁移到连接池、Semaphore、入口限流和超时。 检查 JNI/FFM、旧驱动、文件 I/O、ThreadLocal 和长临界区;根据运行 JDK 版本选择固定诊断方式。 用同一到达率和请求分布比较平台线程与虚拟线程,观察吞吐、尾延迟、CPU、堆、下游饱和与取消行为。 逐步放量。只有在业务瓶颈确实从“可用线程”转移后,虚拟线程的收益才成立。
结论
虚拟线程的核心不是一个新的并发语法,而是 JVM 对 Thread 的重新实现:任务仍拥有连续调用栈和线程语义,但只在运行时临时挂载到 OS 线程;等待时,Continuation 把执行状态留在堆中并释放 carrier;条件满足后再由调度器恢复。
这套机制让阻塞式后端代码获得接近异步模型的线程利用率,同时保留顺序代码、栈追踪和调试体验。它不会增加 CPU,不会扩容数据库,也不会替代背压。把虚拟线程用好,关键不是创建尽可能多的线程,而是明确区分三种容量:任务并发可以很大,CPU 并行度受核数约束,下游资源必须继续有界。
资料来源
JEP 444: Virtual Threads JEP 491: Synchronize Virtual Threads without Pinning OpenJDK JDK 21 GA: VirtualThread.java OpenJDK JDK 21 GA: Continuation.java OpenJDK JDK 24 GA: VirtualThread.java Java SE 21: Thread virtual threads Java SE 21: Executors.newVirtualThreadPerTaskExecutor Java SE 21: LockSupport