ARTICLE · 1012752
DSH(06) “一切皆插件”之后,谁为生产负责:Agent Harness 的外部副作用、版本与审计边界
前面五篇文章讨论了插件化、生命周期、动态依赖、运行时 Context,以及 Loop、任务图和组件图的边界。
按照前几篇建立的设计,这类 Agent Runtime 需要能够在任务执行过程中加载插件、替换依赖、隔离能力,并在条件变化后暂停或恢复任务。
但系统进入生产环境后,还有一个更难的问题:
插件可以卸载,外部动作留下的后果怎么办?能力可以替换,旧版本产生的结果还能不能相信?Agent说任务已经完成,谁来证明它真的完成了?
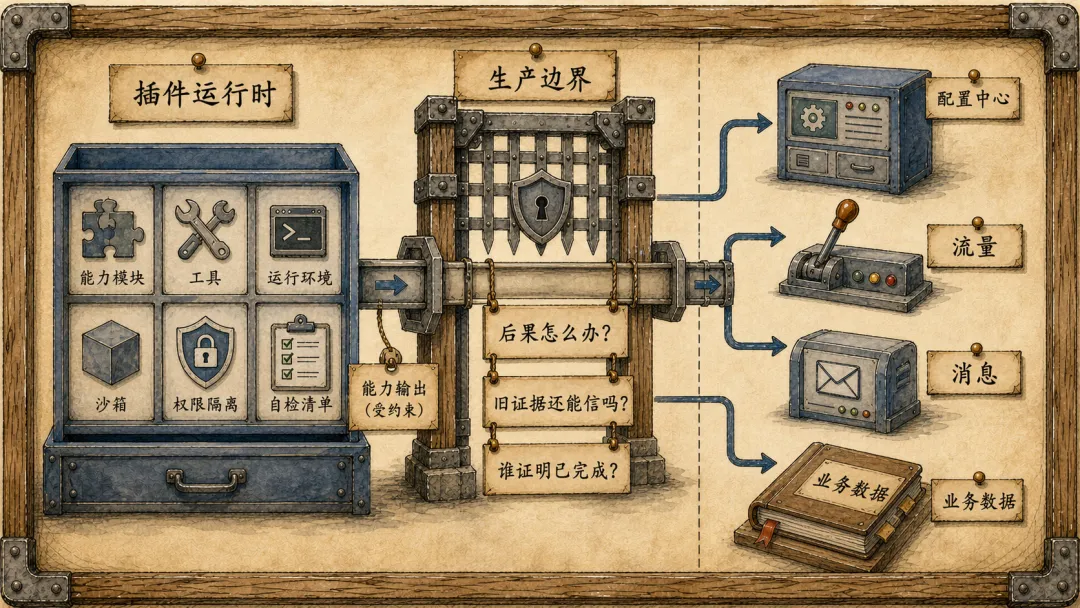
这也是“一切皆插件”之后必须补上的生产边界。
插件运行时可以管理能力如何进入和退出,却不能独自承担所有生产责任。外部副作用需要动作契约,版本变化需要影响分析,任务完成需要独立证据。三者缺少任何一个,运行时越灵活,生产风险反而越难控制。
先说结论:可组合运行时不是生产责任的终点
一个生产级 Agent 系统,至少要区分运行时、动作和证据三类责任。
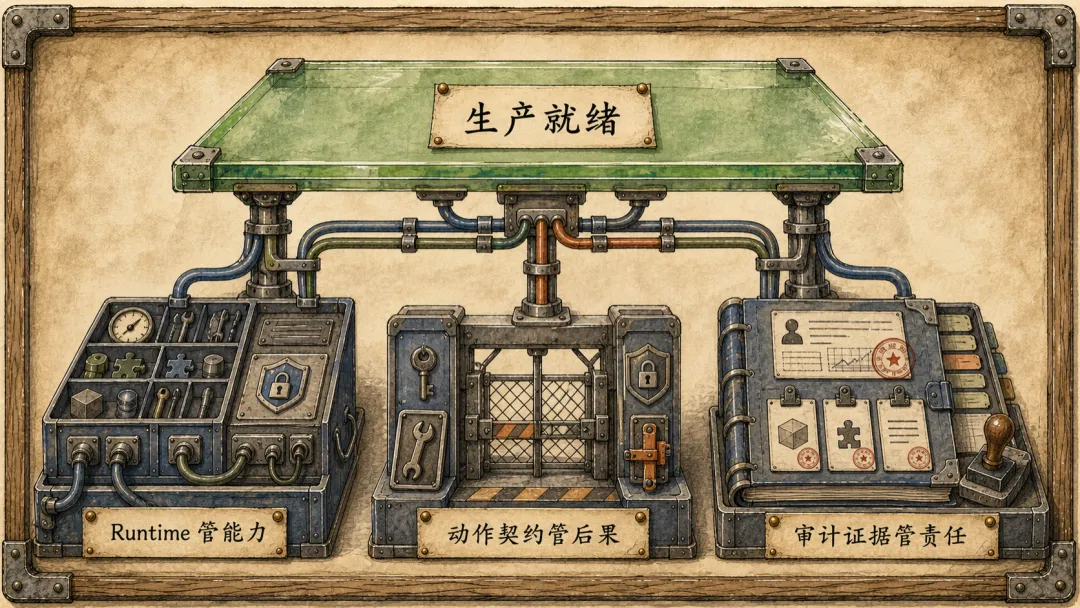
可以把它概括为:
Runtime管能力;动作契约管后果;审计证据管责任。
插件数量、工具调用次数和自动化程度,都不能证明一个 Agent 已经生产就绪。真正重要的是:每一次能力装配、外部执行和状态变化,都能被解释、约束和复核。
从“增加登录限流”走到生产,问题就不再只是写代码
继续沿用前面的案例:为登录接口增加限流。
在开发阶段,Agent 可以修改代码、执行构建、运行测试。即使任务失败,多数影响仍然被限制在工作区和测试沙箱内。
但进入发布阶段后,链路会变成:
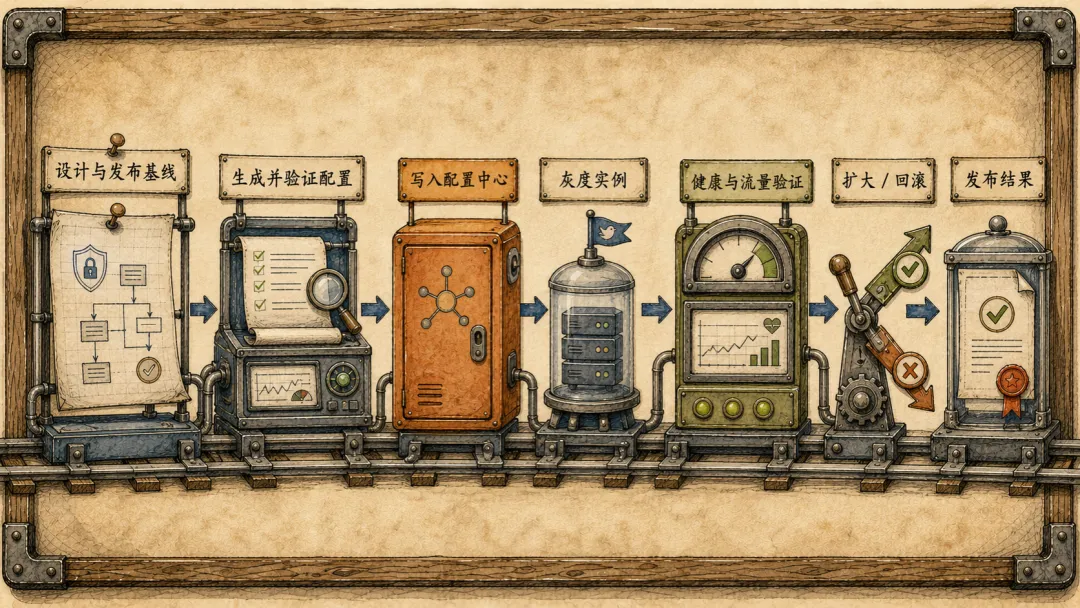
这时,插件被安全卸载,并不代表生产状态已经恢复。
配置可能已经写入,灰度流量可能已经切换,告警可能已经触发,发布消息也可能已经发送。即使运行时清理了临时文件、连接、监听器和工具注册,这些外部后果仍然存在。
因此:
运行时可逆,不等于业务后果可逆。
这不是插件机制的缺陷,而是它本来就不应该独自解决的问题。
先把副作用分清楚,再讨论怎样恢复
“可逆副作用”很容易被理解成“所有动作都能回滚”。真实系统里,不同副作用的处理方式并不相同。
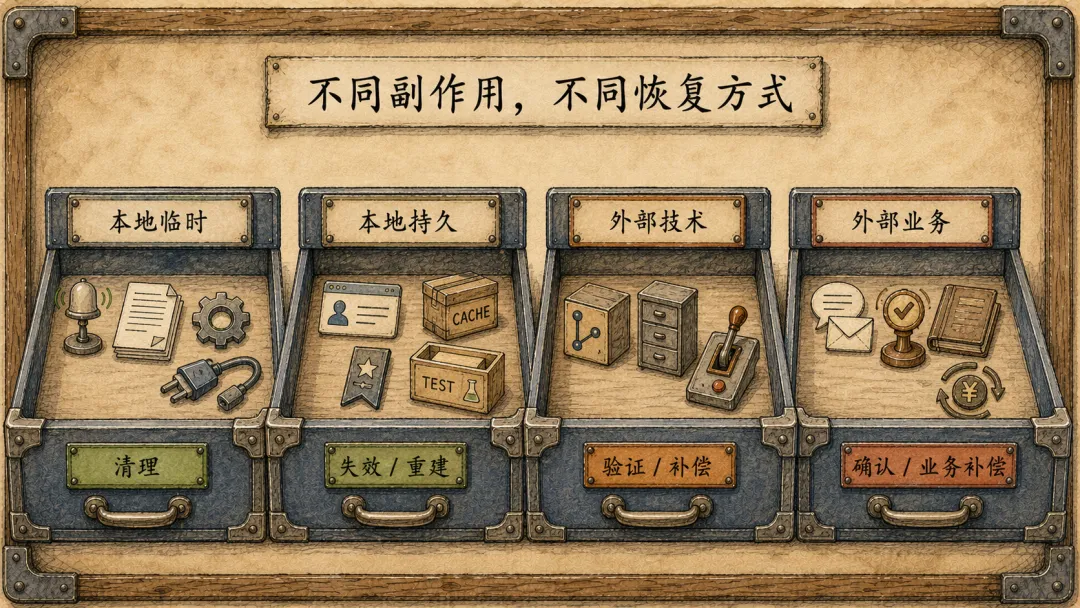
本地临时副作用通常可以撤销,外部动作却可能只能补偿。例如,恢复旧配置不能抹去新配置生效期间已经处理的请求,撤销数据库更新也未必能自动撤销已触发的下游流程。
所以,运行时不能只调用一个 dispose(),就假设生产后果已经处理完毕。它负责清理组件留下的本地资源;任务图则根据外部动作状态,进入验证、补偿、人工确认或阻塞流程。
外部动作需要契约,不能只是一个工具定义
工具定义通常回答:叫什么、接收什么参数、返回什么结果。
生产动作还需要回答:谁可以执行、在什么前提下执行、会产生什么后果、怎样证明成功,以及失败后如何处理。
例如,发布限流配置的动作契约可以包含:
action: rate-limit-config.publishtarget: production/config-centerpreconditions:- design-baseline-approved- regression-tests-passedeffect_class: external-compensatablepermission: release-operatorapproval: requiredidempotency_key:"${task_id}:${config_version}"success_evidence:- config-center-receipt- canary-health-check- traffic-policy-verificationcompensation:action: rate-limit-config.restoreinput: previous-config-version
这段示意的重点不在字段名称,而在于外部动作必须显式声明五件事:
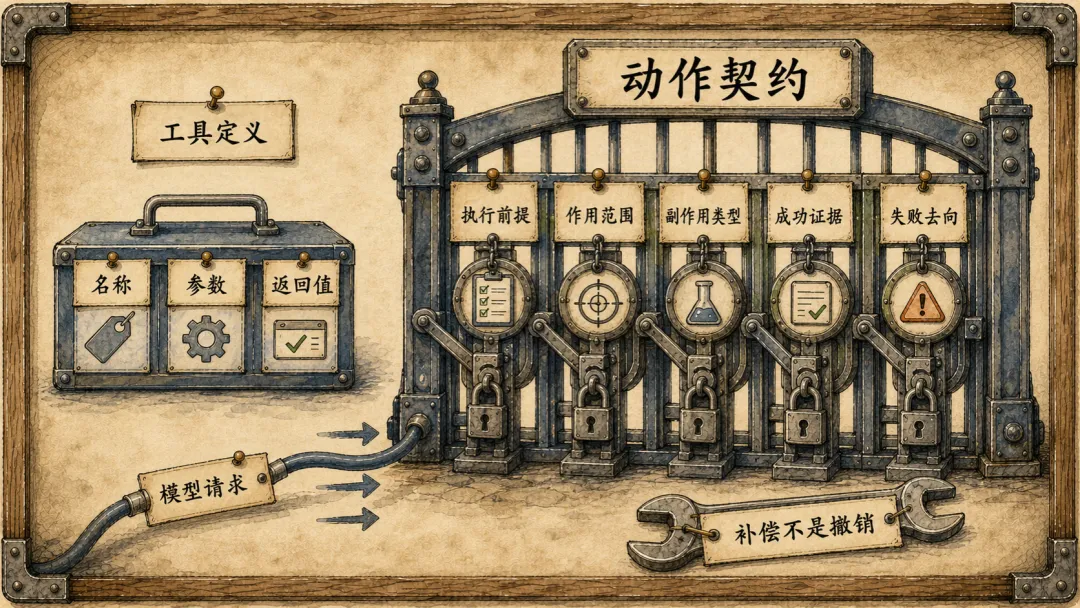
这里的补偿是一次新的纠正动作,不代表已经发生的外部影响被完全撤销。
动作契约不是把自然语言 Prompt 写得更长,而是把约束落到模型无法绕过的调用链上。权限系统、动作网关、外部业务系统和审计系统,都应执行自己的硬约束。
接口名字相同,不代表还是同一个生产能力
第三篇关注的是依赖变化后,运行时怎样重新绑定能力、冻结受影响任务并决定是否重跑。进入生产治理后,还要继续回答:某次已发生的外部动作,到底使用了哪一个经批准的能力版本,旧证据还能否支撑当前的责任判断。
一次实际能力绑定,至少需要能够追溯:
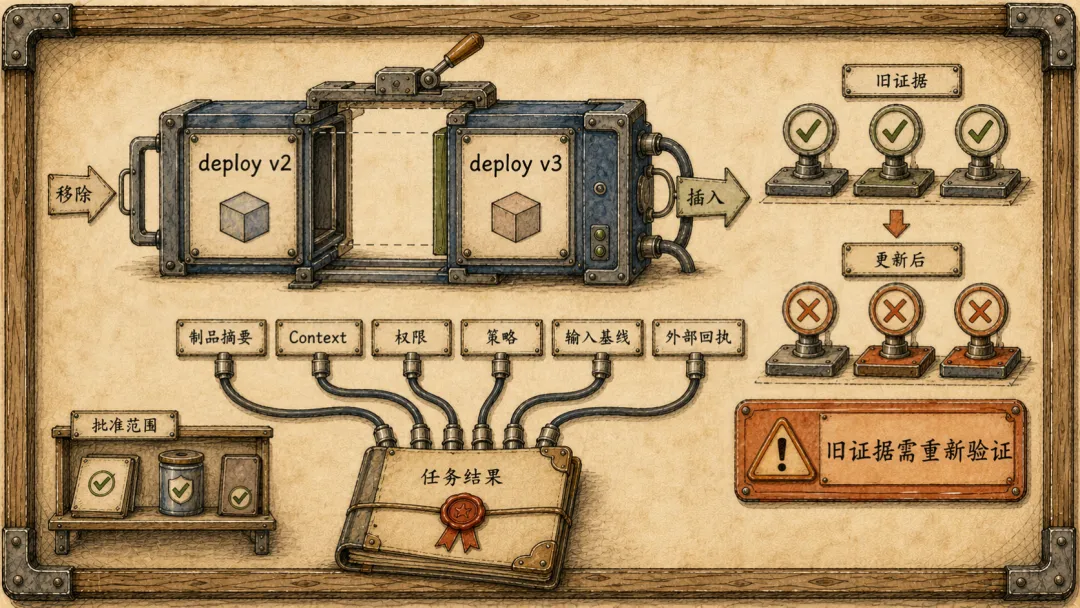
例如, deploy.execute-v2 和 deploy.execute-v3 可能提供相同的调用接口,但审批规则、目标环境、回滚策略或证据格式已经变化。接口兼容只说明调用可能仍然成立,不能证明旧版本的测试和发布证据仍然有效。
更准确的关系应该是:
任务结果->绑定实际插件版本与制品摘要->绑定当时的权限、环境和策略->绑定输入基线与外部执行回执
任何一项发生变化,都要根据影响范围决定是否重新验证。版本治理的目标不是阻止升级,而是避免系统在能力已经变化后,继续沿用旧结果和旧责任判断。
生产环境也不应该允许 Agent 从任意来源临时发现并加载插件。第一阶段至少需要批准清单、固定来源、版本约束和兼容性验证。动态组合只能发生在已经授权的候选能力范围内。
Agent 的“已完成”不是审计证据
Agent 很容易在最终回复中写出:
配置已发布,灰度验证通过,任务完成。
这只是一段结论,不是证据。
模型可能误读日志,工具可能只完成了部分操作,网络超时也可能让 Agent 不知道外部系统是否已经接收请求。真正可复核的证据,应来自独立工具链和外部系统回执,而不是由 Agent 自己生成一句“通过”。
一次生产动作至少需要留下三类记录:
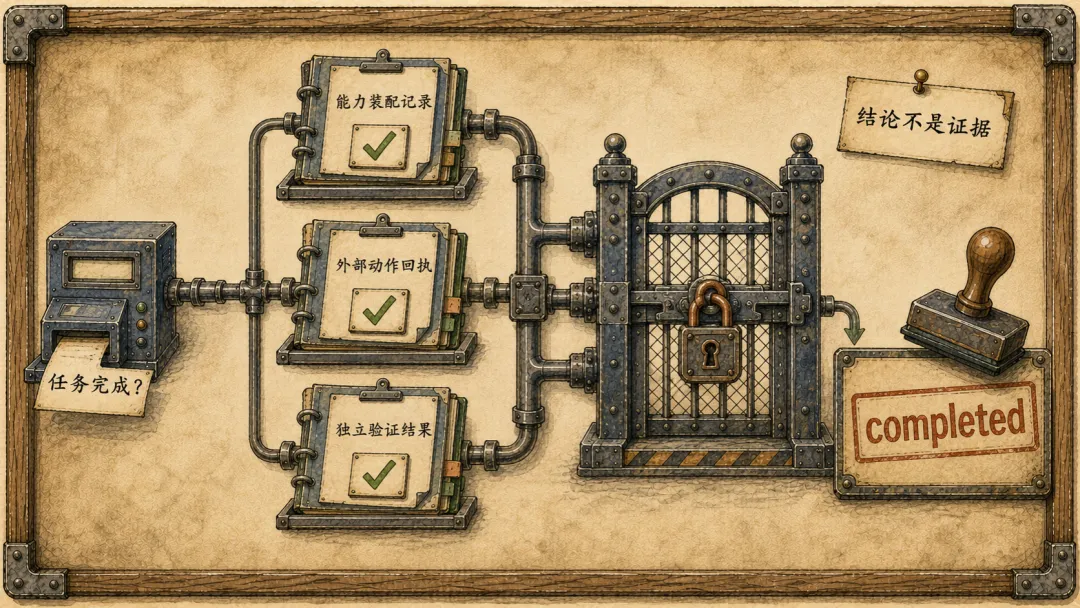
审计也不等于把所有 Prompt 和日志堆在一起。日志可以帮助排查,但审计需要稳定的关联关系:一次任务、一次能力绑定、一次外部动作、一次审批和一组验证证据,必须能够互相定位。
最终的 completed 应由受控规则根据证据得出,而不是由模型自由声明。
最危险的情况,不是明确失败,而是结果未知
继续看配置发布。Agent 发出请求后连接超时,它无法确定配置中心是否已经执行成功。
这时直接重试,可能重复触发发布;直接判定失败,可能在生产配置已经变化后继续使用旧假设;直接标记完成,又没有足够证据。
更合理的处理是:
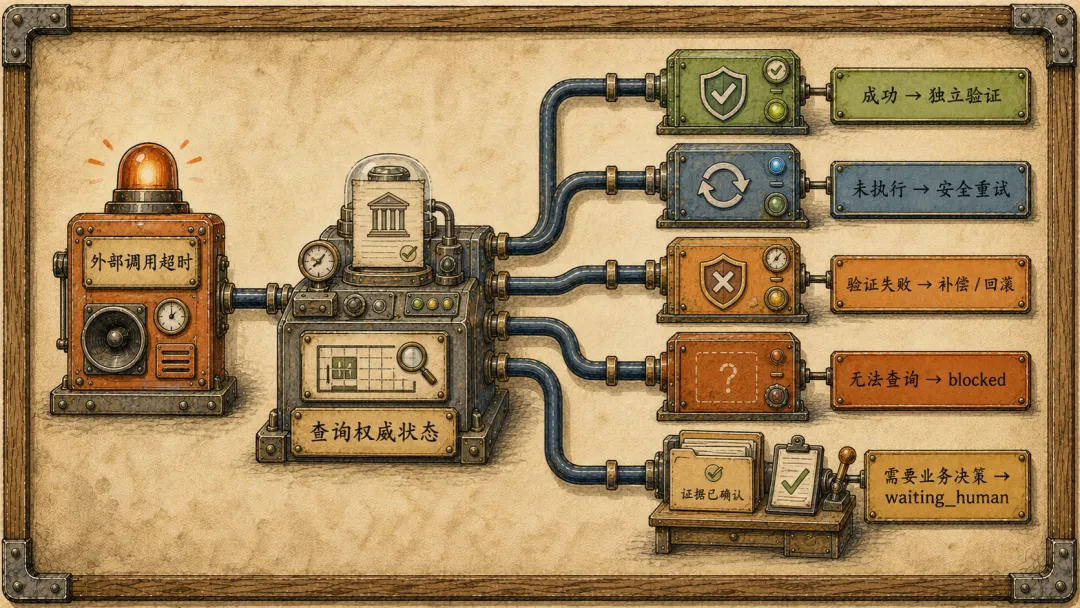
blocked 不是系统无能,而是系统明确知道当前证据不足,不能继续自动推进。
waiting_human 也不是自动化失败。高风险动作、不可逆后果和例外处置,本来就需要责任人做出判断。
最危险的反而是 Agent 为了保持流程顺畅,把“未知”解释成“应该没问题”。
谁为生产负责,必须在架构上说清楚
“人最终负责”是一句正确但不够完整的话。如果系统没有把责任落实到具体边界,人也很难知道自己在批准什么。
一个可控的责任分工可以这样理解:
这里没有一个“万能主 Agent”承担全部责任。责任被拆到真正拥有控制力和事实来源的位置,Agent 负责在这些边界内组织执行。
第一阶段,只验证一类真实外部动作
不需要一开始就建设插件市场、全量供应链平台和复杂审计中心。
可以先在测试环境验证机制,但这只能证明链路能够运行,不是生产就绪证据。随后再选择一个影响明确、能够补偿的低风险生产动作,例如更新一项可回滚的灰度策略,完成下面的最小闭环:
- 固定经过批准的插件来源、版本和制品摘要;
- 声明动作前提、权限、作用范围、副作用类型和补偿方式;
- 通过动作网关执行鉴权、幂等控制并获取外部回执;
- 将实际能力绑定、输入基线、审批和验证结果关联到同一次任务;
- 由独立工具验证外部状态,不接受 Agent 自述作为完成证据;
- 验证三条异常路径:插件中途退出、调用超时但外部可能已成功、版本变化导致旧证据失效。
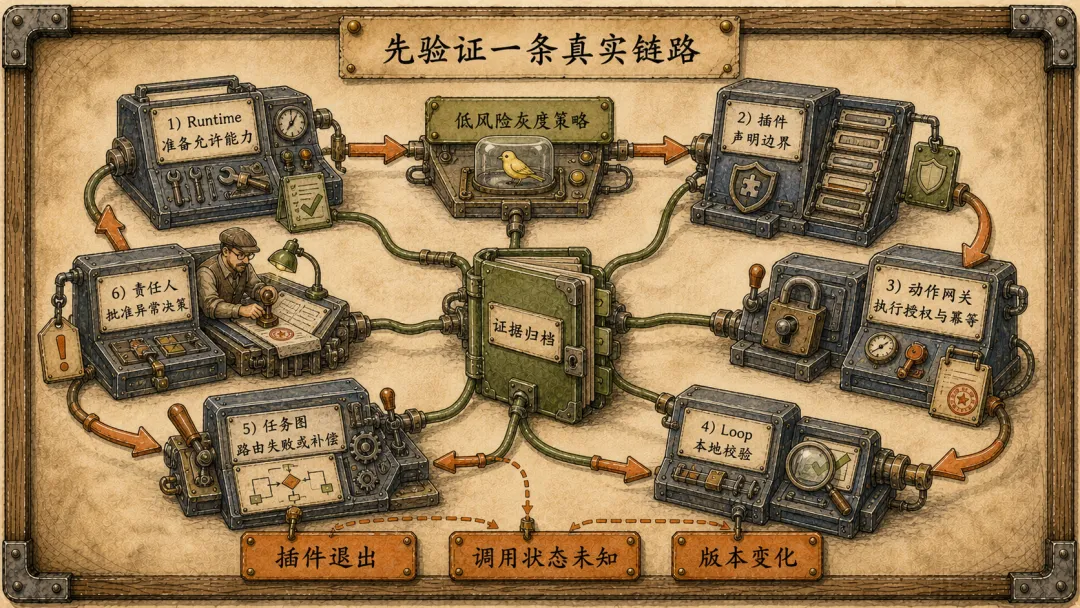
先证明系统在外部后果已经产生、执行状态不确定或能力版本发生变化时,能够停下来、查清事实并按边界恢复,再扩大 Agent 可以执行的生产动作范围。
小结
“一切皆插件”让 Agent Runtime 获得了组合、替换和演进能力,但灵活性本身不等于生产能力。
本地副作用由运行时清理;外部副作用由动作契约约束;版本变化通过实际绑定和影响分析治理;任务完成由独立证据证明;无法确认的状态进入等待、阻塞或补偿流程。
生产就绪的关键,不是 Agent 能调用多少插件,而是每一次能力装配、执行和变化都可解释、可追溯、可验证,并且在超出自动化边界时能够明确停下来。
到这里,这组文章从“为什么需要可组合运行时”,走到了“可组合之后如何承担生产责任”。Harness、Loop、任务图、组件运行时和审计机制各自解决不同问题,只有边界清楚地组合在一起,Agent 才能从一个灵活的执行框架,走向真正受控的生产系统。