ARTICLE · 1015140
AI写影像报告真的省时间吗?101项研究揭示效果、安全与工作流真相
LLM、多模态LLM和视觉语言基础模型已开始生成影像、病理和内镜报告,但是否安全、是否真正减轻医生工作量仍缺少统一证据。
综述检索至2026年5月15日,纳入101项同行评议研究,按有效性、安全性和工作流负担评估,并区分自主生成、人机协作起草和编辑/结构化支持。
没有研究被评为低偏倚风险,也没有主要结局可以Meta分析。部分场景提高专家接受度或缩短阅读时间,但遗漏、幻觉和额外编辑负担仍存在。
这篇综述评估的是临床能不能用
医学影像报告生成过去常用BLEU、ROUGE、CIDEr、BERTScore等文本相似度指标评价,但一份语言流畅、与参考报告相似的文本,仍可能漏掉重要异常、加入不存在的发现,或增加医生修改成本。
作者因此把主要结局分成三类:有效性看专家接受率和盲法偏好;安全性看临床重要错误、遗漏错误和新增错误,其中遗漏指漏掉临床相关发现,新增错误指报告加入缺乏依据或幻觉式内容;工作流负担看报告时间、修改次数、编辑距离和编辑负担。
研究还把AI在工作流中的角色分开:自主生成是模型先独立生成报告,再由医生评价;人机协作起草是医生在写报告过程中使用AI文本;编辑或结构化支持则发生在已有检查所见、报告草稿或原始文本之后。作者没有把这三类任务视为等价干预,因为医生参与程度和错误传播方式不同。
101项研究主要集中在胸片和自主报告生成
检索覆盖PubMed/MEDLINE、Embase、Web of Science、Scopus和Cochrane Library,时间范围为2016年1月1日至2026年5月15日,并补充Europe PMC、OpenAlex和参考文献追溯。初始检索获得6,936条记录,最终纳入101项研究。
其中68项为回顾性或技术验证研究,28项为非随机比较、读片者或工作流研究,只有5项属于前瞻性、真实世界工作流或验证研究。
胸片是最大模态组,共36项;混合模态20项;CT、CTA或PET/CT共11项;MRI 10项;超声6项;内镜5项;病理5项。任务方面,61项直接由图像生成报告,29项进行报告起草或结构化,11项根据已有所见或报告生成诊断印象。66项研究属于自主生成,15项属于人机协作起草,20项用于编辑或结构化支持。
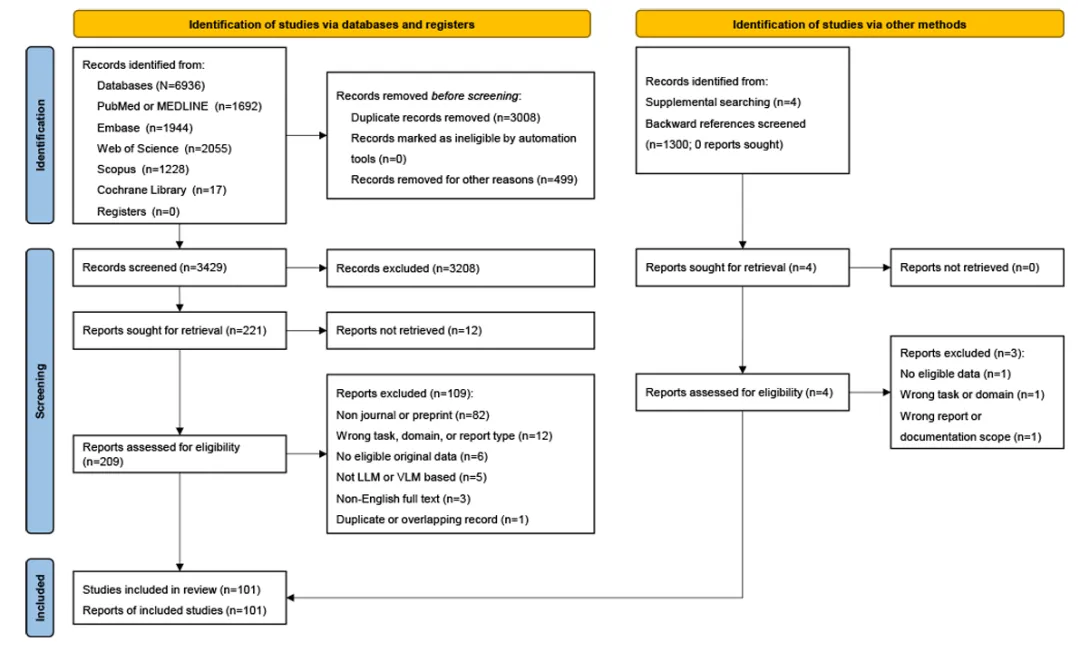
图2|研究筛选流程(原文Figure 1):数据库检索、去重、全文评估及最终纳入101项研究。
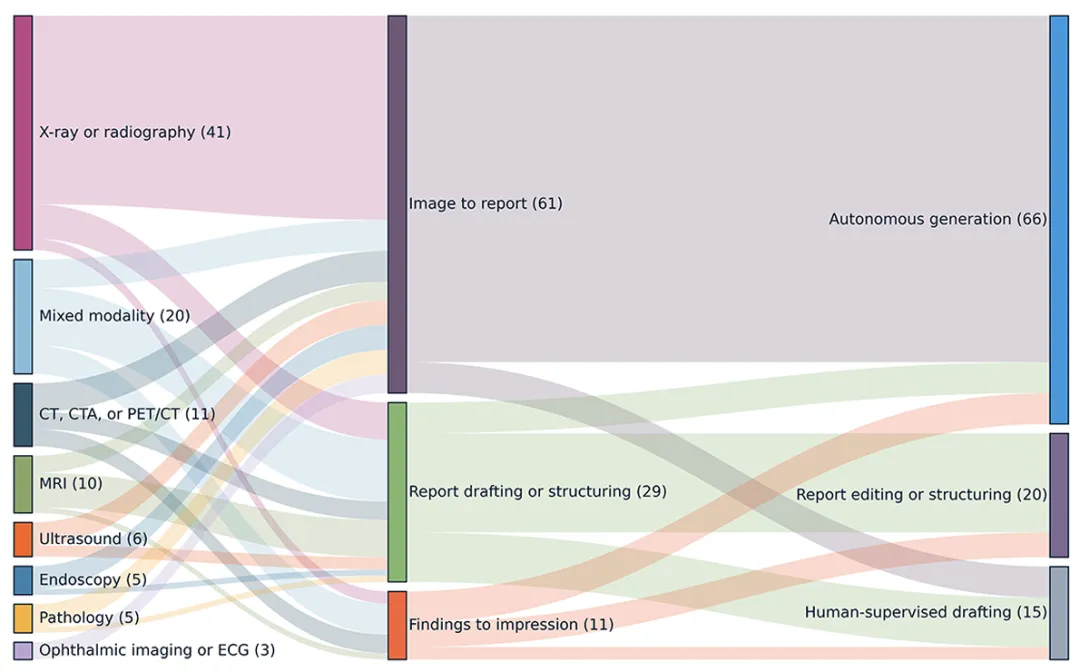
图3|模态、生成任务和AI角色的对应关系(原文Figure 2):证据主要集中在胸片、图像到报告和自主生成流程。
研究数量增长很快,但临床结局报告仍不统一
论文显示,2023年后相关研究快速增加,但评价仍明显偏向自动化文本指标。101项研究中,只有36项至少报告了一项临床相关的人类评价、安全性、工作流、报告质量、接受度或时间指标;作者最终从中选出21项具有较清晰临床可解释结局的研究用于核心证据总结。
这种不平衡直接限制了证据合并。不同研究使用的任务、输入、比较对象、医生参与方式、病例单位和统计分母差别很大。有的按患者计算,有的按报告计算,有的按“读片者-病例”重复评分计算;安全结局也常以不同阈值、不同定义或不可重建的形式呈现。
因此没有任何预设的有效性、安全性或工作流结局满足Meta分析条件。问题是至少两项研究都找不到足够一致的定义、任务结构和可分析数据来形成可靠的合并效应量。
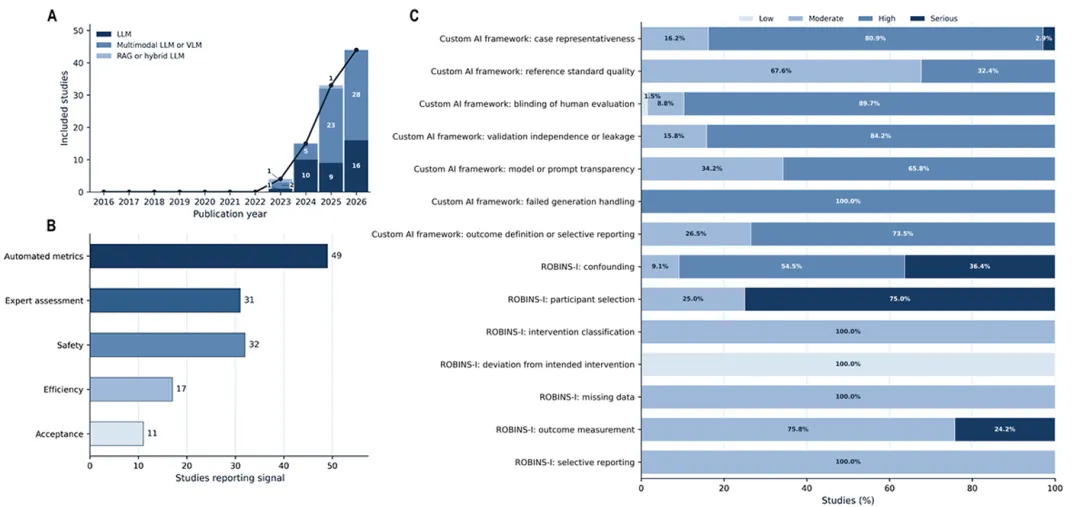
图4|研究增长、评价信号与偏倚风险(原文Figure 3):研究数量快速上升,但临床安全和工作流指标报告不足,多个偏倚领域风险较高。
专家愿意接受AI报告,不等于报告已经足够安全
一项大规模胸片研究中,AI生成初步报告的接受率为70.5%(6,047/8,580),放射科医生报告为73.3%(6,288/8,580),两者接近。但AI报告的假阴性评分为18.5%,放射科医生报告为17.8%;假阳性评分也略高于人工报告。
另一项医生与视觉语言模型协作的胸片研究中,在两个数据集上,AI报告被评为“等同或优于医生报告”的比例分别为77.7%(233/300)和56.1%(170/303)。这些结果支持AI文本在部分受监督场景中具有可接受性,但同一研究仍观察到临床重要错误。
这也是作者反复强调的区分:专家偏好、可读性或语言自然度不能替代病例级安全评价。报告看起来合理,并不能证明其中没有关键遗漏、无依据新增内容或生成失败。
AI有时能省时间,也可能把时间转移到修改环节
工作流结果没有出现一致方向。一项脑MRI读片研究中,AI辅助将平均阅读时间从61秒降至53秒,并改善了诊断表现,初级放射科医生获益更明显。
另一项放射学诊断印象起草研究得到相反结果:模型生成草稿后,医生平均编辑时间从12.20秒增加到18.29秒,平均修改词数从5.74增加到12.32。AI虽然提前生成了文本,但医生需要投入更多时间核查和修改。
因此“生成更快”与“完成最终报告更快”不是同一个终点。真正决定工作流价值的是AI进入哪一个环节、医生还需要核对多少内容,以及最终报告是否减少了总劳动量。
当前证据质量不足以支持自主替代医生
101项研究中,没有一项被评为低偏倚风险;15项为中等风险,72项为高风险,14项为严重风险。常见问题包括回顾性病例选择、缺乏独立外部验证、读片者未充分盲法、训练和测试边界不清、提示词和模型处理不透明,以及生成失败未完整报告。
在作者针对68项技术验证研究使用的AI验证框架中,生成失败处理是最突出的问题:66项被评为高风险,另外2项为严重风险。GRADE框架下,专家接受度、盲法偏好、安全性和工作流负担四类临床重要结局的证据确定性均为“极低”。
作者给出的临床定位很明确:现阶段LLM报告系统更适合作为医生监督下的辅助工具。真正进入临床前,需要在本地病例、本地报告模板、本地医生审核流程和实际IT环境中重新验证,并同时报告遗漏、新增错误、生成失败、修改负担和最终报告质量。
小结
这篇系统综述把医学报告生成的评价重点从“模型能不能写出像样的报告”转向“报告是否安全、医生是否愿意使用、最终工作量是否下降”。101项研究说明LLM和视觉语言模型已经能够进入多种影像报告任务,但现有证据仍以回顾性和技术验证为主,临床结局定义高度不统一。
目前最合理的应用方式仍是受监督辅助:AI可以起草、结构化或提供初步报告,医生负责核查和定稿。下一阶段的关键不再只是提高BLEU或ROUGE,而是用病例级、可重建、可比较的安全和工作流终点评价实际临床价值。
原文信息
Title:Effectiveness, Safety, and Workflow Burden of Large Language Model–Based Medical Report Generation: Systematic ReviewJournal:Journal of Medical Internet ResearchPublished:2026年9月9日Authors:Jie-Lin Huang, Ji-Qing Zhu, Xiao-Guang NiDOI:10.2196/97007Article type:Systematic ReviewStudy design:系统综述;遵循PRISMA 2020、PRISMA-S和SWiM;未进行Meta分析
研究团队
研究由中国医学科学院肿瘤医院/国家癌症中心内镜科完成,作者为Jie-Lin Huang、Ji-Qing Zhu和Xiao-Guang Ni,通讯作者为Xiao-Guang Ni。研究聚焦医学报告生成的临床有效性、安全性与工作流评价。