ARTICLE · 1023312
AI时代,嵌入式工程师需要尽快扔掉的6个想法
上个月去一个客户那儿做技术交流,路过他们嵌入式组的共享盘,我随手点开一个项目目录:
motor_ctrl_v1/motor_ctrl_v2_改/motor_ctrl_v3_最终版/motor_ctrl_v3_最终版2/motor_ctrl_打死不改版/motor_ctrl_给客户演示用/
旁边桌上还躺着一个U盘,标签上写着"备份"。
我问带我的那个小伙子:现在产线上跑的是哪一版?
他愣了三秒:"应该……是 v3 吧?我找找。"
这个场景放在五年前,顶多算管理糙一点。放到今天,它是要命的——因为现在改代码的主力已经不是人了。
人一天改两版,AI一天能给你改几十版。
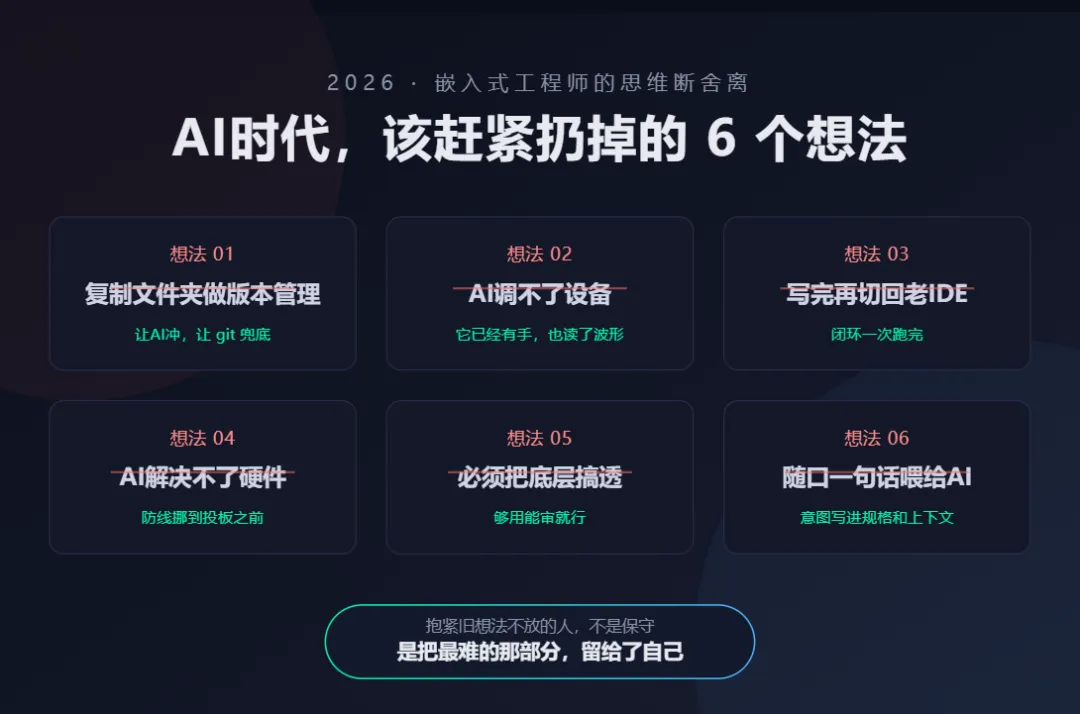
今天想聊的就是这件事:AI已经进来了,咱们脑子里有些旧想法,得赶紧扔掉。不是技术不够,是想法先老了。
下面六个,每一个我都踩过坑。
一、别再靠复制文件夹做版本管理了
坦白讲,我自己也是从"复制文件夹"那个年代过来的。那会儿一天改不了几行,一版能顶三天,命名乱一点问题不大。
现在完全不是一回事了。
AI改代码的速度是按"对话轮次"算的,不是按天。你让它重构一个状态机,它十分钟能给你三版:第一版跑不通,第二版能跑但有内存泄漏,第三版干净了但把你的接口改了。你要是没版本管理,这三版在你脑子里就是一锅粥,最后留在工程里的,很可能是其中最差的那一版。
我现在的操作极其简单,四步:
改之前切分支(feat/xxx)。这是给AI划跑道,它再怎么折腾也出不了这个圈; 一个小改动通过测试就 commit 一次。commit message 不用自己憋,让AI自己写,它比我有文化; 里程碑打 tag。出问题 git checkout那个 tag,五分钟回到出厂状态;gitignore 也别背了。直接跟AI说"帮我把构建产物、IDE本地配置、调试日志都忽略掉",它一次给写全。
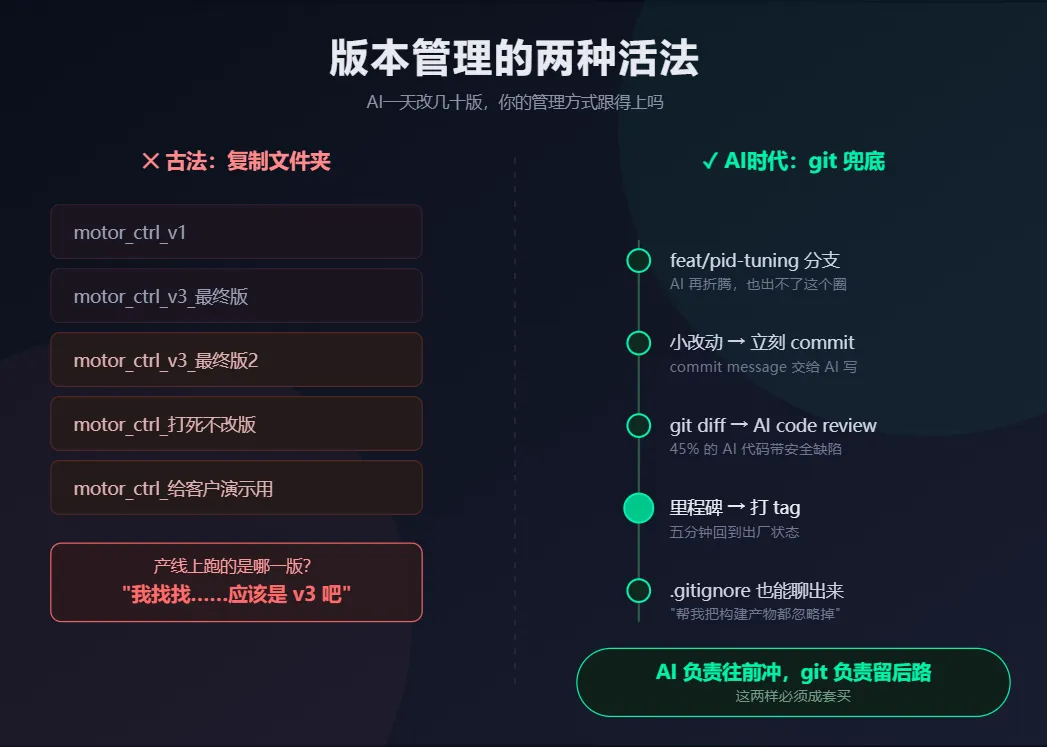
还有一点容易被忽略:git diff 是AI时代最重要的两份材料——一份给AI做 review,一份给你留后路。
为什么 review 这么重要?看两个数就清醒了。Google 的 DORA 报告提到,AI采用率每提升 25%,交付稳定性反而下降 7.2%;行业里另一份统计说,大概 45% 的 AI 生成代码带着安全缺陷。
翻成人话:AI让你跑得快,也让你更容易翻车。
速度和风险一起往上走,唯一能兜底的,就是"每一步都可追溯、可回滚"。
AI负责往前冲,git负责留后路。这两样必须成套买,单买一个都会出事。
二、"AI调不了设备、看不了示波器"——这话现在有点虚了
这是我在各种技术群里最常听到的一句,也是最贵的一句。
去年这么说还有点道理。今年8月,Anthropic 放出了 MHS(Model Hardware Standard)研究预览——一套让 AI agent 操作物理设备的统一接口标准。以前把一台仪器接进AI系统,工程师得写定制集成,几周到几个月;MHS 把设备指令收敛成 read、write 这类通用原语,官方的说法是:接入周期从数月缩到数小时。
而且它已经真的干过活了。
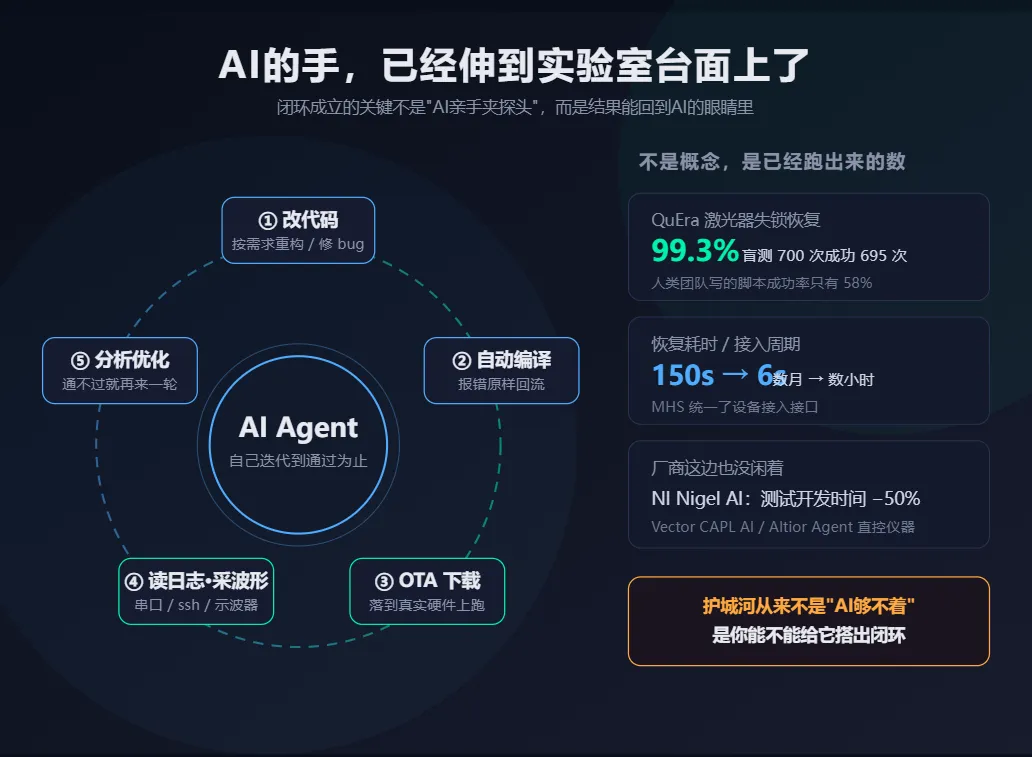
量子计算公司 QuEra 的激光器会"失锁"——温度气压稍微一变,激光频率跑偏,正在跑的计算全废。团队四个人写了好几个月自动恢复脚本,成功率 58%。接上 MHS 之后,AI 把线性脚本改成了决策树,通宵跑了几百轮迭代,最后盲测 700 次成功 695 次,99.3%,恢复时间从 150 秒压到 6 秒。
最狠的是调 PID。伺服回路里 12 个互相依赖的参数,人类专家只能靠伺服报告的均方根误差去近似调(因为每微调一次就做一次完整频谱测量,不现实);AI 每调一次就抓一次示波器波形做 FFT。最后残余误差压到专家的约十分之一;两份参数一起上相位噪声分析仪,专家版在某个共振峰处噪声高出了约一千倍。
我知道肯定有人要说"那是实验室,不是产线"。行,那就看厂商端的:
Emerson(原NI)今年7月把 Nigel AI 升级成"AI作者",覆盖 LabVIEW+、TestStand、InstrumentStudio、VeriStand,官方基准:测试开发时间最高减少 50%; Vector 给 CANoe 加了 CAPL AI Assistant,直接生成、优化、审查总线测试脚本; 国内今年7月,深圳的翱韬智能发布 Altior Agent,官方口径是直接控制示波器、程控电源、传感器和电机控制板。
再说回我们自己手上能用起来的。其实门槛比想象的低:
单片机的最小闭环——把 OTA 通道打通,再留一个能回传日志的通信口。AI 改代码 → 调用编译器 → OTA 下发 → 读调试日志 → 根据日志再改。你甚至不用让 AI 直接连硬件,它只负责改代码和产固件,下载交给脚本。闭环成立的关键不是"AI亲手夹探头",而是结果能回到AI的眼睛里。
Linux 板子就更省事了——给AI设备的 IP、用户名、密码,说清楚要解决什么问题,它自己 ssh 上去 tail 日志、查进程、改配置、验证。我第一次让AI远程调一台工控机上挂着的热敏打印机,出去接了杯水回来,它给我一版方案,还附了复现步骤。
以前我们总说 AI 缺一双手。现在手有了,接口也在标准化。
这行的护城河从来不是"AI够不着",而是"你能不能给它搭出一个闭环"。
三、AI写完再切回老IDE编译——这个来回,迟早把工程切废
这条最容易被忽视,因为它看起来只是个"习惯问题"。
但它有两层成本。
第一层是明面上的:编码和换行打架。
AI 工具里出来的代码,基本都是 UTF-8 + LF + 空格缩进。你拷回一个老 Keil/IAR 工程,那边可能是 GBK + CRLF + Tab。第一次切,中文注释开始冒方块;第二次切,某些行的缩进变成半个 tab;第三次切,整个文件的对齐全歪了,diff 里全是"看起来没改、其实全改了"的行。
一个工程这么倒腾三五回,你就不太愿意打开它了——它已经脏到分不清哪些是改动,哪些是编码事故。
第二层更隐蔽:上下文断裂。
AI 看不到编译输出,等于蒙着眼睛开车。你把报错手动复制回对话框,它能用的信息只有你贴过去的那一段——报了 200 行错,你贴了 20 行,它就在那 20 行的世界里猜。这不是AI不行,是你给它断了粮。
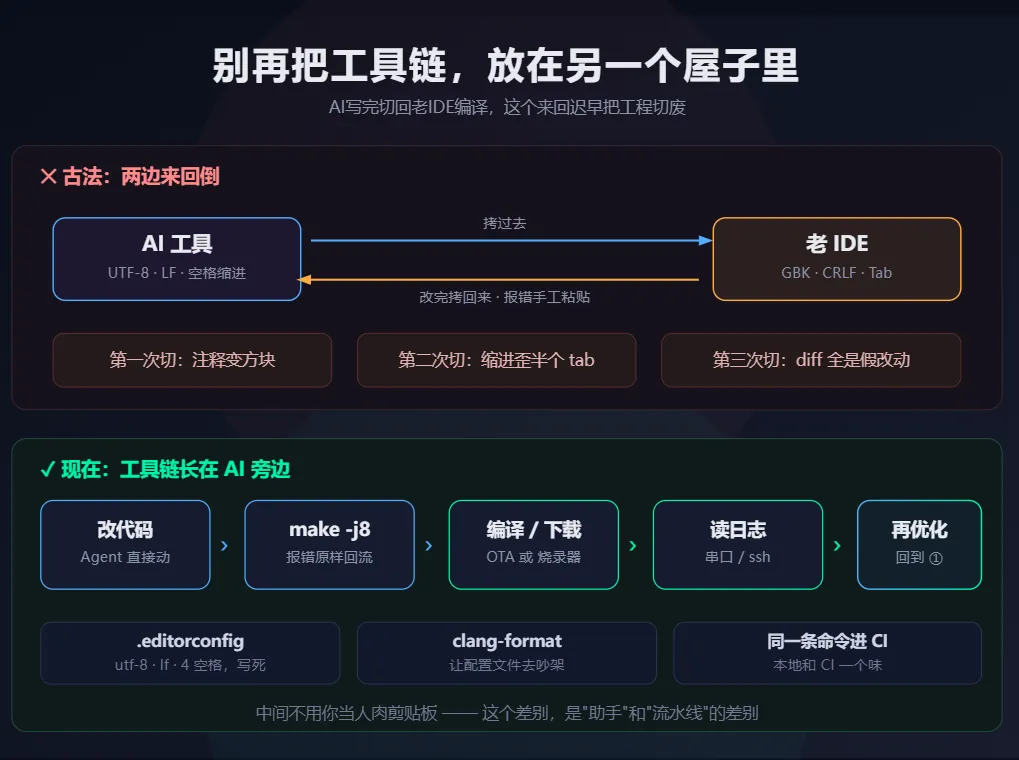
正确的做法是让工具链长在AI旁边,而不是在另一个屋子里。目前有三条现成的路:
① 命令行工具链 + AI agent。这条我觉得最该掌握。arm-none-eabi-gcc + Makefile/CMake 的组合,天然能被AI直接执行——make -j8、west build、idf.py build 都是一句话。编译报错原样回到AI上下文里,它自己看、自己改、自己重编。交叉编译 Makefile 也不用背了,跟AI说一句"用 arm-linux-gnueabihf-gcc,源文件 main.c driver.c,链 pthread 和 i2c",它连路径都替你问明白。
② AI 原生的嵌入式IDE。开源的 Embedist,建项目时选平台和板卡,自动配好 GCC ARM / xtensa-esp32-elf 工具链、链接脚本和启动代码,底层 CMake,能直接接 CI;面向 STM32 的 Devlop AI 主打 One-Click Toolchain,聊天界面里点一下就编译烧录,不用单独折腾 Makefile 和下载器。
③ VSCode / Cursor + SSH 远程Linux。代码在远端、编译在远端、AI读的也是远端——从根子上消灭"切换"这件事。
开工前有两件小事,建议现在就做掉:
根目录放一个 .editorconfig,写死charset = utf-8、end_of_line = lf、indent_style = space、indent_size = 4。所有编辑器、所有AI工具从此一个标准。配一份 clang-format。缩进几位、花括号怎么放,交给配置文件吵架去。
闭环之后是什么感觉?一句话:AI能一口气把"改代码 → 编译 → 下载 → 读日志 → 再改"跑完,中间不用你当人肉剪贴板。
这个差别,是"助手"和"流水线"的差别。
四、别以为AI解决不了硬件问题——真正值钱的是把防线往前挪
一说"AI解决硬件",很多人脑子里是AI拿着电烙铁换芯片的画面。
格局小了。
嵌入式最贵的时间,从来不是排查某个具体问题,是**"这锅谁的"**——硬件说是软件时序,软件说是电源纹波,一台板子来回甩。而这种甩锅,八成源于设计阶段的低级错误:上拉忘放、封装选错、去耦电容放太远、端接电阻没配。
一次改板多少钱?行业里常引用的区间是:一版 $5,000–15,000,加 3–6 周工期。
而这类"低级错误",恰恰是AI现在最擅长的。看几个今年的数:
AI 驱动的 DRC:一块 16 层、1 万网络的板子,不到 60 秒跑完,还能抓到传统规则 deck 抓不到的边缘情况; AI DFM 校验:缺陷检出率 99.2%,传统 DRC 单干只有 82%;误报率从 15% 降到 1.8%;DFM review 时间从 4 小时以上压到 12 分钟以内; 复杂板(8层以上、密脚BGA、有阻抗控制)的首版成功率:不用AI是 40–60%,用AI是 70–85%。一年四个项目的团队,等于少掉 1.2 次改板——省的不只是钱,是三到六周的档期。
工具层面也都已经落地了,不少还是能白嫖的:
kicad-happy(开源):把 KiCad 的原理图和PCB布局解析成结构化数据,AI 交叉引用器件值和 datasheet,自动查端接不匹配、阻抗偏移、去耦不足这类 SI 问题,兼容 Claude Code、OpenAI Codex、Copilot CLI、Gemini CLI; Simbeor Commander:自然语言直接调度 EM 求解器——"把第二层介质换成 Megtron 7 重新跑阻抗",它自己做完链路识别→求解器配置→多轮迭代→结果汇总; Siemens Fuse EDA AI Agent(2026年3月):Supervisor + Worker 多智能体,横跨 Xpedition(布局)、HyperLynx(SI分析)、Tessent(DFT)跑端到端流程; 还有 Quilter AI 那类物理驱动的自动布线,官方案例里 428 小时的人工布线,它 38.5 小时跑完,98% 由AI自主完成。
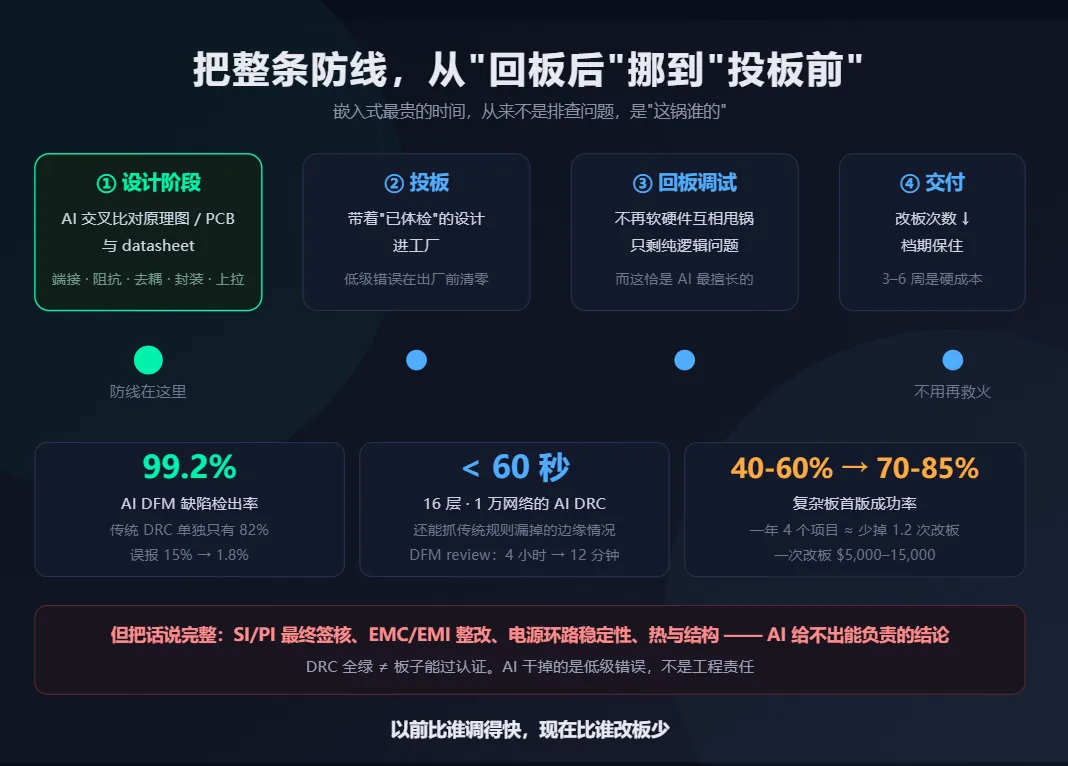
但我得把话说完整——AI现在签不了的字,还很多。
SI/PI 的最终签核、EMC/EMI 整改、电源环路稳定性、小信号采集的噪声、热与结构协同,这几块 AI 能给初稿、能加速仿真,但给不出能负责的结论。DRC 全绿不等于能过认证测试的板子,这句话在 2026 年依然成立。
所以真正的变化到底是什么呢?
是AI把整条防线,从"板子回来之后"挪到了"投板之前"。
你不再是那个凌晨拧着探头四处找毛刺的人,你是那个在设计阶段就把低级错误摁死的人。剩给软件的,才是纯逻辑问题——而那恰恰是人和AI都擅长的部分。
以前比谁调得快,现在比谁改板少。
五、"要把底层搞得特别透"——这句话到2026年,得改改了
这条我知道会挨骂。但还是得说。
我见过太多同行(包括三年前的我)有个执念:不把时钟树从 RCC 一路推到 PLL 分频系数搞明白,不敢写第一行代码;不把 RTOS 的任务切换琢磨通透,觉得自己不算真懂。
这种精神我很尊重,但它的性价比正在急剧下降。
打个比方:二十年前,"不懂汇编算什么程序员"是常识;现在还有几个人手搓汇编?不是汇编不重要了,是它下沉成了少数人需要触碰的那一层。底层知识正在走同一条路——它在下沉,不在消失。
更关键的是,恰恰是这些"确定性极强、可验证性极高"的活儿,AI干得最好。寄存器配置、时钟树计算、DMA 仲裁优先级、字节序和位域对齐——这些东西有唯一正确答案,错了编译器或仿真立刻打脸。让AI干,比人快,也比人稳(人总会在第 47 个寄存器上疲劳)。
那是不是底层就别学了?当然不是。变的是颗粒度:
过去学底层,是为了"能手搓";现在学底层,是为了"能判断AI对不对"。
这是完全不同的学法。你不需要背下 I2C 的时序参数,但得一眼看出AI把 100kHz 和 400kHz 的上升时间要求搞混了;你不需要手推 PLL 分频表,但得知道这条总线的频率上限,能在它把波特率算冒了的时候叫停。
你要是把时间全花在"通透"上——说句不好听的,你是在跟一个不会累、不会烦、一分钟能读三本 datasheet 的东西比赛背参数。
省下来的时间干嘛?三件事,按重要性排:
搭闭环工作流。 就是第二、三条说的那些。这是别人拿不走的产能。 往上游走。 这东西为什么这么定义?客户真正疼的是啥?同一颗方案,隔壁家凭什么卖贵三倍?这些AI答不了,但老板愿意为它付钱。 定义验证规则。 最容易被忽略,也最值钱。AI能产一百版代码,但"什么叫通过"必须你来定。谁定义了验收标准,谁才是这个项目里不可替代的人。
六、最后一个:别再把需求含在嘴里喂给AI
第五条可能有人不服。那这一条,是六条里最容易立竿见影的。
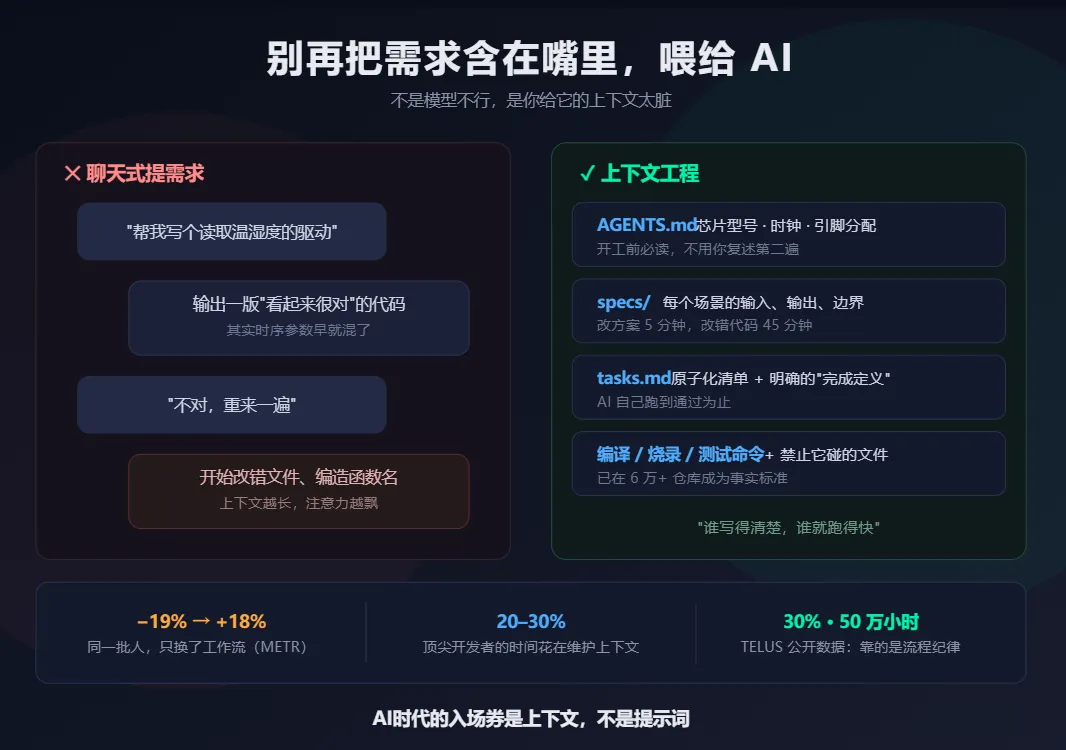
现在大部分人用AI的方式还很原始——打开对话框敲一句"帮我写个读取温湿度的驱动",回车,等。出来的东西不对,骂一句"AI不行",再敲一句。
问题不在模型,在你喂它的东西。
有个数据我一直记着:主流大模型在 1K token 上下文时准确率约 99.3%,到 32K token 时掉到约 69.7%。不是模型变笨了,是上下文变脏了——聊得越久,里面塞的无关信息越多,AI就开始"注意力漂移"。这就是你和AI聊了两小时之后,它开始改错文件、编造不存在的函数名的原因。
再补一刀:METR 那个著名的实验,16位资深开源开发者用AI干活,实测慢了 19%,自己却感觉快了 20%。今年2月他们更新数据,换成新工具和成熟工作流,同一批人提速 18%。人没换,模型换了几代,真正决定结果的是工作流。
所以2026年最值得学的一项技能,叫上下文工程:AI开工之前,你给它准备了什么。
落到嵌入式项目里,特别具体:
一个常驻的项目公约文件。 现在主流做法是仓库根目录放 AGENTS.md(或CLAUDE.md),写清楚:芯片型号和时钟配置、关键外设的引脚分配、编译/烧录/测试的准确命令、日志格式约定、代码风格、以及明确禁止它碰的东西。这已经是事实标准,被 Codex、Cursor、Copilot 等原生读取,出现在六万多个仓库里。有了它,AI每次开工不用你重讲一遍"我们项目是这么回事"。规格先行。 Spec-driven development 今年彻底跑出来了,GitHub 的 Spec Kit 过了 13.4 万 star。流程很朴素:先让AI和你就着需求写出 proposal(为什么改、改什么)、spec(每个场景的输入输出)、tasks(原子化任务清单),你评审通过之后再让它动手写码。改方案花5分钟,改一堆错代码花45分钟——这笔账谁都算得清。 写清楚"完成的定义"。 编译通过不算完,能烧进板子也不算完。把"通过什么测试才算通过"写进任务里,AI会自己跑到通过为止。
TELUS 那边的公开数据是这么做的,交付快了 30%、累计节省 50 万小时。他们自己总结的关键不是选对了哪个工具,是流程纪律。
代价也有:做得好的开发者,现在要把 20–30% 的时间花在维护上下文上。这是过去没有的工作量。但它换来的是AI不再跑偏。这笔钱,值。
写到这儿回头看,这六个想法其实是同一件事:
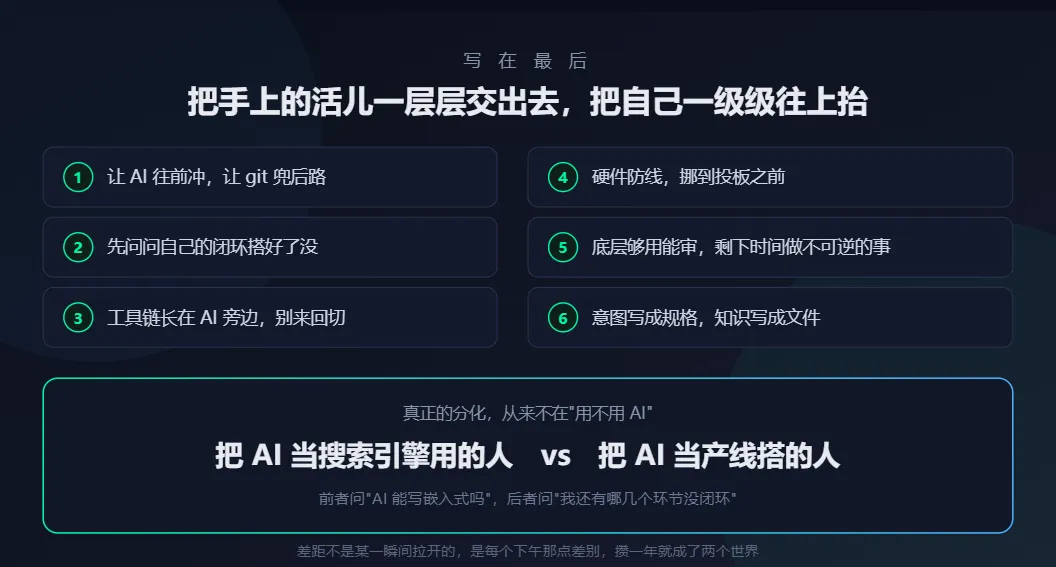
把手里的活儿一层一层交给AI,把自己的位置一级一级往上抬。
别用文件夹做版本管理了,让AI冲,让git兜底; 别低估AI够到物理世界的能力,先问问自己的闭环搭没搭; 别在AI和老工具之间来回切换,工程会被切成一地鸡毛; 别把硬件问题留到板子回来才解决,防线在设计阶段; 别再用"搞懂底层"来对抗效率,够用能审就行,剩下的时间去做不可逆的事; 别再随口提需求,把意图写成规格,把知识写成文件——AI时代的入场券是上下文,不是提示词。
最后说句掏心窝的。
这两年我见到的分化,从来不是"用AI的人"和"不用AI的人"之间的分化。
是**"把AI当搜索引擎用"的人**,和**"把AI当产线搭"的人**之间的分化。
前者还在问"AI能写嵌入式代码吗",后者已经在问"我这个项目,还有哪几个环节没闭环"。
差距就是这么拉开的——不是某一瞬间,是每个下午板子上冒出来的那点差别,攒一年,就成了两个世界。
行了。去翻翻你的工程目录,看看是不是也有个叫"最终版2"的文件夹。
有的话,先删了吧。
——一个正在给自己拆思维里的墙的嵌入式老哥