ARTICLE · 1023314
微信团队开源的 WeKnora,把公司文档变成会干活的 AI 员工
9 月 14 日,微信官方 X 账号干了件少见的事,正经推荐了一个开源项目,WeKnora,微信团队自己做的。
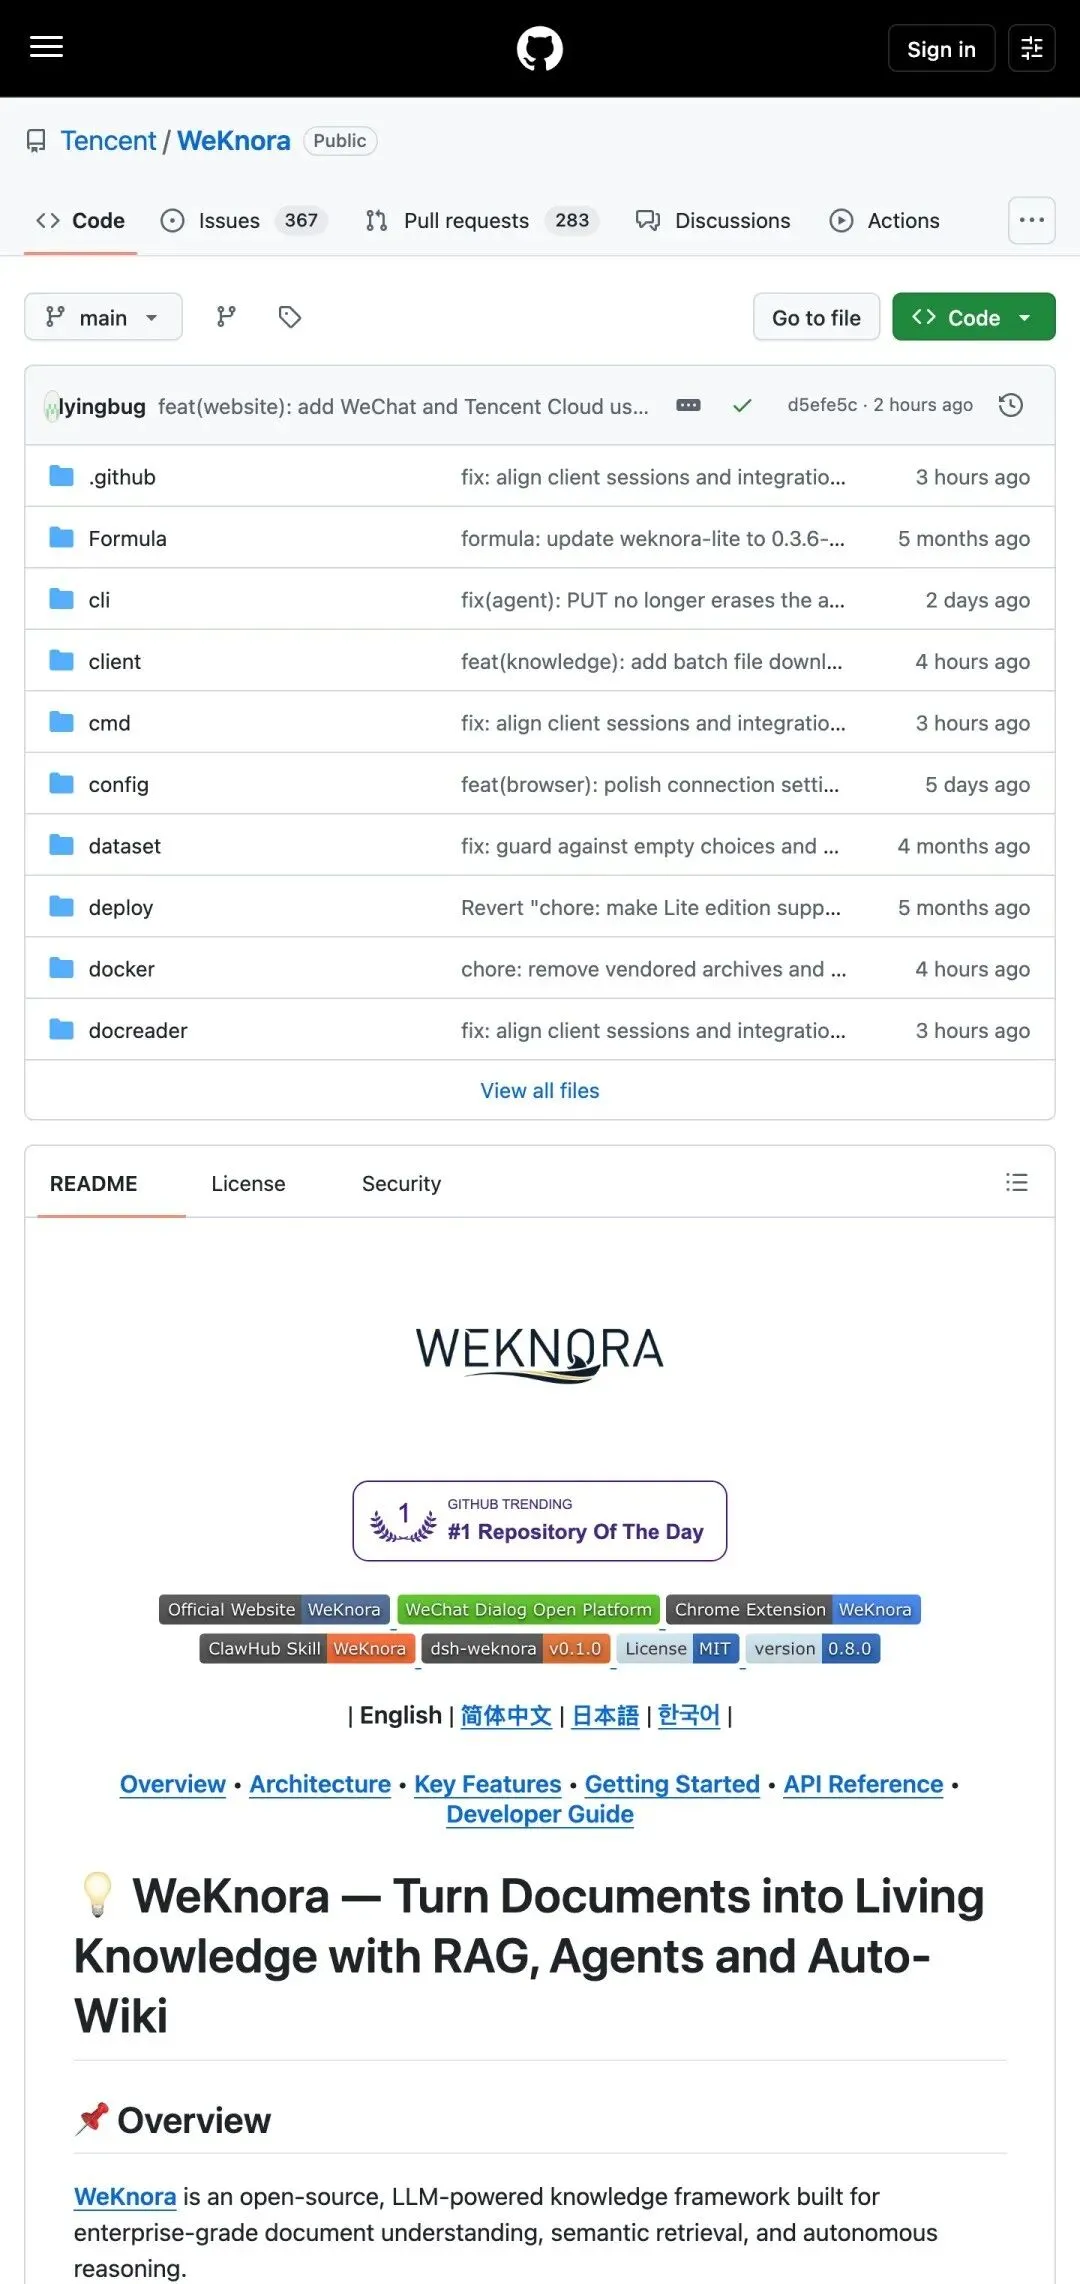
这项目其实已经低调存在一年。2025 年 9 月首次开源时,它还是个知识库问答工具,一年迭代到 v0.8.0,开发者圈子里口碑传了一整年,官方这条推文算是补了个公章。
早期用户的评价相当直接。
真香!腾讯开源的 WeKnora,能把散在飞书、Notion、语雀里的公司文档变成一个直接能问的知识库。
—— @Ryrenz,WeKnora 早期用户
文档都在,就是找不到
你公司大概率也是这个状况。流程文档在飞书,产品资料在语雀,客户信息有人放 Notion,还有人把真正关键的东西记在自己电脑的某个 Word 里。新人想搞清楚退货流程,要么问一圈老员工,要么在十几个标题差不多的文档里盲猜。
传统解法是知识库问答,行话叫 RAG,让 AI 先查资料再回答。文档切块入库,你提问,它检索相关段落,拼一段答案。能用,但天花板一眼可见,它只动嘴。你问上季度的退货流程,它流利地背一遍。听完了呢,把新旧流程对照、标出改动、整理成表格发回飞书,还是你自己来。
早期用户觉得能问就很香了,微信团队自己显然没打算停在这里。
一套入职装备,分三层
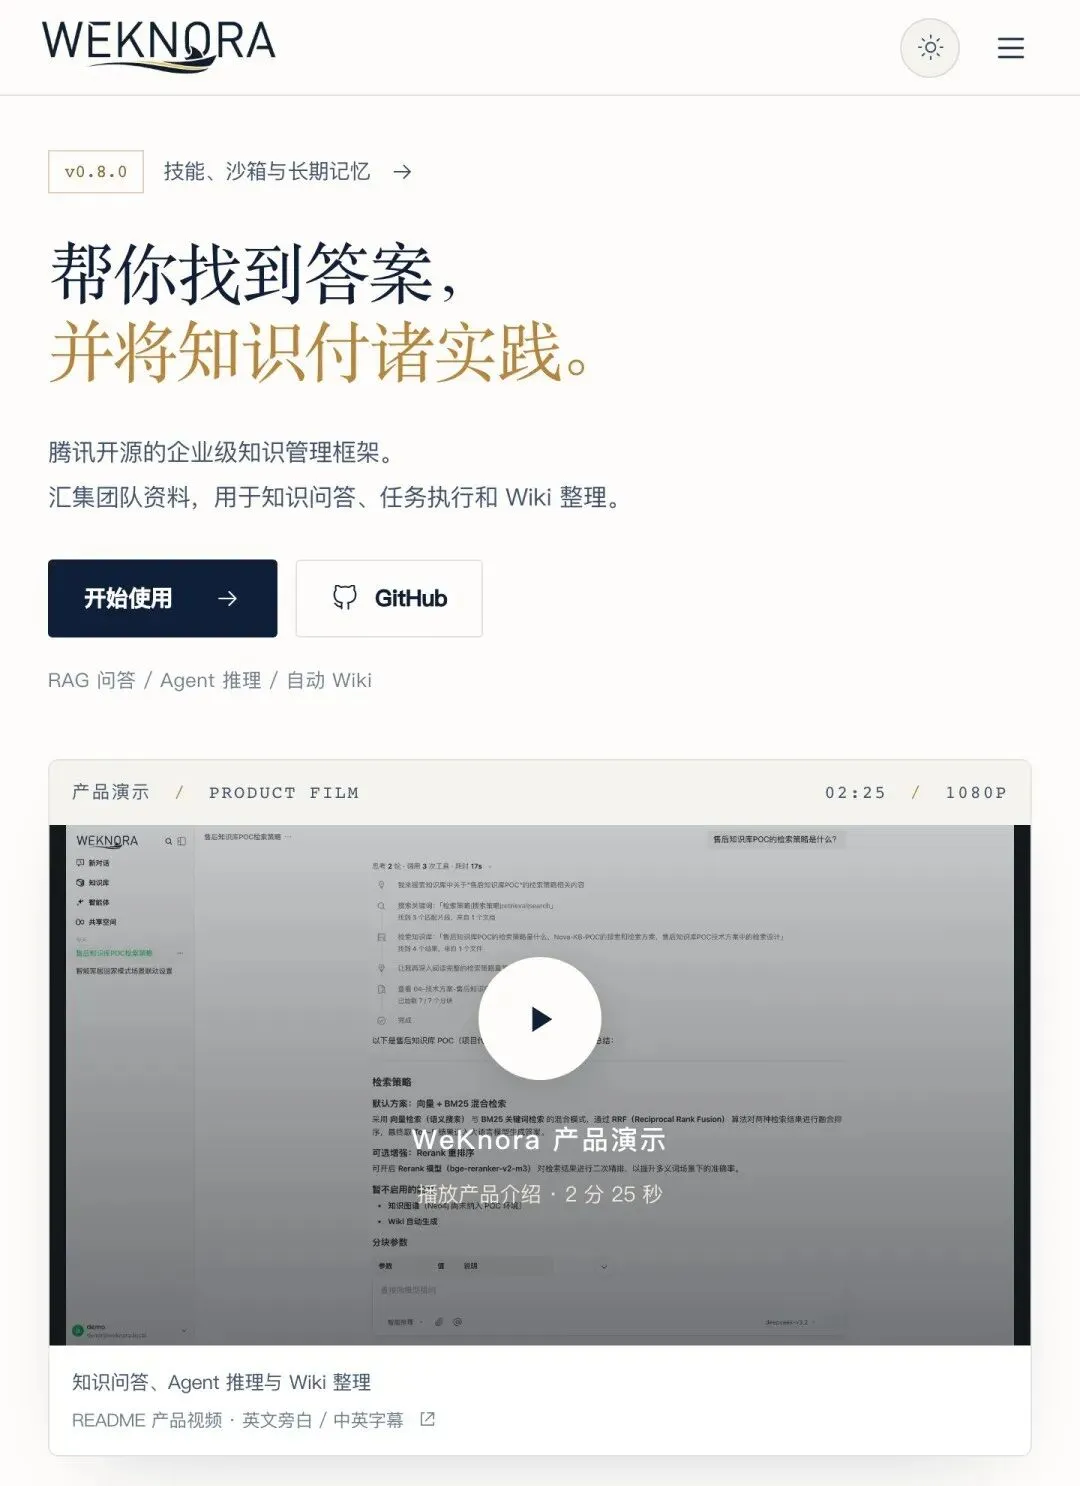
WeKnora 这一年干的事,就是把这个岗位往上提了一级。官方定位翻译过来,把原始文档变成能查询的知识库、能自主干活的智能体,外加一套自己会维护的 Wiki。
拆开看是三层能力。打个比方,像给 AI 新员工配的入职装备,一座图书馆、一本记事本、一个工位。
图书馆管知识,什么格式都收,进来先加工。记事本管记性,跨对话记住你的事,还懂得分寸。工位管动手,AI 在里面跑命令改文件,干完交成品。三层配齐,回答问题就只是基本功了。
图书馆这一层,文档进来先加工
先说图书馆。WeKnora 收文档的口味很杂,PDF、Word、PPT、Excel、网页、图片,连 XMind 思维导图都能直接进。飞书、Notion、语雀、GitLab、钉钉文档这些常用数据源还能源头同步,源文档一更新,库里跟着更新。
进来之后要过一整条加工线。图片先做文字识别,音频先转文字,表格单独解析,然后再切块、建索引。找资料也是两条腿走路,语义理解和关键词匹配同时上,找到的段落再精排一遍,把最相关的顶到前面。
有个细节在同类开源项目里少见,内置了评测工具,召回命中率、回答质量都能跑出数。知识库做出来效果到底行不行,能量出来,不靠拍脑袋。这个设计透露的态度很明确,它默认你是要拿去真用的。
记事本这一层,记什么你说了算
第二层是记性。AI 对话有个通病,聊完就忘,昨天交代的事今天再问,一脸无辜。WeKnora 给智能体配了跨对话的长期记忆,分五类记你的信息,身份、偏好、事实、任务、兴趣。
关键在落库的方式。系统自己推断出来的记忆,先进一个待确认区,你点头了才正式存进去。像新员工记工作笔记,写完先拿给师傅过目,师傅说这条对,才誊进正式本子。它还会顺手记你经常引用哪几份文档,之后的检索自动偏向这些资料。
这道确认看着繁琐,其实是企业场景里最要紧的设计。AI 记错你一个口味偏好,顶多推荐歪了,记错一条业务事实,后面每次回答都带着这个错走。宁可慢一步,这道门不能省。
工位这一层,干完活直接交文件
第三层是 v0.8.0 新增的重点,执行环境。每个对话可以挂一个持续存在的沙箱。沙箱可以理解成一间隔离的作业间,AI 在里面跑命令、装软件、读写文件,动作再大也伤不到外面的系统。README 里写明支持 Docker 等三种沙箱后端,这一版还把「直接跑在宿主机上」的旧选项砍掉了,安全上收得更紧。
有了工位,性质就变了。官方的说法是,智能体从「根据公司文档告诉我该怎么做」,走到「理解我要干什么,然后在受控环境里直接做出来」。你让它对照新旧退货流程,它自己去翻文档、开表格、标出改动,干完把文件当成品交给你。
以前的知识库 AI 像个顾问,讲完就走。这一版之后,它是个带工位的员工了。
它还自己整理档案
三层之外还有个更妙的设计,Auto-Wiki。智能体能把散落的原始资料,整理成互相链接的 Wiki 档案,自动生成知识图谱。这套 Wiki 是活的,智能体能继续搜它、改它、检查前后矛盾、标记过期内容,还配了个专职的 Wiki Fixer,专修死链和名字混淆这类档案病。每次修改都有版本记录,改砸了一键回滚。按官方的说法,这套机制扛得住四万文档级的库。
企业知识库的真实痛点其实有两个,一个是找不到,一个是没人维护。第一个,检索解决大半。第二个,十几年没好过,文档烂尾、链接失效、新旧版本打架,每个上过班的人都懂。WeKnora 的答案是,把档案管理员这个岗位也划给 AI,还是自我维护的那种。
微信为什么敢放出来
这个项目的出身值得交代一句。它从微信对话开放平台长出来,在生产环境里真跑过,多租户、四级权限、审计日志、凭据加密这些企业采购的标配都是齐的。协议选了 MIT,商用友好,企业可以整套搬回自己机房,数据不出门。这条恰好踩在企业最敏感的点上,公司上 AI,最怕的就是文档往外送。
README 里还列了二十多家模型供应商,OpenAI、DeepSeek、本地部署的 Ollama 都在名单里,随换随用。模型层自己就设计成可替换的,代码里没藏护城河。真值钱的东西放哪,X 上的科技博主 MaxForAI 说得最直白。
模型随时可以换。但公司的文档、知识关系、权限、记忆、Skills 和执行环境,才可能是最后真正沉淀下来的那一层。
—— MaxForAI,X 科技博主
配套还有个 DeepSeek Harness 官方插件,装上之后,编程智能体能直接调用 WeKnora 里的企业知识。模型谁家都能换,文档和记忆沉在企业自己手里,这笔账腾讯算得明白。
几句冷水
四万文档级是官方的宣称,真实规模下的表现要等企业用户跑出来。官方推文评论区已经有人在问,它和腾讯自家的 ima 知识库有什么区别,目前还没等到正面回应。开源项目的承诺和落地之间,永远隔着一段要自己踩的路。
模型每季度都有新王,今天最强的,半年后多半被追平。公司攒了十年的文档、流程、客户记忆是慢变量,换什么模型都带不走,这才是家底。WeKnora 有意思的地方在于,它把这套家底的攒法,图书馆、记事本、工位,整套用 MIT 协议放了出来。
感兴趣的可以去 GitHub 搜 Tencent/WeKnora,文档齐全,部署门槛不算高,试的成本大概就是一台服务器。你公司文档里躺着的东西,可能比你以为的值钱。
Macaron 🧁 | AI 员工,自带工位