ARTICLE · 1025634
【RAG】从单文档格式到多文档格式识别
【RAG】从单文档格式到多文档格式识别你将收获: 1、RAG从只支持txt到pdf、doc、md、png等多格式文本 项目优势: 1、保持Pipeline不变,仅新增少量代码 2、langchain配置的文档格式统一 相关知识: 1、类。继承的运用,继承父类的方法、用super().__init__()初始化父类已经初始化的属性 2、langchain的文档读取功能。自带处理pdf、txt、doc的工具,比如:PyPDFLoader、Docx2txtLoader、TextLoader,但图片处理要单独调一次API,直接调api更容易上手,也可以本地ocr识别。 前置资料: 【RAG】纯手搓一个模块化的 RAG 项目 【RAG】4 步跑通私有知识库问答:LangChain 模块化 RAG 极简实战与接口封装
原架构 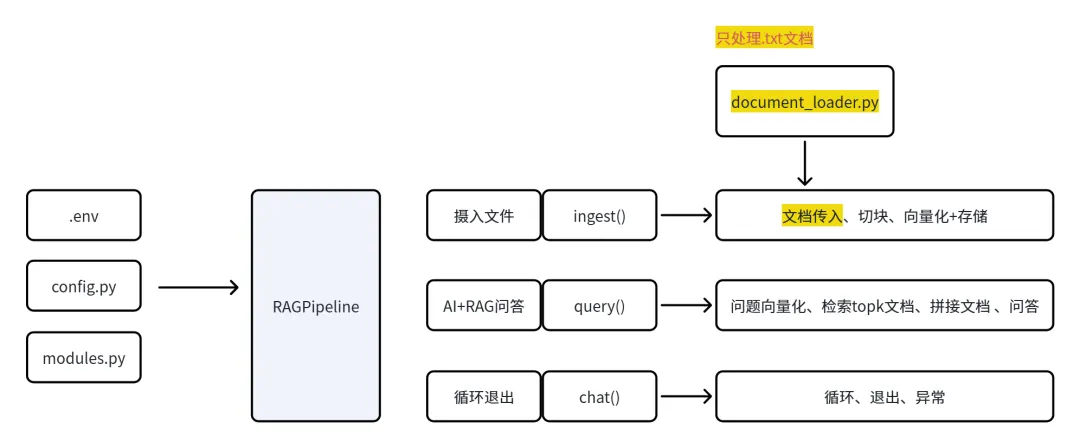
现架构 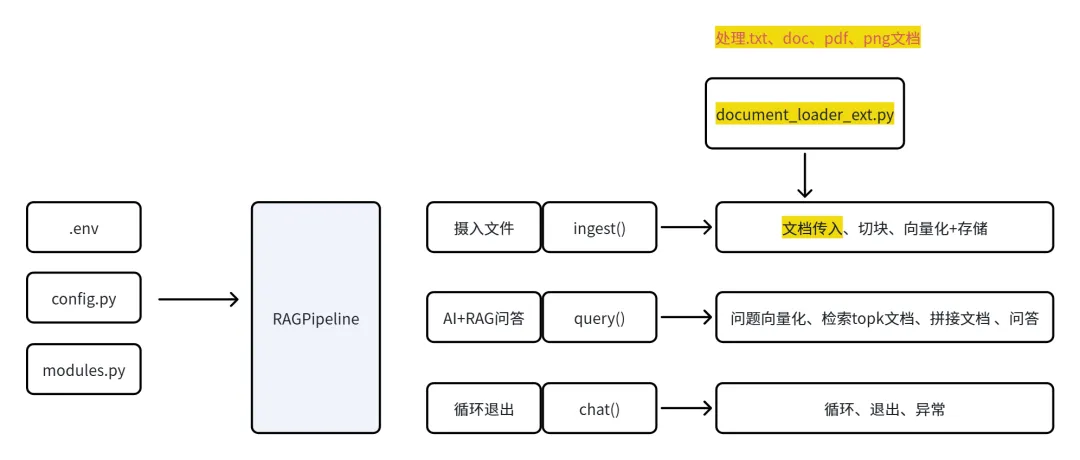
新的模块document_loader_ext.py,其中的DocumentLoaderExt类继承自父类DocumentLoader,通过这个类来做3件事: 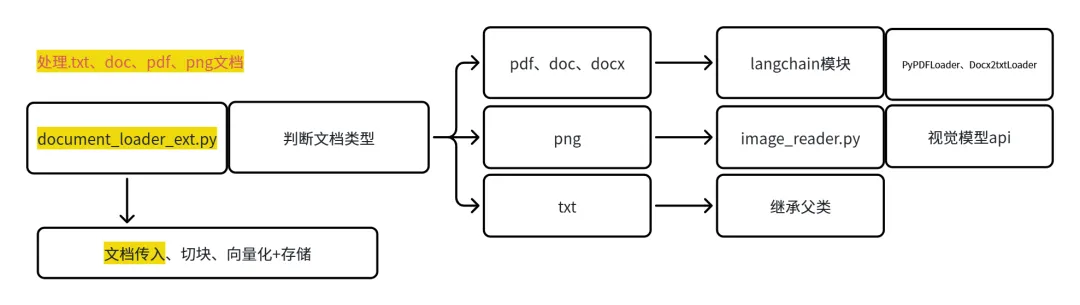
代码改动: 不变的模块有下面4个 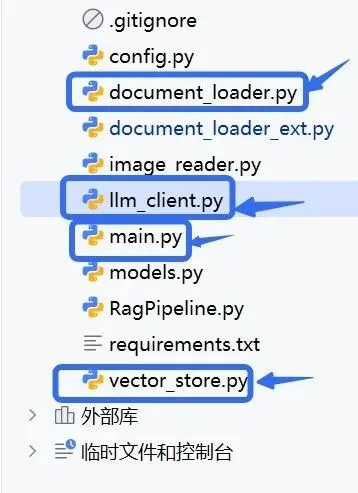
有修改的模块,修改的部分用黄色标出:
1、判断文档类型。通过文件后缀名判断,txt文档直接复用父类功能
2、新建图片处理模块。image_reader.py处理图片类,调用有ocr的api
3、pdf、doc直接用langchain自带的工具
.env
.env文件新增一个视觉模型,用于ocr识别
.env编写代码如下:
# DeepseekDEEPSEEK_API_KEY='sk-*************'DEEPSEEK_API_URL='https://api.deepseek.com'DEEPSEEK_API_MODEL='deepseek-chat'# 阿里云百炼DASHSCOPE_API_KEY='sk-*************'DASHSCOPE_API_URL='https://llm-qwe2oxuia5qhvcmo.cn-beijing.maas.aliyuncs.com/compatible-mode/v1'DASHSCOPE_API_MODEL='qwen3.7-flash'# 2026.10.23到期# 向量模型DASHSCOPE_API_EMBEDDING_MODEL='qwen3.7-text-embedding'# 视觉模型# 【新增】视觉大模型(用于jpeg/jpg图片OCR文字识别,和上面同一个平台同一个key)# 注意:视觉模型≠文生图模型,具体模型能不能用可以问问千问,视觉模型一般名字含vlDASHSCOPE_API_VL_MODEL='qwen3.5-ocr'# 2026.9.14到期config.py
config文件新增一个视觉模型,用于ocr识别
config.py编写代码如下:
import osfrom dotenv import load_dotenv# 加载 .env文件load_dotenv()# ======================文件存储路径======================# 数据文件路径DATA_PATH = os.path.join(os.path.dirname(__file__),"DATA","deepseek百度百科.pdf") # 更改文件类型这里也要改# chromaDB持久化路径CHROMA_PATH =os.path.join(os.path.dirname(__file__),"DATA","CHROMA_DATA")# ======================模型配置 API key==================# 阿里云DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY","")DASHSCOPE_API_URL = os.getenv("DASHSCOPE_API_URL","")DASHSCOPE_API_MODEL = os.getenv("DASHSCOPE_API_MODEL","")DASHSCOPE_API_EMBEDDING_MODEL = os.getenv("DASHSCOPE_API_EMBEDDING_MODEL","")# 【新增】视觉大模型(给image_reader模块用)DASHSCOPE_API_VL_MODEL = os.getenv("DASHSCOPE_API_VL_MODEL","")# DeepSeekDEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY","")DEEPSEEK_API_URL = os.getenv("DEEPSEEK_API_URL","")DEEPSEEK_API_MODEL = os.getenv("DEEPSEEK_API_MODEL","")# ====================== 文本切分配置 ======================CHUNK_SIZE = int(os.getenv("CHUNK_SIZE","150"))CHUNK_OVERLAP = int(os.getenv("CHUNK_OVERLAP","30"))SEPARATORS = ["\n\n","\n","。","?",",",""] # 分隔符优先级# ====================== 批处理设置 ======================BATCH_SIZE = int(os.getenv("BATCH_SIZE","10")) # 防止 API 限流TOP_K = int(os.getenv("TOP_K","5"))TEMPERATURE = float(os.getenv("TEMPERATURE","0")) # 温度# ====================== 集合名称 ======================COLLECTION_NAME = "demo"models.py
新增一个视觉模型models.py编写代码如下:
# models.py# 可用模型列表,以及获得访问模型的客户端# 实际使用时可以根据自己的实际情况调整import osfrom dotenv import load_dotenvfrom config import BATCH_SIZE,DASHSCOPE_API_VL_MODELload_dotenv()# 阿里的通义千问大模型(主要使用)# 官网: https://bailian.console.aliyun.com/#/homeDASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")DASHSCOPE_API_URL = os.getenv("DASHSCOPE_API_URL")DASHSCOPE_API_MODEL = os.getenv("DASHSCOPE_API_MODEL")DASHSCOPE_API_EMBEDDING_MODEL = os.getenv("DASHSCOPE_API_EMBEDDING_MODEL")# DeepSeek# 官网:https://platform.deepseek.com/api_keysDEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")DEEPSEEK_API_URL = os.getenv("DEEPSEEK_API_URL")DEEPSEEK_API_MODEL = os.getenv("DEEPSEEK_API_MODEL")DEEPSEEK_REASONER_MODEL = "deepseek-reasoner"import inspectfrom openai import OpenAIfrom langchain_openai import ChatOpenAIfrom langchain_community.embeddings import DashScopeEmbeddings, HunyuanEmbeddings# 【不要用这个,只是方便后面return】通过LangChain获得指定平台和模型的客户端 (默认是:阿里通义千问)defget_lc_model_client(api_key=DASHSCOPE_API_KEY, base_url=DASHSCOPE_API_URL, model=DASHSCOPE_API_MODEL, temperature=0.7, verbose=False, debug=False):""" 通过LangChain获得指定平台和模型的客户端,设定的默认平台和模型为阿里百炼qwen 也可以通过传入api_key,base_url,model三个参数来覆盖默认值 verbose,debug两个参数,分别控制是否输出调试信息,是否输出详细调试信息,默认不打印 """ function_name = inspect.currentframe().f_code.co_nameif (verbose):print(f"{function_name}-平台:{base_url},模型:{model},温度:{temperature}")if (debug):print(f"{function_name}-平台:{base_url},模型:{model},温度:{temperature},key:{api_key}")return ChatOpenAI(api_key=api_key, base_url=base_url, model=model, temperature=temperature, extra_body={"enable_thinking": False})# 【正常使用】通过LangChain使用阿里大模型defget_ali_model_client(model=DASHSCOPE_API_MODEL, temperature=0.7, verbose=False, debug=False):"""通过LangChain使用阿里大模型"""return get_lc_model_client(api_key=DASHSCOPE_API_KEY, base_url=DASHSCOPE_API_URL, model=model, temperature=temperature, verbose=verbose, debug=debug)# 【正常使用】通过LangChain使用 DeepSeek大模型defget_ds_model_client(model=DEEPSEEK_API_MODEL, temperature=0.7, verbose=False, debug=False):"""通过LangChain使用DeepSeek大模型"""return get_lc_model_client(api_key=DEEPSEEK_API_KEY, base_url=DEEPSEEK_API_URL, model=model, temperature=temperature, verbose=verbose, debug=debug)# [向量化]通过LangChain获得一个阿里通义千问向量化模型的实例defget_ali_embeddings(model=DASHSCOPE_API_EMBEDDING_MODEL):"""通过LangChain获得一个阿里通义千问向量化模型的实例"""return DashScopeEmbeddings( model=model, dashscope_api_key=DASHSCOPE_API_KEY,# chunk_size=BATCH_SIZE )# [视觉模型]通过LangChain获得一个阿里通义千问视觉模型的实例defget_ali_vl_model_client(model=DASHSCOPE_API_VL_MODEL, # 使用视觉模型的环境变量 temperature=0.7, verbose=False, debug=False):"""通过LangChain获得一个阿里通义千问视觉模型的实例"""from langchain_openai import ChatOpenAIreturn ChatOpenAI( api_key=DASHSCOPE_API_KEY, base_url=DASHSCOPE_API_URL, model=model, temperature=temperature, verbose=verbose )RAGPipeline.py
新增一个子类document_loader_ext.py,继承父类document_loader.py
RAGPipeline.py编写代码如下:
# 目标(客户视角)# 接受文件--向量化,存储,检索--提问回答--多次问,退出# import document_loader # 【修改点1】注释掉原导入import document_loader_ext # 【修改点1】改为导入扩展模块import llm_clientimport vector_storeclassRagPipeline:"从文档读取-向量化-存储-问题检索-ai问答 的全流程管线"def__init__(self):"备齐管线其他函数所需要的工具"self.document_loader = document_loader_ext.DocumentLoaderExt() # 【修改点2】换用扩展类self.vector_store = vector_store.VectorStore()self.llm = llm_client.LLMClient()defingest(self):"摄入文档"""" 解决什么问题: - 读取文件 - 文件切块 - 切块文档向量化并存储 输入: - 无(文件在子模块自动加载,保持管线清爽) 输出: - doc_vector:向量化后的文档(存到数据库即可) 用到什么模块: - document_loader.file_read():文档加载类,读文件函数 - document_loader.splitter():文档加载类,切分文档函数 - vector_store.add_document():向量数据库类,存储文档 """# 读取文件 document = self.document_loader.file_read()# 切块 chunk = self.document_loader.splitter(document)# 向量化+存储 doc_vector = self.vector_store.add_document(chunk)return doc_vectordefquery(self, question):"一次AI检索问答"""" 解决什么问题: - 问题向量化,并在向量数据库中找到topk个相关文档 - topk个向量文档拼接 - 接通AI模块,输出基于文档的回答 输入: - question:用户问题 输出: - answer:基于问题+文档 的回答 用了什么模块: - vector_store.search():向量数据库类,把问题向量化并检索topk文档的函数 - llm.rag_ask():大模型类,接通AI,根据问题和文档回答的函数 """# 问题向量化,检索topk个文档 top_k_doc = self.vector_store.search(question)# topk个文档拼接 context = "\n".join(top_k_doc)# AI回答 answer = self.llm.rag_ask(context, question)return answerdefchat(self):"多次问答,退出"""" 解决什么问题: - 退出:用户输入q,exit,quit自动转小写,识别并退出break - 空内容处理:用循环continue - 循环问答:While True 输入: - 无(输入在子模块已处理) 输出: - answer:调用query()函数,并print结果 用到了什么方法: - query:循环调用回答 - while循环:continue,break """print("你好,欢迎你进入AI-RAG问答系统~~")whileTrue: question = input("请输入你的问题:")if question.lower() in ['q', 'quit', 'exit']:print("那就再见了")breakifnot question:continue answer = self.query(question)print(f"AI回答:{answer}")document_loader_ext.py
新增一个子类document_loader_ext.py,这个模块之前没有
document_loader_ext.py编写代码如下:
# document_loader_ext.py# 多格式文档加载扩展模块## 解决什么问题:# - 原 document_loader 只支持 .txt,本模块在不改动原代码的前提下# 新增 .pdf / .doc / .docx / .jpeg / .jpg 等格式识别# 核心思路:# - 建一张"后缀名 → 加载器"映射表(LOADER_TABLE)# - 继承原 DocumentLoader,只重写 file_read() 一个方法:# 识别后缀 → 图片走 image_reader(大模型OCR)# → 命中映射表走对应加载器# → 否则调用父类(原txt逻辑)# - splitter() 切块函数完全继承父类,零改动import osfrom config import DATA_PATHfrom document_loader import DocumentLoader# 【新增】图片OCR模块:用视觉大模型提取图片文字,不装任何本地软件import image_reader# pdf 加载器:逐页读取pdf文本from langchain_community.document_loaders import PyPDFLoader# word 加载器:读取 .docx / .doc 文本from langchain_community.document_loaders import Docx2txtLoaderfrom langchain_community.document_loaders import TextLoader# ======================图片格式清单(新增图片格式=改这里)======================# 解决什么问题:# - 单独列出图片类后缀,因为图片不走映射表,而是走大模型OCRIMAGE_EXTS = [".jpeg", ".jpg",".png"]# ======================格式映射表(新增非图片格式=新增一行)======================# 解决什么问题:# - 用一张表集中管理"什么后缀用什么加载器",避免写一堆if/elif# 输入:文件后缀名(小写) 输出:对应的langchain加载器类LOADER_TABLE = {".pdf": PyPDFLoader, # pdf 文档".doc": Docx2txtLoader, # word 老格式".docx": Docx2txtLoader,".md": TextLoader # markdown 格式}classDocumentLoaderExt(DocumentLoader):"多格式文档加载器:识别文件后缀,自动选择对应的读取方式"def__init__(self, file_path=DATA_PATH):"初始化:直接复用父类,不需要额外准备任何工具"""" 解决什么问题: - 获得文件地址(与原模块完全一致,只是转了一道父类) 输入: - file_path:文件地址,来自config 输出: - self.file_path 用了什么模块: - super():调用父类DocumentLoader的初始化,一行顶三行 """super().__init__(file_path)# 新增:初始化图片OCR工具,它内部会自动连接阿里百炼视觉大模型self.image_reader = image_reader.ImageReader()deffile_read(self):"按后缀名识别格式,读取文件内容"""" 解决什么问题: - 识别文件是什么格式(看后缀名) - 命中映射表:用对应的langchain加载器读取 - 未命中:回退到父类的txt读取逻辑,保持原功能不变 输入: - self.file_path:文件地址 输出: - 读取内容的纯文本字符串(与父类输出格式一致,后续流程无感) 用了什么模块: - os.path.splitext():拆出文件后缀名,例如 "a.pdf" -> ".pdf" - LOADER_TABLE:后缀名->加载器的映射表 - load():langchain各加载器的读取方法,返回Document列表 - doc.page_content:langchain读取文本的key - super().file_read():父类的txt读取,兜底 """# 拆出后缀名并转小写,统一大小写,例如 ".PDF" ".pdf" 都能识别 ext = os.path.splitext(self.file_path)[-1].lower()# 分支1:图片格式 -> 走视觉大模型OCR(新增的唯一分支)if ext in IMAGE_EXTS:returnself.image_reader.read(self.file_path)# 分支2:命中映射表 -> pdf/word 走对应的langchain加载器if ext in LOADER_TABLE: documents = LOADER_TABLE[ext](self.file_path).load()# 有的格式读取结果是多页/多段,合并成一整段文本字符串return"\n".join(doc.page_content for doc in documents)# 分支3:其余格式(如txt)走父类原有逻辑,一行不改returnsuper().file_read()# 注意:splitter() 切块函数完全继承父类,无需重写image_reader.py
新增一个模块image_reader.py,在document_loader_ext.py调用,用于解决图片类文件识别,这个模块之前没有
image_reader.py编写代码如下:
# image_reader.py# 视觉大模型OCR模块## 解决什么问题:# - jpeg/jpg 图片里的文字,不装任何本地软件(tesseract等)# - 直接调用阿里云百炼的视觉大模型(qwen系列)完成图片文字提取## 核心思路:# - 读图片文件 -> 转成base64 -> 按OpenAI视觉格式发给大模型# - 大模型返回图片中的文字 -> 交给原有切分流程import base64from config import DASHSCOPE_API_VL_MODELfrom models import get_ali_vl_model_clientclassImageReader:"用视觉大模型,把图片里的文字读出来"def__init__(self, model=DASHSCOPE_API_VL_MODEL):"初始化:接通视觉大模型"""" 解决什么问题: - 获得视觉大模型的客户端 输入: - model:视觉大模型名,来自config(默认qwen-vl-max) 输出: - self.model:模型名 - self.client:大模型客户端(和文本大模型同一个平台,同一个key) 用了什么模块: - get_ali_vl_model_client:models模块已有函数,直接复用,一行不改 - config:DASHSCOPE_API_VL_MODEL视觉模型名 """self.model = model# 复用models.py里现成的客户端函数,不传参数就是默认的阿里百炼平台self.client = get_ali_vl_model_client()defread(self, file_path):"读取图片文件,返回图片中的文字"""" 解决什么问题: - 图片文件 -> base64编码 - 按OpenAI视觉格式组装消息(文字指令 + 图片) - 调用视觉大模型,提取图片中的全部文字 输入: - file_path:图片文件地址(例如 a.jpeg) 输出: - text:图片中提取出的文字(纯文本字符串,和txt读取结果格式一致) 用了什么模块: - base64:python内置,文件转base64 - self.client.chat.completions.create:OpenAI格式的视觉对话接口 - data:image/jpeg;base64:OpenAI视觉格式的图片传参方式 - .choices[0].message.content:提取大模型回答内容 """# 1.读图片二进制 -> base64编码(网络传输图片的标准方式)withopen(file_path, "rb") as f: image_base64 = base64.b64encode(f.read()).decode("utf-8")# 2.组装视觉消息:一条文字指令 + 一张base64图片 messages = [{"role": "user","content": [ {"type": "text", "text": "请完整提取这张图片中的所有文字,""按原有排版输出,不要添加任何解释。"}, {"type": "image_url","image_url": {"url": f"data:image/jpeg;base64,{image_base64}"}}, ] }]# 3.调用视觉大模型 response = self.client.invoke(messages)# 4.取回答文字 text = response.contentreturn text总结
该项目是上一个项目的拓展,运用了langchain的pdf,doc处理器,体现了langchain工具的扩展优势, 修改代码很少,并且95%为新增。
该项目运用了类中继承的功能,后续可以用这个功能实现更多模块的扩展,继承我理解就2个用处:一是用super省略初始化;一是直接复用父类中的方法,也就是父类中定义好的函数。
尝试理清流程,每部分的功能,每行代码的含义,但是不要花费过多时间在复现代码细节上,性价比太低。
项目地址
github项目地址:
https://github.com/renduermai/RAG-ChromaDB/tree/wechat_4_steps_langchain_RAG_more_type