ARTICLE · 1027755
团队文档散在 9 处,让它收成一个知识库
团队文档散在 9 处,让它收成一个知识库
团队文档散在飞书、语雀、Notion 和共享盘里,同一个问题新人问三遍,你翻三处贴三次链接。想自建一套,又卡在两件事上:分块改不动,组件换不了。
01先说它是干什么的
WeKnora(维娜拉)是一套开源的 LLM 知识框架,把文档灌进去之后同时做三件事:基于知识库的 RAG 问答、能自己调工具的多步推理 Agent,以及从原始文档自动生成互相链接的 Wiki 页面。后端用 Go 写,形态是 Web UI 加 REST API,另有命令行、Chrome 插件和微信小程序。当前 24,914 星,单日再涨 696,最近一次提交就在今天。
它不是又一个「传个 PDF 然后问答」的知识库,不是绑死在别人云上的 SaaS,也不是只管检索的向量库;它更接近一套自托管的知识底座,模型、向量库、解析引擎、存储都能逐项换掉。
这件事市面上的办法大致两类。一是买 SaaS 知识库,开箱即用,代价是文档要出内网、模型和向量库没得选。二是自己拼一套,灵活,代价是解析、分块、权限、升级这条管道长期占掉一个人力。它选了第三条路:模块化自托管,一条 docker compose 起一整套,哪块不合适换哪块。
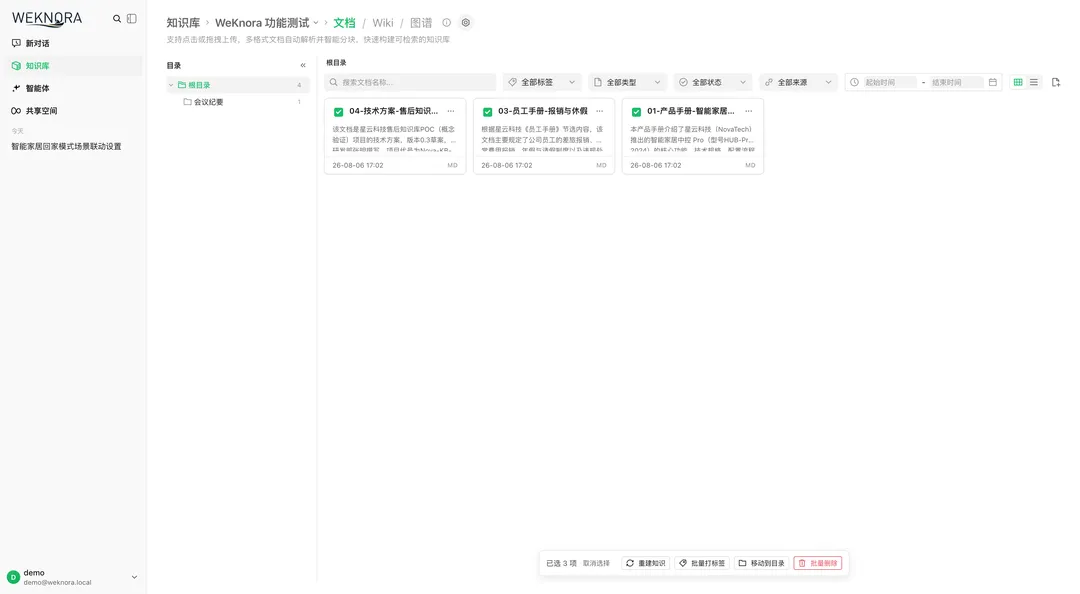
知识库页:左侧目录树,右侧文档卡片,底部批量操作条
02四条命令跑起来
前置只有两样:Docker(带 Compose)和 Git,不需要本地 Go 环境。下面这四条按顺序抄完就能用。
跑起来先看到的是 Web UI(http://localhost),左侧导航是「新对话 / 知识库 / 共享空间」,后端 API 在 8080。第一件事是进设置里配模型,列表上有 OpenAI、DeepSeek、Qwen、混元、智谱、Gemini、MiniMax、Ollama、LiteLLM 等二十来家,本机装了 Ollama 就一分钱不花。
知识图谱、对象存储、链路追踪是可选组件,用 profile 按需加,挑一条跑就行,不用全上,多个 profile 可以叠着写。
成本说清楚:软件本身免费自托管,真正的开销是模型调用,用自己的 API key 或指向本地模型;数据落你自己的磁盘,向量库用的是 compose 里的 pgvector,不用另买。
03差别在能不能改
改前改后的差别,不在功能条目多少,而在知识进来之后还能不能动。
以前的流程是这样:同一份制度在三个平台各躺一份,问起来得人工对齐;接上 RAG 之后只有只读问答,发现某一块切错了只能把原文件重传一遍;模型和向量库写死在配置里,想换一家要动代码。
现在换成:数据源按增量同步进同一个库,十几种格式自己解析、自己分块;检索命中的那一块在界面上直接改,改完自动重建索引,改坏了有版本快照和行级 diff 可以回滚;需要出文件时,Agent 在沙箱里跑命令把产物落下来,你在右侧直接预览。
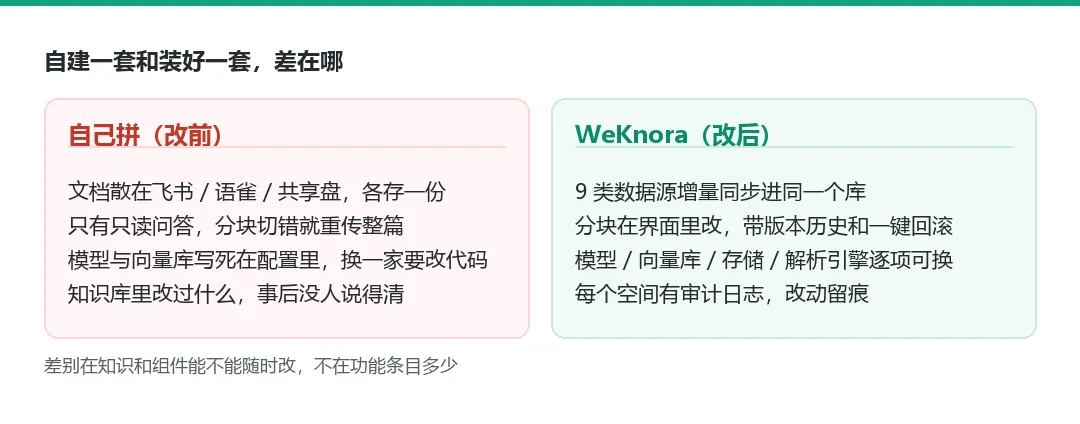
自己拼一套,和装好一套的差别
04分块改得动才算数
知识管理这块,它把「还能改」当成默认能力来做。
目录树保留原结构:文件夹上传时目录层级一起入库,能像文件管理器那样浏览、重命名、把文档挪到别的目录。为什么需要:两百份文档平铺在一个列表里,找东西全靠搜索,等于没有管理。
分块可以逐块编辑:检索命中的那一段直接在界面上改,保存后自动重建索引。为什么需要:切分策略再调也有切错的时候,只能重传整篇的话,没人愿意动它。
每次改动都留版本:分块有逐版本快照,能看 diff、能一键回滚。为什么需要:知识库改错了很难发现,没有回滚就不敢改。
录入方式不止上传:知识库分 FAQ、文档、Wiki 三类,文件夹、URL、在线录入都收,解析完还会按已有标签自动关联,不新建标签、不覆盖人工标签。
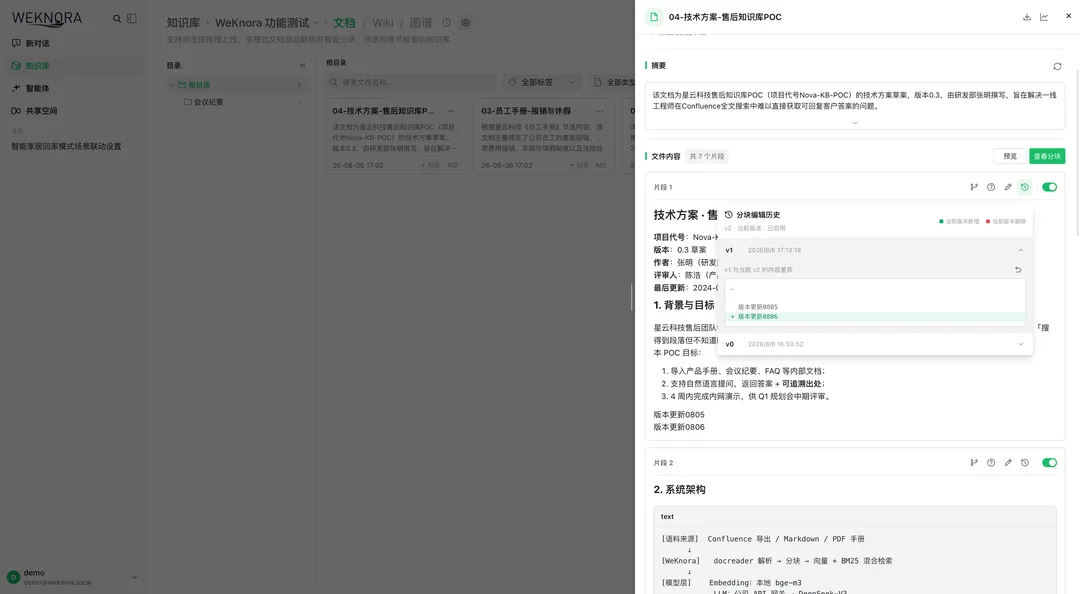
改单个分块:右侧是编辑区与历史,v1 到 v3 可对比可回滚
05问答之外还有 Wiki
Wiki 模式是它和普通 RAG 分岔的地方:Agent 读原始文档,生成互相链接的 Markdown 页面和一张知识图谱,页面上能直接编辑,保留版本历史、行级 diff 和一键回滚。规模问题也考虑到了,任务队列加死信队列是为支撑万级文档的知识库。
它和直接问答解决的不是同一件事,选哪条路取决于你要的是答案还是沉淀。
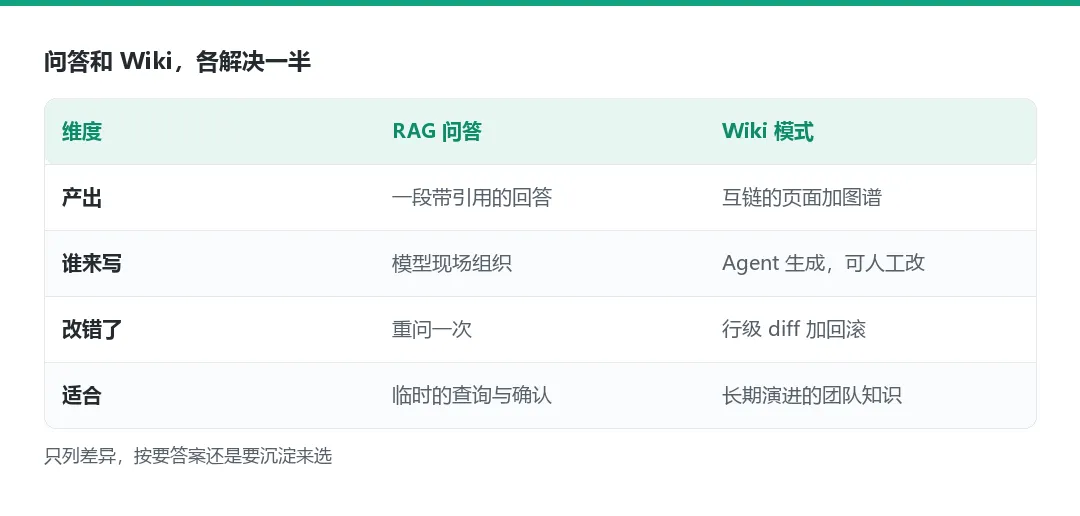
问答和 Wiki,各解决一半问题
06它会自己调工具
它的 Agent 不是一问一答,而是 ReAct 式多步推理:自己决定下一步查什么、要不要调工具。
技能目录加沙箱:从 ClawHub、SkillHub、git 仓库或 zip 装技能(skill 可以理解成插件位,放一份说明文件进去,Agent 干活前先读一遍),装进会话级的 Docker / E2B / Cube 沙箱,可以用 shell_exec 跑命令、读写文件、收集产物。为什么需要:要它交一份 Word 或 PPT,光有知识不够,得有能动手的地方。
长期记忆:跨会话记住你的画像、偏好、事实和任务,自动抽取会先让你确认,也能主动 search_memory。为什么需要:每次开新对话都重新交代背景,用几次就懒得开了。
工具与 MCP 可收窄:内置工具之外能接外部 MCP 服务(含 OAuth2 授权),也能用 @Skill、@MCP 把某一轮的范围限死。为什么需要:工具越多,模型越容易乱调。
临时附件与推荐问题:会话里能临时传图片或文档,解析完只对这一轮生效;空对话时它从知识库内容里生成几个推荐问题,省得你不知道从哪问起。
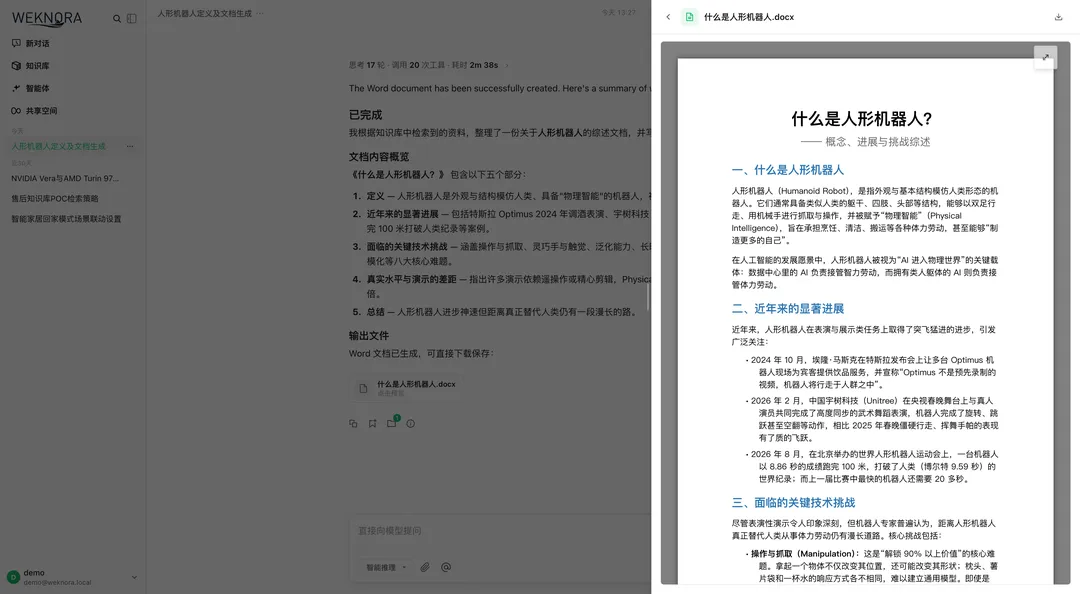
一轮对话 17 个思考轮次、20 次工具调用,产出的 Word 在右侧预览
07组件都能换掉
自建 RAG 最怕的不是上线,是两年后想换掉其中一环却发现换不动。它把这条防线做在了设置里。
模型二十来家:OpenAI、Azure、Anthropic、DeepSeek、Qwen、智谱、混元、豆包、Gemini、MiniMax、Ollama、LiteLLM 等,还能按知识库选不同模型。
向量库八种:pgvector、Elasticsearch、OpenSearch、Milvus、Weaviate、Qdrant、Apache Doris、腾讯云 VectorDB。为什么需要:换一家云或换一套检索策略,不该等于重做一遍。
存储与解析可替换:对象存储支持本地、MinIO、S3、OSS、COS、TOS、KS3、OBS,可按空间配多实例;解析引擎可选 OpenDataLoader、PaddleOCR-VL,Office 文档走进程内的 anydoc。为什么需要:PDF 和扫描件的解析质量,基本决定后面检索的上限。
08权限与安全摆明面
能进企业的东西,权限模型躲不掉。
空间四级角色:Owner / Admin / Contributor / Viewer,资源按知识库归属,每个空间有审计日志。为什么需要:文档权限错一次,比功能少一半更麻烦。
API Key 有权限范围:能力级授权加按知识库限制,带最近使用时间追踪。为什么需要:接进来的第三方脚本不该拿到全量权限。
凭据加密与隔离:API Key、数据源凭据走 AES-256-GCM 静态加密并支持轮换,技能跑在沙箱里按空间配网络策略。官方也写明了:生产环境别把服务直接放到公网。
09接到你常在的地方
知识库建完没人用是常态,它的路子是把入口铺到你已经在的地方。
十个 IM 频道:企业微信、飞书、Lark、微信、QQBot、钉钉、Slack、Telegram、Mattermost、云之家,在群里直接问。
网页嵌入与 MCP:嵌入 Widget 能把问答挂到自己站点,带域名白名单和限流;官方 PyPI 包 tencent-weknora-mcp 提供 29 个工具,支持 stdio / SSE / HTTP 三种传输。
给编码 Agent 的插件:官方的 DeepSeek Harness 插件 dsh-weknora,装上之后工具集里多出四个只读工具,检索、读文档、提问、列知识库。为什么需要:写代码时顺手查规范,比切窗口去搜快得多。
10这些情况别用它
只想问一个文件两个问题:这套东西的部署成本远大于收益,直接用网页版工具更省事,它的价值在长期沉淀。
没人维护文档的团队:先解决有没有人写,再上工具。知识库只会把现有的混乱原样搬进去,检索再准也搜不出没写下来的东西。
不能接受模型调用出内网:得先准备好本地模型(Ollama 那类)再谈落地,不准备的话问答质量会明显低一档。
追新版本的生产环境:它还在 0.x,当前 0.8.0,版本之间改动不小,升级要跑数据库迁移,先在测试环境过一遍再动。
11我的三条判断
同类项目多数停在「文档能问」这一层,它把后半段补齐了:改得动、换得掉、发得出去。这三件事看着不酷,恰恰是自研团队后期最费人力的地方。
真要上手,我会先只跑核心服务,配一个本地模型,喂二十份真实文档看检索质量,再决定要不要上对象存储和知识图谱。可选组件一次全开,出了问题你分得清是组件还是模型吗?先跑通最小可用的一套更好判断。
项目信息
仓库:Tencent/WeKnora语言:Go星标:24,914今日涨星:+696地址:https://github.com/Tencent/WeKnora
上面这条地址点不动,点文末「阅读原文」可直接打开仓库
另外 3 个也值得看
1. cloudflare/security-audit-skill
给编码 Agent 装一个安全审计技能,结论分阶段可复核
★5,799 | 今日 +1,434 | JavaScript | https://github.com/cloudflare/security-audit-skill
2. abue-ammar/tinycast
macOS 启动器加剪贴板历史,常驻内存不到 100MB
★5,270 | 今日 +1,076 | Swift | https://github.com/abue-ammar/tinycast
3. alphaXiv/OpenResearch
把 Claude Code、Codex 变成能查文献、跑实验的研究 Agent
★4,015 | 今日 +1,036 | Rust | https://github.com/alphaXiv/OpenResearch
把文档灌进知识库不难,难的是两年后它还改得动、换得掉、有人在用。
仓库链接放在文末「阅读原文」了。先收着,遇到同类问题能少想一步。
你们团队的文档现在主要放在哪,飞书、语雀还是共享盘?评论区说一个,我挑几款同类工具做下期横评。
如果这篇对你有用
·右下角点个「在看」,让正好需要它的人刷到
·觉得有用就转走,别让它躺在你收藏夹里
·想每天看一个,就关注一下
本文依据 Tencent/WeKnora 的官方 README 整理,关键事实与参数以仓库原文为准;配图取自项目仓库,版权归项目方。