ARTICLE · 1034989
AI Systems Performance Engineering04--分布式网络通信调优
章节概述
在当今 AI 领域,GPU、存储和网络接口之间无缝、低延迟的数据传输已成为刚性需求。本章深入探讨 NVIDIA Magnum IO 平台(包括 NCCL、GPUDirect RDMA、GDS)在训练场景中的应用,以及 NIXL 在解耦推理(disaggregated inference)场景中的作用。这些库及其底层硬件支撑构成了超大规模 AI 系统的关键通信架构。
在大规模系统中,即使是最快的 GPU 也会因低效的通信和内存/磁盘数据传输而受限。本章讨论了加速数据传输的策略、正确的数据分片技术、如何直接操作高速存储子系统,以及 GPU 上通信与计算重叠的高级模式。通信与计算的重叠是 AI 系统性能工程中反复出现的核心模式。
本章的核心论点是:快速的数据传输与原始计算能力同等重要。世界上最快的 GPU 如果持续等待来自 CPU 或其他 GPU 的数据,其价值将大打折扣。 没有单一组件能单独提供峰值性能,只有高速通信、高效数据处理和系统级调优的精心协调与协同设计,才能构建可扩展且健壮的 AI 系统。
本章关键内容路线图
一、通信与计算的重叠(流水线技术)
1.1 核心原理
通信与计算的重叠(Overlapping Communication and Computation),也称为流水线(Pipelining),是构建高效大规模训练和推理系统的关键技术。其核心思想是:确保数据传输与正在进行的计算并发执行,使得当一个任务完成时,下一阶段所需的结果已经在传输中或已经到达。
在分布式训练中,GPU 之间的通信(如梯度 All-Reduce)往往是性能瓶颈。如果通信和计算串行执行,GPU 在通信阶段将处于空闲状态,造成严重的资源浪费。重叠技术的目标是将通信延迟"隐藏"在计算时间之后,使得 GPU 尽可能保持忙碌。
现代深度学习框架(如 PyTorch)支持异步操作,使得集合通信(如梯度 All-Reduce)可以与计算任务并行运行。这减少了 GPU 的空闲时间,提高了整体系统吞吐量。
1.2 CUDA Streams 与异步执行
实现重叠的基础是异步执行机制。GPU 支持多个流(Stream),即可以并发执行或重叠的操作队列。一个流可以处理计算内核(如矩阵乘法),另一个流可以处理通信任务(如数据拷贝和 All-Reduce 调用)。
通过将工作分配到不同的流并使用非阻塞操作,通信可以在后台进行。例如,一个 All-Reduce 操作可以在单独的流上启动,而无需等待完成。同时,默认流继续对独立数据进行进一步计算。这要求通信库(如 NCCL)使用立即返回控制权的非阻塞调用。
关键注意事项:
避免不必要的同步点,如 torch.cuda.synchronize()避免使用 torch.Tensor.item()将张量移至 CPU,这会触发全设备同步如果需要测量整体迭代时间,在迭代末尾放置单个同步点
1.3 减少通信频率与数据量
执行更多计算再进行通信可以增加重叠和效率。主要技术包括:
梯度累积(Gradient Accumulation):不是每个小批次都进行 All-Reduce,而是在几个小批次上累积梯度,在本地求和后再执行一次 All-Reduce。这实际上是用更多内存存储未归约的梯度来换取更少的同步点。例如,累积 4 个小批次可以将 All-Reduce 频率降低 4 倍,但有效批量大小会增加,可能影响模型收敛和内存使用。
压缩与量化:梯度压缩可以减少每次通信中发送的数据量,而不显著影响模型质量。更少的数据意味着更快的传输和更多隐藏传输的机会。极端形式是稀疏化(Sparsification),只发送一部分梯度,但通常需要算法变更以保持精度。
分桶(Bucketing):PyTorch 的 DDP 通信机制将许多小张量分组为更大的消息,减少每次调用的开销。分桶大小是一个权衡:很大的桶最大化带宽利用率但延迟通信开始;很小的桶更早开始传输但因多次小 NCCL 调用而产生更多开销。PyTorch DDP 的默认桶大小为 25 MB。
1.4 代码示例:无重叠 vs DDP 重叠
无重叠方案——手动同步梯度归约:
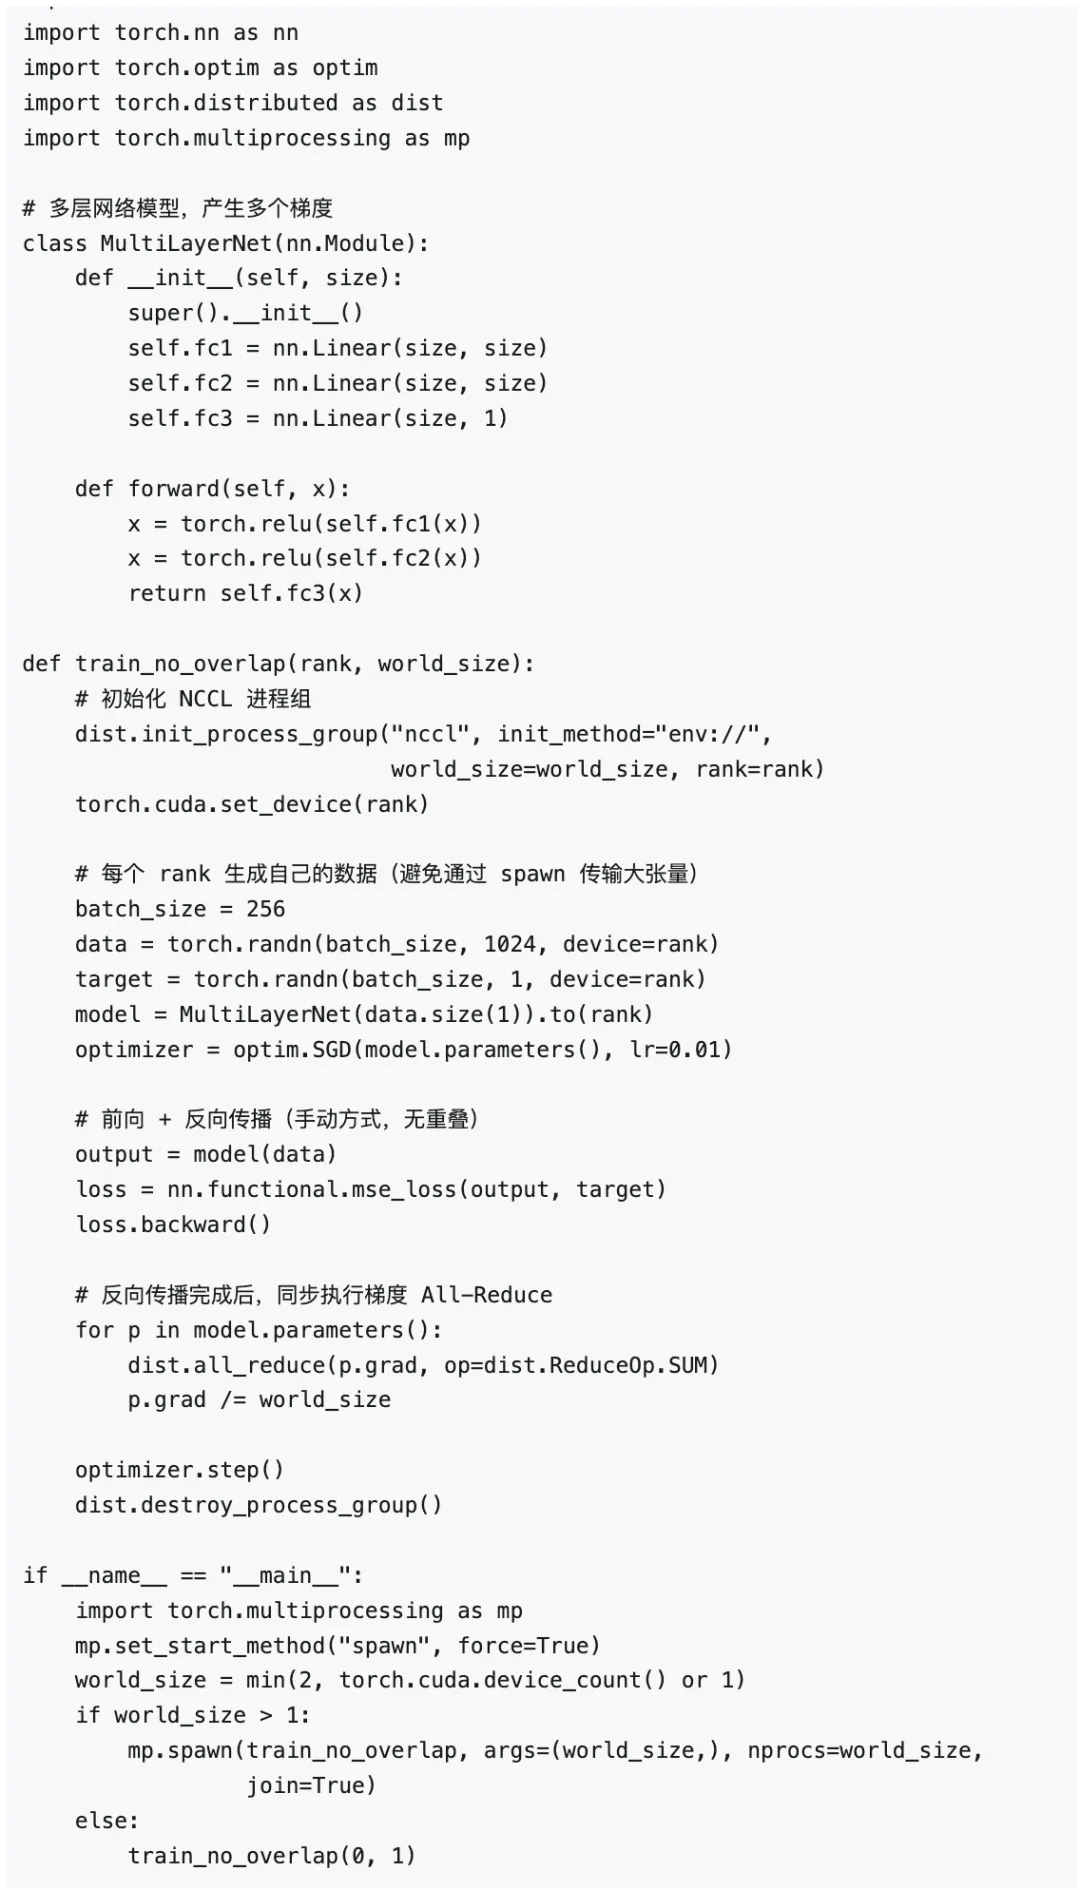
技术要点:此代码中,每个进程独立计算梯度,在 loss.backward() 之后显式执行 All-Reduce。通信完全在计算之后进行,没有重叠。假设前向+反向计算耗时 10ms,梯度 All-Reduce 耗时 12ms,总迭代时间约为 22ms。
DDP 重叠方案:
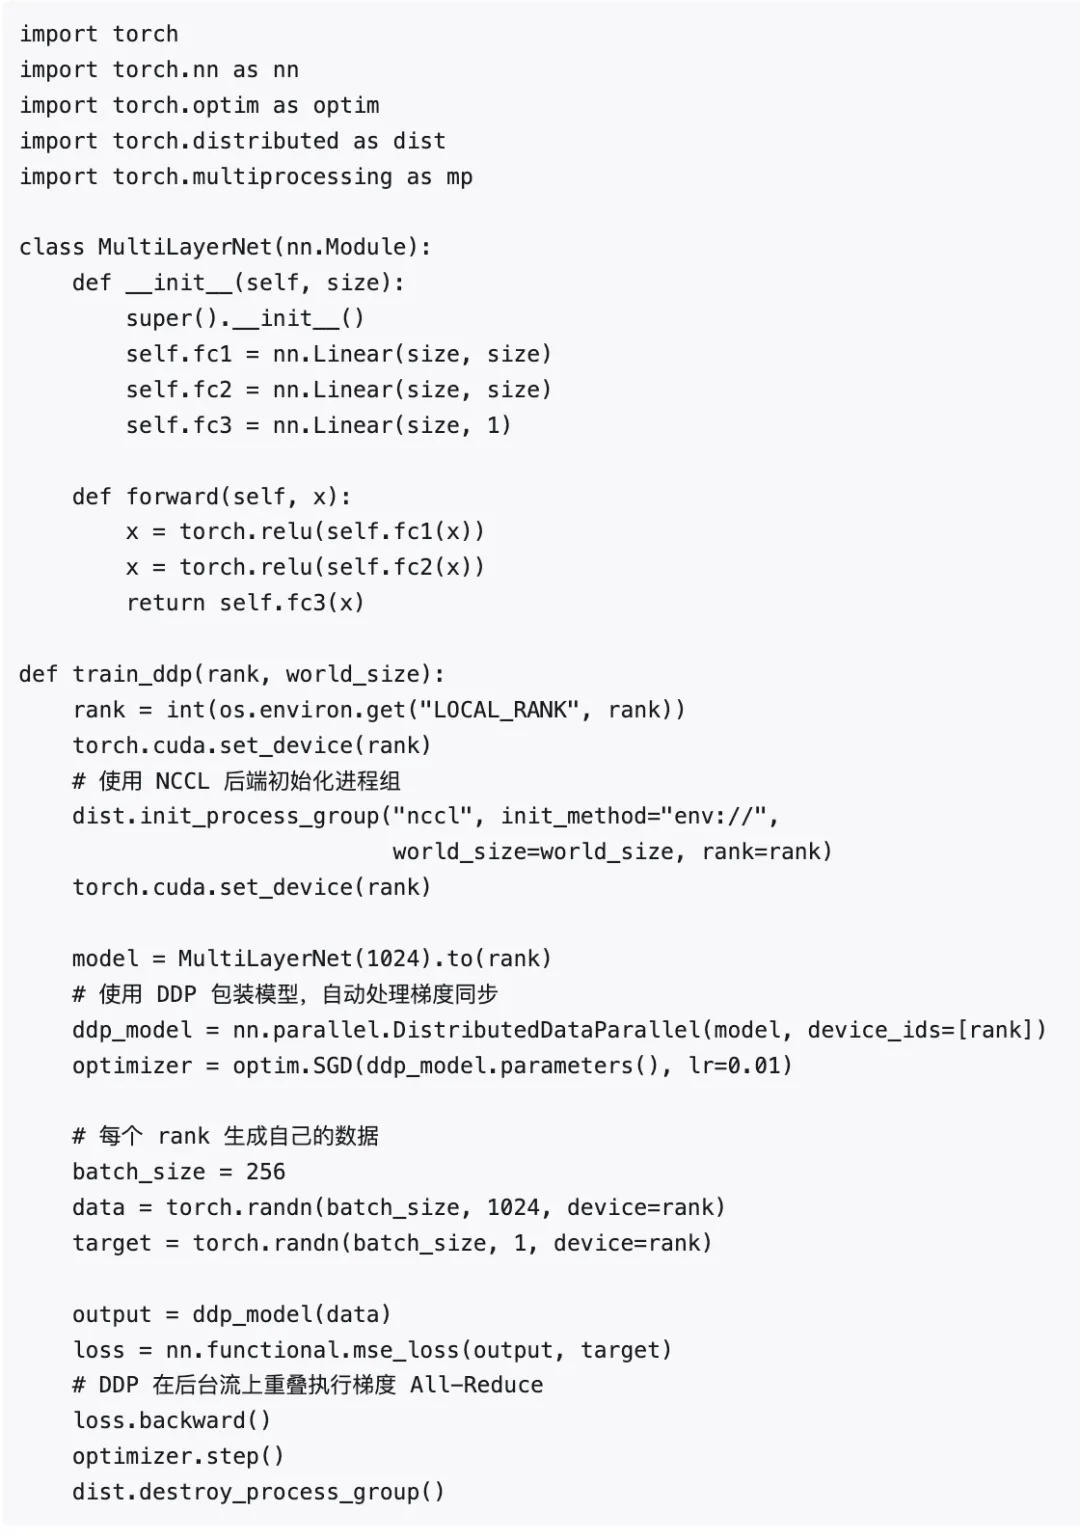
技术要点:DDP 的内部 Reducer 将梯度分成桶,在每个桶就绪时立即在单独的 CUDA 流上启动 NCCL All-Reduce 操作。例如,fc3 的权重和偏置梯度在计算完成后立即进行 All-Reduce(因为它们来自最后一层,在反向传播中最后计算),而 fc1 和 fc2 的梯度在到达反向传播末尾时已经完成 All-Reduce。
1.5 重叠效果性能对比
性能分析:在示例工作负载中,重叠通信与计算可带来约 30% 的迭代时间改善。在更大的训练任务中,收益更为显著,因为更大的模型会产生更多的通信瓶颈。PyTorch DDP 默认使用 25 MiB 的桶大小,通过 bucket_cap_mb 参数可调整。调优桶大小可以帮助增加特定模型拓扑的重叠度,但更大的桶会增加最后一个桶的延迟。
DDP 的默认重叠策略通常被称为无等待反向传播(Wait-Free Backpropagation, WFBP),它将梯度分桶并在每个桶就绪时立即启动归约。唯一无法重叠的通信部分是尾部——最后一个梯度桶如果在最后一次计算之后才完成。
二、NVIDIA Magnum IO 优化栈
2.1 架构概览
Magnum IO 是 NVIDIA 的综合 I/O 加速平台,整合了一系列技术来加速 GPU、CPU、存储和网络接口之间的数据移动、访问和管理。Magnum IO 架构包含四个关键组件,涵盖存储、网络、网内计算和 I/O 管理:
2.2 各组件深度解析
存储 I/O:GDS 允许 GPU 直接从 NVMe 存储设备读写数据,完全绕过 CPU 内存。传统路径需要 SSD → CPU 内存 → GPU 内存的三跳传输,而 GDS 将其缩短为 SSD → GPU 内存的直接路径,大幅减少延迟和 CPU 开销。
网络 I/O:GPUDirect RDMA 是核心网络 I/O 技术,允许 RDMA 能力的 NIC(如 InfiniBand 和 RoCE)直接对 GPU 设备内存执行 DMA 读写操作,跨服务器绕过主机 CPU 和系统 RAM。NCCL 则是在此基础上构建的集合通信库,提供 All-Reduce、All-Gather 等操作的优化实现。
网内计算:SHARP(Scalable Hierarchical Aggregation and Reduction Protocol)在 Quantum 级 InfiniBand 交换机内部执行归约运算。当 NCCL RDMA SHARP 插件启用且架构具备 SHARP 固件和活跃的聚合管理器时,符合条件的集合操作可以卸载到 IB 交换机,减少主机和 GPU 开销。注意:基于以太网的 GPU 集群依赖 RoCEv2 实现 RDMA,但通常缺乏 SHARP 等功能。这是许多超大规模 AI 系统使用 InfiniBand 而非以太网的原因之一。
I/O 管理:NetQ 和 UFM 提供架构级别的可见性和控制能力,帮助运维团队监控网络健康、诊断问题并优化配置。
2.3 Magnum IO 的演进
Magnum IO 持续演进以支持新硬件:
集成 NVLink Switch 网络域支持,实现机架内 GPU 通信的架构级扩展 利用 InfiniBand(Quantum-2 和 Quantum-X800 系列)和以太网(Spectrum-X)的最新进展进一步降低通信开销 在 NVL72 等系统中,Magnum IO 充分利用 NVLink Switch 域的全连接带宽
三、RDMA 高速低开销数据传输
3.1 RDMA 技术原理
RDMA(Remote Direct Memory Access,远程直接内存访问)是一种为低延迟、高吞吐量数据传输而优化的技术。RDMA 的核心机制是允许设备之间直接进行内存到内存的通信,无需 CPU 参与不必要的数据拷贝操作。
具体而言,RDMA 绕过了传统内核网络栈的大部分,允许 NIC 直接读写应用程序内存。这避免了 CPU 参与每个数据包的处理,减少了上下文切换和缓冲区拷贝。
RDMA 与传统 TCP/IP 的性能差异:
3.2 GPUDirect RDMA
NVIDIA 的 GPUDirect RDMA 是针对 GPU 的 RDMA 实现。它允许 RDMA 能力的 NIC(如 InfiniBand 和 RoCE)直接对 GPU 设备内存执行 DMA 操作,跨两个服务器完全绕过主机 CPU 和系统 RAM。
工作原理:
通过将 GPU 缓冲区注册到 NIC,GPUDirect RDMA 启用远程 GPU 之间的单边 RDMA 读写 这最小化了多节点训练中的延迟和 CPU 开销 数据路径:GPU 内存 → NIC → 网络 → NIC → GPU 内存(无 CPU 参与)
3.3 InfiniBand 与 RoCE
RDMA 由 InfiniBand 原生支持,也可通过某些高速以太网网络以 RoCE(RDMA over Converged Ethernet)形式支持。使用 RoCE 时,可以在以太网上获得类似 RDMA 的零拷贝传输,前提是网络设备支持 RDMA 且正确配置。使用 RDMA 与 RoCE 通常需要正确配置的系统,包括 NVIDIA OFED 驱动。
关键配置要点:
如果只有以太网可用,应使用最高带宽和最低延迟的配置 200+ Gbps 以太网配合 RDMA(RoCE)对 All-Reduce 流量的表现远优于基本 10-25 Gbps TCP 网络 至少确保使用巨型帧(Jumbo Frames),如 MTU 9000 调优 TCP 栈参数: net.core.rmem_max/wmem_max和net.ipv4.tcp_rmem/tcp_wmem使用现代 TCP 拥塞控制算法(如 BBR)以改善高延迟链路的吞吐量
3.4 容器环境中的 RDMA 陷阱
在 Docker 和 Kubernetes 等容器环境中,确保容器可以直接访问主机的 InfiniBand 设备(如 /dev/infiniband)至关重要。否则,NCCL 可能会静默回退到 TCP 套接字而非 GPUDirect RDMA,且不会有任何明显的错误提示。这导致吞吐量从数十 GB/s 骤降至仅几 Gb/s。
验证 RDMA 是否真正工作的方法:
确认内核模块已加载: lsmod | grep nvidia_peermem检查 dmesg 中的初始化信息 运行 NCCL 时设置 NCCL_DEBUG=INFO确认 NET/IB 路径使用 RDMA perftests 配合 --use_cuda验证 GPU 到 GPU 传输
另一个容器陷阱是容器的 GID 分配与主机不匹配(如某些 "rdma-shared" Docker 镜像),这会阻止 GPUDirect 注册,转而使用 CPU 驱动的 RDMA 拷贝而非真正的 GPU RDMA。
3.5 CPU 亲和性
即使使用 RDMA,CPU 也不完全脱离。主机仍需设置 RDMA 传输和处理通信完成事件。因此,正确的 CPU 亲和性很重要:
将网络中断处理或轮询线程绑定到与 NIC 同一 NUMA 节点的 CPU 核心 理想情况下也与 GPU 在同一 NUMA 节点 例如,如果 InfiniBand HCA 在 NUMA 节点 0,将其中断 CPU 亲和性核心绑定到节点 0
四、多节点连接调优
4.1 理解拓扑
使用 nvidia-smi topo -m 获取基本 GPU 互连视图,但对于 NVSwitch 和 NVLink 系统,建议还使用 nvidia-smi nvlink 或 Nsight Systems 来理解多跳交换架构的连接性。
4.2 利用 NVLink Switch 域
NVIDIA GB200 和 GB300 NVL72 机架解决方案使用 NVLink Switch 在单个 NVLink 域中连接多达 72 个 GPU,提供极低的每跳延迟(约几百纳秒量级)。GB200 NVL72 架构提供高达约 130 TB/s 的全对全带宽,跨机架所有 GPU 的亚微秒延迟。
如果集群包含此类基础设施,确保作业放置在同一 NVLink 域内以充分利用这一超快互连。这可以显著减少对较慢的 InfiniBand 和以太网通信的需求。
4.3 聚合多 NIC 带宽
一些服务器有多个网络接口(NIC)。NCCL 可以跨多个 NIC 分条传输(称为多轨/multirail)以增加带宽。需要设置环境变量如 NCCL_NSOCKS_PERTHREAD 和 NCCL_SOCKET_NTHREADS 来优化。确保每个 NIC 在不同子网上且 NCCL 能发现两者。正确配置下,两个 800 Gbps NIC 并行可获得 1.6 Tbps 的聚合带宽;四个此类 NIC 链路(如两个双端口 NIC)可达约 3.2 Tbps。
4.4 直接 NIC 模式
现代 GPU 系统中,NCCL 支持 GPU 发起的网络通信,使用 InfiniBand GPUDirect Async (IBGDA) 和直接 NIC 路径。这让 GPU 可以驱动全带宽 RDMA 而无需 CPU 介入,进一步降低延迟。
五、多节点通信陷阱
5.1 陷阱 #1:使用 CPU 绑定的 Gloo 后端而非 NCCL
PyTorch 的分布式框架支持多个通信后端。对于多 GPU 训练,NCCL 是 NVIDIA GPU 的首选后端,但也有一个名为 Gloo 的回退后端,它使用 CPU 和 TCP 套接字。如果错误地使用 Gloo 初始化 ProcessGroup 进行 GPU 训练,或者 NCCL 初始化失败后回退到 Gloo,训练仍能正常运行,但所有跨 GPU 通信都将通过 CPU 和以太网栈,导致极其缓慢的性能。
代码示例——Gloo 后端(不推荐):
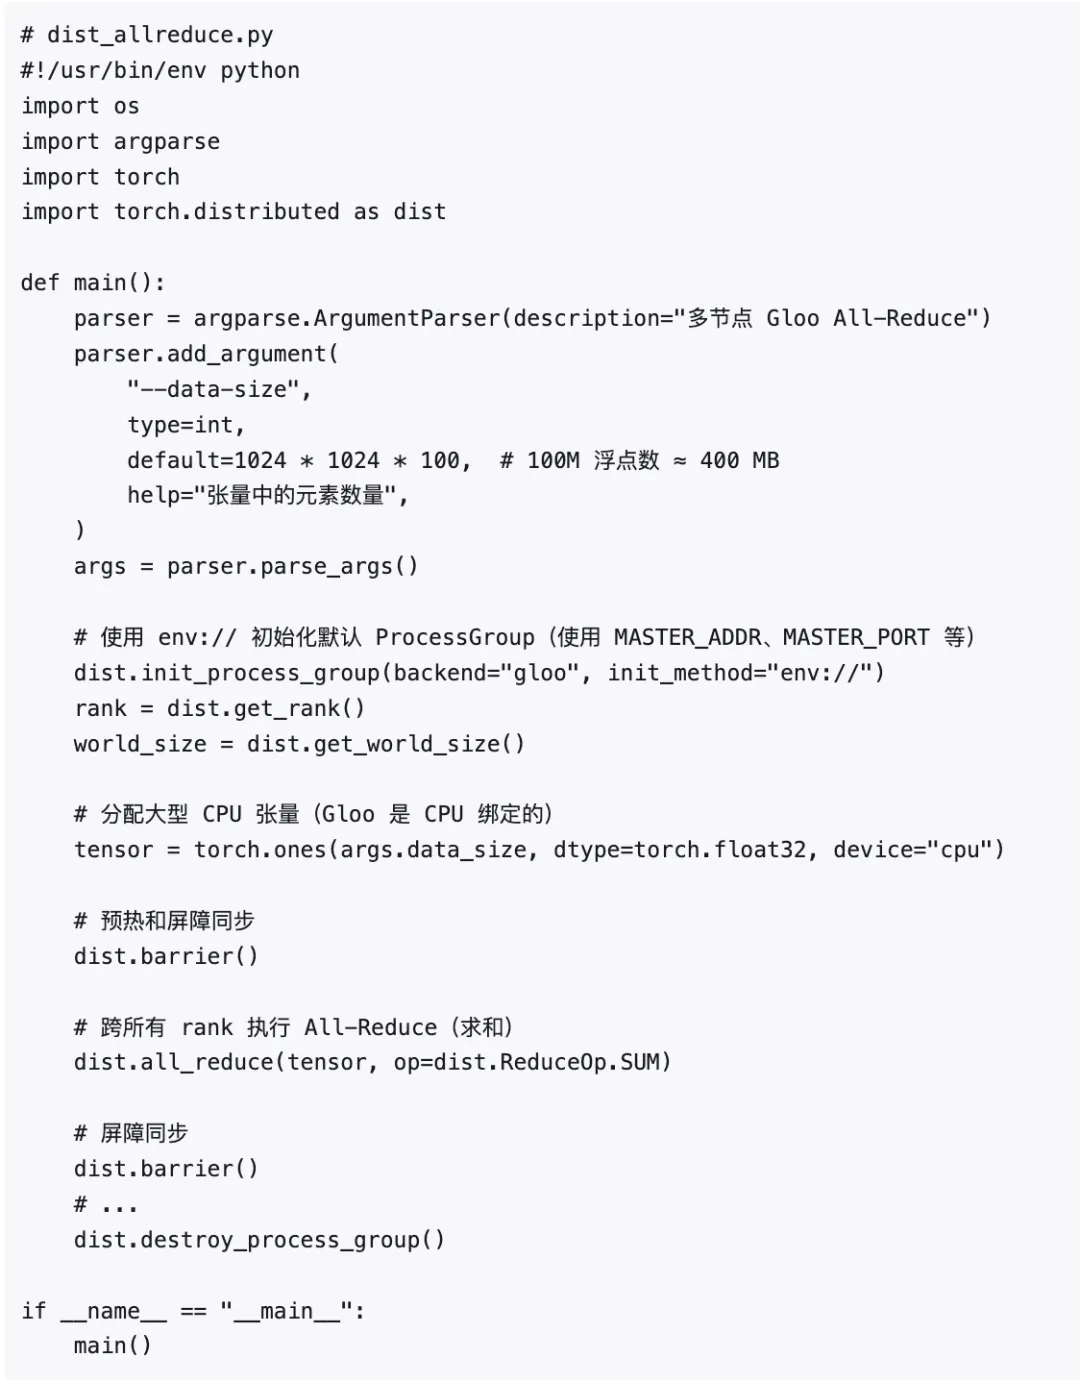
性能对比:
NCCL 比 Gloo 快两个数量级,达到硬件线速极限。使用 Gloo 时 CPU 利用率接近 100%,而使用 NCCL 时 GPU 直接执行通信。
生产环境建议:在多 NIC 集群中,应显式设置 NCCL_SOCKET_IFNAME=ib0,使 NCCL 的初始 TCP 握手通过 InfiniBand HCA 运行,确保正确引导后切换到 GPUDirect RDMA 的最快路径。
5.2 陷阱 #2:NCCL 版本不匹配
如果运行 PyTorch 捆绑的 NCCL(如 torch.cuda.nccl.version() == ())与系统安装的不同版本 libnccl,会导致系统挂起或静默回退到较慢的实现。确保通过匹配 nvidia-nccl-cu* 包或重新构建 PyTorch 以对齐系统 NCCL 来避免兼容性问题。
5.3 陷阱 #3:NCCL 引导期间 TCP 端口耗尽
NCCL 使用临时 TCP 端口进行带外设置。如果操作系统的 net.ipv4.ip_local_port_range 太窄,可能耗尽可用端口,导致握手失败或停滞。建议在 /proc/sys/net/ipv4/ip_local_port_range 中扩大端口范围(如 50000 51000)。
5.4 陷阱 #4:网络带宽不足或 NIC 配置错误
当 GPU 集群扩展时,网络带宽不足或未使用所有可用接口的问题变得更加常见。例如,单个 400 Gbps 链路很容易被 Blackwell GPU 饱和。
监控工具:
nvidia-smi dmon:收集 NVLink/PCIe/网络统计ethtool -S <iface>或ip -s link show <iface>:字节/包计数器iftop或nload:实时 NIC 吞吐量
多 NIC 调优:如果需要更多网络吞吐量,启用 NCCL 的多 NIC 支持。设置 NCCL_NSOCKS_PERTHREAD 和 NCCL_SOCKET_NTHREADS 控制并行连接数和线程数。例如,两个 NIC 时可设置 NCCL_NSOCKS_PERTHREAD=2 和 NCCL_SOCKET_NTHREADS=2(2 线程 × 2 套接字 = 4 总连接)。但线程和套接字的乘积不应超过 64(NVIDIA 指导值),逐步增加并持续测量吞吐量。
5.5 陷阱 #5:落后节点或进程
在多节点训练中,最慢的节点或 GPU 将决定整体进度,因为同步需要等待每个节点和 GPU 响应。
检测落后节点:
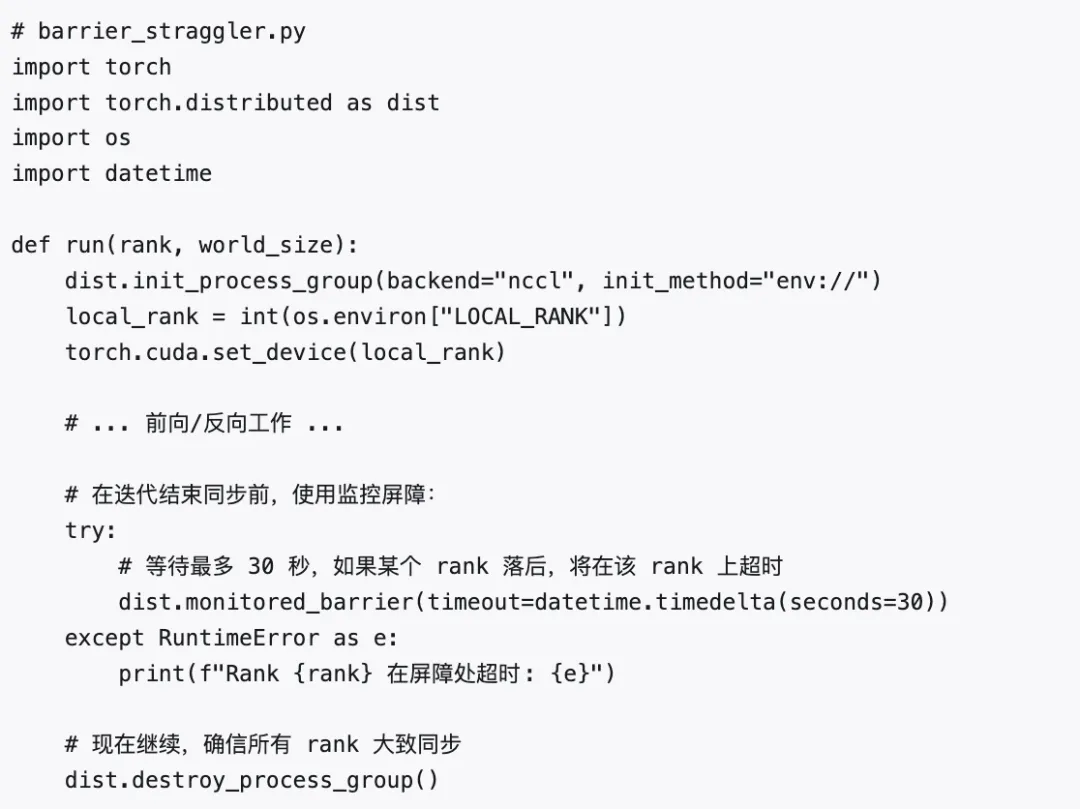
dist.monitored_barrier(timeout=datetime.timedelta(seconds=30)) 会在任何 30 秒内未到达的 GPU 上引发错误,帮助定位落后者。结合 NCCL_DEBUG=INFO 和 NCCL_ASYNC_ERROR_HANDLING=1 获取 PyTorch 和 NCCL 日志。
5.6 陷阱 #6:UCX/RDMA 下的 GPU 内存碎片化
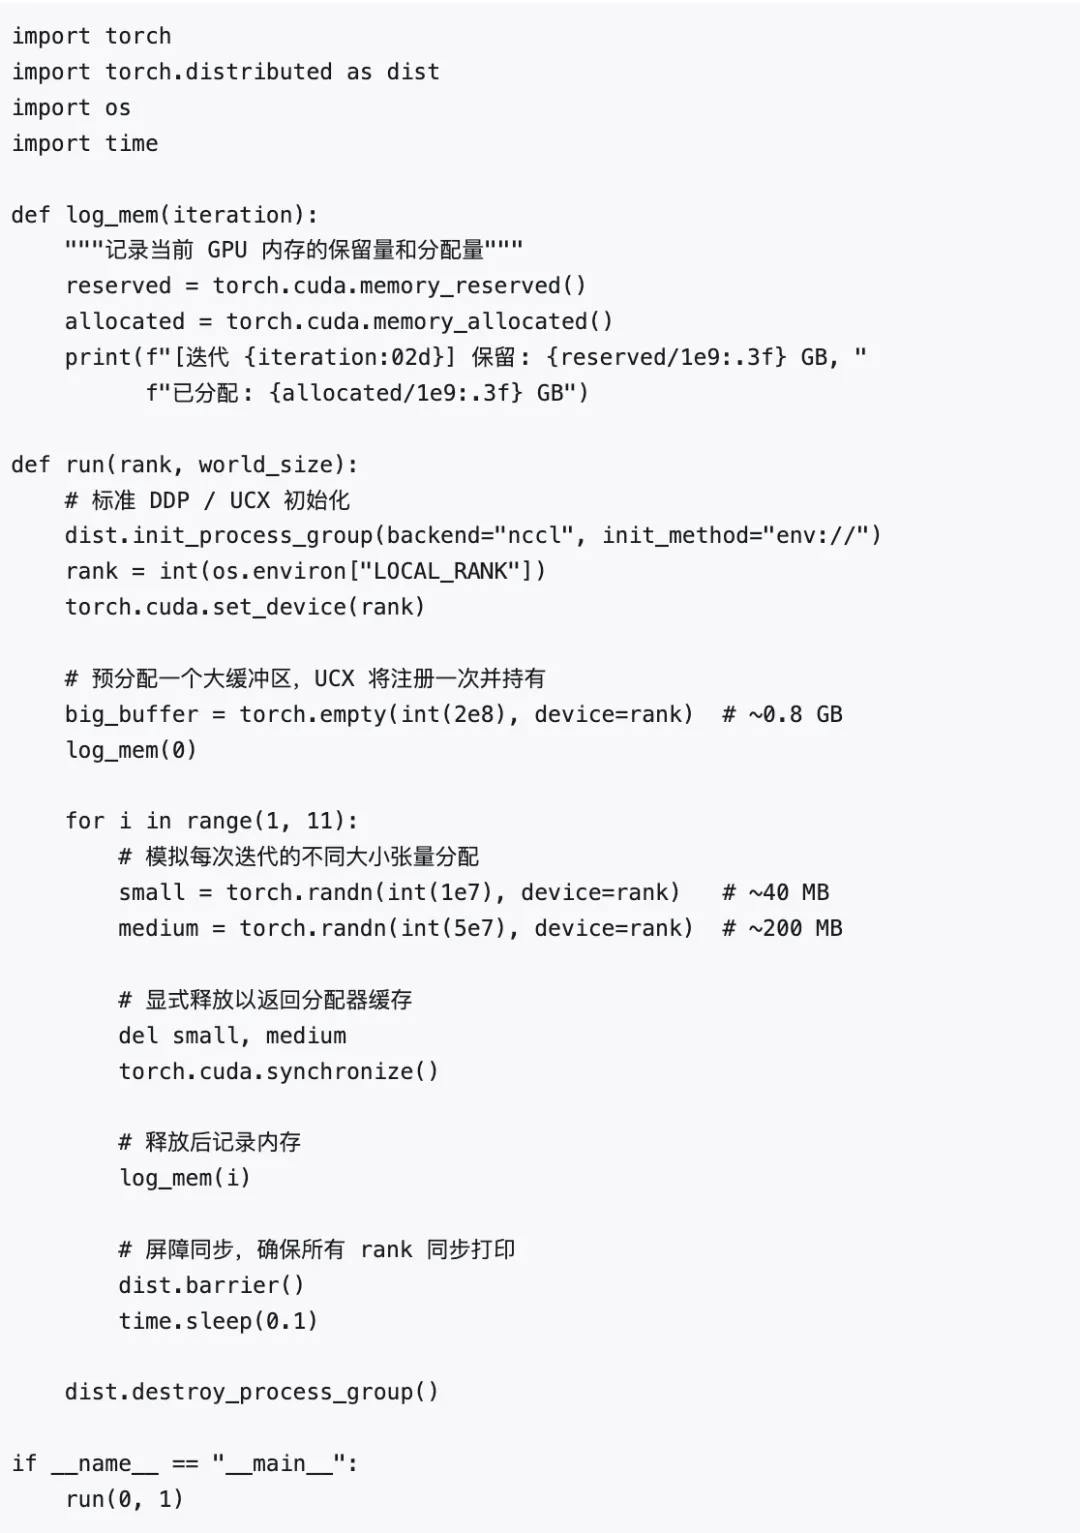
PyTorch 的缓存分配器在迭代间保持 GPU 内存。在使用 UCX/RDMA 的分布式设置中,这些长期存活的分配可能耗尽注册池或碎片化内存,导致偶发的分配失败或性能断崖。
监控内存碎片化:
输出示例:
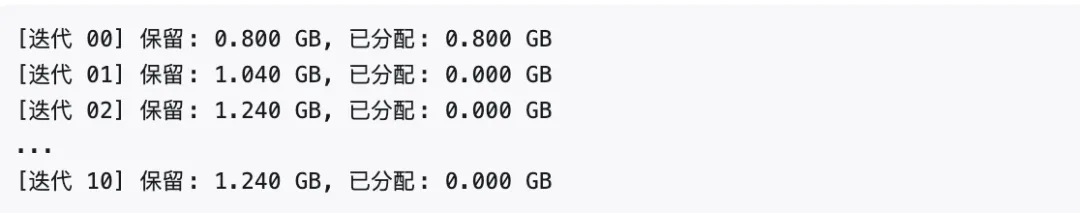
保留内存每次迭代增长,因为缓存分配器持有已释放的块以加速未来分配,但从不将它们返回给 OS 或 UCX 注册池。缓解措施包括升级到最新的 CUDA 运行时,或使用 torch.cuda.empty_cache() 作为最后手段。
六、NCCL 分布式多 GPU 通信深度解析
6.1 NCCL 概述
NVIDIA NCCL(NVIDIA Collective Communications Library)是一个多对多通信库,用于 GPU 组之间共享数据的集合操作。NCCL 支撑了 NVIDIA 生态系统中大多数多 GPU 训练工作负载。
NCCL 提供集合通信操作的优化实现,包括 All-Reduce、All-Gather、Broadcast 和 Reduce-Scatter,可从几个 GPU 扩展到数千个。在分布式训练中,每个 GPU 计算其数据部分的梯度,NCCL 用于跨所有 GPU 执行梯度的 All-Reduce,使每个 GPU 用平均梯度更新模型权重。
NCCL 针对 NVIDIA GPU 优化,支持 PCIe、NVLink、NVSwitch、InfiniBand 和 TCP 套接字等多种互连,自动选择任意两个 GPU 之间最快的路径。
6.2 拓扑感知
拓扑感知在 NCCL 性能中扮演重要角色。NCCL 检测 GPU 的物理连接方式并相应优化通信模式。
层次化通信示例:考虑一个拓扑,其中 GPU 0-1 共享 NVLink 连接,GPU 2-3 共享另一个 NVLink 连接,但 0-1 对和 2-3 对之间的任何通信必须通过较慢的 PCIe 互连。NCCL 的层次算法将:
首先在每个 NVLink 连接对上执行归约集合操作 然后通过 PCIe 链路从每对中选一个 GPU 进行跨组归约交换 最后在每对内再次分发数据
这样,慢速 PCIe 链路只处理一小部分数据。
性能影响:
NVL72 的特殊优势:在 NVL72 机架中,所有 72 个 Blackwell GPU 都是单个 NVLink Switch 域的一部分。任何 GPU 可以在单个 NVSwitch 阶段以全双分带宽到达任何其他 GPU。每个 Blackwell GPU 支持 18 条 NVLink 5 链路,每条约 100 GB/s,总计约 1.8 TB/s 的 GPU 到 GPU 双向聚合带宽,是上一代 900 GB/s 的两倍。
Grace Blackwell 超级芯片:NVIDIA 超级芯片模糊了 CPU 和 GPU 内存之间的界限,提供 CPU 和 GPU 之间约 900 GB/s 的 NVLink-C2C 互连。这意味着即使 All-Reduce 的某些部分涉及 CPU 或系统内存,速度仍可能与较旧的 GPU-GPU 链路相当。
6.3 NCCL 通信算法详解
NCCL 内部可根据数据大小、GPU 数量和拓扑采用不同的通信算法。以下是主要算法的深度解析:
6.3.1 Ring(环形算法)
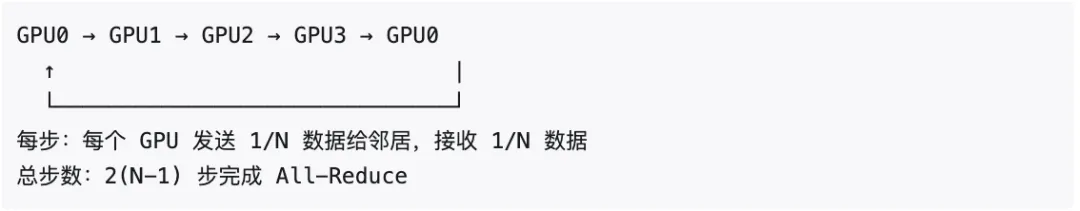
原理:在环形 All-Reduce 中,GPU 在逻辑上排列成环形。每个 GPU 向其邻居发送数据并从另一个邻居接收数据,以流水线方式进行。对于 All-Reduce,数据的每个块将在环中循环,累积部分和。
性能特征:
完美平衡网络负载,每个 GPU 发送和接收完全相同数量的数据 带宽最优:每条链路传输 2 × (data_size ÷ num_gpus) 字节 延迟随 GPU 数量线性增长(O(N)),因为数据必须遍历所有跳 - 适用场景
:大消息(带宽主导型工作负载),因为传输大量字节的时间远超启动传输的成本
数据流示意(4 GPU Ring All-Reduce):
6.3.2 Tree 和 NVLSTree(树形算法)
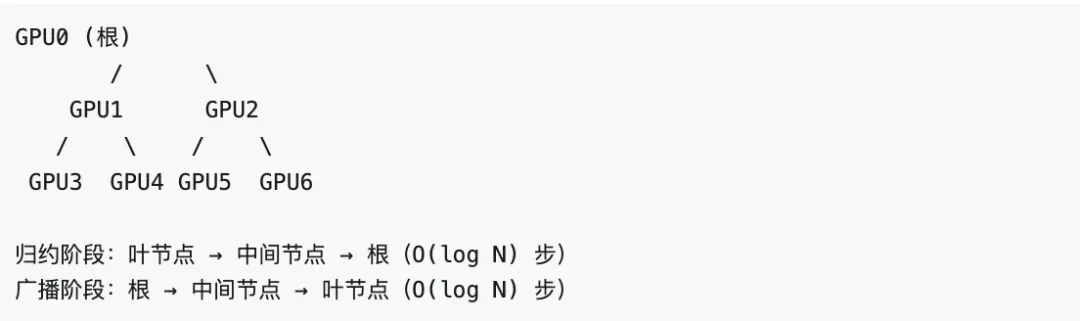
原理:使用生成树算法,在树结构中进行归约和广播。All-Reduce 实际上是 Reduce-Scatter 后跟 Broadcast。树算法可以在 O(log N) 步内完成 All-Reduce(N 个 GPU),而环形需要 O(N) 步。
性能特征:
对小消息提供更低延迟 可能无法为大消息充分利用所有链路(不是所有 GPU 都在所有时间传输) - 适用场景
:小消息(延迟主导型工作负载),总时间由传输启动延迟主导 NVLSTree 启用 NVLink SHARP 卸载
树形结构示意:
6.3.3 CollTree(层次化树集合通信)
原理:构建两层树以减少延迟同时保持高本地带宽。在每个快速本地域(如节点上所有 GPU 或一个 NVSwitch 岛内)内,形成本地树并执行 Reduce-Scatter 后跟 Broadcast。每个本地组的一个领导者然后通过 RDMA 参与跨组的二级树。两层是流水线化的,完成本地阶段的张量块可以立即进入跨组阶段。
性能特征:
将跨节点步数减少到 O(log N),缩短中小消息的延迟 仍使用节点内全带宽 在 NVLink 域上,本地树通过 NVSwitch 路由,可用 NVLink SHARP 进行交换机内聚合 在 InfiniBand 架构上,跨组树可在 NCCL SHARP 插件启用时卸载到 SHARP - 适用场景:跨节点延迟主导时优先选择;极大消息时 Ring 或 PAT 可能达到更高峰值吞吐量
6.3.4 CollNet(跨节点层次化集合通信)
原理:也称为树并行,结合两种集合策略以优化不同规模的通信。首先,将共享快速本地互连的 GPU 分组(如单节点内所有 GPU 或 NVSwitch 岛内),然后在每组内应用高吞吐量算法(如 Ring 或本地树)聚合数据。每组一个指定的领导者 GPU 参与跨组的二级树归约。
性能特征:
最小化跨组通信轮数 同时提供跨节点传输的低延迟和节点内流量的高带宽 - 适用场景:减少超大多节点 GPU 集群的网络负载
6.3.5 PAT(并行聚合树)
原理:PAT 是 NCCL 的 Ring 和 Tree 算法的流水线混合体。一旦张量的一个段在其 GPU 树上完成归约,下一个段同时以交错、轮询方式开始自己的树归约。这种连续归约阶段的重叠使 PAT 保持链路饱和并达到接近纯 Ring All-Reduce 的带宽。同时,它将每个段的传输启动延迟限制在 O(log N),与 Tree 算法类似。
性能特征:
将大消息分成多个块 对块 1 启动基于树的 Reduce-Scatter,然后立即对块 2 执行相同操作,依此类推 交错执行使始终有工作在进行中 - 适用场景:大消息传输的近 Ring 级吞吐量 + 小段的 Tree 级延迟优势,两全其美
算法选择总结:
NCCL 默认自动选择最佳算法。可通过 NCCL_ALGO 环境变量覆盖(如 NCCL_ALGO=NVLSTree,PAT),但通常仅在故障排除或研究实验时需要。
NCCL 还支持 NVSwitch 的硬件多播用于 NVLink 域内的一跳广播,以及 SHARP(InfiniBand 上)和 NVLink SHARP(NVLS,NVSwitch 架构上)来加速 All-Gather 和 Reduce-Scatter 等集合操作。
七、分布式数据并行策略
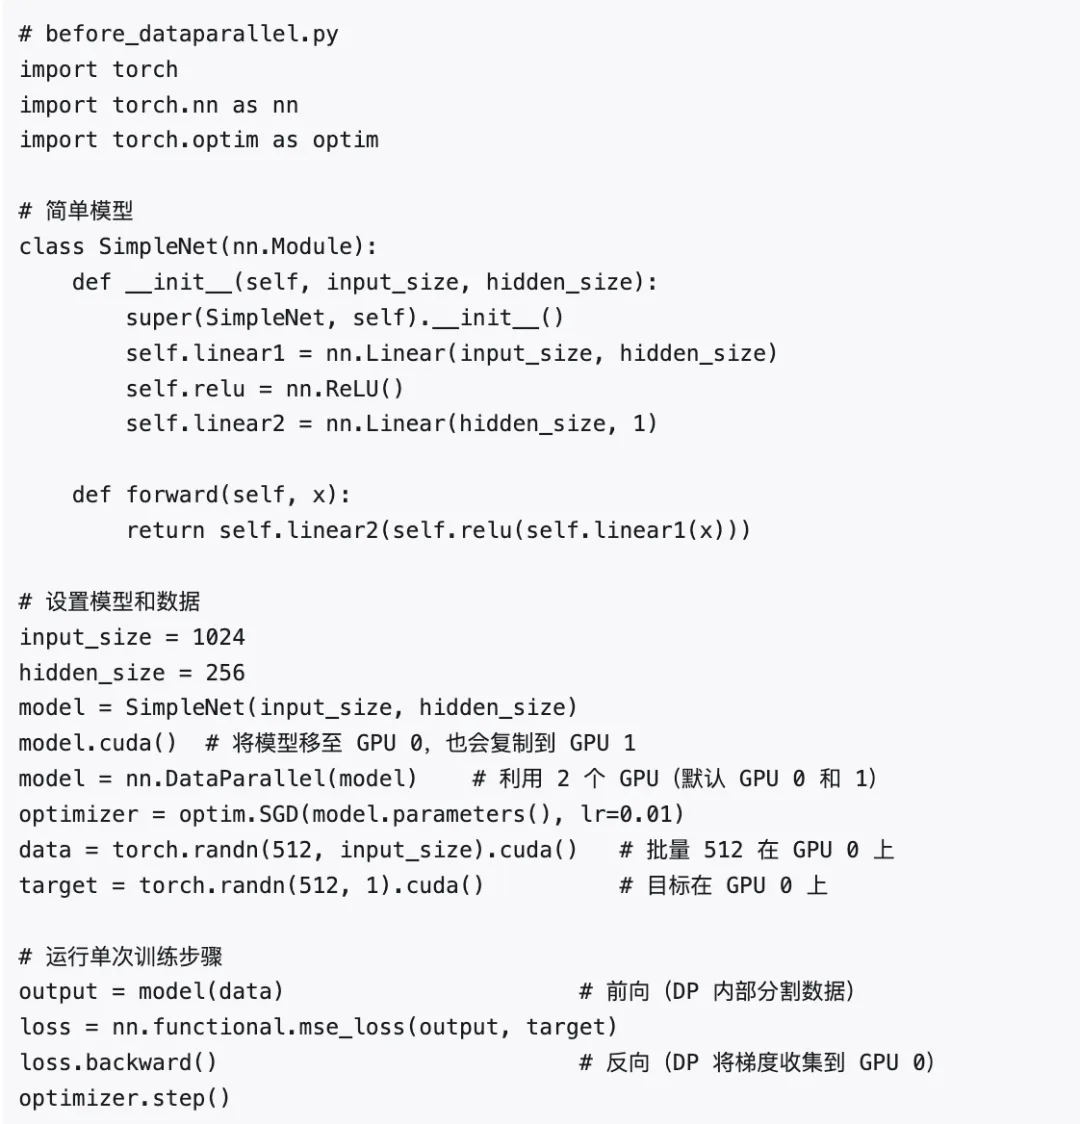
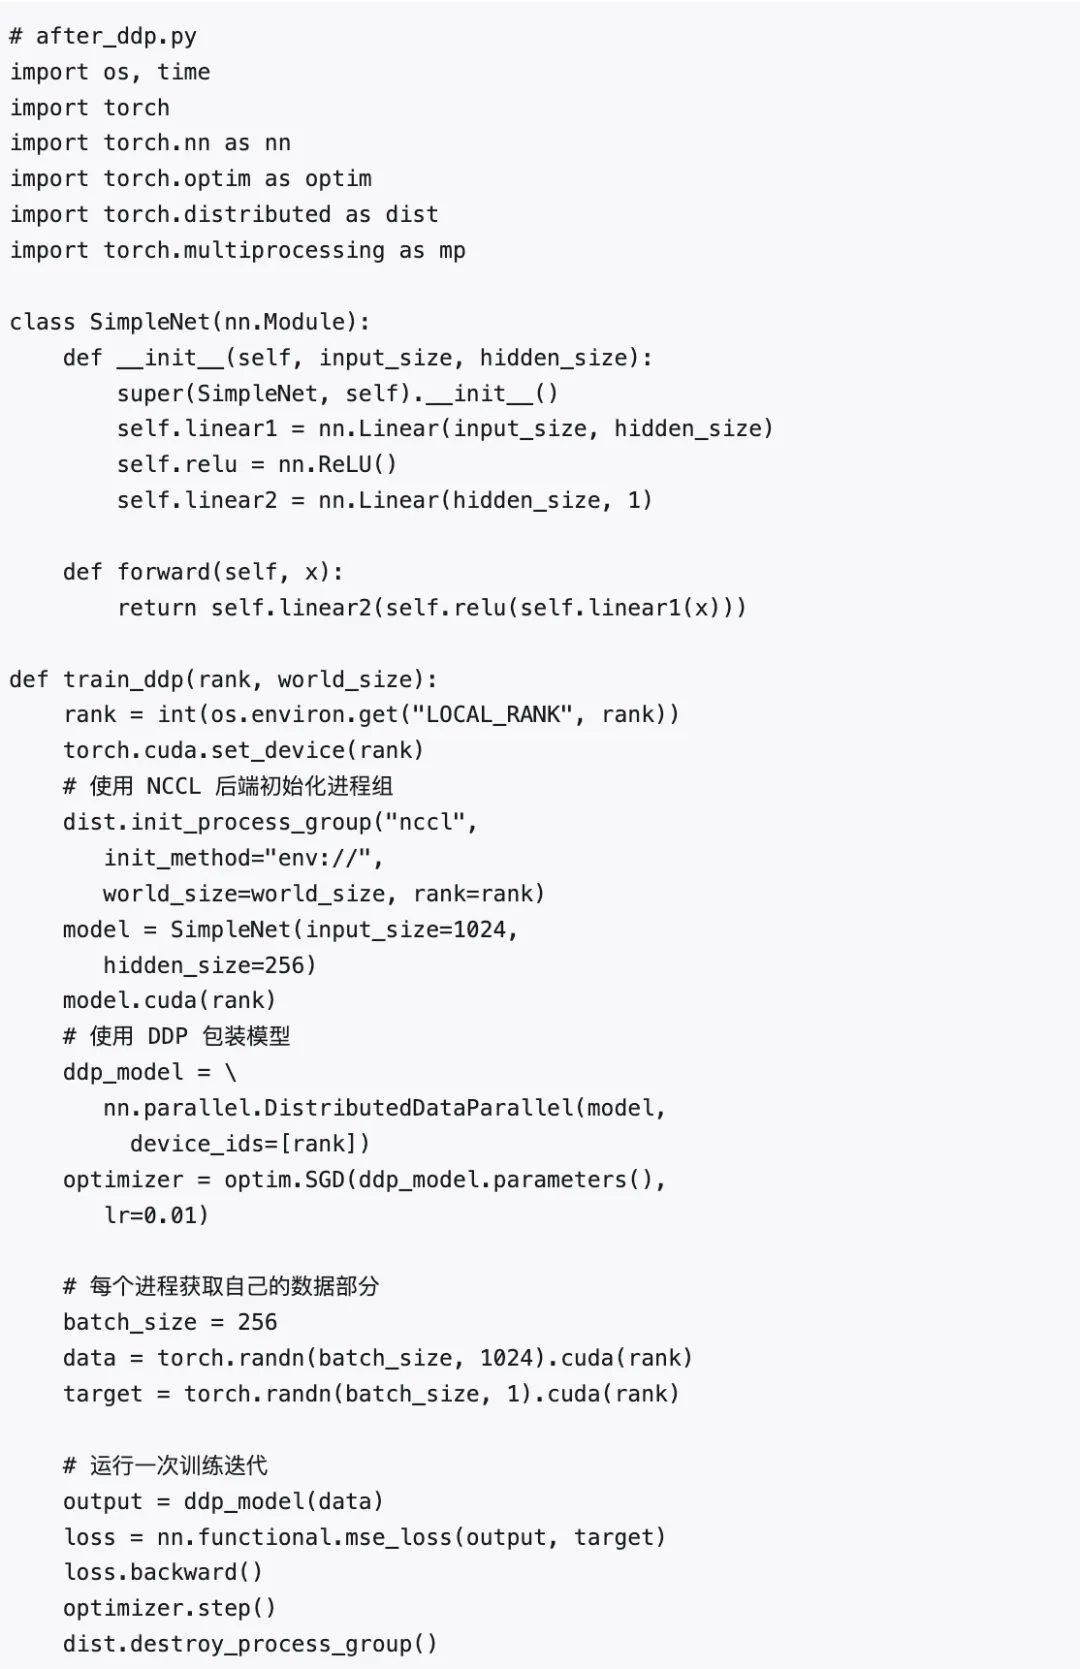
7.1 DataParallel (DP) vs DistributedDataParallel (DDP)
7.2 代码对比
DataParallel 示例:
DDP 示例:
运行方式:
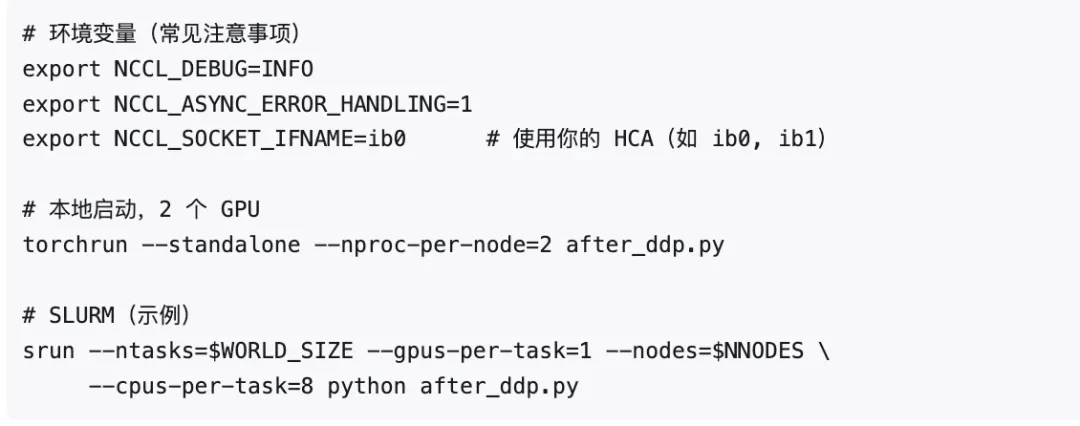
性能对比:在示例中,DDP 耗时 30ms 而 DP 耗时 45ms,DDP 快 33%。改进来自多个因素:
每个进程处理半批量,无 Python GIL 竞争,真正并行 梯度使用 NCCL All-Reduce,与反向计算重叠 无额外梯度拷贝到单一聚合 GPU 通信工作分散到所有参与 All-Reduce 的 GPU
7.3 FSDP(全分片数据并行)
FSDP 通过在 GPU 间分片激活值、梯度和参数来避免完整模型副本,大幅减少内存开销。对于超大规模模型,FSDP 通常与张量并行和流水线并行等其他并行策略组合使用。
八、NCCL 通信器生命周期与环境陷阱
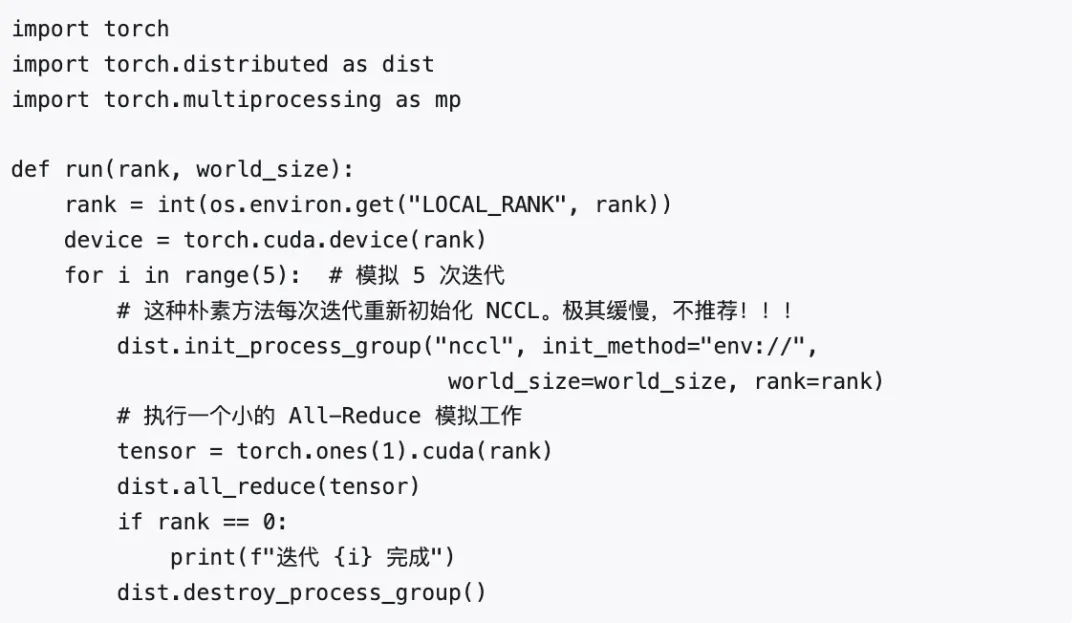
8.1 陷阱 #1:过于频繁创建 NCCL 通信器
NCCL 通信器代表一组可以集体通信的 GPU(rank)。创建通信器(C++ 的 ncclCommInitRank 或 PyTorch 的 torch.distributed.init_process_group)是昂贵操作。初始化器要求所有 rank 交换信息(唯一 ID、网络地址等),设置环/树并分配缓冲区。
错误做法——每次迭代重新初始化:
正确做法——循环外初始化一次:
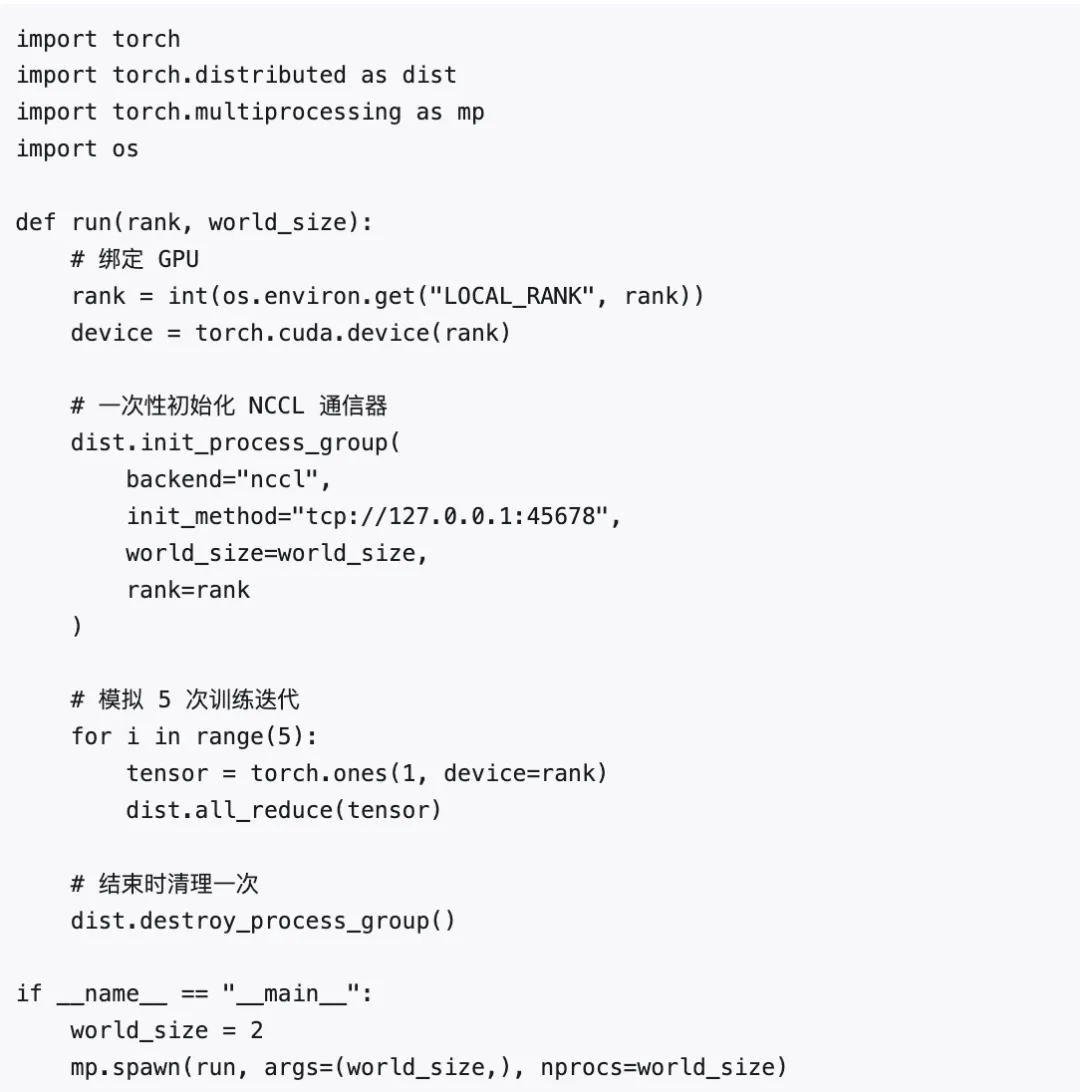
性能影响:
将通信器设置和拆除移出循环后,总迭代时间减少超过 98%。
8.2 陷阱 #2:不要在每次迭代创建和销毁 NCCL 通信器
在定义模型并行和流水线并行的进程子组时,小心不要意外创建新的 NCCL 通信器。应在开始时使用 torch.distributed.new_group() 创建子通信器并重用。如果需要创建多个通信器,NCCL 提供 C++ API 用 ncclGroupStart()、ncclCommInitRank(...) 和 ncclGroupEnd() 一起初始化多个通信器以减少开销。
8.3 陷阱 #3:避免过度调优或禁用 NCCL 功能
关键环境变量:
8.4 陷阱 #4:验证 CPU-GPU NUMA 节点亲和性
NCCL 启动后台 CPU 线程进行网络轮询和内核调度。如果进程被绑定到狭窄的核心集,NCCL 可能将所有线程压缩到单个核心,导致调度不良和低吞吐量。
解决方案:设置 NCCL_IGNORE_CPU_AFFINITY=1,让 NCCL 忽略继承的 CPU 亲和性掩码,自由地将工作线程分布在本地 NUMA 域的核心上。推荐做法是将每个 GPU 进程绑定到其 NUMA 域的 CPU 核心,然后设置 NCCL_IGNORE_CPU_AFFINITY=1。
示例:双 NUMA 节点域、8 GPU 系统:
GPU 0-3 连接到第一个 CPU → 将 rank 0-3 绑定到第一组 CPU 核心 GPU 4-7 连接到第二个 CPU → 将 rank 4-7 绑定到第二组 CPU 核心 设置 NCCL_IGNORE_CPU_AFFINITY=1
8.5 陷阱 #5:不要忽视 NCCL 警告和错误
关键警告示例:
"unable to enable P2P, falling back to copy" → NCCL 无法建立直接 GPU P2P,数据传输将通过主机 CPU 内存缓冲区,速度大幅降低 "NET/Socket: using Ethernet interface eth0" → 使用的不是最高性能互连,需设置 NCCL_SOCKET_IFNAME=ib0
8.6 陷阱 #6:NCCL 通信器挂起、错误或完全关闭
如果一个进程崩溃或一个 GPU rank 遇到错误,NCCL 通信器可能挂起其他 rank。在大规模集群中,GPU 故障的频率相对较高。
Meta Llama 3 405B 预训练 54 天中断统计:
设置 NCCL_ASYNC_ERROR_HANDLING=1 可提高弹性,允许 NCCL 在错误时异步中止。PyTorch 近期版本在使用 init_process_group 时默认设置此值,但建议显式设置以确保清晰和可重现性。
九、NCCL 性能分析与调试
9.1 NCCL 分析器插件 API
NCCL 支持异步错误处理和故障转移。启用方式:NCCL_ASYNC_ERROR_HANDLING=1。调试时启用 NCCL_DEBUG=WARN 或 INFO。
NCCL 分析器插件 API 允许监控 GPU 通信的内部时间线,定位任何滞后设备或瓶颈。插件通过 NCCL_PROFILER_PLUGIN 环境变量动态加载。
插件架构:
事件激活掩码(32 位整数),每位对应一个不同的 NCCL 事件 五个回调函数: init(初始化)、startEvent(开始事件)、stopEvent(停止事件)、recordEventState(记录事件状态)、finalize(终结)
PyTorch 的 Kineto 可以通过 CUPTI 和 NVTX 收集 NCCL 活动,即使 NCCL 插件未启用。
十、网内 SHARP 聚合
10.1 SHARP 技术原理
SHARP(Scalable Hierarchical Aggregation and Reduction Protocol,可扩展层次聚合与归约协议)是 InfiniBand 网内归约技术,与 Quantum 级 InfiniBand 交换机配合使用,通过 NCCL-SHARP 插件实现。在 NVLink 域中,类似功能是 NVLink SHARP(NVLS),在 NVSwitch 架构内卸载集合操作。
核心机制:SHARP 使集合操作(如 All-Reduce)部分由网络架构计算。当来自多个 GPU 的数据流入交换机时,交换机会归约/聚合(如求和)数据并共享部分归约结果。这节省了每个 GPU 冗余传输许多中间结果的需要。
10.2 SHARP 性能分析
Ring Reduce-Scatter 对比:
无 SHARP:每个 GPU 接收 B(n-1)/n 字节,跨 (n-1) 跳 有 SHARP:交换机聚合并仅返回 B/n 给每个 GPU 每端点接收量减少为 1/(n-1)
All-Gather 对比:
NVLS 硬件多播让每个 GPU 发送其 B/n 段一次,网络复制 发送方数据量减少为 1/(n-1)
重叠效果:当多播 All-Gather 与网内 Reduce-Scatter 重叠时,端到端阶段时间可降低约 1/2(带宽受限阶段),因为网络执行聚合和复制工作而非端点。有效分片交换时间是两个操作的最大值而非总和。
整体性能提升:NVIDIA 报告在大规模 AI 系统上使用 SHARP 可获得 2× 到 5× 的 All-Reduce 加速。收益在 GPU 和计算节点数量多时更为显著(网络通常是瓶颈)。在小集群(2-4 个 GPU 计算节点)上改善可能不明显,但在 32 个节点上 SHARP 可显著减少集合延迟。
10.3 SHARP 配置与注意事项
SHARP 默认不启用,需配置插件选择或策略 可用 NCCL_SHARP_DISABLE=1进行 A/B 测试验证 SHARP 是否使用:查看 NCCL 日志( NCCL_DEBUG=INFO),日志中会提及 SHARPSHARP 主要为 InfiniBand 技术;Spectrum-X 以太网平台改善 All-Reduce 性能但不提供交换机内归约引擎 SHARP 可能产生额外交换机内存开销;超大集合(多 MB 或 GB 消息)可能因超出硬件限制而回退到常规方法
十一、持久化 NCCL 用户缓冲区与零拷贝注册
NCCL 支持用户缓冲区注册,允许集合操作直接在张量缓冲区上操作,无需内部暂存。这减少拷贝和内部通道压力。
持久化 NCCL 用户缓冲区对于使用 SHARP 实现最佳路径(节点内 NVLS 和节点外 InfiniBand 场景)至关重要。零拷贝注册可以加速集合操作并减少 SM/通道使用。
使用 ncclCommRegister() 和 ncclCommDeregister() 注册和注销持久化用户缓冲区。如果通信中的任何 rank 使用注册缓冲区,所有 rank 必须使用。此外,对于某些算法,缓冲区头部的偏移量必须在各 rank 间匹配。
十二、NIXL 与解耦推理
12.1 NIXL 概述
NVIDIA NIXL(NVIDIA Inference Xfer Library)是一个开源、高吞吐量、低延迟的点对点通信库,于 2025 年初发布。NIXL 专为加速大规模 LLM 分布式和解耦推理而设计。
NCCL 与 NIXL 的定位差异:
NCCL:多对多集合通信,主要用于训练 NIXL:一对一或一对少数据传输,主要用于推理
12.2 解耦推理架构
Transformer 模型的推理路径分为两个不同阶段:
Prefill(预填充)阶段:
通常是计算密集型的 使用大量矩阵乘法从输入请求数据(即提示词)构建 KV Cache 需要高计算能力
Decode(解码)阶段:
通常是内存吞吐量受限的 需要从 GPU HBM 内存获取模型权重来计算下一组 token 需要高内存带宽
解耦服务将 Prefill 和 Decode 阶段分离到不同的 GPU 集群:
Prefill 集群中的 GPU 生成输入序列的 KV Cache 使用 NIXL 将 KV Cache 传输到 Decode 集群中的 GPU 这种专业化产生更高的整体吞吐量和高级扩展配置
12.3 NIXL 智能互连路由
NIXL 是互连无关的,自动选择最快路径:
同一计算节点内的 GPU:NVLink 同一机架域内:NVSwitch 跨节点:InfiniBand 或以太网 RDMA 必要时:PCIe 或 NVMe
NIXL 还支持在不同内存层之间统一传输:GPU HBM、CPU DRAM、甚至 NVMe SSD。
12.4 NIXL 异步 API 详解
NIXL 提供一致的异步 API,用于在 GPU、CPU、SSD 和共享网络存储之间移动数据。
核心 API 流程:
registerMem:注册内存trim:获取传输描述符prepXfer:准备非阻塞请求postXfer:提交请求checkXfer:轮询检测完成
代码示例——NIXL 非阻塞 VRAM 到 VRAM 传输:
// NIXL 0.5.x 风格示例:两个 agent 之间的非阻塞 VRAM->VRAM 传输
#include <nixl.h>
#include <nixl_types.h>
#include <cuda_runtime.h>
#include <iostream>
#include <thread>
#include <vector>
#include <cassert>
#include <cstdint>

int main() {
    // 1) 配置 agent。优先使用 UCX 进行 GPU<->GPU 传输,
    //    如果后续需要存储传输则允许 GDS
    nixl_agent_config cfg{};
    cfg.backends = {"UCX"};  // 如需存储传输则用 {"UCX","GDS"}
    cfg.thread_safe = true;   // 线程安全模式(0.2.x 早期版本新增)

    // 2) 创建源和目标 agent
    nixlAgent agentSrc("srcAgent", cfg);
    nixlAgent agentDst("dstAgent", cfg);

    // 3) 在同一 GPU 上分配简单测试缓冲区(仅用于演示)
    int deviceId = 0;
    cudaSetDevice(deviceId);
    const size_t bytes = 1 << 20; // 1 MiB
    void* d_src = nullptr;
    void* d_dst = nullptr;
    cudaMalloc(&d_src, bytes);
    cudaMalloc(&d_dst, bytes);

    // 4) 构建 VRAM 注册描述符
    //    每个描述符使用地址、长度和关联设备
    nixl_desc_t srcDesc{};
    srcDesc.addr      = reinterpret_cast<uintptr_t>(d_src);
    srcDesc.len       = bytes;
    srcDesc.devId     = deviceId;
    srcDesc.seg       = VRAM_SEG;

    nixl_desc_t dstDesc{};
    dstDesc.addr      = reinterpret_cast<uintptr_t>(d_dst);
    dstDesc.len       = bytes;
    dstDesc.devId     = deviceId;
    dstDesc.seg       = VRAM_SEG;

    std::vector<nixl_desc_t> srcList{srcDesc};
    std::vector<nixl_desc_t> dstList{dstDesc};

    // 5) 向每个 agent 注册内存并裁剪为传输描述符
    auto srcRegs = agentSrc.registerMem(srcList);
    auto dstRegs = agentDst.registerMem(dstList);
    auto srcXfer = srcRegs.trim();  // 用于传输的无元数据描述符
    auto dstXfer = dstRegs.trim();

    // 6) 准备从 srcAgent->dstAgent 的 WRITE 操作,然后提交(非阻塞)
    nixlReqH reqHandle = nullptr;
    // 准备 + 提交
    if (agentSrc.prepXfer(NIXL_WRITE, srcXfer, dstXfer, "dstAgent", reqHandle)
      != NIXL_SUCCESS) {
        std::cerr << "prepXfer 失败\n";
        return 1;
    }
    if (agentSrc.postXfer(NIXL_WRITE, srcXfer, dstXfer, "dstAgent", reqHandle)
      != NIXL_SUCCESS) {
        std::cerr << "postXfer 失败\n";
        return 1;
    }
    std::cout << "传输已提交 — 正在执行其他工作...\n";

    // 7) 轮询完成状态(替代已弃用的 getNotifs/poll map)
    nixl_status_t st;
    do {
        st = agentSrc.checkXfer(reqHandle);
        if (st == NIXL_INPROGRESS) std::this_thread::yield();
    } while (st == NIXL_INPROGRESS);

    if (st != NIXL_SUCCESS) {
        std::cerr << "传输完成但出错: " << st << "\n";
        agentSrc.releaseReqH(reqHandle);
        agentSrc.deregisterMem(srcRegs);
        agentDst.deregisterMem(dstRegs);
        cudaFree(d_src);
        cudaFree(d_dst);
        return 1;
    }
    std::cout << "传输完成!\n";

    // 8) 清理
    agentSrc.releaseReqH(reqHandle);
    agentSrc.deregisterMem(srcRegs);
    agentDst.deregisterMem(dstRegs);
    cudaFree(d_src);
    cudaFree(d_dst);
    return 0;
}技术要点解析:
nixlAgent 是 NIXL 的核心传输对象,封装端点配置、内存注册和后端选择需要两个 agent 进行传输:源 agent(agentSrc)和目标 agent(agentDst) NIXL 协商两个端点之间的最优路径并管理独立资源和请求生命周期 非阻塞 API 允许下游内核在传输仍在进行时就开始消费已到达的数据 内部使用 UCX 作为低级传输,利用 GPUDirect RDMA 和 IBGDA 实现 GPU 发起传输
12.5 KV Cache 卸载
NIXL 的设计动机与 LLM 推理大内存处理的最佳实践密切相关。如果 GPU 没有足够内存容纳长序列或多轮对话的整个 KV Cache,NIXL 允许推理服务器将 KV Cache 卸载到 CPU 内存甚至 NVMe SSD,并在需要时取回。
性能数据:
PCIe x86 + H100 系统:KV Cache 卸载对长输入序列的 TTFT(首 Token 延迟)改善可达 14× ARM Grace Hopper 超级芯片:凭借 900 GB/s NVLink-C2C 互连,TTFT 延迟比 x86 H100 版本快 2×
12.6 NCCL 与 NIXL 全面对比
十三、关键要点总结
13.1 拓扑至关重要
节点间互连(InfiniBand)和节点内互连(NVLink/NVSwitch)影响最优通信策略。对于多节点和多 GPU 配置,应考虑层次化方法。始终确保使用最快的互连,而非因配置错误或意外默认值而通过慢速路径发送数据。检查 NCCL 的行为,如果可用则利用 SHARP 等功能进行大规模网内聚合/归约。
13.2 调优环境和系统
有时单个环境变量或 OS 设置就能提升吞吐量。例如:
增加 NIC 缓冲区 启用/禁用 NCCL 功能和日志 正确绑定 CPU 在 OS 和驱动级别执行系统优化(如 IRQ 亲和性)
13.3 利用最新硬件创新
NVIDIA Grace Hopper 和 Grace Blackwell 超级芯片提供海量 CPU 内存和快速 CPU-GPU 互连 网内计算如 SHARP 可将集合操作加速 2×-5×,尤其在规模扩展时 保持对新计算和网络硬件创新的关注,因为每代新产品都会改变最优配置
13.4 终极目标
让 GPU 100% 的时间都在计算,同时后台进行通信;让网络链路充满有用数据;让磁盘全速流式传输数据。所有这些应该完美协调地同时发生。
实现这一切需要迭代调优和验证,以及一些权衡(如更多内存使用和更多代码复杂性)。但这种调优以更快的模型训练和推理以及昂贵基础设施的更好利用率为回报。
十四、技术术语对照表
十五、实践建议
15.1 通信与计算重叠
- 始终使用 DDP 而非 DP:DDP 通过 NCCL 异步 All-Reduce 实现梯度通信与计算重叠,避免 GIL 瓶颈
- 调优桶大小:默认 25 MB 适用于大多数情况,大层模型可增大,多小层模型可减小
- 避免隐式同步:不在训练循环中使用
.item()、torch.cuda.synchronize()等操作 - 使用梯度累积:减少通信频率,在通信频率、内存使用和收敛性之间找到平衡点
15.2 RDMA 与网络配置
- 始终验证 RDMA 路径活跃:使用
NCCL_DEBUG=INFO确认 NET/IB 路径,用 RDMA perftests 配合--use_cuda验证 - 容器环境特别注意:确保容器直接访问 InfiniBand 设备,验证 GID 分配匹配
- 使用巨型帧:至少 MTU 9000
- 调优 TCP 栈:设置
net.core.rmem_max/wmem_max和net.ipv4.tcp_rmem/tcp_wmem - CPU 亲和性:将网络中断处理绑定到与 NIC 和 GPU 同一 NUMA 节点的 CPU 核心
15.3 NCCL 最佳实践
- 通信器只初始化一次:在程序开始时调用
init_process_group,结束时调用destroy_process_group - 显式设置环境变量:不依赖默认值,显式设置
NCCL_ASYNC_ERROR_HANDLING=1、NCCL_SOCKET_IFNAME=ib0等 - 使用最新 NCCL 版本:新版本包含针对新硬件的优化
- 监控 NCCL 日志:设置
NCCL_DEBUG=WARN或INFO,关注回退警告 - NUMA 绑定:将 GPU 进程绑定到对应 NUMA 域的 CPU 核心,设置
NCCL_IGNORE_CPU_AFFINITY=1 - 多 NIC 调优:逐步增加
NCCL_NSOCKS_PERTHREAD和NCCL_SOCKET_NTHREADS,乘积不超过 64
15.4 大规模集群建议
- 使用同构硬件:避免落后节点拖慢整体进度
- 利用 SHARP:InfiniBand 集群中启用 SHARP 可获得 2×-5× All-Reduce 加速
- NVLink Switch 域优先:将作业放置在同一 NVLink 域内
- 监控工具:使用 DCGM、InfiniBand 计数器、
torch.distributed.monitored_barrier检测落后节点 - 端口范围:扩大
net.ipv4.ip_local_port_range避免引导失败
15.5 推理场景建议
- 使用 NIXL 而非 NCCL send/recv:NIXL 为点对点大消息传输优化,延迟更低
- 考虑解耦推理:将 Prefill 和 Decode 分离到不同 GPU 集群
- KV Cache 卸载:利用 NIXL 将 KV Cache 卸载到 CPU 内存或 SSD
- 利用超级芯片:Grace Hopper/Blackwell 的 900 GB/s NVLink-C2C 可大幅提升 TTFT
十六、结论
高性能、分布式和多 GPU 通信及存储系统的演进是调优大型复杂 AI 系统的基础。通过利用专门的库——NCCL 用于集合操作、NIXL 用于高效推理数据传输、RDMA 用于超低延迟通信——AI 系统可以显著减少瓶颈并提升性能。
智能网络硬件(如 NVSwitch 和支持 SHARP 的 InfiniBand 交换机)的集成直接转化为更高的训练和推理性能。同样,保持软件最新至关重要,因为较新版本的 CUDA 和 PyTorch 内置了针对最新 GPU 和网络技术的优化。
本章强调:没有单一组件能单独提供峰值性能。只有高速通信、高效数据处理和系统级调优的精心协调与协同设计,才能构建可扩展且健壮的 AI 系统。
对于性能工程师而言,核心教训是:快速的数据传输与原始计算能力同等重要。世界上最快的 GPU 如果持续等待来自 CPU 或其他 GPU 的数据,其价值将大打折扣。 通过精心工程实践和本章描述的技术,通常可以达到或接近物理"光速"硬件极限的性能。
在下一章中,将探索基于 GPU 的存储策略和优化,与 RDMA、NCCL 和 NIXL 等网络协议和库相辅相成,GDS 和高效输入管道是保持 GPU 持续工作的整体方法的一部分。