ARTICLE · 1041213
AI互连(一):一文读懂AI互连
过去一段时间,我经常看到光模块、铜缆、CPO、NVLink这些词,其中光模块听到的最多。
我大概知道它们都和AI互连有关,也知道不少方向这两年在二级市场很受关注,但一直没有系统了解过。光模块和CPO是什么关系,NVLink和Ethernet(以太网)有什么区别,这些互连技术在AI时代为什么又变得这么重要,我其实都没有真正想清楚。
最近我花了一些时间,把这些概念和背后的产业逻辑重新梳理了一遍。
这篇文章就是学习后的一些理解。我觉得看完以后,应该能对AI互连建立一个基本的认知框架。
一、AI互连的三个维度
AI互连里的概念很多,但可以从三个维度来理解:互连类型、互连架构、物理传输。
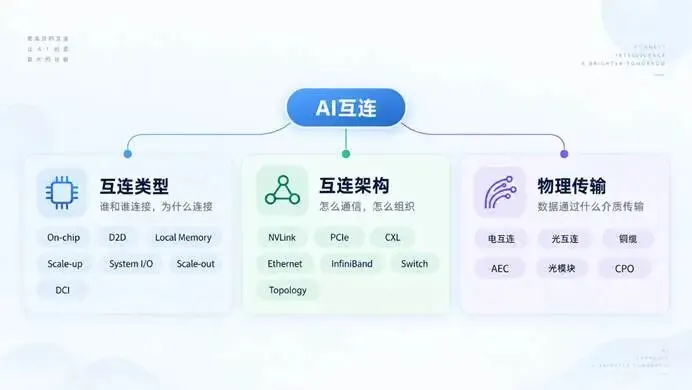
第一个维度:互连类型。
也就是谁和谁连接,以及这类连接要解决什么问题。为了建立一个基本框架,可以把AI系统中的主要互连问题大致分成七类。
1. On-chip,片上互连。
它连接的是一颗芯片内部的计算单元、缓存、内存控制器等不同模块。这些模块之间也需要不断交换数据,因此芯片内部同样需要互连。
2. D2D,Die-to-Die互连。
它连接的是同一个Package(封装)里的不同Die(裸片)。随着高性能芯片越来越多采用Multi-die(多裸片)或者Chiplet(芯粒)设计,原本发生在一块Die内部的数据交换,有一部分需要跨Die完成。
3. Local Memory,本地内存互连。
它主要连接GPU或者其他Accelerator(加速器)与HBM(High Bandwidth Memory,高带宽内存)。GPU负责计算,HBM负责保存计算过程中需要频繁访问的数据,两者之间需要持续进行高带宽的数据交换。
从物理位置看,在采用HBM的高性能GPU中,GPU Die和HBM通常也被集成在同一个先进封装内。但它和前面的D2D承担的作用不同:D2D主要解决不同逻辑Die之间如何协同,Local Memory解决的则是计算芯片如何高速访问本地内存。
4. Scale-up,纵向扩展。
它连接的是多颗GPU或者其他Accelerator。当计算任务需要多颗GPU或者Accelerator协同完成时,它们需要频繁交换中间结果。Scale-up的作用,就是把这些计算设备组织成一个更大的计算域。
5. System I/O,系统输入输出互连。
它连接的是CPU、GPU、NIC(网卡)、存储设备等承担不同功能的设备。它和Scale-up的区别在于,Scale-up主要连接共同参与计算的GPU或者Accelerator;System I/O则负责把不同类型的设备连接成一个完整的计算系统。
6. Scale-out,横向扩展。
它连接的是不同的计算节点或者Scale-up计算域。当一个计算节点或者一个Scale-up 计算域仍然不够时,需要继续把更多计算资源连接起来,组成更大的计算集群。
Scale-up和Scale-out并不是简单按服务器或Rack(机架)边界划分。Scale-up强调把多个计算设备组织成一个紧耦合计算域,Scale-out则把多个相对独立的计算节点或计算域连接成更大的集群。两者的区别在于,这些计算资源是被作为一个紧密协作的计算单元,还是作为多个相对独立的计算单元进行协作。
7. DCI(Data Center Interconnect),数据中心互连。
它连接的是不同的数据中心,用于跨数据中心传输模型、数据和其他流量。
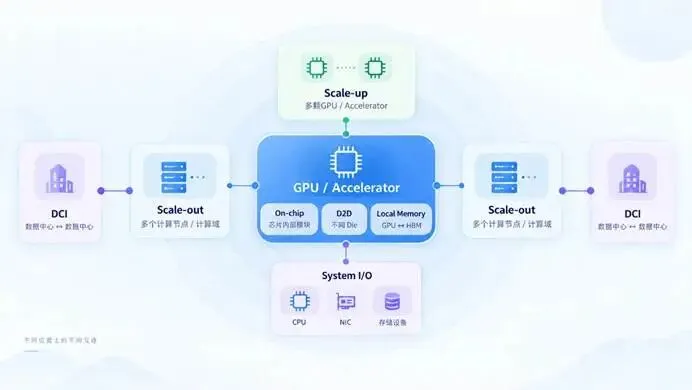
这七类互连并不是一条从里到外依次经过的链路,而是在不同位置、不同设备之间,为解决不同数据交换问题形成的几类互连。
第二个维度,互连架构。
它规定设备之间怎么通信:哪些设备可以直接连接,数据按照什么规则传输;当需要连接的设备越来越多时,又该怎样通过交换机组织连接并转发数据。
1. 数据按照什么规则传输。
不同互连类型通常会使用不同的接口、协议或技术体系。例如:
- D2D常见UCIe等接口标准;
- Local Memory主要使用HBM接口;
- Scale-up以NVLink等技术体系为代表;
- System I/O常见PCIe、CXL;
- Scale-out则主要使用Ethernet或者InfiniBand。
这些名字不需要全部记住。这里真正需要理解的是:它们分别服务于不同的互连类型,规定数据如何在对应的设备之间传输。
2. 设备之间具体怎么连接。
设备数量较少时,可以采用设备之间直接连接。但随着设备数量增加,不可能让每个设备都与其他所有设备单独连接,因此需要通过Switch(交换机)组织更多节点之间的数据交换。
这些连接最终会形成不同的Topology,也就是拓扑结构,例如Ring、Mesh以及大规模网络中常见的Clos等。
所以,同一种互连类型,也可以采用不同的协议和拓扑结构。
第三个维度,物理传输。
它关注的是数据最终通过什么物理方式,从一个设备传到另一个设备。
最基本的两类是:电互连和光互连。
电互连通过电信号传输数据。
芯片内部、封装内部、电路板以及很多短距离连接,目前都以电互连为主。具体形态包括芯片和封装内部的高速线路、PCB(印刷电路板)走线、铜缆,以及加入主动信号处理能力的AEC(有源电缆)等。
光互连则把电信号转换成光信号,通过光纤传输。目前常见的产品和集成形态包括可插拔光模块和CPO。
可插拔光模块通常安装在交换机面板上。数据从交换芯片出来以后,需要先以电信号的形式经过PCB传到光模块,再由光模块把电信号转换成光信号,通过光纤发送出去。
CPO,也就是Co-Packaged Optics(共封装光学),则把负责光电转换的光学引擎放到离交换芯片更近的位置。这样数据从交换芯片出来以后,只需要经过很短的电连接,就可以转换成光信号,从而减少高速电信号在PCB上传输的距离。
因此,两者都属于光互连,区别主要在于电信号在哪里转换成光信号,以及转换之前需要经过多长的电连接。
理解了这三个维度,AI互连里很多看起来混杂的概念就可以被放到各自的位置:先看它属于哪一类互连,再看它如何组织通信,最后看数据通过什么介质传输。
二、AI互连背后的底层机制
这些不同的互连之所以会同时存在,本质上是因为它们面对的数据传输需求和工程约束并不相同。
AI算力扩张,并不只是增加更多GPU。单颗GPU的计算和存储能力有限,模型和计算任务会被拆到更多GPU和计算节点。原本在一颗芯片内部完成的数据交换,越来越多地需要跨Die、跨GPU甚至跨节点完成。只要下一步计算依赖这些数据,互连就会进入计算的关键路径。数据没有及时到达,计算单元就只能等待。
因此,互连要解决的核心问题其实很简单:怎样用尽可能少的资源,把下一步计算需要的数据,在需要的时间内送到需要的位置。
这个问题最终会落到几个最基本的约束上。
1. 带宽。
带宽决定单位时间内能够传输多少数据。AI计算需要不断搬运权重、中间结果和其他运行数据,因此GPU与HBM之间、GPU与GPU之间,都需要很高的带宽。
在芯片和封装内部,距离很短,可以布置大量线路,让很多数据同时传输。HBM就是典型例子,通过非常宽的接口获得很高的总带宽。
当距离变长以后,就很难继续把成百上千条线路直接拉出去,通常需要减少通道数量,提高每条通道的传输速度,通过高速SerDes(串行器/解串器)让有限的线路承载更多数据。
2. 延迟。
带宽解决的是单位时间可以传多少数据,延迟解决的是一份数据从发出到到达需要多久。
如果下一步计算必须使用某份数据,那么这份数据到达之前,计算就无法继续。比如两颗GPU共同完成一次计算,其中一颗GPU完成局部计算后,需要把结果发送给另一颗GPU。即使链路带宽很高,只要结果到达得晚,另一颗GPU仍然需要等待。
3. 距离。
芯片内部和封装内部距离很短,可以使用大量短距离电连接。
离开封装以后,信号需要经过PCB、连接器和线缆。随着距离和传输速率提高,高速电信号的衰减、串扰以及信号恢复难度都会增加,需要更复杂的信号处理。
当距离继续增加,维持高速电连接的代价越来越高,光纤低损耗的优势开始体现,光互连也就逐渐进入更合适的位置。
4. 规模。
设备数量很少时,可以直接连接;但随着设备越来越多,不可能让每个设备都和其他所有设备分别拉一条线路,因为需要的接口和线路数量会迅速增加。
这时就需要Switch和不同的Topology,让多个设备共享有限的端口和链路,并决定数据经过哪条路径、不同设备如何共享网络,以及发生拥塞时如何调度。
这也是为什么Scale-out不能简单理解成“距离更远、规模更大的Scale-up”。当大量相对独立的计算节点连接起来以后,还需要解决路由、拥塞和故障处理等网络问题。
5. 功耗和成本。
更多线路会占用芯片边缘和封装面积;更高速的SerDes和信号处理电路会消耗更多功率;距离增加以后,还可能需要Retimer(重定时器)、AEC、Switch以及光模块等额外设备。
因此,互连设计不会把所有连接都做到最高带宽、最低延迟,而是把高成本、高性能的互连优先放在通信最频繁、对等待最敏感的位置;越往外围,则更多考虑距离、共享能力和成本。
6. 可靠性。
系统规模越大,设备、端口、线缆和交换机越多,运行过程中出现故障的概率也会增加。
在大型集群中,一条链路、一个端口甚至一个节点发生故障,都不应该轻易导致整个计算任务停下来,因此需要通过故障隔离、重传、绕路和任务恢复等机制,把影响尽量控制在局部范围内。
把这些约束放回不同互连类型中:
芯片和封装内部,更看重带宽密度和能耗;
Scale-up需要高带宽、低延迟,以及多个计算设备之间频繁的数据交换和同步;
Scale-out连接大量相对独立的计算节点,还需要处理路由、拥塞和故障;
到了DCI,传输距离和可靠性的约束进一步增强。
不同位置面对的约束组合不同,也就形成了不同的互连方案。
三、现实中的AI互连
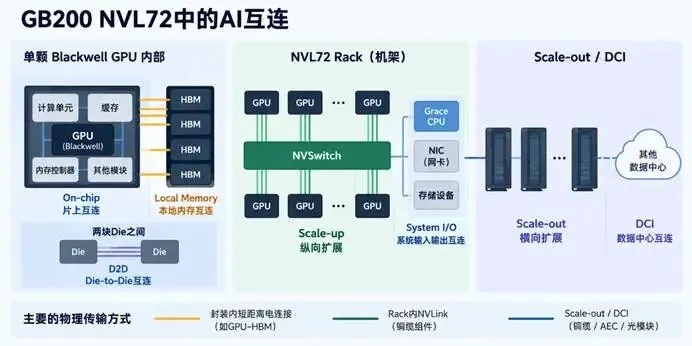
以英伟达GB200 NVL72为例。一个NVL72 Rack包含72颗Blackwell GPU和36颗Grace CPU,并通过NVLink和NVSwitch把72颗GPU组织成一个Rack级Scale-up计算域。
1. 互连类型
在一颗Blackwell GPU内部,计算单元、缓存等模块之间需要On-chip互连;Blackwell采用双Die设计,两块Die之间需要D2D互连;GPU与旁边的HBM之间则是Local Memory互连。
再往外,72颗GPU组成一个Scale-up计算域,CPU、GPU、NIC等不同功能设备之间还存在System I/O。
多个NVL72或其他计算节点继续连接,就进入Scale-out;跨越不同数据中心,则是DCI。
2. 互连架构
NVL72内部,GPU之间使用NVLink通信,并通过NVSwitch组织72颗GPU之间的数据交换。
当计算规模继续扩大,多个NVL72或其他计算节点可以通过Ethernet或者InfiniBand等Scale-out网络连接。
Scale-up描述的是一种系统级互连关系,NVLink是GPU之间的高速互连技术,NVSwitch则负责组织多颗GPU之间的数据交换。
3. 物理传输
在芯片和封装内部,主要依靠短距离电连接。GB200 NVL72的Rack级NVLink互连也采用Copper Cable Cartridge(铜缆组件)。
到了Scale-out,同一套网络可以根据距离和带宽要求使用铜缆、AEC或者光模块。随着距离和速率提高,高速电连接的损耗、功耗和布线代价增加,光互连的优势逐渐体现出来。
因此,计算规模扩大,并不意味着所有互连都会从铜变成光。具体采用哪种物理传输方式,仍然取决于不同位置面对的距离、带宽、功耗和成本约束。
理解了这套框架以后,光模块、铜缆、CPO、NVLink、Ethernet这些原本看起来杂乱的概念,也就更容易理解了。