ARTICLE · 1042474
一条命令跑起一支 AI 团队:Octop 1.0 把「自托管 AI 助手」推进了生产环境
过去两年,AI 助手的能力涨得飞快,但有个前提一直没变:你的对话、文件、知识库,都存在别人的服务器上。
对个人是隐私顾虑,对一人公司、家庭、小团队则是实打实的成本与合规问题。于是"自托管 AI 助手"成了一个持续升温的细分赛道——把模型调用留在本地或自己的云上,数据不出内网。
腾讯云开源的 Octop 就是这条路线上的选手。2026 年 9 月 14 日,它发布了 1.0 GA 正式版。这个项目今年 7 月 8 日才建仓,两个月时间在 GitHub 上攒到了 4,119 star、437 fork,采用 MIT 协议,纯 Python 写的。
数字好看不代表能用。这篇我想说清楚的是:1.0 到底把哪些坑填上了,以及它离"敢放进生产环境"还有多远。
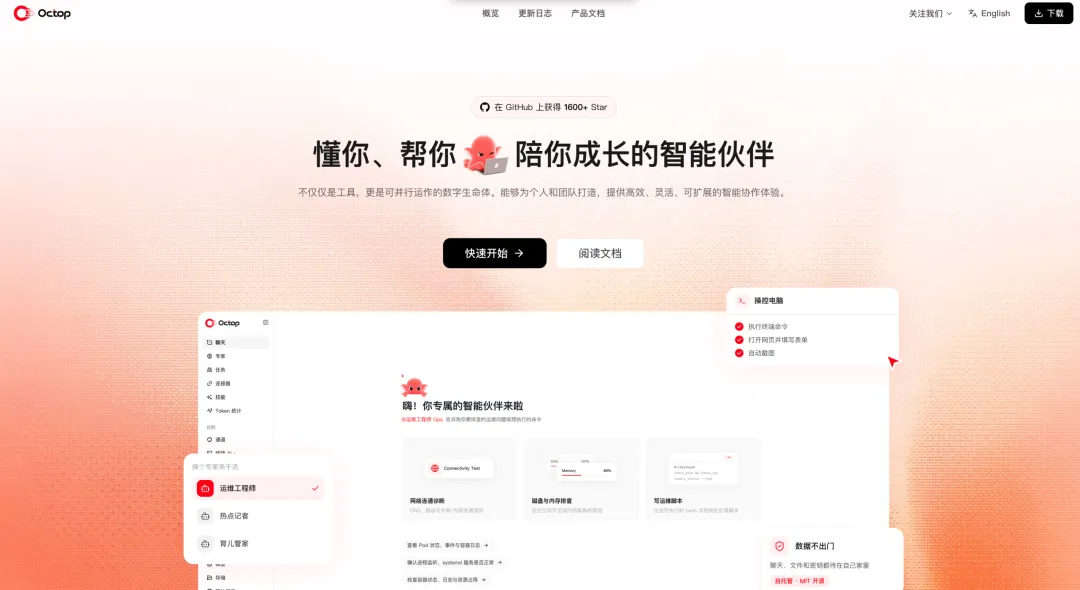
一、它到底是个什么东西
先把定位说清楚,免得又是一篇发布会通稿。
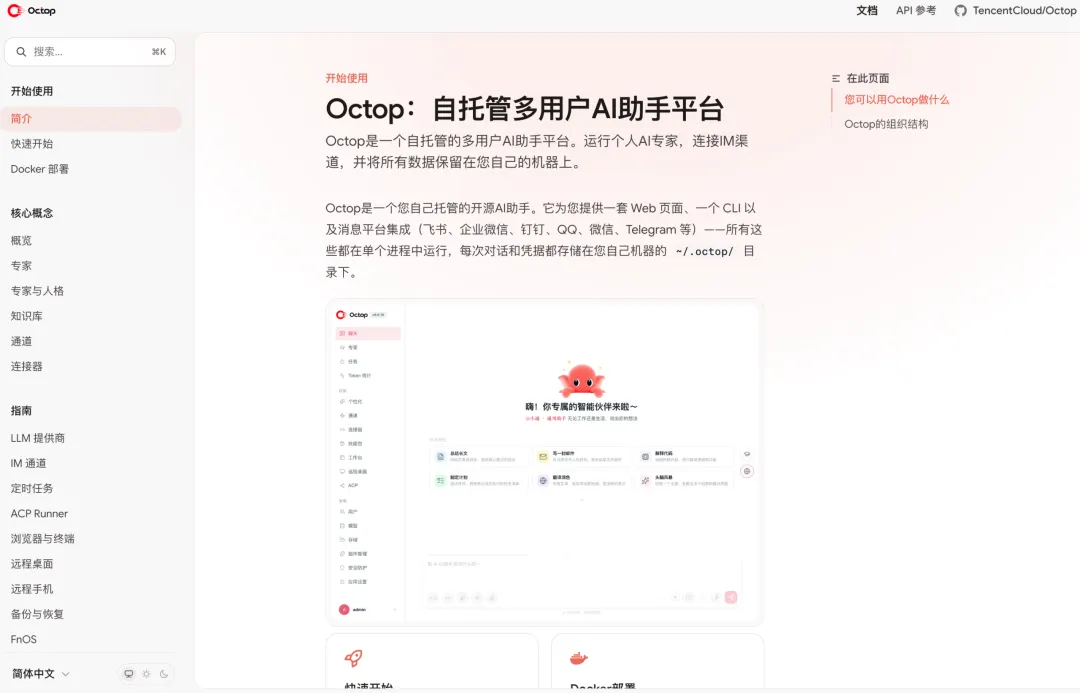
Octop 的自我描述是"a smarter, self-hosted AI assistant — multi-user, multi-agent"。拆开看是三层意思:
自托管:整个服务是一个 Python 进程。一条 octop run 拉起来,数据全部落在 ~/.octop/ 目录下,控制面数据库默认用 SQLite(WAL 模式),需要更大规模可以换 PostgreSQL。没有外部消息队列、没有强制依赖的中间件,除了你自己配的 LLM 提供商,它不需要连任何外部服务。
多用户:内置管理员 + 多用户体系,JWT 做隔离。这是它和多数"个人 AI 助手"项目最大的区别——它的目标场景写得很明确:一人公司、家庭、小团队。
多智能体:每个用户可以拥有多个 Agent,每个 Agent 有自己的工作区、模型提供商、消息通道和定时任务。启动时会扫描一个"专家库",按场景切换不同的专家角色;还内置了 16 种 MBTI 人格模板,让每个 Agent 有不同的说话风格。
支持的入口相当杂:网页控制台、CLI、以及飞书、钉钉、QQ、Discord、企业微信这些 IM 通道,再加上 HTTP/SSE/WebSocket 的程序化接口。也就是说,你可以在企业微信里 @ 它,也可以在浏览器里聊,底层是同一套会话和智能体状态。
二、1.0 补上的五块拼图
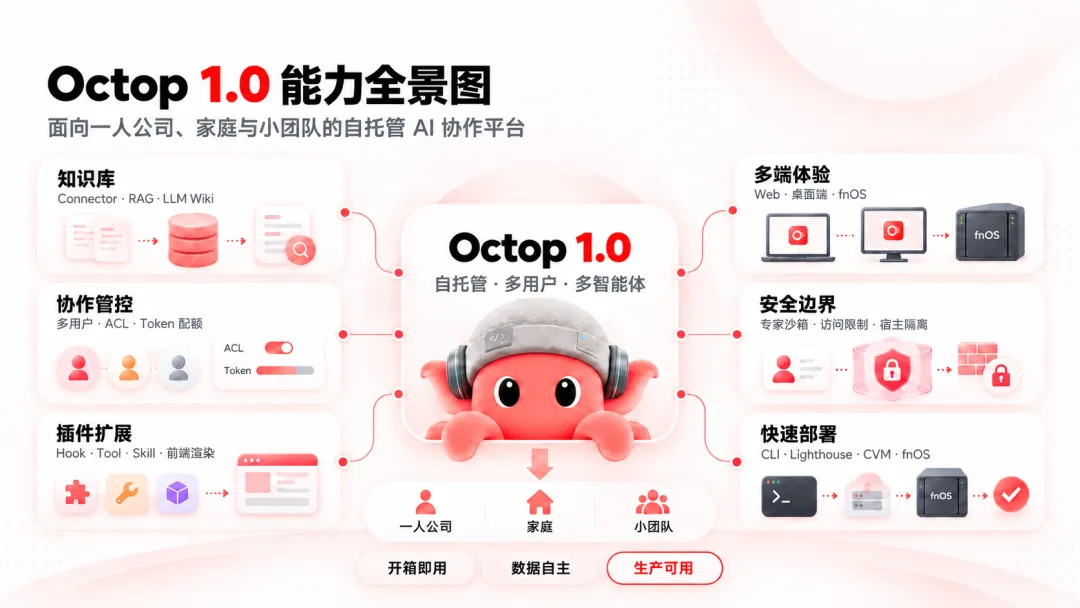
官方说 1.0 的目标是"把已有能力串成一条能放心给真实用户用的生产链路"。从更新内容看,这个说法基本诚实。五块拼图分别是:
1. 知识库:从"能连"到"能管"
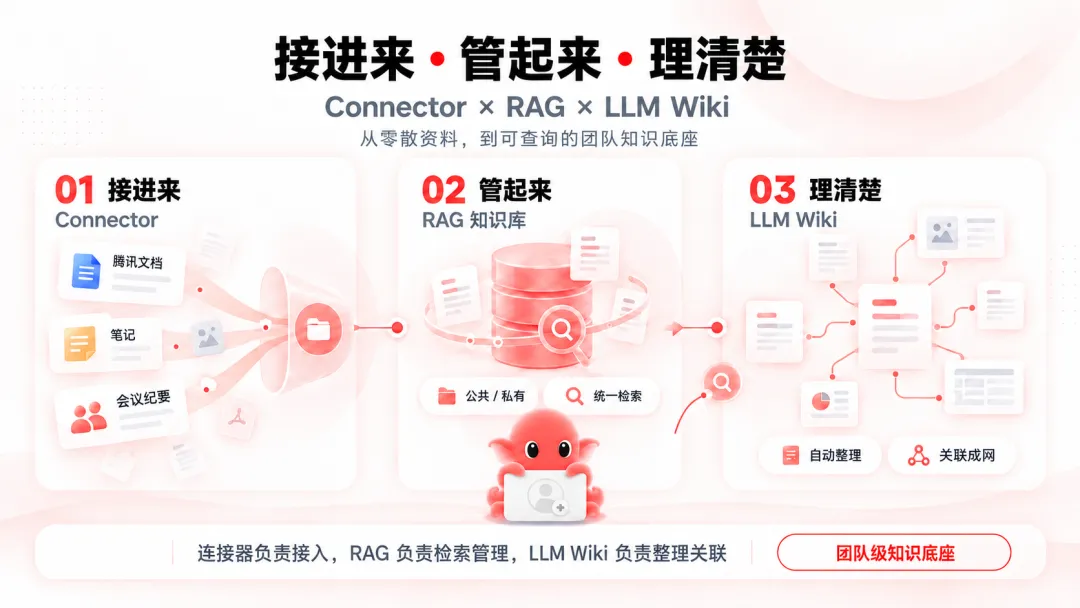
1.0 之前,Octop 通过连接器体系接入了腾讯文档、微博热搜、新闻等知识来源——但"接进来"和"管起来"是两件事。
1.0 上线了两条并行的知识路线,这点值得单独说,因为它反映了当前知识库方案的一次路线分歧:
官方的总结很简洁:连接器负责"接进来",RAG 负责"管起来",LLM Wiki 专家负责"理清楚"。
2. 多端:从"只有网页"到"桌面 + NAS"
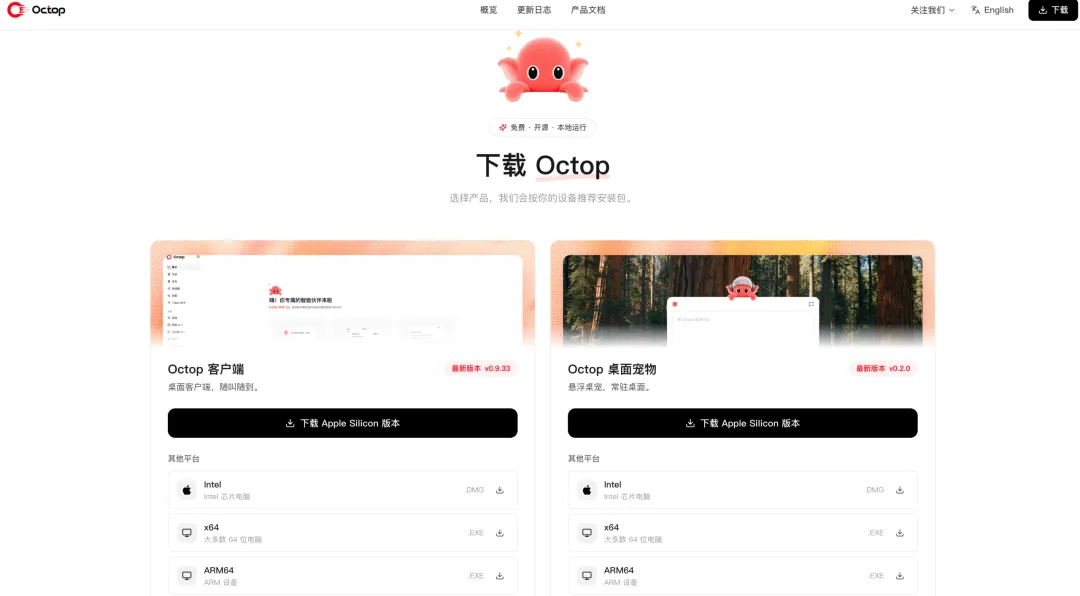
1.0 补齐了三端原生桌面客户端(macOS / Windows / Linux),支持后台常驻和系统通知,与网页端共享会话状态。
更有意思的是飞牛 NAS(fnOS)应用——提供 native 和 docker 两种形态。把 AI 助手装在家里的 NAS 上、当"常驻 AI 中枢",这个场景过去基本要靠自己折腾 Docker Compose,现在变成了应用中心里点一下。
3. 权限:能看什么,和能用多少
多用户体系早就有,1.0 把它做"细"了:
这一条对"把 AI 开放给家人或外部协作者"很关键——共享但不失控。
4. 安全:专家默认跑在沙箱里
1.0 给专家(Expert)的运行环境加了沙箱限制:
配合 README 里列的 JWT 隔离、工具调用审批、shell 命令护栏、PII 脱敏,这套东西明显是照着"多人共用一台机器"设计的。
5. 插件:补上前端渲染
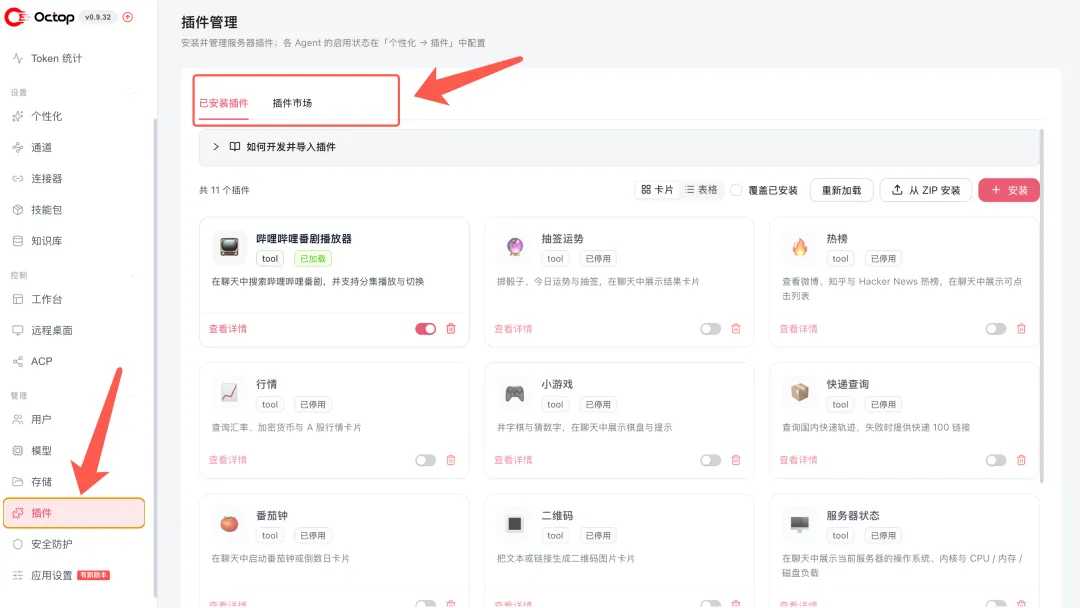
插件体系之前已经能覆盖 Hook(干预处理生命周期)、Tool(注册新工具)、Skill(沉淀可复用工作流)三类扩展点。1.0 新增的是前端渲染支持——插件可以向控制台注入自定义 UI,比如配置面板、结果卡片、专属交互组件。
后端逻辑和前端界面一体的插件,才算"装得上、用得顺"。
三、顺带说清楚:LLM Wiki 到底是什么
上面提到的 LLM Wiki,可能是这篇文章里最值得你花两分钟理解的概念。
Karpathy 提出这个思路后引发了大范围讨论,核心分歧点是一句话:传统 RAG 是不是走错了路?
打个比方。传统 RAG 像解释器:原始文档全部存着,每次提问时才去检索、拼装、交给模型现场理解。你问一百次,它就得现场理解一百次,而且每次只看得到被检索出来的那几块。
LLM Wiki 像编译器:让模型先把零散资料预先编译成一份结构化、互相链接的 Markdown 知识库——有目录、有交叉引用、有持续维护的摘要。之后查询时读的是这份已经"编译过"的成果,而不是每次从头解释原始材料。
它的实现甚至有点反直觉:不需要向量数据库,也不需要嵌入模型,靠 Markdown 文件 + 全文检索(如 BM25)就能跑。国内的实践者总结得很到位——这是"把 RAG 从解释器模式升级为编译器模式"。
两种路线的优劣目前还有争议:LLM Wiki 的好处是知识可见、可人工编辑、可版本管理(就是一堆 Markdown 文件),避免了向量检索"召回不准又看不出为什么"的黑盒问题;代价是前期要有一次"编译"成本,而且知识规模上去之后,谁来维护这份 Wiki、怎么保证它不腐化,是新问题。
已经有第三方研究在做对照实验(比如在小型多领域语料上比较向量 RAG 与 LLM 编译型 Wiki),但结论尚未收敛。
Octop 的做法是不押注单一路线:结构化文档走 RAG,碎片资料交给 LLM Wiki 专家。 这个组合在工程上是很务实的选择。
四、技术架构:一个进程装下所有东西
把架构摊开看,Octop 的地基是一组叫 Harness 的运行时,拼装成一个进程:
关键设计是那句"不依赖外部消息队列":Web UI、IM、定时任务三个入口,全部经由进程内的一个 HarnessProcessor 处理。好处是部署极简、重启安全——进程重启后,整个状态从控制面数据库里重建。
还有一个容易被忽略的能力:ACP(Agent Client Protocol)双向支持。入站方向,外部工具(如编辑器)可以把 Octop 的 Agent 当自己的后端用;出站方向,Octop 可以委派给 OpenCode、CodeBuddy、Claude Code、Codex 这些外部编码智能体,并且带权限门控。
五、客观看:哪些地方要留个心眼
说了这么多好处,该说问题了。
第一,这是个两个月大的项目。 建仓 2026-07-08,到 1.0 GA 只有两个月。虽然 PyPI 上从 0.7.1 到 1.0.1 发了 52 个版本(迭代速度惊人),但迭代快本身也是风险信号——版本之间行为变化可能不小,自托管用户得做好跟版本的心理准备。
第二,issue 积压不算少,而且痛点很具体。 GitHub 上 264 个未关闭 issue。光看数字没感觉,翻进去看内容才有意思——社区反馈最集中的几条,全是自托管场景下的真实运维问题:
这些不是"功能不够炫"的抱怨,而是"长期跑会不会出事"的抱怨。对一个宣称可用于生产的自托管平台来说,这类 issue 的关闭速度比 star 增长更重要。 生产环境上线前,建议直接翻一遍 issue 列表。
第三,把量级摊开看,它还是个很小的项目。 同赛道几个名字,差距是数量级的(数据均取自 GitHub,同口径对比):
| Octop | 4,121 | 264 | MIT | |||
两个观察:
第四,自托管的隐藏成本在运维,不在部署。 一条命令能跑起来是真的,但能跑和能长期稳定跑是两件事:数据库备份、版本升级、模型/嵌入模型缓存管理、NAS 上的资源占用、多用户权限审计——这些都得你自己扛。上面那两个 issue(磁盘不释放、Chromium 常驻)恰好就是这类成本的具体样子。这正是它推出腾讯云官方镜像的动机:把运维外包给云厂商,是很多人最终的归宿。
第五,别把它当成"免费"。 它省掉的是平台订阅费和部署门槛,但模型调用成本还在你自己身上。1.0 专门加了 Token 额度管控,某种程度上也说明了这件事的敏感性。
第六,能力面铺得很宽,深度需要自测。 远程桌面、浏览器自动化、终端 AI、ACP 委派……这些功能它都有,但每个都做不到专精工具的程度。用之前想清楚:你是要一个"什么都能沾一点"的统一入口,还是要每个环节都用最好的工具。
补充一个版本发布的细节:GitHub Releases 上只挂了 v0.9.35、v1.0.0、v1.0.1 三个版本,而 PyPI 上有 52 个版本——它的迭代主要通过 pip 包分发,不看 PyPI 会误判项目活跃度。
六、想试的话,四条路
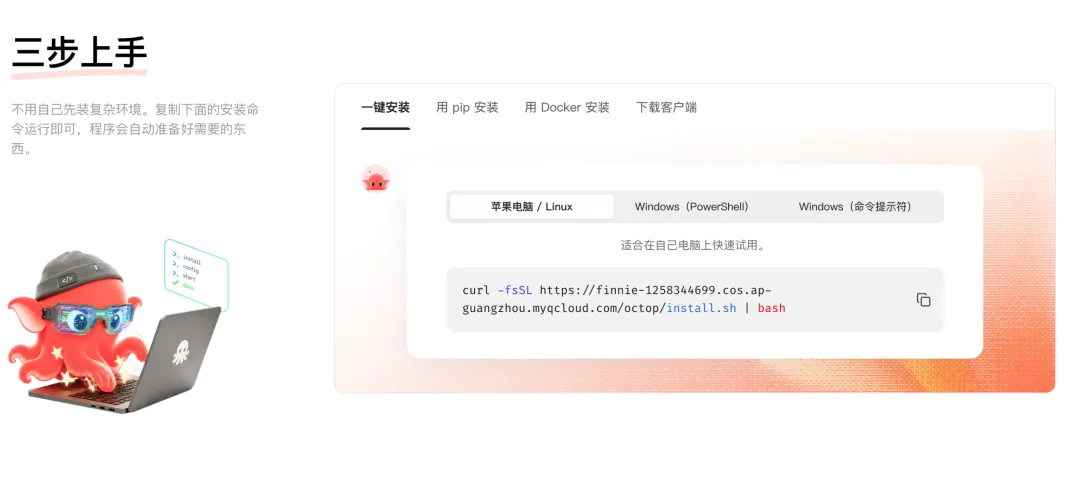
官网 octop.cloud 已经上线,文档中心、客户端下载、版本日志都在那里。上手方式按门槛从低到高:
~/.octop/ 下隔离出一个 Python 3.12 环境,不需要你预装 Python;pip install octop,想用浏览器自动化加 "octop[browser]",想用本地嵌入模型加 "octop[local-embedding]";装完 octop init 初始化,octop run 启动,打开 http://127.0.0.1:8088 就是控制台。
写在最后
把这件事放在更大的背景下看:AI 助手的竞争,正在从"谁的模型更强"转向"谁能把能力装进用户自己的边界里"。
Octop 1.0 的价值不在于它有多惊艳的功能,而在于它把一堆零散需求——多用户、权限、知识库、多端、沙箱、插件——收拢成了一个能自托管的产品,并且给出了从桌面到 NAS 到云服务器的完整交付路径。对一个两个月大的开源项目来说,这个完成度是超出预期的。
但它也诚实地呈现了自托管路线的固有矛盾:自由以运维为代价,数据主权以维护成本为代价。 官方镜像和桌面客户端,本质都是在替用户消化这个代价。
如果你正好属于"一人公司、家庭、小团队"这个目标人群——手上有一台 NAS、一台闲置服务器,或者只是想给家人一个不受限的 AI 入口——它值得花一个下午试试。装错了大不了删掉 ~/.octop/ 目录,没有沉没成本。
GitHub 仓库地址:github.com/TencentCloud/Octop,MIT 协议,欢迎提 Issue 和 PR。
本文的事实性数据(GitHub 数据、版本号、架构表、功能清单)均来自项目仓库与官网的一手信息,抓取时间为 2026-09-19;主观判断部分为作者观点。