ARTICLE · 1042882
AI 原生的软件开发生命周期(SDLC)实战手册
代码不再是瓶颈
各组织已经开始使用 AI 以一年前难以想象的速度编写代码,但围绕代码运行的流程却没有以同样的速度改变。
许多工程团队仍然保留着同样的审批关卡、评审、交接和政策,这使得使用像 Claude Code 这样的智能体编程(agentic coding)解决方案所带来的生产力提升受到了阻碍。
软件开发生命周期(SDLC)是将软件从创意推向生产环境的过程。大多数组织运行的都是同一套六个阶段的某个变体,涵盖软件的规划、设计、构建、测试、部署和维护。传统上,每个阶段都是一个由不同角色负责的离散环节。产品经理编写需求,技术架构师将它们转化为设计,工程师基于设计进行构建,受监管企业的 QA 团队进行验证,发布团队负责交付,运维团队监控运行中的系统。工作通过这些阶段之间的文档、工单和签核进行流转。
传统的软件开发生命周期(SDLC)流程繁重,目的是在每一步都确保责任明确与可控。然而,传统的 SDLC 是为一个"编写和实现代码是最耗时、最昂贵阶段"的时代设计的,用以最大化效率,而如今情况已不再如此。PRD(产品需求文档)、估算仪式和产品安全评审,所有这些的存在都是为了让原本可能持续数周、数月或数个季度的开发工作在过程中被迫达成一致。
传统的 SDLC 还带有一些控制机制,它们假设每一步都由人来执行。而那些创造最大价值的组织,已经围绕智能体 AI 现在能够做到的事情重建了他们的流程,同时确保人类始终参与在环(in the loop)。在本指南中,我们借鉴与客户合作的经验,逐步介绍我们 Applied AI 团队在 SDLC 各个阶段内部署 Claude 的几个最佳实践,以加速开发并让流程运行得更快。
当代码不再是瓶颈,且构建阶段的运行速度超过了传统 SDLC 所允许的范围时,以下三点就会成为现实:
瓶颈转移到了构建阶段左右两侧的环节。主要是规划、评审/测试以及部署,这些环节仍然以人类的速度运行。
控制措施与现实脱节,变得难以应对。当代码是由人编写时,逐行人工审查是合理的;但一旦大部分差异(diff)都是由智能体写出来的,人工审查就跟不上节奏了。
治理成本上升,因为例外情况仍然要通过每周或每月召开的会议和委员会来流转处理。
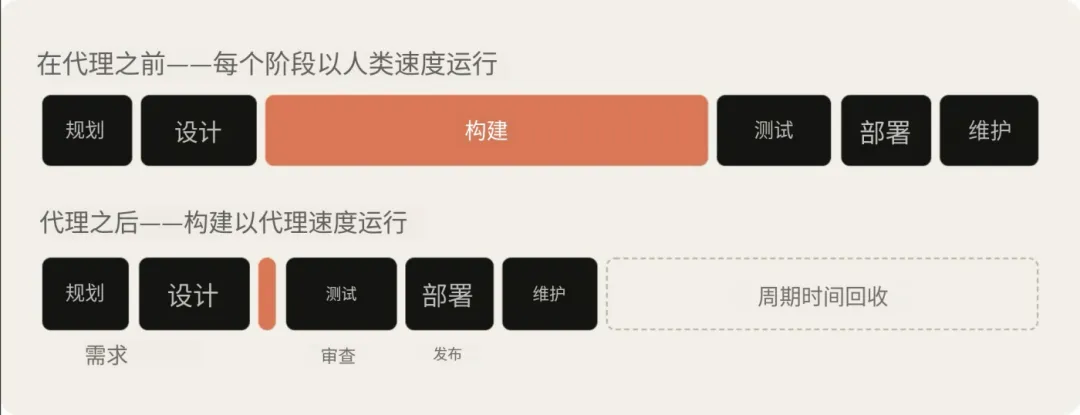
构建不再是约束——围绕它运行的、以人类速度为节奏的环节才是。人类速度的环节保持原有时长,而构建环节则压缩到了数小时。
让我们以安全瓶颈为例。安全团队的规模是按人类产出配置的,因此当智能体成倍提升代码产出时,要么评审队列堆积,要么代码在未经充分审查的情况下就被交付。一个受监管的组织无法接受这两种结果中的任何一种,因此它的安全和政策检查必须与智能体保持同步。
为了更好地实现智能体 AI 的生产力收益并确保其安全,传统的 SDLC 生命周期需要进行与实现阶段同等程度的改造。
目录
代码不再是瓶颈
实战方案(Plays)
阶段 1 — 规划(Plan)
阶段 2 — 设计(Design)
阶段 3 — 构建(Build)
阶段 4 — 测试(Test)
阶段 5 — 部署(Deploy)
阶段 6 — 维护(Maintain)
结语
什么是 AI 原生的 SDLC?
AI 原生的 SDLC 是一个被重新构想的流程,它将旧的控制目标与新的执行机制结合起来。流程不再是线性流动,而变成了一个循环,AI 被嵌入到每一个节点中。AI 原生的 SDLC 倡导自动化的交接和对后续实战方案的自动触发,有助于解决传统 SDLC 各阶段之间手工化、笨重的交接问题。
你还会听到这种转变被称为"智能体 SDLC(agentic SDLC)""AI SDLC",或简称为"智能体软件开发"——标签不同,但描述的是同一件事。
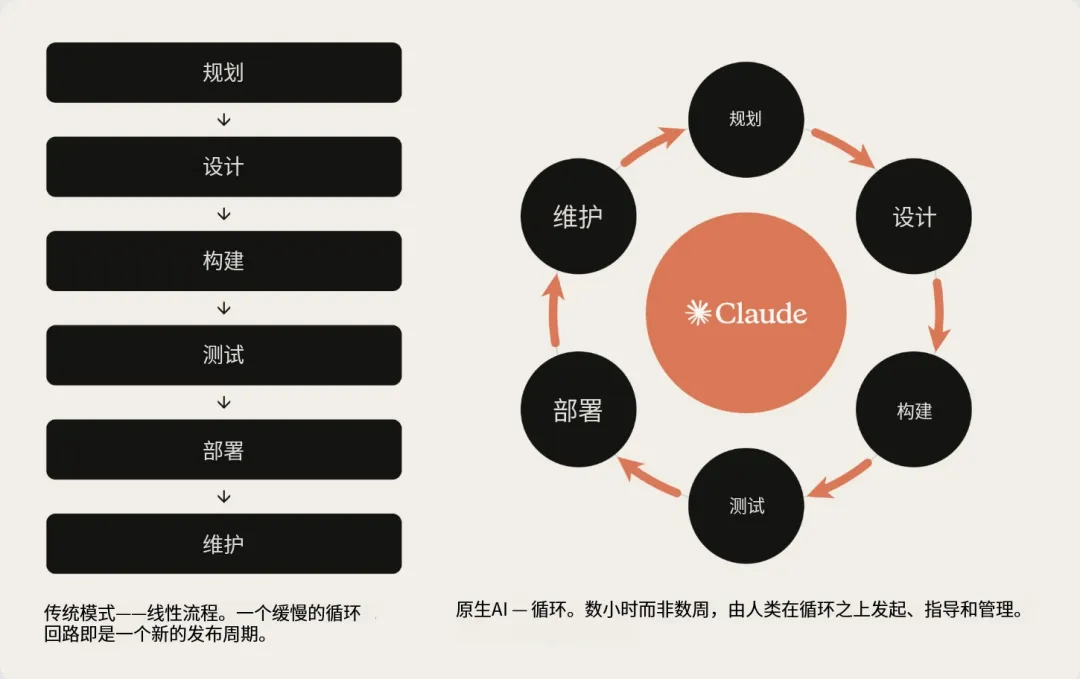
AI 原生 SDLC 在六个阶段的转变
下表突出了传统 SDLC 与由 Claude 支撑的 AI 原生 SDLC 之间两种极端形态,大多数组织都处在两列之间。
| 阶段 | 传统 SDLC | AI 原生 SDLC |
|---|---|---|
| 规划(Plan) | 由委员会收集需求,通过研讨会和签核进行提炼,由人工撰写 | Claude 直接从源头综合痛点,并将其捕获到 intent.md 中——该文件人类可读、机器可执行 |
| 设计(Design) | 由分析师撰写规格说明,由设计师解析 | 需求与设计在与智能体的一次工作会议中被压缩整合,由编码为技能(skills)的标准引导,并在 git 中版本化 |
| 构建(Build) | 测试和代码都是手写,文档在主要开发完成之后才编写 | 测试和代码由 AI 生成,机构知识以版本化的机器可读 CLAUDE.md 文件和技能的形式维护 |
| 测试(Test) | 在阶段边界处设置 QA 关卡 | 贯穿实现过程的持续评估(evals) |
| 部署(Deploy) | 人类逐行审查代码,治理发生在评审周期中,往往不一致 | 多层智能体评审,仅对受监管和关键代码保留人工评审。治理在 AI 行动时即被强制执行,以钩子(hooks)作为审批关卡 |
| 维护(Maintain) | 人类监控生产环境以发现缺陷 | 智能体监控实时部署。任何被突破的控制带(control band)都会被诊断并作为新的 intent.md 写回循环 |
贯穿右列的主线是"已提交的产物(committed artifact)"。每个阶段都以向版本控制提交一个产物作为结束(包括 intent.md、spec.md、plan.md、差异及其测试、带有评审发现的 PR,以及事故记录),下一个阶段则以读取它作为开始。在早期阶段,.md 文件是主要产物,因为产品负责人和智能体都能读取同一个文件并对其采取行动。从构建阶段开始,产物变成了代码及其记录。提交链同时也是审计线索:谁要求了什么、智能体产出了什么、谁批准了它。
人类仍然对每个需要判断力(judgment)的决策负责。在智能体 SDLC 的世界里,人类的注意力随着必须被评审的产物一起发生转移。
每一个阶段都提交一个下一个阶段可以读取的产物。意图(intent)、规格(spec)、计划(plan)、差异和评审发现共同构成了审计线索。
实战方案(Plays)
实战方案是这本手册的核心,它们被分为六个非线性的阶段(规划 Plan、设计 Design、构建 Build、测试 Test、部署 Deploy、维护 Maintain),共同覆盖完整的生命周期。
每个实战方案涵盖:
改变了什么;
如何开始;
具体的实施步骤;
治理考量;
如何衡量它是否奏效。
这些步骤是模块化的,组织可以根据自身的独特需求,选择在不同时间优先改造不同的阶段。每个实战方案在"先决条件(Prerequisites)"下列出了它的依赖项,依赖关系图进一步说明了这一点。
一个阶段以提交一个产物作为结束,而该次提交会启动下一个阶段。一份被接受的 intent.md 触发需求和设计环节,一份被批准的 spec.md 触发计划模式(plan mode),一个被合并的 PR 触发流水线,而生产环境中被突破的控制带则写入下一份 intent.md——如此循环往复。
首先,你手工提示(prompt)每一步,最终形成一个循环,其中每个被接受的产物都会触发下一个关卡。人类的注意力集中在关卡处,评审智能体标记的内容,而不是从零开始每个阶段。
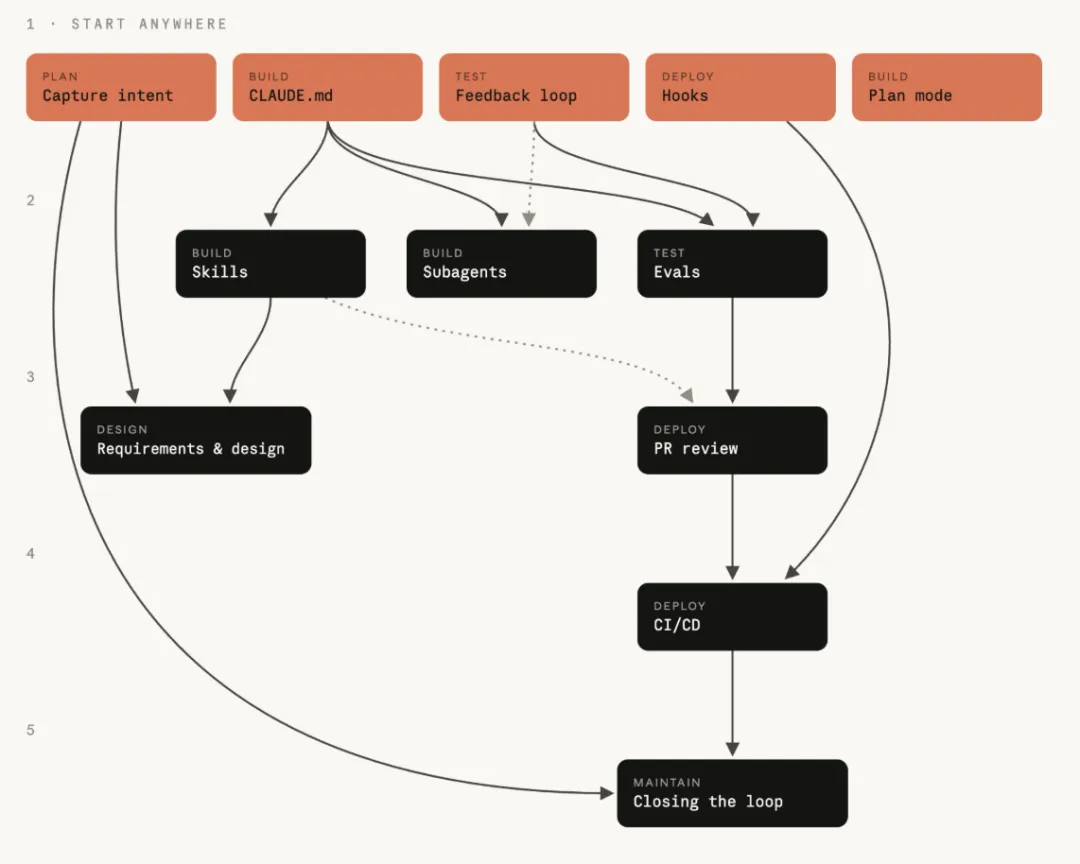
实战方案按阶段列出;箭头给出了采用它们的顺序。两者并不相同。从任何一个"黏土(clay)"实战方案开始——没有任何箭头指向它,因此它一开始不需要任何前置条件。对于任何其他实战方案,指向它的箭头所代表的实战方案就是在它之前需要先采用的。
01 规划(Plan)
创意不再等待有人把它们写下来。意图被一次性捕获,用发起者自己的语言,作为一个版本化的产物,供下一个阶段采取行动。
以 intent.md 形式捕获
启动软件开发流程的 intent.md 可以通过不同途径进入。一个人有了想法,提交了一张工单,或者通过告警浮现出一起事故(见阶段 6:维护)。
当一个人有了想法,他会与 Claude 一起头脑风暴,并产出一份 markdown 形式的原型规格(proto-spec)。在传统 SDLC 中,同一个人随后必须说服产品团队的一名成员与他一起或代他将这个想法写下来。
由 Claude 生成的原型规格是人类可读、版本化的,并且可以被下一个阶段立即消费。该原型规格被保存为 intent.md。
无论意图是来源于事件触发器还是智能体,所适用的步骤都是相同的:产品负责人在 intent.md 被提交之前,对其由智能体撰写的内容进行评审和纠正。
传统方式 一个想法要经过待办条目(backlog entries)、用户故事(user stories)、故事点(story points)和细化会议(refinement meetings),才能被任何人采取行动。所有权在每次交接时转移,因此最终到达工程团队的,已经与发起者本意相去甚远。
AI 原生方式 发起者与 Claude 一起头脑风暴,并将结果记录为 intent.md——一份用发起者自己措辞写成的原型规格。该产物包含想要什么、为什么,以及在哪些约束条件下。重复性的流程通过技能进行编码。
如何开始
先决条件
None.
基础设施
面向非工程人员(claude.ai 或 Cowork)的 Claude 访问权限;一份商定好的 intent.md 模板;一个供意图(intent)存放的、共享且版本化的"家",由产品负责人看管。对于单一产品,最简单的"家"就是产品仓库中的一个 intent/ 文件夹。这种设置让产物链紧邻由其衍生出的代码。只有当意图跨越多个仓库时,一个专门的意图仓库才值得承担其开销;而在单体仓库(monorepo)中,它只是一个目录。阶段 3:构建 的侧边栏涵盖了这个"家"如何与已经保存记录的 Jira 或需求工具相关联。
建立这一套是平台或工程团队的一次性任务。一名技术团队成员需要搭建好意图的"家",并决定谁可以向其中写入内容,因为许多贡献者将来自整个组织。
仓库一旦存在,没有 git 经验的贡献者就不需要直接使用 git。相反,一个连接到版本控制系统(如 GitHub)的连接器,让 Claude 能够代表他们从 claude.ai 或 Cowork 提交 markdown 文件。
如何执行
发起者用自己的语言向 Claude 描述问题。发起者可以描述今天无法做到的事情、受该想法影响的人、更好的状态是什么样,或者哪些内容不在范围内。不需要正式的语言。
头脑风暴,直到想法变得具体。Claude 会提出分析师会问的问题:范围、用户、约束,以及成功是什么样。
让 Claude 使用组织的模板,将结果写成
intent.md。该模板可以由技术团队成员设立并经过主管签核,作为技能(skill)进行编码。它可以涵盖问题、提议的结果、受影响的用户和系统、约束条件,以及悬而未决的问题。发起者纠正 Claude 误解的任何内容。
将
intent.md提交到共享的"家"。作者和时间戳会并入记录,产品负责人从那里接手这个想法。
# 意图:理赔状态自助服务作者:J. Ortiz(理赔运营)。状态:草稿。## 问题客户致电联络中心询问他们的理赔进行到哪一步了。话务员大约三分之一的通话时间花在仅询问状态的问题上。## 提议的结果客户在门户中看到理赔状态、下一步以及预计日期。## 受影响的用户和系统理赔话务员、门户团队、理赔核心 API。## 约束门户会话中不新增任何 PII(个人身份信息)。仅使用现有身份验证。## 悬而未决的问题第三方损失理算师是否也需要访问权限?
治理考量
证据就是已提交的 intent.md,它列出了作者、时间戳和完整的修订历史。它被记录在意图"家"的 git 历史中。由产品负责人批准,而将意图送入阶段 2:设计的接受或拒绝决策,被记录为合并(merge)或关闭的评审。
如何衡量它
先行指标(Leading indicator)
从第一次对话到一份已提交的 intent.md 所花的时间,从意图"家"的 git 历史中读取,其中记录了作者和时间戳。预期是从跨越数周的获取与细化周期,下降到数小时。
滞后指标(Lagging indicator)
存活率(survival rate),即产品负责人接受的、进入阶段 2:设计而非关闭的 intent.md 文件所占的比例。接受或拒绝的决策被记录为产物的合并或关闭的评审。此外,还包括同一变更在首个 spec.md 提交之后,对 intent.md 所做的修改数量。
02 设计(Design)
需求和设计坍缩进一次会话中。政策在规格撰写的同时就被应用,而不是在数周后的评审中才被发现。
需求与设计
一旦被产品负责人批准,Claude 就会拿取被接受的 intent.md,并产出一份需求与设计规格。这由组织关于品牌、安全、合規和用户体验(UX)的技能所引导。
产品负责人评审这份规格,但不撰写它。这个流程的目标是创建一份工程团队可以据此制定计划、并带有标记的关注区域的规格。
前端工作是最清晰的例子。一旦 intent.md 被接受,产品负责人就会基于 intent.md 在 Claude Design(测试版)中制作设计原型,对原型进行迭代,然后将其导出到 Claude Code 进行构建。
传统方式 需求与设计是分开的阶段,由不同的团队运行。分析师将想法形式化为需求,然后设计师再将其解析回一份设计。这种分离是为了责任明确而存在的,但它缓慢且存在信息损耗。
AI 原生方式 两个阶段在一次被提示的会话中发生。Claude 拿取 intent.md,并在组织技能的约束下,产出一份需求与设计规格,并标记出关注区域。
如何开始
先决条件
撰写一份 intent.md 文件,并将品牌、安全、合規和 UX 政策编写为技能(skills)。
基础设施
一名拥有 Claude 访问权限的产品负责人。不需要工程技能。
如何执行
产品负责人开启一个会话,使其组织的技能可用,并附上
intent.md。产品负责人将提示(prompt)指向
intent.md,指明约束条件,并要求标记出关注点。一开始手工运行,随后将其编写为组织级的斜杠命令(slash command)。从那里开始,让意图"家"中对intent.md的接受成为触发器,用一个在合并时触发的非交互式作业,在组织技能加载的情况下运行该环节,并将spec.md作为拉取请求(pull request)提交(部署阶段的 CI/CD 实战方案涵盖了其中的管道细节)。从那时起,产品负责人的首次参与就是评审。同一位产品负责人根据想法评审这份规格。这份规格是否解决了所述的问题?
intent.md中悬而未决的问题是否得到了回答或延续?首先处理被标记的关注点,因为它们是分析师本应升级上报的点。产品负责人在工程团队看到规格之前,与相应的政策负责人(policy owner)逐一解决这些问题。
将
spec.md与intent.md一并提交。这对文件记录下了要求了什么以及决定了什么。产品负责人决定是否将该规格和意图推进到构建阶段,并就组织归类为更高风险的任何事项咨询技术主管(tech lead)。这个决定始终由人类队友做出,而接受该规格正是启动阶段 3:构建中计划模式实战方案的动作。
它看起来是什么样(提示词)
读取附带的 intent.md,并产出一个将其集成到我们现有代码库中的需求与设计规格。应用你可用的技能,使计划符合我们的品牌指南、安全策略和 UX 标准。将规格完整地记录为 spec.md,准备交付给工程团队。清楚地描述任何关注区域,特别是当你无法满足相互矛盾的政策时。治理考量
政策不再是在数周后的评审中才被发现,而是在撰写规格的同时就被读取和应用。组织的技能作为对该规格的约束而应用。该规格、生成它的提示词,以及生效中的技能版本,都被记录在版本控制中。产品负责人对规格进行签核,并将标记的关注点路由给指定的政策负责人。
如何衡量它
先行指标
对同一变更而言,从 intent.md 提交到 spec.md 提交之间经过的时间(两个 git 时间戳),与旧的需求加设计周期进行对比。
滞后指标
构建开始之后的需求返工。统计同一变更中,日期晚于首个 plan.md 提交的 spec.md 提交数量。git 日志会直接给出这个数字。
03 构建(Build)
没有一份被接受的计划,什么都不会被实现。机构知识变成了智能体读取的文件,护栏(guardrails)以代码而非习惯的形式运行。
以 Claude Code 计划模式作为默认起点
工程师在计划模式下开启 Claude Code 会话,将来自阶段 2:设计的已批准 spec.md 交给 Claude,并让它对自己进行访谈(interview),在计划上迭代,直到工程师满意为止。
传统方式 一名工程师阅读设计并开始编写代码。这个变更将如何完成——具体到哪些文件、哪些测试——留在工程师的脑中,或者最多留在工单的评论里。没有其他人能够评审它。评审者看到的第一样东西就是完成的差异(diff),而到那时返工已经很慢了。
AI 原生方式 工作从一份书面计划开始,该计划由 Claude 在计划模式下产出,在那里它可以在不修改任何东西的情况下读取代码库。工程师在代码编写之前纠正计划,被批准的版本作为 plan.md 提交,供后续阶段核对。
如何开始
先决条件
意图产物(intent.md 或 spec.md,如果存在的话),以及 CLAUDE.md 文件会有所帮助。
基础设施
可访问仓库的 Claude Code。
如何执行
工程师在计划模式下与 Claude 开启会话。
工程师将
intent.md和spec.md交给 Claude,并要求一份实现计划,其中指明发生变更的文件、工作顺序,以及用以证明它的测试。通过询问这个变更可能破坏什么、哪一步风险最大、以及 Claude 选择不做哪些其他选项,来拷问(interrogate)这份计划。
迭代,直到一个从未见过这次对话的工程师仅凭这份计划就能实现该变更。
将已批准的计划作为
plan.md提交。该计划并入审计线索,而 PR 评审实战方案(阶段 5:部署)会据此核对最终的差异。接受计划,让 Claude 实现。有了扎实的计划,实现往往一次就能通过。
当实现偏离计划时,在同一提交中更新
plan.md。考虑使用一个钩子来强制两者之间的同步。
它看起来是什么样(plan.md)
# 计划:理赔状态自助服务(来自 intent.md 2026-06-02)## 发生变更的文件portal/src/claims/StatusPanel.tsx(新建)、claims-api/routes/status.py、claims-api/tests/test_status.py## 工作顺序1. 在现有身份验证之后添加状态端点。2. 面板对接该端点。3. 接入门户导航。## 风险理赔核心 API 在 50 rps 处进行速率限制;面板必须进行缓存。## 证明test_status.py 覆盖四种理赔状态;截图与已批准的原型相匹配。
治理考量
设计评审在任何代码生成之前进行,此时改变方向还只是编辑一份文档的事。计划模式本身强制执行这一点,因为在工程师接受计划之前,Claude 无法编辑文件。计划及其修订,连同是谁接受了它,都被记录在日志中。常规变更由工程师批准,而组织归类为更高风险的任何事项则上报给技术主管或架构师。
如何衡量它
先行指标
从首次实现就合并的变更所占比例,以及从计划批准到合并 PR 的时间(所需数据在 PR 元数据中)。
滞后指标
每个变更的返工轮次,同样来自 PR 元数据;以及合并的差异仍然与已提交的 plan.md 相匹配的频率。
Claude Code 的自动(auto)模式
Claude Code 也可以在自动模式下运行,即工程师批准计划,并在满意且经过迭代后,Claude 应用每一次变更,而无需逐次编辑的提示。随着后续实战方案中的护栏趋于成熟(调优好的 CLAUDE.md、编码了政策的技能、阻止不安全操作的钩子,以及 Claude 可以运行的测试套件),自动接受(auto-accept)成为常规工作的默认选择:一份紧凑的 spec.md、一个小的爆炸半径(blast radius),以及测试已经覆盖的代码。
这种转变现在从"用户看着智能体做编辑并评审其动作",转向"在更长的自主会话之后评审产物"。自动接受模式进一步实现了个人和团队层面的并行化(当与工作树 worktrees 结合使用时),并且对于如阶段 6:维护中所述的自主运行 SDLC 并闭合循环(closing the loop)至关重要。
侧边栏
遗留系统与真相来源(source of truth)
适用于流程产出的每一个产物。
现有的 SDLC 流程很可能已经在追踪产物,只是不是用 markdown 文件。工作项可能在 Jira 中,需求在一个内建了监管可追溯性的工具中,设计在 Figma 中,变更审批则在一个变更委员会(change board)处。这些系统难以被取代,因为审计人员和监管者已经接受它们,并且其他团队也依赖于它们,因此 AI 原生的 SDLC 必须围绕现有系统进行调整。
在向 AI 原生 SDLC 过渡时,对于流程产出的每一个产物,指定一个系统作为真相来源(source of truth),其他一切都持有其副本或指向原件的链接。以下配置可以设置为拥有一个真相来源,选择因产物而异:
以仓库作为真相来源。 markdown 产物是权威记录,遗留系统引用提交(commit)中的文件。对于工程驱动型组织来说,这可能是最干净的配置之一,因为所有记录都存在于一个工具中,拥有一套时间戳权威。
以遗留系统作为真相来源。 Jira、ServiceNow 或需求工具持有权威记录,而 markdown 产物是工作副本。Claude 在会话开始时读取记录,并在生成规格或计划的同一会话中,通过一个 MCP 连接器将结果写回。
以链接作为最低门槛。 所有产物都注明记录 ID,所有遗留记录都包含 markdown 文件的提交 SHA。在向 AI 原生 SDLC 过渡时,接受存在两个真相来源,链接是一个不错的起点。
遗留系统和 markdown 优先的系统可以共存,只要两者之间存在链接,或者指定其中一个为真相来源即可。
CLAUDE.md
CLAUDE.md 向 Claude 提供新加入者所需的背景上下文,涵盖约定、命令、架构,以及团队最常看到的错误。那些曾经存在于人们脑中和 wiki 上的知识,变成了一份在每次会话开始时由智能体读取的文件,由整个团队维护,并在每次犯错时进行迭代。
如何开始
先决条件
无。
基础设施
一个仓库、已安装的 Claude Code,以及一名熟悉代码库的工程师。
如何执行
在仓库中运行
/init。Claude 会根据它发现的内容生成一份初始的CLAUDE.md。将生成的文件精简到新加入者在第一天所需的内容。保留构建、测试和 lint 命令,重要的约定,以及 Claude 一直搞错的东西。
将
CLAUDE.md检入(check in)到 git 的仓库根目录,这样整个团队共享同一版本,变更会像代码一样被评审。一个有效的规则在这里很有帮助:当 Claude 两次犯同一个错误时,纠正措施就进入
CLAUDE.md。将其保持在不到一页,因为 Claude 在会话开始时会读取全部内容,任何过时内容都在白白占用上下文。
它看起来是什么样(CLAUDE.md)
# 支付服务## 命令-构建:makebuild-测试:maketest(单元测试)、makeitest(集成测试,需要docker)-Lint:makelint(在CI中运行;推送前修复)## 约定-Java21、SpringBoot3。不再使用新的Lombok。-金额永远是BigDecimal,绝不用double。-每个端点都需要在src/itest中有一份集成测试。## 架构-api/存放REST控制器,core/存放领域逻辑,adapters/与外部系统通信。-Kafka事件在schemas/中定义;永远不要编辑生成的类。## Claude常犯的错误-不要升级依赖版本;平台团队负责它们。-遗留的v1/包已冻结;变更都进v2/。
治理考量
CLAUDE.md 是版本控制的,因此智能体所遵循的指令是可评审、可审计的。团队约定通过该文件应用,对其的变更记录在 git 历史中,代码所有者(code owners)在 PR 评审中批准这些变更。
如何衡量它
先行指标
Claude 重复一个本应被 CLAUDE.md 抓住的错误的频率。对 CLAUDE.md 的纠正或变更应在 git 历史中追踪。
滞后指标
一名新团队成员从加入 PR 历史到首个合并 PR 所花的时间。
将技能作为机构知识
技能是组织使其机构知识可操作化的方式。指令是显式的、版本控制的、广泛应用的,并且在政策变更时集中更新。经验法则:为必须一致应用的机构知识编写技能;不要为属于 CLAUDE.md 或提示词的组件编写技能。
如何开始
先决条件
不需要。拥有 CLAUDE.md 会有帮助,因为它将智能体的工作知识保留在仓库中,但技能并不依赖它。
基础设施
一项有指定负责人和书面真相来源的政策。
如何执行
挑选今天执行不一致的一项知识。这可以是一项安全标准、一个 API 设计约定,或一条品牌规则。
将它编写为一个技能,即一个包含
SKILL.md的文件夹,其 frontmatter(前置元数据)说明它何时触发,其正文说明该做什么。一名工程师根据政策负责人的真相来源,借助 Claude 来编写它。将技能放在仓库的
.claude/skills/<name>/处,使其随代码一起发布;或者通过插件在组织范围内分发。测试该技能是否触发。以不同方式要求 Claude 完成相关任务,并确认每次该技能都会加载。
当政策变更时,更改技能,并由政策负责人签核该变更。
工程师在他们下一次会话中自动获取到新版本。
它看起来是什么样(.claude/skills/secure-api-review/SKILL.md)
---name: secure-api-reviewdescription: 应用 API 安全标准。每当你创建或修改对外的端点、 评审 API 代码,或生成 OpenAPI 规格时使用。---# 安全 API 评审当你创建或变更一个 API 端点时:1. 身份验证:每个端点都需要网关 JWT; 除 /health 外不允许匿名路由。2. 输入校验:根据 OpenAPI 模式校验请求体, 并拒绝未知字段。3. 审计:每个改变状态的端点都发出一条审计事件, 包含操作者、动作、实体和时间戳。4. 数据分类:在模式中被标记为 pii 的字段绝不可 出现在日志或错误消息中。运行 scripts/check-endpoints.sh,并将它的输出包含进你的总结。
治理考量
技能是一种控制,尽管是建议性的(advisory)。它让 Claude 在代码编写的同时很可能应用该政策,但没有什么能强制某个会话遵守它。一项必须始终成立的政策,需要在技能背后有某种确定性的东西,例如一个阻止该动作的钩子,或在 PR 时重新检查该政策的评审环节。技能让违规变得罕见,钩子让违规几乎不可能。技能调用记录在会话追踪中,政策负责人像评审代码一样评审技能变更。
如何衡量它
先行指标
从政策负责人批准政策变更,到更新后的技能合并所花的时间,取自该技能文件夹上的 PR。
滞后指标
引用该政策的 PR 评审发现,一旦技能在代码编写时就应用政策,这一数字应趋近于零。在发现没有趋近于零的地方,要么是技能没有触发,要么是它的文本已与官方政策发生偏离。
将钩子作为构建时的护栏
技能是建议性控制,而钩子是它背后确定性的那一层。Claude 的大部分动作在构建阶段都是文件编辑和 shell 命令,因此构建阶段是钩子最终可能最频繁触发的地方。
构建阶段的钩子可以:
阻止对受保护路径(如生成的类或冻结的包)的编辑;
在文件编辑之后运行格式化工具和 linter,使偏离永不发生累积;
让凭据远离差异(diff)。
为任何必须毫无例外成立的政策提供钩子支撑。一个钩子会在每次匹配它的动作上运行,因此构建阶段的钩子应当快速,并且作用域限定在已变更的文件上。更重的检查(如完整的测试套件)属于提交或 PR 环节。
要求人类批准的钩子,应当和阶段 5:部署中的关卡放在一起,因为在构建过程中的一个批准提示,会把一个人重新放回到所有并行运行会话的关键路径上。
并行会话与子智能体(subagents)
一名工程师可以同时驱动多个工作流。
一个并行会话(parallel session)是另一个完整的 Claude Code 实例,在它自己的 git worktree 中处理一个独立的任务。每个独立的会话对其他会话一无所知,引导它们的工程师是它们唯一共享的东西。
子智能体(subagent)在单个会话内作为一个作用域受限的辅助程序运行,拥有自己的上下文窗口和工具限制,适合在多任务中反复出现的工作,例如验证应用的运行是否符合预期。
并行会话提高了工程师可以同时进行中的任务数量,而子智能体让每个会话专注于自己的任务。工程师的工作是引导和评审它们全部。
传统方式 一名工程师一次处理一个任务,并将一天或一周中相当大的一部分时间花在构建、测试和评审者身上。在等待时切换任务虽然可能,但上下文切换令人疲惫,以至于很少人愿意这么做。
AI 原生方式 一名工程师同时运行多个 Claude 会话,每个会话在自己的 worktree 中处理自己的任务。重复性的工作变成带有自身上下文和工具限制的子智能体。工程师的工作转变为编排(orchestrating),并最终转变为构建和监控循环。
如何开始
先决条件
CLAUDE.md,因为所有会话都会读取该文件。反馈循环(阶段 4:测试)在这里也有帮助,因为当会话能够验证自身工作时,工程师所需的监督更少。
基础设施
一个 git 仓库,因为隔离来自 worktree,以及调优过的权限设置,使会话不必为组织认为安全的命令等待批准提示。
如何执行
工程师将工作拆分为触及不同文件的任务,使用计划模式实战方案(阶段 3:构建)中的计划,来查看工作在何处是独立的。共享文件的任务在单个会话中一个接一个地运行。
每个并行任务都拥有自己的 worktree,例如在一个终端中
claude --worktree feature-auth,在另一个终端中claude --worktree fix-rate-limit。worktree 是它自己分支上的一个独立检出(checkout),可防止会话在文件上发生碰撞。两到三个会话是一个合理的起点。实际的上限是一个人能妥善评审多少个工作流,因此只在评审跟得上的时候才增加会话。
将重复性的工作转变为子智能体,如
.claude/agents/中定义的 markdown 文件,每个都带有名称、关于何时使用的描述,以及它可以触及的工具。示例包括:在主智能体完成后剥离不必要复杂性的代码简化器(code simplifier)、运行应用并检查行为的验证器(verifier)、探索代码库并回报而不淹没主上下文的研究器(researcher)。将这些定义检入 git,以便整个团队共享它们。
它看起来是什么样(.claude/agents/verifier.md)
---name: verifierdescription: 在会话报告完成之前运行应用并检查变更是否生效tools: Bash, Read---用makerun启动应用。演练变更后的行为以及两个最接近的相关流程。报告你运行了什么、看到了什么,以及任何与plan.md不匹配的行为。不要修复任何东西;只做报告。
治理考量
更多的会话意味着更多的产出,因此控制必须来自仓库中的配置。那里的钩子和权限设置适用于所有会话,而一个会话所做的事情被记录并归因为运行它的工程师。
如何衡量它
先行指标
在评审质量保持的情况下,每名工程师的并发会话数,从 OpenTelemetry 导出中统计;以及一天中用于引导而非等待的时间所占比例。
滞后指标
每名工程师每周合并的变更数,结合根据 PR 历史确定的返工率一起读取。
04 测试(Test)
在人类的眼睛看到工作之前,每个会话都会先检查自己的工作,而引导智能体的配置会像它编写的代码一样被回归测试。
给 Claude 一个反馈循环
始终给 Claude 一种验证自身工作的方式,无论是测试、构建,还是截图对比。会话在工程师看到之前,先检查自己的工作并修复自己的错误。
反馈循环不应与验证器子智能体(阶段 3:构建)混淆。反馈循环贯穿整个任务,运行次数与工作次数一样多。而验证器子智能体,则是在会话认为工作已完成时,通过运行一个全新上下文窗口来打包最终检查的一种方式。这样,结论就不会被产生代码的那些假设所影响。
传统方式 代码有效的信号来得很晚。CI 数分钟之后,测试人员数天之后,生产环境数周之后。当由智能体产出代码时,一个迟来的信号意味着必须有人检查它的所有产出,而那个人就成了瓶颈。
AI 原生方式 在人类的眼睛看到之前,会话被给予一种检查自身工作的方式。运行测试、运行构建、截图。Claude 迭代直到检查通过,因此到达工程师手中的东西已经通过了检查。搭建这个循环落在运行会话的工程师身上,以下步骤是为他们写的。
如何开始
先决条件
无。
基础设施
一个测试套件和一个构建,各自都能用一条命令在本地运行。对于 UI 工作,让 Claude 看到结果的方式至关重要,无论是通过浏览器工具还是通过 MCP 接入的截图工具。
如何执行
如果今天检查工作需要一系列命令和一些环境知识,就将它包装进一个单一目标,例如 "make test" 或 "npm test",在失败时以非零状态退出。
在
CLAUDE.md的 Commands 部分,列出每条命令以及一个健康输出的示例。声明一个目标并使其可量化,以便 Claude 无需询问你就能检查工作,例如:"test_status.py 中的所有测试都通过"、"截图与附带的原型相匹配",或"端点返回 200 并带有新字段"。
对于缺陷修复,先编写失败的测试。让 Claude 将缺陷复现为一项测试,运行它,并确认它因你预期的原因而失败。提交该测试。只有到那时,才让 Claude 在不编辑测试的前提下让它通过,由最后一步的测试文件钩子强制执行该限制。在修复之前就已存在、且智能体无法重写的测试,就是缺陷已消失的证明。
对于 UI 工作,用视觉检查闭合循环。给 Claude 一个浏览器或截图工具,把原型交给它,让它迭代。实现、截图、对比、调整。两到三轮是正常的,结果应当每一轮都有改善。
让验证成为"完成"的一部分。指令位于
CLAUDE.md中。在报告任务完成之前运行测试,并展示输出。最后,循环本身需要被保护,因为一个修复代码的智能体绝不能削弱对该代码的检查。一个在修复任务期间阻止编辑测试文件的钩子可以实现这一点。另一种做法是在评审中检查差异,并拒绝任何触及测试的变更。
它看起来是什么样(CLAUDE.md 验证块)
## 验证你的工作-构建:makebuild(必须以"Build succeeded"结束)-测试:maketest(全绿;绝不跳过或删除失败的测试)-Lint:makelint(零警告)在报告任何任务完成之前运行这三项,并粘贴输出。如果测试失败,修复代码,而不是修复测试。
治理考量
强制执行什么
在报告任务完成之前的验证,以及阻止智能体在修复期间编辑测试文件的限制,两者都在组织希望得到保证的地方以钩子的形式实现。
证据是什么
"make test" 的字面输出、构建日志,或 Claude 运行并粘贴的截图对比,因此证据来自工具链。
记录在哪里
在会话转录(transcript)中,由 OpenTelemetry 导出转发到组织的可观测性(observability)技术栈;以及 PR 的检查运行中,评审者和任何后续审计者都能在那里看到它。
谁批准
评审 PR 的代码所有者,由于机械性的证据已经附上,他可以专注于意图和风险。
如何衡量它
先行指标
智能体编写的变更的首次通过(first-pass)CI 成功率,CI 系统已经支持这一点。
滞后指标
每个 PR 的评审时间(来自 PR 元数据),一旦测试抓住了评审者过去抓取的东西,这个时间应当下降;以及来自事故追踪器的变更失败率。
CI 中的持续评估(continuous evals)
评估(evals)是 AI 原生版本的阶段关卡式 QA(stage-gate QA)。在实践中,这意味着一套每当智能体的配置发生变更时就会运行的套件。当换入一个新模型或重写一个提示词时,评估套件会说明智能体是否仍以达到同样的标准完成工作。
评估应当被视为一套活套件(live suite)。随着模型的改进,曾经具有区分度的用例不再具有区分度,必须添加源于持续监控的新用例。
根据用例的不同,一些团队可能更喜欢按固定节奏离线运行这些评估,而不是在每次变更时都运行。以下步骤针对的是持续评估。
如何开始
先决条件
CLAUDE.md 和反馈循环(阶段 4:测试)。
基础设施
能够非交互式运行 Claude Code 的 CI,以及为评估运行提供预算的 API 密钥。
如何执行
平台工程师从近期工作中收集 20 到 50 个真实任务及其预期/可接受的结果。
将每个任务编写为一个评估(eval),即提示词加上定义可接受条件(测试通过、lint 干净、行为未变、政策被遵循)的检查。
该套件在 CI 中按固定节奏、以及在
CLAUDE.md、技能或钩子发生任何变更时非交互式地运行,因为这些配置引导着智能体,理应得到代码所得到的回归测试。用结果来对配置变更设门槛(gate)。一个导致通过率下降的技能变更,在合并之前会被评审。
每一起生产事故都会获得一个评估,由负责该事故的团队编写,并作为回归测试保留在套件中。
它看起来是什么样(.github/workflows/agent-evals.yml)
name: Agent evalson: pull_request: paths: ['CLAUDE.md','.claude/**'] schedule: - cron: '0 2 * * *'jobs: evals: runs-on: ubuntu-latest steps: - uses: actions/checkout@v4 - run: npm install -g @anthropic-ai/claude-code - name: Run eval suite env: ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }} run: | for eval in evals/*.json; do claude -p "$(jq -r '.prompt' $eval)" \ --allowedTools "Read,Edit,Bash(make test)" \ --output-format json > result.json ./evals/check.sh "$eval" result.json done
治理考量
评估为 QA 提供了一个能跟上智能体产出的关卡。通过率阈值作为合并检查被强制执行,运行被记录以便随时间比较结果,而拥有配置变更的团队批准它。
如何衡量它
先行指标
评估通过率随时间的变化,由套件在每次运行时报告;以及一起生产事故变成永久评估需要多长时间。
滞后指标
在 CI 中捕获的回归,对比来自事故追踪器的在生产中发现回归。
05 部署(Deploy)
评审双向运行,治理在智能体行动时即被强制执行。智能体完成生产关卡之前的一切,而不越过它。
PR 评审循环中的 AI
Claude 既给出评审,也接收评审。它根据组织的政策评审 incoming 的 PR,并处理自己 PR 上的评审评论。这让工程师能够专注于 PR 评审中的行为,归根结底就是判断意图和风险。
传统方式 评审能力是按人类产出规划的。一个 PR 等待评审者通读全部内容,评审质量随评审者负载而波动,作者一边追着催,一边待办堆积如山。
AI 原生方式 所有 PR 都得到一组完全相同的评审环节,发现按严重程度排序。人类的注意力上升了一个层级,转向变更是否实现了计划意图,以及风险是否可接受。
如何开始
先决条件
来自阶段 3:构建的更新过的 CLAUDE.md 文件;如果评审环节强制执行书面政策,则需要技能、已定义的子智能体。
基础设施
一个安装了 Claude 集成的仓库,要么是管理员启用的托管版 Code Review(研究预览)服务,要么是在你自己 CI 中运行的 claude-code-action,在需要时用 AWS Bedrock、Google Vertex 或 Microsoft Foundry 进行模型调用(CI/CD 实战方案涵盖了部署选项)。要求代码所有者批准的分支保护(branch protection)策略也值得设置。
如何执行
托管的 Code Review 服务是最快的起点。一名管理员启用它并选择仓库。当你需要对流水线的控制,或希望 API 调用通过你自己的云协议路由时(CI/CD 实战方案涵盖了该管道细节),在你的 CI 中用 claude-code-action 运行评审。
技术主管将评审政策写成仓库根目录下的
REVIEW.md,分为组织关心的几个环节:缺陷和逻辑错误;安全和漏洞;对照规格(来自需求实战方案的spec.md)、实现计划(来自计划模式实战方案的plan.md)以及设计原则的合规性。REVIEW.md还定义了什么算"重要(Important)"而非"挑剔(Nit)",以及什么该跳过。技术主管设定人类的门槛。发现本身不会批准或阻止一个 PR,分支保护仍然需要来自代码所有者的批准。一个希望用发现来给合并设门槛的平台工程师,可以读取检查运行以机器可读计数形式发布的严重程度统计。
当一名评审者或作者在一个评审评论中 @claude 时,Claude 会处理该评论并推送修复。PR 线程记录了请求和变更两者。这个修复循环通过 claude-code-action 运行。在托管服务中,评论
@claude review会请求一次全新的评审。对于 Claude 开启的 PR,更进一步,让 Claude 看护(babysit)PR 直至合并。团队将一个自定义斜杠命令包裹进这个循环,该命令会清扫 PR 上未解决的评审评论和失败的检查,处理它们并推送修复,直到 PR 变绿并只等待代码所有者的批准。评审发现反馈回
CLAUDE.md。当一次评审第二次标记一个错误时,纠正措施作为该评审的一部分进入CLAUDE.md,并且由于评审会读取CLAUDE.md,该错误会从现在起的下一个 PR 起被抓住。评审还会在变更使CLAUDE.md过时时进行标记。技术主管每月通过给发现评级(让评审者改进)以及在
REVIEW.md中限制 Nit 数量来调优设置。生成的路径和 CI 已经强制执行的任何内容都被排除在外。
它看起来是什么样(REVIEW.md)
# 评审指令## 环节运行三个环节,并为每个发现打上环节标签:- 缺陷:逻辑错误、损坏的边界情况、细微的回归- 安全:注入风险、身份验证缺口、日志中的 PII- 合规:变更与 spec.md、plan.md 以及我们的设计原则相匹配## 此处"重要"的含义将"重要"保留给会破坏行为、泄露数据或违反政策的发现。风格和命名是 nit(吹毛求疵)。## 限制 nit 数量每次评审最多报告五个 nit;将其余的以计数形式总结。## 不要报告src/gen/ 下的生成文件,以及 CI 已经强制执行的任何内容。
治理考量
职责分离(separation of duties)得以保留,因为编写代码的智能体没有办法批准它。评审政策在 REVIEW.md 中应用于所有 PR,而发现、修复、评级和批准都记录在 PR 历史中,因此 PR 就是审计记录。批准来自通过分支保护的人类,并以发现为依据。
关于这些控制在生产规模上如何组合,请参阅在 Anthropic 保障 AI 原生 SDLC 安全。
如何衡量它
先行指标
到首次评审的时间,应下降到数分钟;以及在没有任何人类触碰分支的情况下解决的评审评论所占比例,数据直接存储在 Git 上。
滞后指标
合并前捕获的缺陷和漏洞,对比逃逸到生产环境的,来自 PR 历史和事故追踪器。
将钩子作为审批关卡
构建阶段使用钩子作为护栏,允许或阻止动作,而无人类参与(阶段 3:构建)。一个钩子也可以"询问",暂停动作直到特定的人批准,这正是发布把关(release gating)所需要的。
该实战方案位于阶段 5:部署,因为发布关卡是最清晰的用例,但钩子并非部署专属:它们在 Claude 行动的任意地方运行。例如,钩子可以在阶段 3:构建期间,在没有变更工单的情况下阻止对迁移和基础设施的编辑,并在阶段 4:测试期间阻止智能体编辑测试文件。
如何开始
先决条件
无。
基础设施
一份书面列出的、变更流程所需的审批清单。
如何执行
工程领导层,连同变更管理和合规部门,列出必须保留的人类审批关卡,例如变更管理签核、发布授权,以及对受保护路径的编辑。
平台工程师将每个关卡表达为一个钩子——一个在 Claude 行动前运行的脚本,可以允许、询问或阻止。
团队钩子放入 git 中的
.claude/settings.json,不可协商的钩子则放入由平台或 IT 管理员拥有的托管设置(managed settings)中,个人工程师无法将其关闭。阻止应当自我解释,因此当一个钩子停止一个动作时,原因和批准路径会出现在 Claude 的输出中。
它看起来是什么样(.claude/settings.json)
{"hooks": {"PreToolUse": [ {"matcher": "Bash","hooks": [ { "type": "command","command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/production-gate.sh" } ] } ] }}
以及关卡本身(.claude/hooks/production-gate.sh)
#!/bin/bash# 生产部署需要一份具名的发布授权cmd=$(jq -r '.tool_input.command' < /dev/stdin)if [[ "$cmd"== *"deploy"* && "$cmd"== *"production"* ]]; thenif [ -z"$RELEASE_APPROVAL" ]; thenecho"生产部署需要一份发布授权。" >&2exit2# exit 2 阻止该动作;消息发送给 Claudefifiexit0
治理考量
钩子就是审批关卡。关卡条件每次都对每个人强制执行。允许和阻止的决策都带时间戳记录。关卡还定义了什么算作批准,无论是已批准的变更工单,还是发布经理的签核。
实例剖析
面向受监管企业的托管设置
由平台团队通过 MDM 或管理员控制台部署;工程师无法编辑或覆盖其中的任何内容。
{"permissions": {"deny": ["Read(.env*)", "Read(./secrets/**)","WebFetch", "Bash(curl *)", "Bash(wget *)" ],"allow": ["Bash(git *)", "Bash(make build)","Bash(make test)", "Bash(make lint)" ],"disableBypassPermissionsMode": "disable" },"allowManagedPermissionRulesOnly": true,"sandbox": {"enabled": true,"failIfUnavailable": true,"allowUnsandboxedCommands": false,"network": { "allowedDomains": ["git.internal.example.com","registry.npmjs.org"] },"credentials": {"files": [ { "path": "~/.ssh", "mode": "deny" }, { "path": "~/.aws/credentials", "mode": "deny" } ],"envVars": [ { "name": "GITHUB_TOKEN", "mode": "deny" } ] } },"allowManagedHooksOnly": true,"disableSideloadFlags": true,"allowManagedMcpServersOnly": true,"strictKnownMarketplaces": [ { "source": "github", "repo": "example-corp/approved-plugins" } ],"requiredMinimumVersion": "2.1.193"}
每一行在控制层面买到了什么
permissions.deny 让机密远离智能体的上下文,并通过工具阻止任意的网络出口;permissions.allow 预批准安全的内部循环,从而使拒绝列表不会变成提示疲劳(prompt fatigue)。
disableBypassPermissionsMode 加上 allowManagedPermissionRulesOnly 意味着没有工程师、项目文件或命令行标志能够放宽规则。
sandbox 关闭了权限无法覆盖的缺口。工具层面的 WebFetch 拒绝并不能阻止 shell 命令到达网络;OS 级的域名允许列表直接阻断出口。
failIfUnavailable 和 allowUnsandboxedCommands 让沙箱成为一个关卡:当沙箱无法初始化时,Claude Code 拒绝启动;而在沙箱内失败的命令无法在沙箱外重试。
credentials 关闭了拒绝规则留下的缺口。permissions.deny 管理 Claude 的文件工具,但一个被沙箱化的 shell 命令默认仍可能读取 ~/.ssh 或 ~/.aws/credentials;这个块拒绝那些读取,并从每个沙箱命令的环境中剥离具名的机密。
allowManagedHooksOnly 意味着来自本实战方案的审批关卡是唯一运行的钩子;没有任何本地内容能添加或替换它们。
disableSideloadFlags 和 strictKnownMarketplaces 意味着工程师机器上的每个技能、智能体、钩子和 MCP 服务器,都通过组织批准的插件市场到达,绝不会来自主目录。
allowManagedMcpServersOnly 让智能体的工具面(tool surface)成为一份由平台团队拥有的允许列表。
requiredMinimumVersion 拒绝在低于已批准下限的版本上启动,因此这些控制由一个组织真正评估过的构建来强制执行。
请将以上内容视为一个待定制的起点,而非一份建议照搬的清单。每一项拒绝都会与能力进行权衡,而正确的平衡取决于仓库的数据分类。设置参考文档涵盖了每一个键,包括仅托管可用的那些:code.claude.com/docs/en/settings
如何衡量它(针对钩子本身)
先行指标
在每个审批关卡上等待所花的时间。每个钩子决策都带有时间戳和一个允许或阻止的裁决,写入 OpenTelemetry 导出,因此等待时间在每一关卡处都可见。
滞后指标
钩子启用前后,到达生产的关卡违规,来自事故追踪器。
CI/CD 集成与部署
在 CI/CD 流水线内非交互式运行 Claude Code,将执行沙箱化以便长时间运行的智能体安全运行,通过 MCP 集成暴露部署能力,并在智能体真正需要它们之前演练回滚(rollback)路径。
传统方式 流水线运行确定性的脚本,任何需要判断力的东西都等待人类。例如,对不稳定(flaky)测试进行分类、编写变更日志,或弄清构建为何中断。部署和回滚是在压力之下由人类遵循的运行手册(runbooks)。
AI 原生方式 Claude 在流水线内针对判断性步骤非交互式运行,处于一个带有作用域受限凭证的沙箱中。部署工具通过 MCP 暴露给智能体,因此编写并测试了该变更的同一工作流,也能在它组织为每个环境定义的关卡内交付它并将其回滚。
如何开始
先决条件
PR 评审循环中的 Claude,以及作为审批关卡的钩子,因为这些关卡必须在自动化加速通过它们之前就存在。
基础设施
安装了 claude-code-action 的 CI 平台,或任何能调用 claude -p 的运行器;通过 API,或在流量必须停留在组织云协议上时通过 Bedrock、Foundry 或 Vertex 访问模型;面向部署目标的 MCP 服务器;一个没有常驻生产凭证的、面向智能体作业的沙箱配置文件。
如何执行
平台工程师从只读的判断性步骤开始。在流水线作业中使用
claude -p来对一个失败构建进行分类、总结一个不稳定测试,或起草变更日志。在现有关卡之后添加写入步骤,用于修复 lint、更新生成的文档,或通过
@claude提及处理评审评论等作业。智能体写入的任何东西都通过分支保护作为 PR 到达,智能体没有路径直接推送到 main。执行被沙箱化。智能体作业在网络策略下于容器中运行,使用短暂(short-lived)的作用域受限令牌,默认不持有生产凭证。
通过 MCP 暴露部署。部署、状态、回滚成为工具,按环境作用域受限,因此智能体的部署能力是一份允许列表,而非一个带有凭证的 shell 脚本。
按环境分级(tier)自治度。在开发环境中,智能体自由部署。在生产环境中,智能体准备发布,由发布经理授权,并由一个钩子强制执行生产关卡。预发(staging)环境位于两者之间的某处。
回滚应当是流水线中演练得最充分的路径,是一条智能体可以运行、并在预发环境中定期演练的单一命令。闭合循环实战方案(阶段 6:维护)在控制带被突破时调用此回滚,因此它必须提前被验证过。
它看起来是什么样(流水线步骤)
- name: 对失败构建进行分类 if: failure() run: >claude -p "读取 out/build.log 中的构建日志。识别最可能的原因,说明该失败看起来是不稳定还是真实,并为 PR 线程写一份三行总结。" >> triage.md
治理考量
治理原则是:智能体可以行动到生产关卡为止,而不能越过它。以下控制强制执行这一原则。
分支保护将智能体写入的任何东西变成 PR,没有直接通往 main 的路径。
生产部署钩子在该发布被具名的发布经理授权之前,阻止该发布。每次非交互式运行都以其自身的身份(identity)行动,因此流水线日志将智能体的所作所为与触发它的工程师的所作所为区分开来。
按环境的权限分级设置了智能体在通往关卡的路上可以做多少。
如何衡量它
先行指标
在无需呼叫人类的情况下完成分类的流水线失败所占比例,取自 CI/CD 流水线日志。
滞后指标
DevOps 研究与评估(DORA)指标,CI 系统和部署工具已经发出。
06 维护(Maintain)
循环闭合。一个触发器在没有人处于调用路径中的情况下调用 Claude,而它的发现作为 intent.md 重新进入流水线。
维护与闭合循环
到目前为止,我们已经讨论了如何为 SDLC 流程的每个阶段添加 Claude,每个阶段都需要一个人来启动最初的步骤。然而,这个阶段将焦点转移到自主运行 Claude 以闭合循环上。
例如,一个持续运行的监控智能体,可以基于一张缺陷工单的提出,创建一份 intent.md,并流经需求、计划、构建、测试和评审阶段。阶段 6:维护以无头(headless)方式运行,阶段之间有一个独立的置信关卡(confidence gate),即一个确定性的检查或一个对抗性的评审智能体,决定前一阶段的输出是继续还是升级给人类。
传统方式 维护是一个被动(reactive)的阶段。所有工单或事故都等待一个人对其采取行动并重启流程。凌晨 3 点的告警可能被错过,一张工单可能在待办中搁置直到有人接手,而如果另一场火灾先燃起,事后复盘(post-mortem)的行动可能根本到不了代码库。
AI 原生方式 一个如控制带突破、工单、频道消息或定时计划之类的触发器,在没有人处于路径中的情况下调用 Claude。Claude 进行诊断,只通过有关卡的路径行动,并将它的发现写成 intent.md,随后通过该环节描述的各个阶段。人类对这些工作进行分类和评审,而不再需要去启动它。
闭合循环
一个确定性的脚本监控生产环境,并在控制带被突破时调用 Claude。对一次突破的监控,是循环自主运行模式的一个有益示例,而本阶段末尾的 Claude Tag(公开测试版)一节,涵盖了通过不同渠道到来的工作。
如何开始
先决条件
Intent.md,它为循环提供了一个结构化的输出来重启。Claude 加速的 PR 评审、作为行动边界的钩子,以及用于 CI/CD 的回滚路径(由最高自治层级调用)。
基础设施
一个检测脚本可以查询的指标存储(Prometheus、CI 系统的 API,或等价物),对仓库的读取权限,一种在 CI 中非交互式运行 Claude Code 的方式,或用于接收 webhook 的服务的 Agent SDK。
如何执行
服务负责人或平台工程师挑选一个具有稳定滚动基线(rolling baseline)的指标,例如 CI 测试失败率、部署后 5xx 错误率,或 PR 周期时间。
他们编写检测脚本,通常是基于滚动窗口的均值和标准差,并带有规则(Western Electric 或类似的),使得这些带(bands)既能捕捉缓慢的漂移,也能捕捉尖峰。该脚本是版本控制并经过单元测试的,检测完全保持确定性,不涉及任何模型。
响应层级(tiers)定义在版本控制的配置中(如下的
bands.yaml)。在 1σ 时脚本只记录日志,在 2σ 时以只读方式调用 Claude 进行诊断,在 3σ 时 Claude 可以行动,尽管只能通过开启一个进入评审关卡的 PR 或触发一个预先批准的 runbook。触发器层可以是一个 GitHub 或 GitLab 中的定时工作流、来自现有监控技术栈的 webhook,或网络内的一个 Cron Job。Claude 以无状态方式运行,要么作为 CI 运行器上的一个非交互式步骤,要么作为沙箱容器中的一个 Agent SDK 服务,而 CI/CD 实战方案涵盖了部署和模型访问选项。由于运行是无状态且非交互式的,一个循环可以无人在场地开始和结束。
智能体将其诊断写成阶段 1:规划格式的
intent.md,涵盖异常及其证据、提议的结果、受影响的系统,以及任何悬而未决的问题。从那里起,该发现就像其他任何东西一样流经流水线。服务负责人或值班工程师对队列进行分类,将面向产品的发现路由给产品负责人。立即修复、排期,或忽略。忽略会调优这些带,并有助于减少噪音。
当一个修复上线时,为这起事故添加一个评估(持续评估实战方案),以确保这类问题在往后得到防范。
它看起来是什么样(例如,一个监控 CI 测试失败率的 bands.yaml)
metric: ci_test_failure_ratebaseline: rolling_30drules: western_electrictiers: 1sigma: { action: log } 2sigma: { action: diagnose, tools: "Read,Grep,Bash(gh run view *)"} 3sigma: { action: propose, routes: [pull_request, runbook:rollback-deploy]}
治理考量
层级边界由版本控制的配置强制执行,权限和托管设置拒绝生产访问。调用、发现和分类决策都带时间戳记录。一名服务负责人对发现进行分类并批准,所产生的变更通过正常的 PR 评审关卡,而智能体可以触发的 runbook 是事先批准过的。
如何衡量它
先行指标
从带突破到进入分类队列的一份 intent.md 所花的时间,对比旧的从事故到事后复盘行动的时间。检测脚本的日志含有突破时间戳和事故的层级。
滞后指标
成为合并修复的发现所占比例(分类队列对比实际 PR 历史),以及同类(class)的重复事故,随着修复向评估套件中添加用例,这一数字应当下降。
示例
当 CI 测试失败率突破 3σ 时,智能体隔离不稳定的测试或开启一个回退 PR,由评审关卡决定。
当部署后 5xx 错误率在窗口期内有部署的情况下突破 3σ 时,智能体触发现有的回滚流水线。
当 PR 周期时间触发一条漂移规则时,智能体为工程领导层写一份报告,这表明该机制对流程指标和生产指标同样有效。
检测保持确定性。一旦带被突破,Claude 才会被调用,而层级设定了它可以做什么。
周期性代码库扫描
一次安全扫描,是关于特定模型下某个代码库的一个时间点(point-in-time)陈述,而这两半都会过时:代码每周都在变化,并且每一代模型都会发现上一代遗漏的漏洞。AI 原生的答案是按计划运行扫描,调用路径中无人参与,并将它发现的东西,通过与其他任何代码库变更相同的关卡发送出去。
Claude Security 是计划化扫描的托管形态。连接一个 GitHub 仓库,扫描就运行在 Anthropic 基础设施上的 Claude Mythos 5 上,每个发现(finding)在报告之前都经过验证,并附上置信度评级。建议的补丁在 Web 版 Claude Code 中被评审和应用。组织无需访问模型本身即可获得发现。
传统方式 安全扫描是一个事件,在发布或审计之前启动一次扫描。报告进入一个追踪器,待办项由人工逐步消化直到下一次事件。期间编写的代码由 PR 评审抓到的内容覆盖。
AI 原生方式 扫描按计划针对每个已连接的仓库运行,使用最强大的可用模型,发现在任何人读取之前都经过验证。每个发现都像被突破的控制带一样处理:适合一个 PR 的修复通过评审关卡,任何更大的则成为 intent.md。覆盖范围是从上次运行开始计时的,而非从第一次
如何开始
先决条件
PR 评审关卡和作为审批关卡的钩子(阶段 5:部署),以便发现像任何其他变更一样通过评审。来自阶段 1:规划的 intent.md 格式,用于太大而无法放进单个 PR 的发现。
基础设施
Claude Security 以公开测试版向 Claude Enterprise 组织提供。它需要在目标仓库(云托管 github.com)上安装 Anthropic GitHub App,启用 Web 版 Claude Code,开启 Extra Usage 并设置支出上限,为运行扫描的人员提供高级席位,并由管理员在 claude.ai/admin-settings/claude-code 处打开该功能。扫描按 Mythos 5 的费率以消耗量计费,因此支出上限应匹配仓库的大小和数量。
如何执行
安全主管连接仓库,并按仓库、服务或团队将其组织为项目,以便发现的归属从一开始就很清晰。
对最关键的仓库运行首次完整扫描,包括那些曾被其他工具或早期模型扫描过的。将首次扫描视为基线。首次扫描很可能会在被认作干净的代码上浮现出发现。
为每个项目设定计划。对于活跃开发的服务,每周一次是合理默认;当仓库很大或混合时,将扫描范围限定到某个目录或分支。
手握置信度评级对发现进行分类。附上理由地忽略(dismiss),以便该忽略被记录,同一个发现在下一次运行时不会作为新发现返回。
对于一个有界的发现,在 Web 版 Claude Code 中打开建议的补丁,评审它,并像任何其他变更一样通过 PR 评审关卡发送它。提出修复的那个智能体没有途径批准它。
对于任何超出一个补丁范围的东西,例如一个架构弱点或一个跨服务重复的模式,将其按阶段 1 的格式写成
intent.md,并从规划开始。当一个修复发布到生产环境时,为该类漏洞向持续评估实战方案的套件添加一个评估,以便从那时起,引导智能体的配置就针对该类被测。
将发现导出为 CSV 或 Markdown,或使用 webhook,将组织现有的追踪器和审计系统保留为记录系统(system of record),因为审计者已经期望在那里看到它们。
治理考量
扫描在组织的管理员控制下运行,即哪些仓库被连接、谁持有扫描席位,以及支出上限,全部集中设置。每个发现都有验证结果和置信度评级,每次忽略都有理由,因此扫描历史是一份关于发现了什么、修复了什么、以及被有意识地接受(accepted)了什么的审计记录。
修复通过 PR 评审关卡和分支保护到达生产环境,而非来自扫描本身。Claude Security 是对现有静态分析和依赖扫描的补充。确定性的检查保留在 CI 中,而由模型驱动的扫描覆盖那些检查并非为发现而构建的、依赖于上下文的漏洞。
如何衡量它
先行指标
处于计划中的已连接仓库所占比例,以及从发现被报告到其补丁进入 PR 评审关卡的时间,从扫描历史和 PR 元数据读取。
滞后指标
由计划化扫描发现的漏洞,对比在生产环境或通过外部报告发现的,来自事故追踪器;以及经过多次运行后的仓库上,每次扫描发现数的趋势,随着修复和评估的累积,这一趋势应当下降。
通过 Claude Tag 让 Claude 值班(on call)
事故也可以通过其他方式到来,例如职场沟通应用,如 Slack 或 Teams。事故可以像晚上 10 点 Slack 频道上一条请求紧急修复的消息,而现在可以立即被处理。Claude Tag(公开测试版,目前可用于 Slack)让 Claude 以它自己的身份成为这些频道的一名成员,因此每个新事故都有一名第一响应者(first responder),而响应本身成为循环和未来事故的记忆的一部分。
对话和机构知识留在频道中,频道中的任何人都能引导和处置(action)该响应。任何团队成员都能测试假设、探索新选项并实时调查,频道历史增加了可审计性。通过 MCP 的访问,Claude 验证指标是否已回到基线,并在线程中确认,将事后复盘写入一份版本控制的经验文件(lessons file),供未来的调查读取。
事故并非 Claude Tag 接手的唯一工作。在工单上通过 MCP 被 @ 标记,或在频道中被询问时,Claude 以同样的方式对工单进行分类。一个小的、界定良好的修复作为 PR 通过评审关卡到达,任何更大的则被写成 intent.md 以进入阶段 1:规划,此时循环开始自我供给(feeding itself)。参见:Claude Tag 如何在 Anthropic 为 CI/CD 值班。
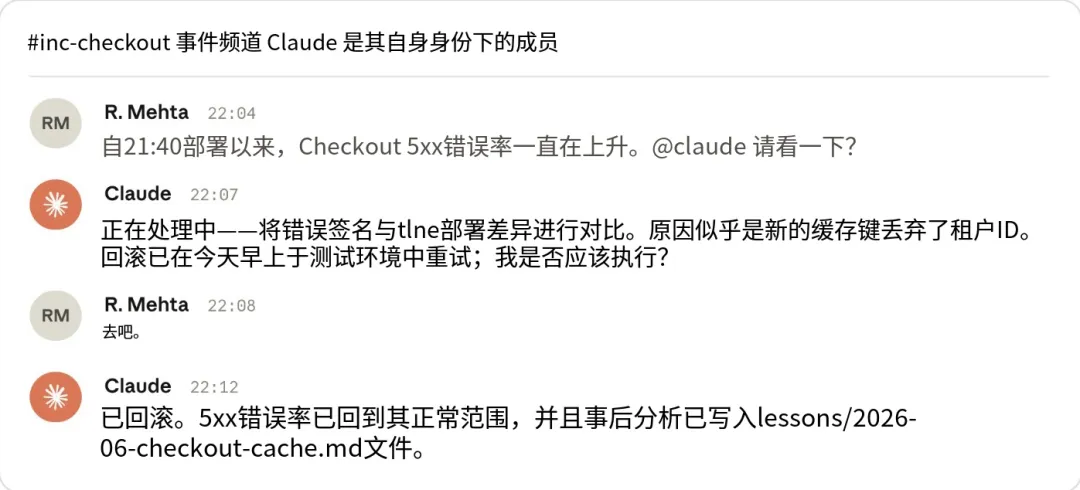
频道就是审计线索:请求、诊断、人类授权和修复都留在事故被处理的地方。
结语
模型和工具(harnesses)已变得更加先进,使组织不仅能够改造它们生产代码的方式,更能改造整个软件开发生命周期。
这种转型将人类判断力保持在流程的核心,并考虑了大型企业组织的治理与监管需求。
本指南整合了我们的 Applied AI 团队日常为客户执行的许多真实最佳实践,我们希望你觉得它是一个实用且可操作的资源。
循环持续运行。人类判断力始终在其之上。