ARTICLE · 1047981
AI 都能替你干活了,为什么回句话还这么慢?
拿一个占 28GB、快装满一张大显存消费卡的模型来算:假设它独自用卡、每步都用遍模型里的数字,每多写一个 token,就得把这份数据再读一遍。
在下面的算例里,光搬一次就约要 8.4 毫秒,眨眼的工夫已经能搬好多轮;把算力翻倍,这笔搬运时间一分也省不下来。
同一个模型,为什么读得快,写得慢?读完你会知道这笔账怎样算,以及为什么有的 API 报价里,同样多的 token,输出要花输入的 5 倍价钱。
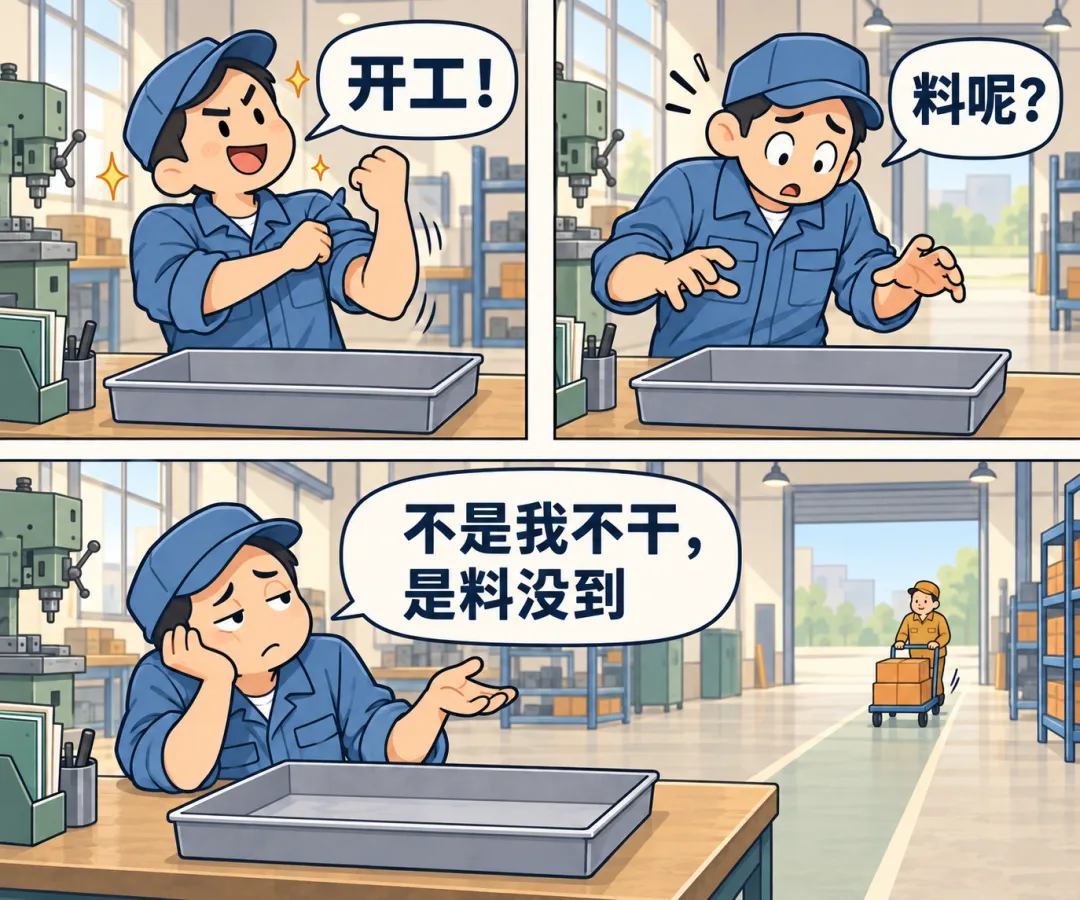
一、计算很快,原料供得上吗?
把显卡想成一座加工车间。执行计算的一组单元(SM)是一组工位,模型反复取用的数字(权重)是原料,存放它们的大仓库叫显存。每次生成,都要分块取料,送到工位计算;这些原料用过以后还能再用。
刚才那份模型装着 140 亿个数字,存起来约占 28GB,是大显存消费卡能装下的分量。你平时打开网页使用的 AI 服务,背后跑在机房里。
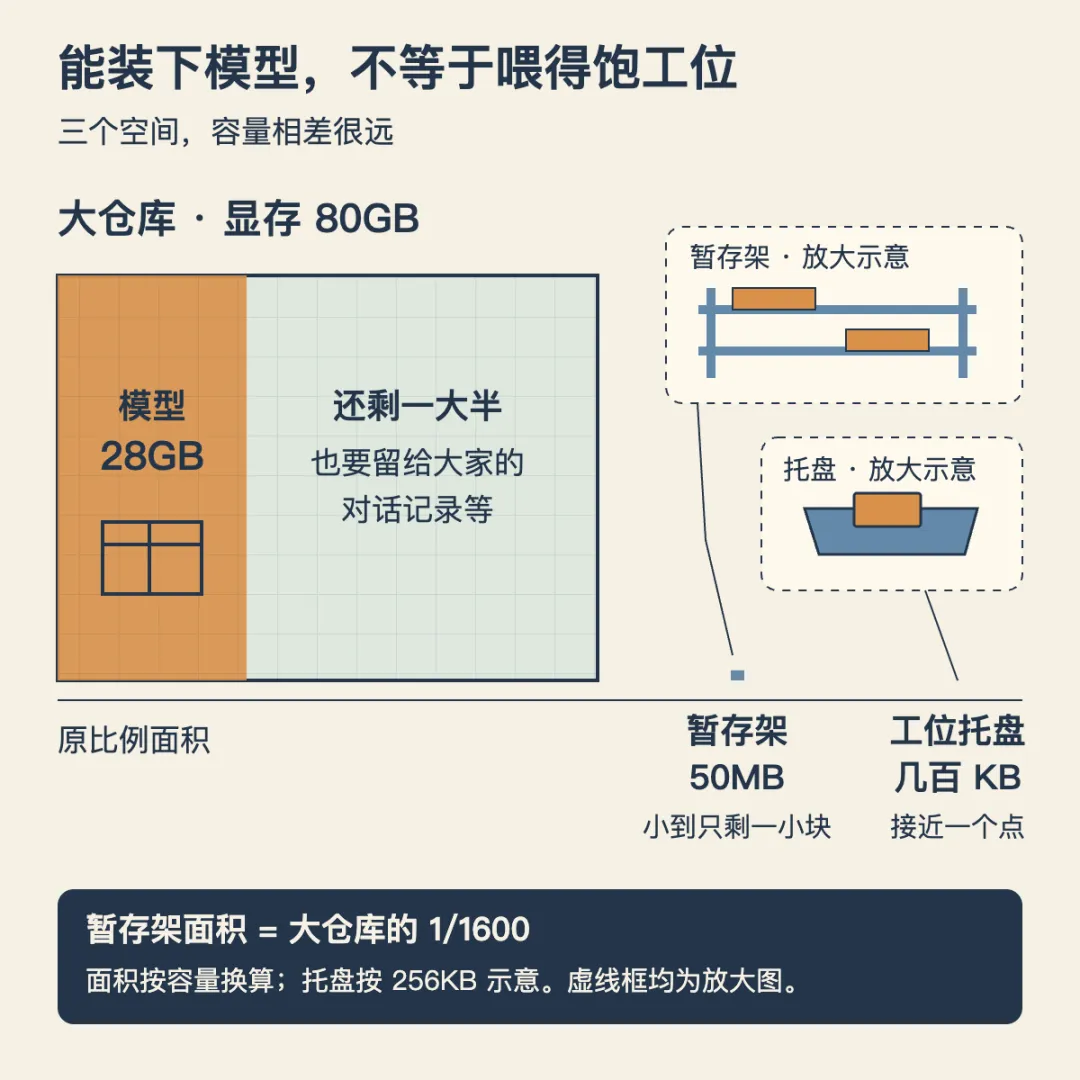
下面换到机房视角,拿 H100 来看:它是这几年 AI 数据中心的主力卡之一。我们用的这款单卡显存(HBM)有 80GB,是一张 32GB 消费卡的两倍半。
大仓库放入这份模型还剩一大半,余下五十多 GB,要分给你和同卡上聊天的其他人:各人的对话记录、工作中的临时数据,都往这里放。
既然原料反复用,为什么不一次全放在工位旁边?
芯片里的暂存架(L2缓存)只有 50MB,连整份模型的一小角都装不下;每组工位的托盘(L1缓存/共享内存)只有几百 KB,能接住的料就更少。
28GB 的原料,大约要五百多个 50MB 暂存架才装得下。工位边没有这么大的地方,只能搬一块、用一块。这些小空间用的是片上静态存储器(SRAM),临时放下当前要算的那部分数据。
模型占多大说的是容量;从大仓库往工位每秒能送多少,才叫显存带宽。H100 每秒能搬 3350GB,大约是普通高速固态硬盘的几百倍。你买到的计算工位再多,也得靠这条通道持续供料。
二、为什么读得快,写得慢?
先看你粘贴的长文章。
你输入“帮我看看这份周报写得怎么样”,再附上周报,所有输入都已经摆在那里。模型可以一起安排多个已知位置的计算。一块原料搬到工位旁,就能供这一排位置反复使用。这段处理叫预填充(prefill)。
好比你把已填好的整份订单交给车间,工人看得见各栏要做什么,可以同时开工。长文章增加的是要处理的位置,整排工位能一起消化这些工作。
轮到生成,后面的内容还没有写好。换个例子:AI 刚写到“我想喝”,下一步选“茶”还是“水”,会改变后面要接什么。普通逐步生成先确定眼前的 token,再把新内容带回去,算接下来该写什么,这段叫解码(decode)。
你看到它已经写了半句,就知道前半句定了;后半句还得沿着新结果继续。车间没法提前拿到一份填好的完整答案,一次把后面的所有位置都算完。运料车送来一块原料,单条回答这一轮只有眼前的新位置能用上。
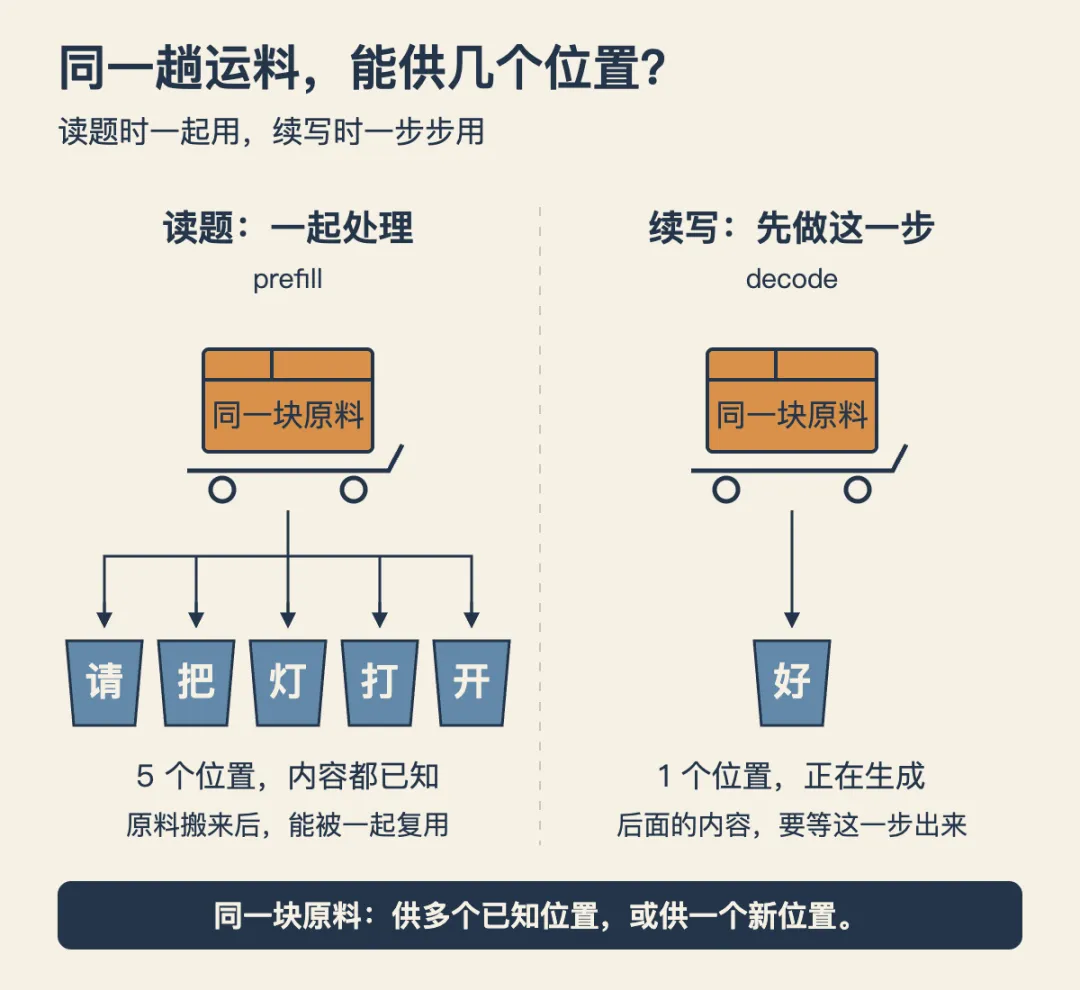
读题时,一趟搬运服务整排;单条续写时,一轮接着一轮。
你会问:权重一直不变,为什么不提前放好?
权重已经提前装进显存大仓库;工位旁的暂存架和托盘,放不下整套。好比你在工位边留一小块空地,先摆开头要用的料,算完换成后面要用的料。后面的料不断进来,前面那份在近处的副本就被替换了,仓库里的原件一直没动。
生成下一个 token,还要逐层经过模型的计算,前面用过的料得重新取。数据不变,省不了“近处放不下”造成的反复搬运。
历史记录是另一份数据:已经算好的中间结果(KV缓存)。常规生成时,旧记录保留,新记录往后追加,通常也放在显存大仓库里。留下旧记录省重算,使用时还得读取。前面的搬运账只算权重,读取历史记录的开销还要另计。
这解释了你遇到的两种任务:同一份长文,读完只回一句结论,和全文重写,等待差很多。后者多出来的是持续续写,要不断取料、计算,再选出下文。
也正因为如此,如果你接过模型 API,输入和输出会在账单里分开算。
以 Claude Sonnet 4.6 的标准价为例,同样数量的 token,输出费用是输入的 5 倍:输入花一份钱的量,换成输出要花五份钱。你让它读材料和让它写回答,付钱买的是两种不同的工作。官方价格表
输入能复用搬运,输出要逐步继续,两种工作成本不同。具体价差还包含商业定价,不能只靠搬运账推出来。
当你收到百来个 token 的一小段回答,内部累计读取已约有 2.8TB,相当于把一块常见的 2TB 移动硬盘整个读一遍还多。屏幕上增加的是新内容,车间里重复的是这份庞大的取料工作。
把计算工位翻倍,运料通道没变,读完同一份原料的时间也没变。工人更快地把手边的活做完,下一车没到,空着的手还是只能等。
现在兑现开头的算式。让这张卡只给你续写,每步读过整份模型,按刚才的运输速度:28GB ÷ 3350GB/秒 ≈ 8.4 毫秒,也就是每秒约 119 个 token,屏幕上的字会连着往外冒。
做个参照:假设每个 token 恰好对应一个汉字,拿每秒 20 字来比较,就是五六倍的出字速度。每秒 20 字大约是一行短句一秒铺开,你可以想象边读边出的节奏。
既然这笔账算出来这么快,那你平时到底在等什么?
三、那为什么你还是觉得慢?
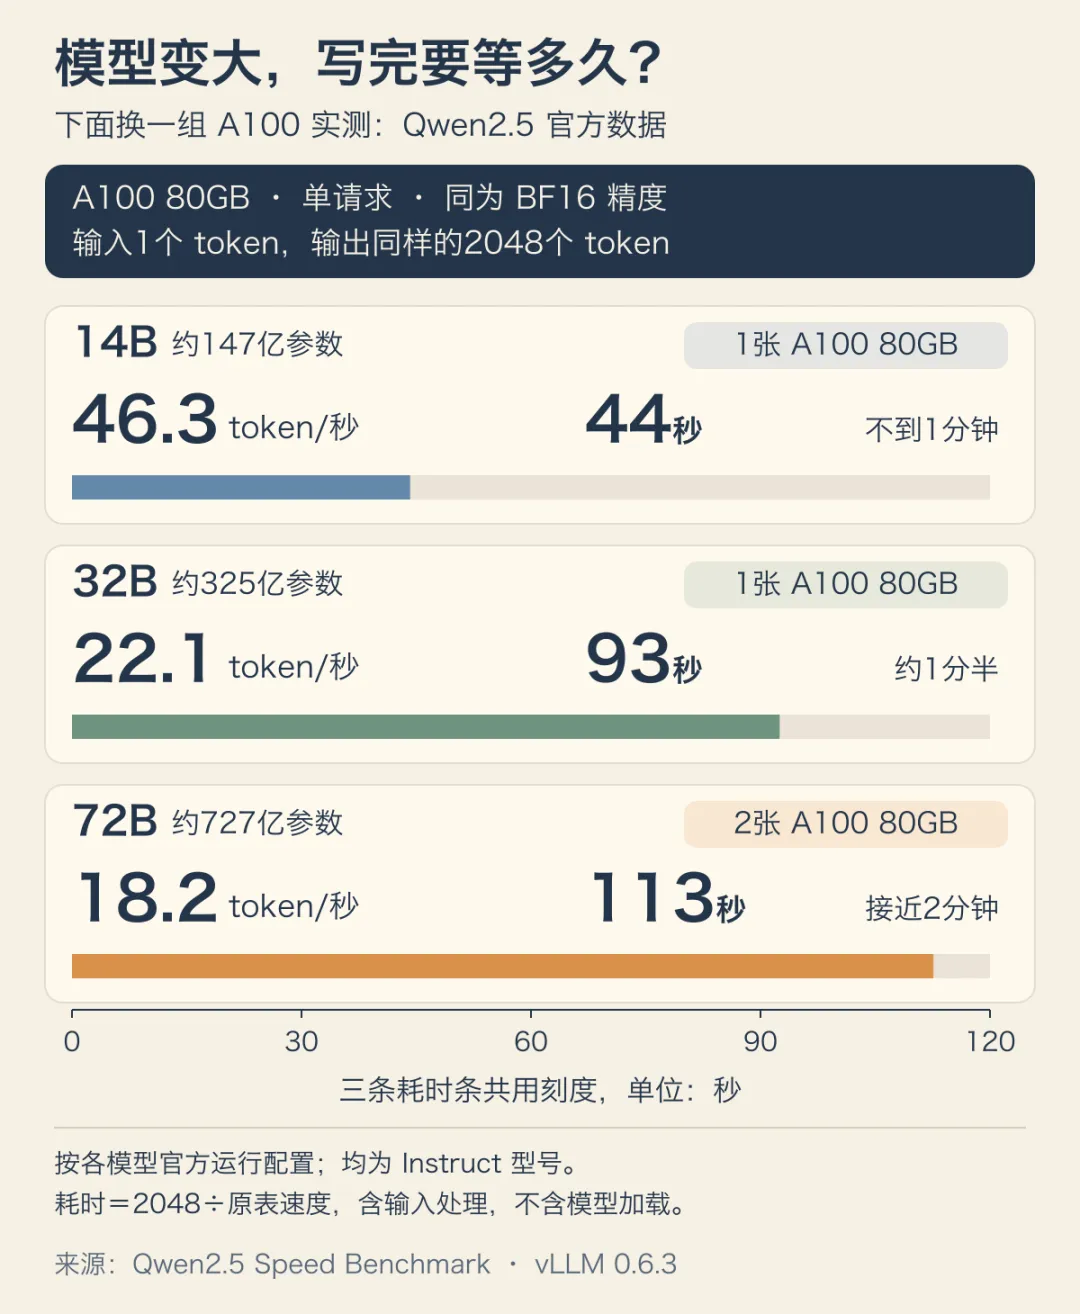
刚才算的是搬运时间的地板。更大的模型,实际要等多久?看Qwen团队的公开实测:这里换用A100显卡,每次只处理一份请求。你让它们写同样长的回答,较小模型不到一分钟,较大模型接近两分钟。图里同时写明了卡数;这些是各自运行配置下的结果。
先拿掉最关键的独享假设:你不是这张卡唯一的客户。
假设几十甚至上百份请求同时涌进车间,像一群客户挤在窗口交订单。服务器会把大家的工作放在一起安排,同一趟取料供更多请求使用。它追求的是让整间车间多完成订单,你关心的是自己的回答什么时候到手。
还记得仓库剩下的那些空位吗?每个人的对话记录都要占地方。接进来的请求越多,同时要照看的记录和计算就越多;资源被占满时,新来的还要排队。忙的时候,你等的不止是运料车,也在等前面的工作让出位置。
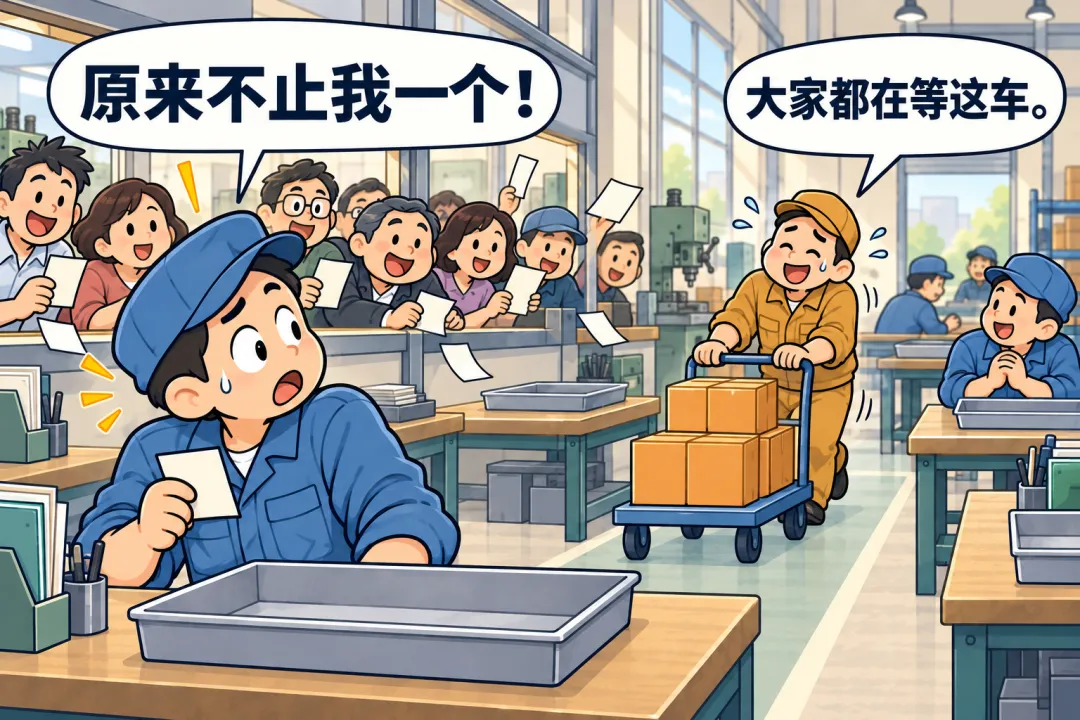
所以,你碰上“同一个问题,换个时段就快了”,服务器当时接着多少活、怎样安排这些活,就是值得先看的线索。
再看其余几笔:换成每步参与更多原料的大模型,搬运和计算都增加;你把对话聊得更长,续写时要翻的历史记录也更多。
还有先想再答的模型。它会先生成一段中间内容,再显示答案。你盯着空白屏幕的这段时间,后台已经在接着干活。
回到开头的反差:读得快,是因为一趟料能供多个已知位置;单条回答写得慢,是因为每一步要等前一步确定,再为新位置取料。
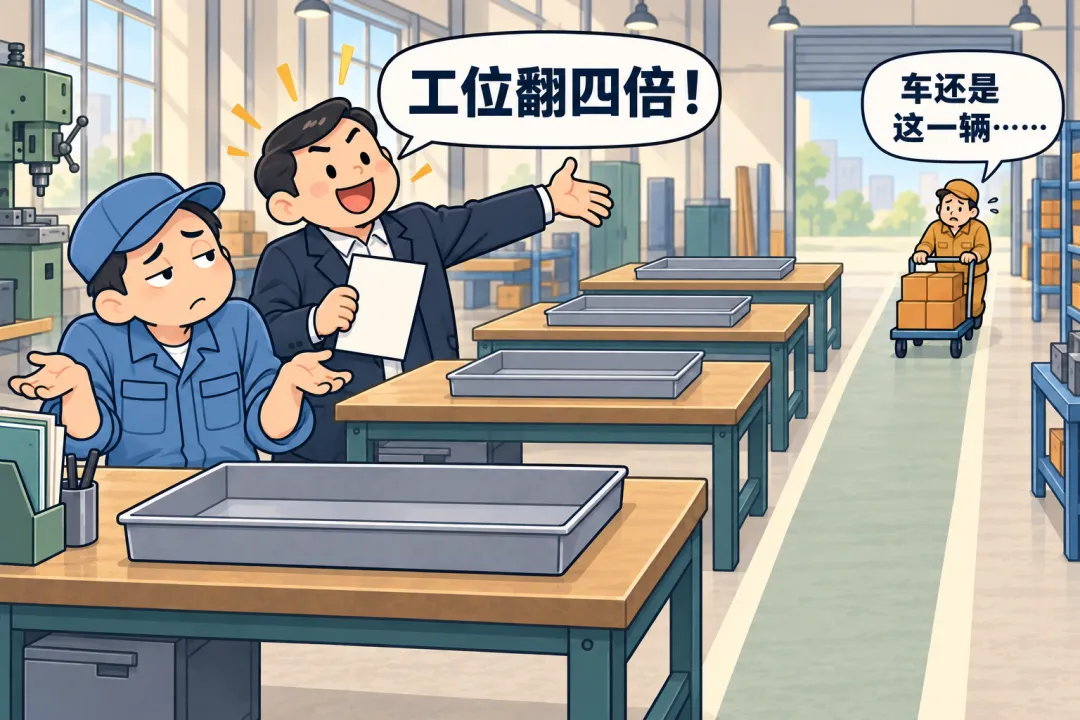
下次看到“算力翻倍”,先问一句:数据搬得过来吗?
算式与资料
- 算例:
140亿参数×2字节=28GB;28÷3350秒≈8.4毫秒,约119 token/秒;生成100次累计读取2.8TB。每步近似读全模型,按标称带宽计算;字速比较另设“一token对应一汉字”。 - 硬件:
采用H100 SXM:80GB显存、3.35TB/s带宽、50MB L2;每个SM的L1/共享等存储合计256KB。H100规格、Hopper指南、32GB消费卡参照。 - 定价:
2026年9月21日核查Sonnet 4.6标准API价:每百万token,输入3美元、输出15美元;售价比例不等于硬件成本比例。官方价格。 - 口径与实测:
H100算式为单卡单请求稠密模型的教学估算。对照图取Qwen官方A100测试;用时按2048÷原表速度换算,不含模型加载。实测配置与原表、KV缓存说明。
下一篇:你只说“把它改一下”,AI 怎么知道你指哪个?